


Mise en haute disponibilité d’un site web (cluster de bases de données et répartiteur de charge)
Le site de GSB sur deux serveurs web et trois nœuds de base, publié sur Internet le 10 novembre : il tient quand un serveur tombe.
Seul, dans le laboratoire de l’école qui reproduit l’informatique du siège de GSB (Galaxy Swiss Bourdin, laboratoire pharmaceutique fictif du cas d’étude de la formation). Tests de panne complétés le 29 octobre et le 2 novembre 2026 ; site publié sur Internet le 10 novembre.
Compétences mises en œuvre
| Compétence | Ce que j’ai fait | Preuve |
|---|---|---|
| Développer la présence en ligne de l’organisation | ||
| Participer à l’évolution d’un site web exploitant les données de l’organisation | Le site de GSB (WordPress, puis son intranet) est passé d’un serveur unique à deux serveurs web derrière un répartiteur, et sa base sur un cluster de trois nœuds, sans changer l’application | figure 1 |
| Mettre à disposition des utilisateurs un service informatique | ||
| Déployer un service | Quatre machines ajoutées (répartiteur, second serveur web, deux nœuds de base), site basculé derrière le répartiteur, règles de pare-feu adaptées | mise en œuvre |
| Réaliser les tests d’intégration et d’acceptation d’un service | Alternance, arrêt d’un serveur web, écriture sur un nœud et lecture sur un autre, arrêt d’un nœud, perte de la majorité, cloisonnement, accès depuis Internet par le nom public | tests, figures 2 et 3 |
Contexte et besoin
Mon laboratoire reproduit l’informatique du siège de GSB : un pare-feu qui sépare des zones réseau, un site web, une base de données, un annuaire. Au départ, le site reposait sur une seule machine web et une seule machine de base de données : si l’une des deux tombait, le site tombait avec elle.
La mission N3 du cas d’étude demande de la haute disponibilité pour les services de l’entreprise, et l’annexe II.E de l’épreuve exige un service avec continuité, de la tolérance de panne et de la répartition de charge. Il fallait donc que le site reste en ligne quand un serveur web ou un nœud de base s’arrête, et que cette évolution n’ouvre pas de nouveaux accès vers la base.
Objectifs et contraintes
Objectifs
- Que le site reste servi si un serveur web tombe, et si un nœud de base tombe.
- Répartir les visites entre deux serveurs web, sans casser les sessions ni les fichiers envoyés.
- Que la base refuse d’écrire plutôt que de laisser deux copies diverger, si la majorité des nœuds disparaît.
- Ne pas élargir la liste des machines autorisées à parler à la base.
Contraintes
- Un hyperviseur partagé avec d’autres élèves : des machines sobres, obtenues par clonage plutôt que par réinstallation.
- Le cloisonnement existant : la base reste seule dans sa zone, elle n’initie aucun flux, et rien ne passe sans règle explicite dans le pare-feu.
- L’application telle quelle : WordPress ne sait pas qu’il y a un cluster derrière lui ; c’est l’infrastructure qui s’adapte.
- Aucun secret dans la documentation : les mots de passe des comptes de service sont remplacés par des marque-places.
Analyse et choix techniques
| Question | Mon choix | Pourquoi |
|---|---|---|
| Combien de nœuds de base ? | Trois, en cluster Galera (réplication synchrone) | Avec deux nœuds, une coupure laisserait chacun croire qu’il est seul : deux bases qui divergent. Avec trois, la majorité décide ; le nœud isolé refuse d’écrire |
| Comment un nœud rattrape-t-il les autres ? | Copie à chaud avec mariabackup | La méthode rsync bloque le nœud donneur en lecture seule pendant la copie ; mariabackup le laisse servir |
| Où placer le répartiteur ? | Une machine dédiée (srv-ha) dans la zone web, seule porte vers la base | Les postes ne joignent plus qu’une machine, et une seule machine joint la base : la couche ajoutée restreint les autorisations au lieu de les élargir |
| Répartir aussi les requêtes SQL ? | Non : nœud 1 actif, nœuds 2 et 3 en secours | Deux écritures concurrentes sur la même ligne depuis deux nœuds produisent un conflit que l’application ne sait pas traiter. Devant un cluster synchrone, HAProxy fait de la bascule, pas de la répartition |
| Et les fichiers envoyés au site ? | Administration épinglée sur le premier serveur web, fichiers recopiés à sens unique vers le second | Un fichier envoyé sur un serveur doit exister sur l’autre ; la recopie à sens unique évite les conflits, et la clé SSH utilisée est confinée à une seule commande |
| Cloner ou réinstaller le second serveur web ? | Cloner, en gardant tous les fichiers | Les clés de session de WordPress doivent être identiques sur les deux serveurs, sinon un visiteur est déconnecté dès qu’il change de serveur |
| Où terminer le chiffrement ? | Sur le répartiteur, avec un certificat auto-signé qui porte tous les noms du site | Un seul certificat à gérer ; les serveurs web reçoivent l’information « la visite était en HTTPS » par un en-tête |
Ce que j’en retiens : on appelle HAProxy un « répartiteur de charge », mais devant un cluster de bases synchrone il fait de la haute disponibilité par basculement : tout le trafic va sur un nœud, et bascule seul s’il tombe. Savoir expliquer cette différence distingue un montage compris d’un montage recopié.
Mise en œuvre
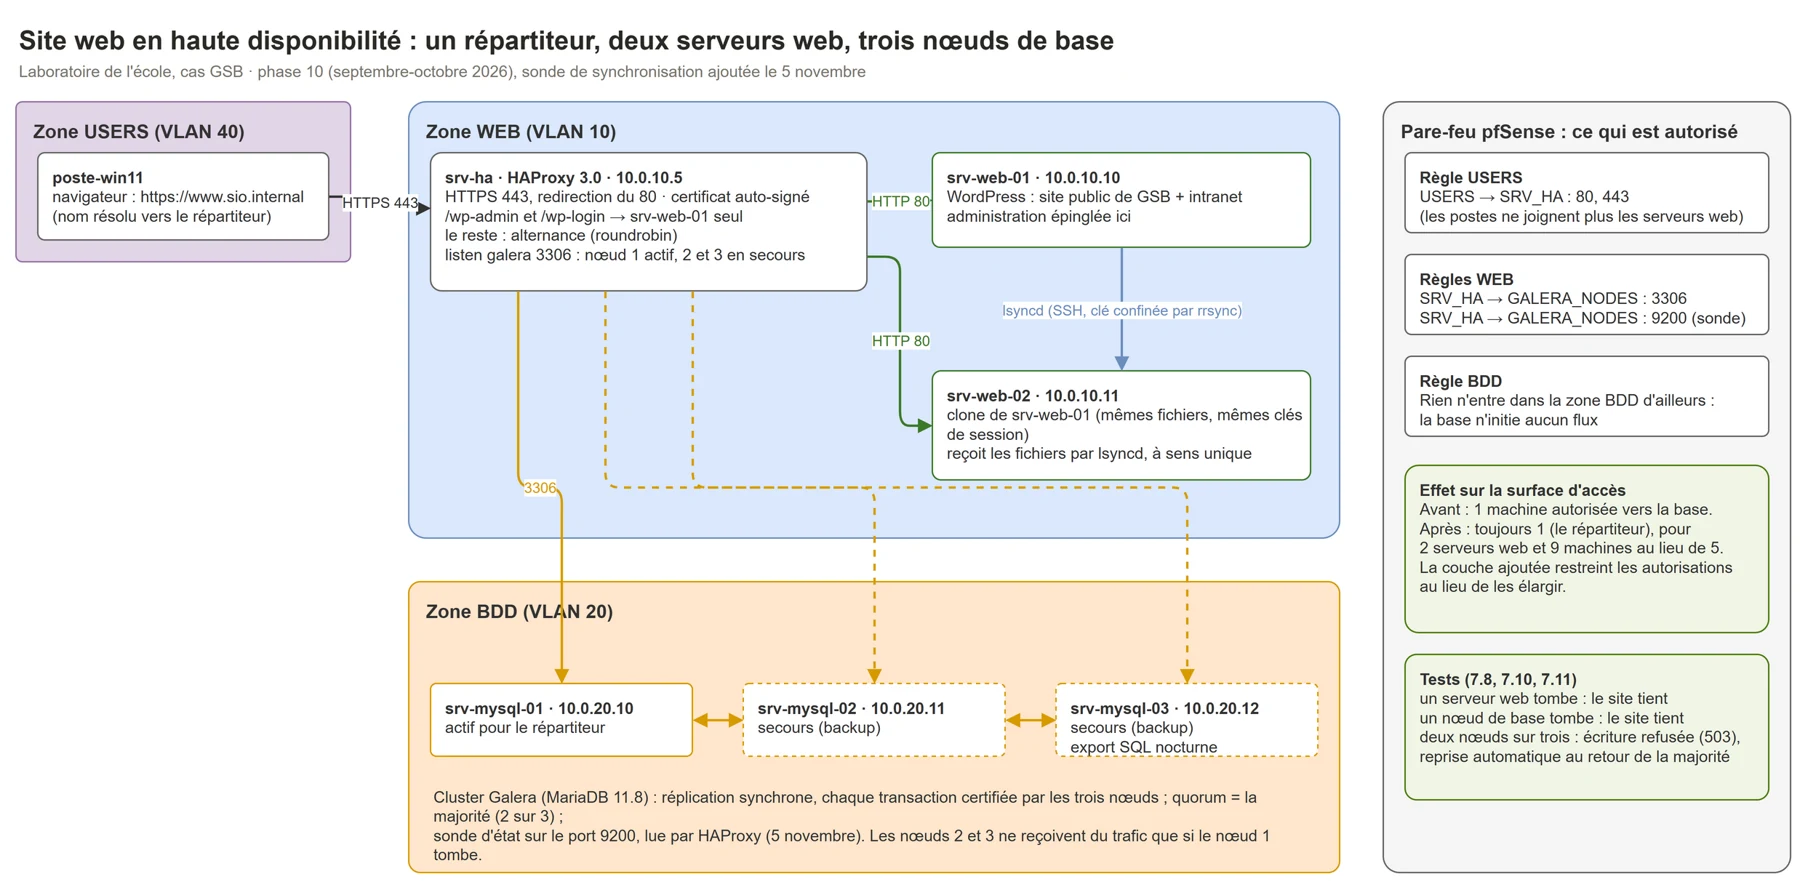
Figure 1 · Le site en haute disponibilité : répartiteur, deux serveurs web, trois nœuds de base, règles de pare-feu.
- Les machines : le répartiteur installé proprement (Debian 13 sans bureau), puis trois clones : le second serveur web (clone complet du premier) et deux nœuds de base (dossier de données vidé pour forcer une copie cohérente). J’ai régénéré l’identité de chaque clone (nom, adresse, clés) et renommé les machines d’origine en
-01. - Le pare-feu : alias pour le répartiteur et les nœuds, règle « répartiteur vers les nœuds, port 3306 » placée avant le rejet de la zone web, règle des postes redirigée vers le répartiteur, règle temporaire de la zone de base rouverte le temps des installations puis refermée.
- Le cluster : même configuration sur les trois nœuds, compte de synchronisation avec les quatre privilèges strictement nécessaires, amorçage depuis le nœud qui détient les données, puis jonction des nœuds 2 et 3 un par un.
- Le répartiteur : certificat auto-signé avec tous les noms du site, entrée HTTPS avec redirection du port 80, administration de WordPress épinglée sur le premier serveur, le reste en alternance, bloc TCP vers la base avec les nœuds 2 et 3 en secours.
- La bascule du site : WordPress pointé sur le répartiteur, adresse du site fixée, détection du HTTPS relayé ajoutée, nom du site résolu vers le répartiteur. Une réponse
HTTP/2 200avec le bon en-tête prouve d’un coup qu’il n’y a pas de boucle, que l’adresse du site est appliquée et que toute la chaîne fonctionne. - La recopie des fichiers :
lsyncddu premier serveur web vers le second, à sens unique, avec une clé SSH enfermée dans une seule commande (rrsync) : elle ne peut écrire que dans le dossier des fichiers du site. - Le nettoyage : anciens comptes de base des serveurs web supprimés ; seule l’adresse du répartiteur reste autorisée.
- Le 5 novembre, un complément : une sonde d’état sur chaque nœud (port 9200) dit s’il est synchronisé ; le répartiteur l’interroge et retire un nœud qui répond mais n’a plus les mêmes données que les autres.
- Le 10 novembre, la publication sur Internet (réalisation RP10) : le répartiteur sert aussi le nom public du site, avec des règles propres à ce nom : administration, connexion, API et intranet refusés, lecture seule, 100 requêtes par 10 secondes et par visiteur. Il sert également la mesure d’audience (Matomo), en actif / secours comme GLPI.
Tests et recette
| Test | Résultat |
|---|---|
| 7.7 · Alternance entre les deux serveurs web | Huit requêtes de suite : srv-web-01, srv-web-02, en alternance stricte |
| 7.8 · Arrêt d’un serveur web | Le site tient sur l’autre ; arrêt des deux : coupure ; redémarrage : reprise immédiate |
| 7.9 · Écriture sur le nœud 2, lecture sur le nœud 3 | Donnée lue immédiatement : la réplication est synchrone |
| 7.10 · Arrêt de la base sur le nœud 1 pendant 5 minutes (29 octobre) | Sonde du site restée à 1 chaque minute ; alerte « Galera incomplet » reçue ; nœud revenu synchronisé |
| 7.11 · Perte de la majorité : deux nœuds débranchés (2 novembre) | Le nœud restant refuse d’écrire ; site en erreur 503 ; cluster reformé seul en moins de 10 s au rebranchement, sans réamorçage |
| 7.13 · Cloisonnement : un poste utilisateur vers les nœuds, port 3306 | Connexion refusée sur les trois nœuds |
| Arrêt réel d’une machine virtuelle web (30 octobre) | srv-web-02 éteinte 8 minutes : le site reste servi par srv-web-01 |
| Nœud désynchronisé sans être arrêté (5 novembre) | Retiré par le répartiteur en quelques secondes, site toujours servi ; repris dès qu’il est resynchronisé |
| Depuis Internet, par le nom public (10 novembre) | Pages publiques à 200 ; administration, connexion et intranet à 403 ; 130 requêtes rapides d’un même visiteur : 100 passent, 30 sont refusées (429) |
| Démonstration involontaire du cloisonnement | Le clone du serveur web, identique en tout, a été refusé par la base parce que son adresse avait changé : c’est la restriction d’origine du compte qui a joué |
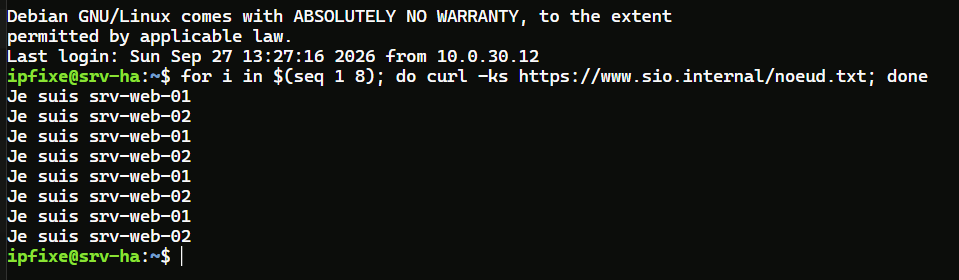
Figure 2 · Test 7.7 : huit requêtes, les deux serveurs web répondent à tour de rôle.
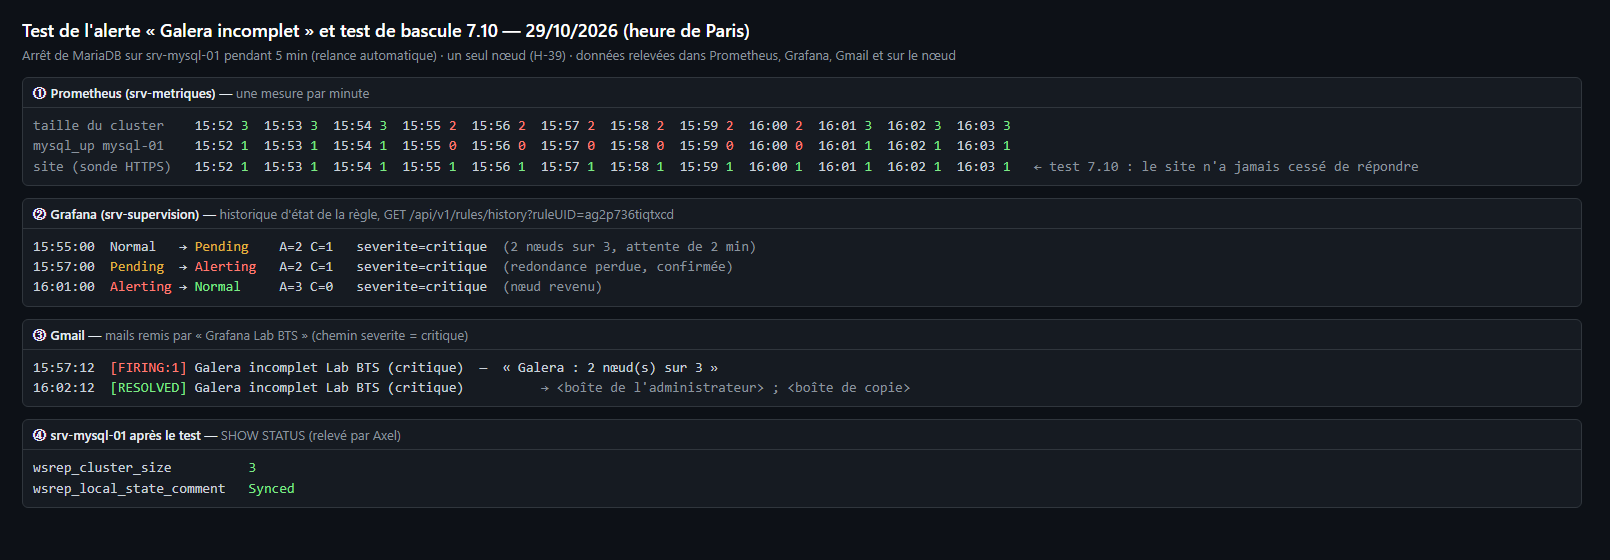
Figure 3 · Test 7.10 (29 octobre) : un nœud arrêté cinq minutes, le site n’a jamais cessé de répondre.
Bilan critique
Ce qui a coincé. Avant la règle de pare-feu entre le répartiteur et les nœuds, HAProxy voyait les trois nœuds « DOWN » avec un refus immédiat : le rejet du pare-feu renvoie un paquet de refus, un blocage silencieux aurait produit un délai d’attente. Ce détail m’a appris à lire l’état des serveurs dans HAProxy comme un diagnostic réseau.
Au premier essai, le site tournait en boucle de redirection : WordPress ne savait pas que la visite était en HTTPS côté répartiteur ; la détection de l’en-tête relayé, ajoutée dans sa configuration, a réglé le problème. Ensuite, le poste utilisateur affichait « connexion refusée » alors que le nom se résolvait bien : j’avais oublié de rediriger la règle des postes vers le répartiteur. Le message du navigateur désigne la couche en défaut : un nom non résolu aurait désigné le DNS, un refus désigne le filtrage.
Sur le clone du serveur web, l’adresse se changeait par nmcli et non par le fichier d’interfaces, parce que
cette machine utilise NetworkManager. Pour la recopie des fichiers, lsyncd ajoute par défaut une option que
rrsync refuse, et le compte du serveur web ne peut pas servir de compte SSH : deux pièges résolus en lisant
les journaux.
Les limites que j’assume.
- Les nœuds écoutent sur toutes leurs adresses (dette technique notée) : le cloisonnement repose sur le pare-feu.
- L’hyperviseur est unique : la redondance est logique, pas matérielle.
- Si deux nœuds sur trois disparaissent, le site est volontairement indisponible : le cluster préfère l’indisponibilité à l’incohérence.
Ce que je referais autrement. Je poserais la règle de pare-feu avant d’installer le répartiteur, et je testerais depuis le poste utilisateur dès la première bascule, au lieu de valider d’abord depuis la zone des serveurs.
Outils et aides. Les choix et les décisions sont les miens, ainsi que les étapes écrites à la première personne. Un assistant IA (Claude Code) a exécuté une partie des commandes et m’a aidé à rédiger la documentation, que j’ai relue.
Documents et productions associés
- MO-2 · Monter un cluster Galera à 3 nœuds
- MO-3 · HAProxy : répartir le web, basculer la base
- MO-24 · Matomo et mise en ligne du site
- Documentation du laboratoire
- Tests de bascule
- Sonde d'état des nœuds