


Mise en place d’une supervision avec alertes
Mesures, journaux, tableau de bord et alertes testées en provoquant chaque panne.
Seul, dans le laboratoire de l’école qui reproduit l’informatique du siège de GSB (Galaxy Swiss Bourdin, laboratoire pharmaceutique fictif du cas d’étude de la formation). C’est la mission N4 du cas d’étude, et la première réalisation de mon épreuve E6. En cours : l’exercice d’incident conduit par un tiers reste à faire (janvier 2027).
Compétences mises en œuvre
| Compétence | Ce que j’ai fait | Preuve |
|---|---|---|
| Gérer le patrimoine informatique | ||
| Exploiter des référentiels, normes et standards adoptés par le prestataire informatique | Durée de garde des journaux fixée d’après la recommandation de la CNIL et le guide de journalisation de l’ANSSI | contraintes, choix techniques |
| Répondre aux incidents et aux demandes d’assistance et d’évolution | ||
| Traiter des demandes concernant les services réseau et système, applicatifs | Pannes provoquées puis traitées (service, machine, nœud de base, supervision elle-même) ; trois défauts de la supervision trouvés par les tests et corrigés ; les alertes deviennent des tickets | tests, figures 2 à 4, bilan |
| Travailler en mode projet | ||
| Analyser les objectifs et les modalités d’organisation d’un projet | Besoin de GSB écrit, contrat de service avec trois engagements mesurables, dossier de choix de l’outil (deux outils comparés), cadre juridique des journaux | contexte, choix techniques |
| Planifier les activités | Phase découpée en douze tâches numérotées, calée sur les séances de l’épreuve (dossier d’architecture en séance 4, tests en séance 7, fiche en séance 8) | mise en œuvre |
| Évaluer les indicateurs de suivi d’un projet et analyser les écarts | Plan de tests : 39 tests, 38 réalisés ; détection mesurée à 3 min au lieu des 2 min annoncées, et le document corrigé | tests, bilan |
Contexte et besoin
Les serveurs du siège de GSB rendent des services à toute l’entreprise : annuaire, résolution de noms, site et intranet, bases de données. La direction des systèmes d’information veut voir les pannes avant les utilisateurs, mesurer la disponibilité de ses services et être alertée dès qu’un seuil est dépassé. C’est la mission N4 du cas d’étude, que j’ai choisie comme première réalisation de mon épreuve E6.
Mon laboratoire comptait alors quatorze machines dans cinq zones réseau, sans aucune mesure centralisée : une panne se voyait quand quelqu’un s’en plaignait. Le formateur a demandé que la solution s’appuie sur le cluster de bases de données déjà en place.
Objectifs et contraintes
Objectifs
- Mesurer la disponibilité de chaque service comme le ferait un utilisateur, et l’état de chaque machine de l’intérieur.
- Centraliser les journaux de toutes les machines, six mois, et pouvoir y chercher une attaque.
- Un tableau de bord lisible par un non-technicien.
- Des alertes par courriel à deux niveaux de gravité, regroupées, avec une procédure d’escalade.
- Un contrat de service dont chaque engagement est mesuré par une règle testée.
Contraintes
- Les données dans le cluster : les journaux et la base de Grafana vivent dans le cluster Galera, par un HAProxy local ; ils survivent à la perte d’un nœud.
- Deux machines sobres dans la zone d’administration (2 processeurs virtuels, 2 Gio chacune) : l’hyperviseur est partagé.
- La supervision lit, elle n’administre pas : aucun compte ni accès SSH sur les machines surveillées ; des flux ouverts vers un seul hôte source, sur des ports précis.
- Le RGPD : les journaux contiennent des identifiants et des adresses ; base légale, durée de conservation (six mois, recommandation de la CNIL, reprise par le guide de journalisation de l’ANSSI), accès restreint et purge automatique sont écrits dans mon dossier d’architecture.
Analyse et choix techniques
| Question | Mon choix | Pourquoi |
|---|---|---|
| Quel outil ? | Prometheus et Grafana, plutôt que Zabbix | Un exporteur par type de machine, déployé par script ; Prometheus vient lire les mesures (les machines n’envoient rien) ; Grafana sait lire la base des journaux dans le cluster. Comparaison écrite dans mon dossier de choix |
| Comment mesurer un service ? | Des sondes « comme un utilisateur » (page web, requête DNS, connexion au bastion…) toutes les 15 s | Une machine qui répond au ping peut servir un site en panne ; la sonde teste le service, pas la machine |
| Où mettre les journaux ? | rsyslog sur une machine de supervision, vers deux tables dans le cluster ; Fluent Bit sur Windows, filtré à la source | Les journaux survivent à un nœud perdu ; le bruit des comptes machine de l’annuaire est coupé avant d’être envoyé (volume divisé par deux) |
| Quels niveaux de gravité ? | Critique (mail en 10 s, rappel chaque heure) et avertissement (regroupé 5 min, rappel chaque jour) | Une panne se traite tout de suite ; un disque qui se remplit attend le matin. Chaque groupe donne un seul mail, puis un mail de résolution |
| Quels seuils ? | 2 min d’échec continu pour une panne ; 15 min pour disque, mémoire, processeur ; 26 h pour une sauvegarde ; 5 refus de connexion en 5 min | Une mesure manquée ne doit pas alerter ; un pic passager non plus (un poste monté à 95 % de mémoire quelques minutes n’a pas produit de mail) ; 26 h, c’est une nuit manquée avec deux heures de marge |
| Et si la supervision tombe ? | Une règle « Supervision aveugle » qui envoie un seul mail ; les autres règles se taisent | Au premier test, l’arrêt de Prometheus avait produit trois mails trompeurs accusant les services et les machines |
| Quels engagements ? | 99 % de disponibilité sur 30 jours, site en moins de 2 s, reprise en 4 h | Chaque engagement a sa sonde et sa règle ; la reprise est appuyée par une restauration testée en 125 s |
Ce que j’en retiens : une panne de la supervision doit produire une seule alerte qui dit « je suis aveugle », pas une avalanche de fausses pannes. Il faut séparer l’erreur (la source ne répond plus) de l’absence de données (la mesure a disparu).
Mise en œuvre
Le schéma ci-dessous montre ce que j’ai construit. Les étapes, dans l’ordre, viennent après.
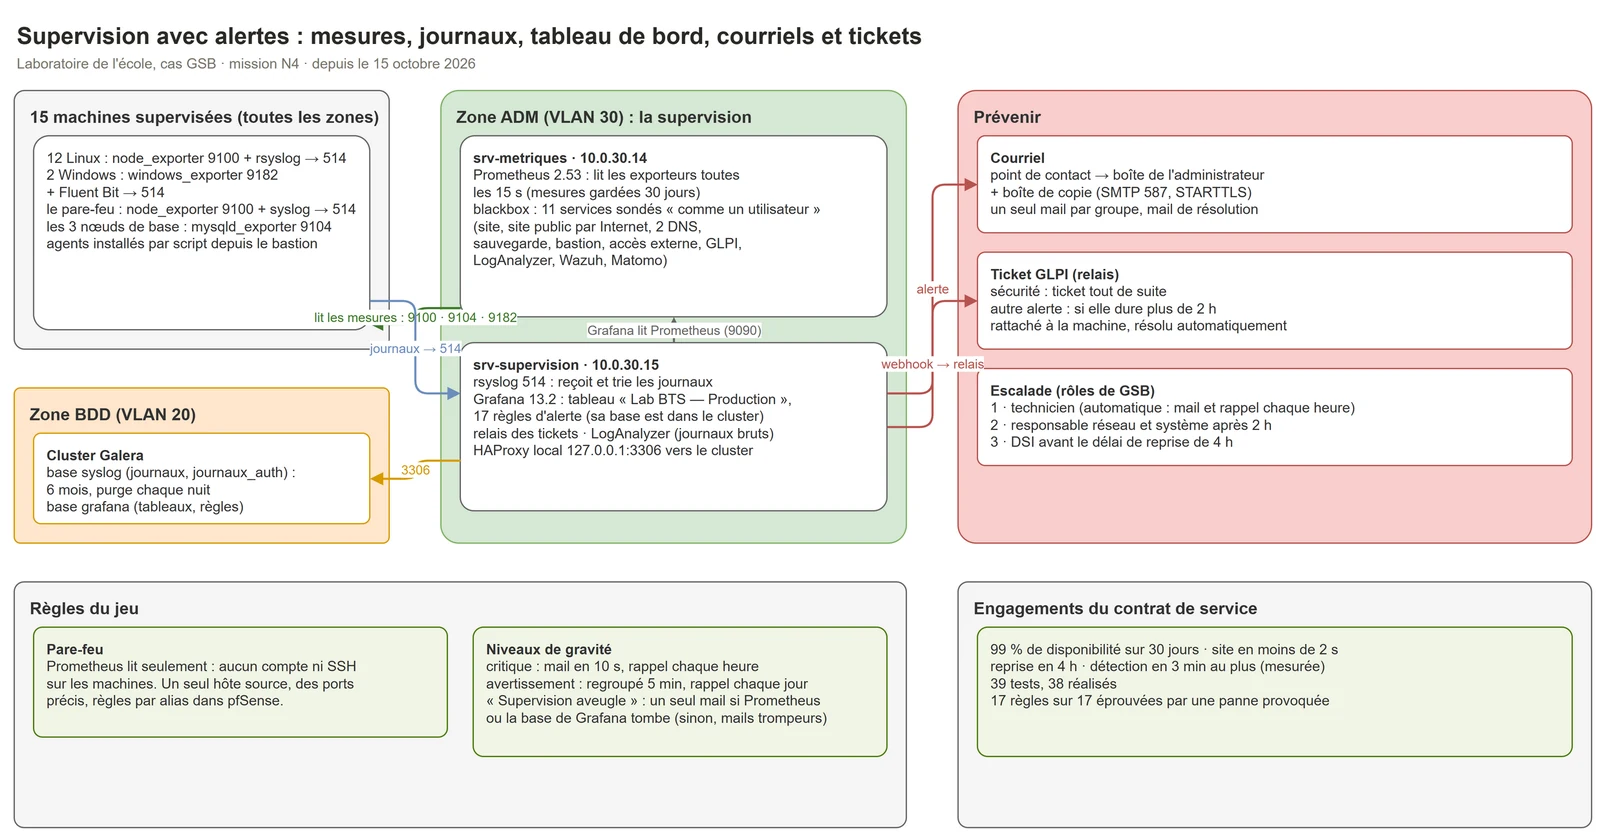
Figure 1 · La supervision : mesures, journaux, tableau de bord, courriels, tickets et engagements.
- Le pare-feu d’abord (15 octobre) : alias et règles posés avant les machines, un seul hôte source pour les mesures, un seul pour les journaux.
- Deux machines (19 et 20 octobre), installées à la main en Debian sans bureau : Prometheus et les sondes sur l’une, la réception des journaux et Grafana sur l’autre.
- Un exporteur sur chaque machine (20 et 21 octobre), installé par un script lancé depuis le bastion : Linux, les trois nœuds de base, Windows, le pare-feu. Prometheus connaît ses cibles par une fiche par machine : 21 cibles, puis 23 avec la zone invités.
- Les journaux : toutes les machines envoient leurs journaux à la machine de supervision, qui les range dans deux tables du cluster (journaux, authentifications) ; sur Windows, le bruit des comptes machine est filtré à la source.
- Grafana : sa base dans le cluster, un tableau d’exercice, puis le tableau de bord de production (disponibilité par jour, état des machines, sauvegardes, refus de connexion, volume des journaux).
- Les alertes (29 et 30 octobre) : envoi SMTP chiffré, un point de contact vers deux boîtes, deux chemins de gravité, puis onze règles éprouvées une par une en provoquant la panne. Douze avec la détection d’intrusion, dix-sept aujourd’hui.
- La purge : un compte dédié aux droits minimaux supprime chaque nuit les journaux de plus de six mois, par paquets, sans bloquer le cluster.
- Les tickets (6 novembre) : un relais reçoit les alertes et ouvre un ticket GLPI pour les alertes de sécurité tout de suite, pour les autres si elles durent plus de deux heures.
- Le site public (11 novembre) : deux sondes de plus, le site de GSB testé par Internet de bout en bout et la mesure d’audience (fiche RP10) : 11 services suivis. La règle « Service injoignable », écrite pour tous les services, les couvre sans changement.
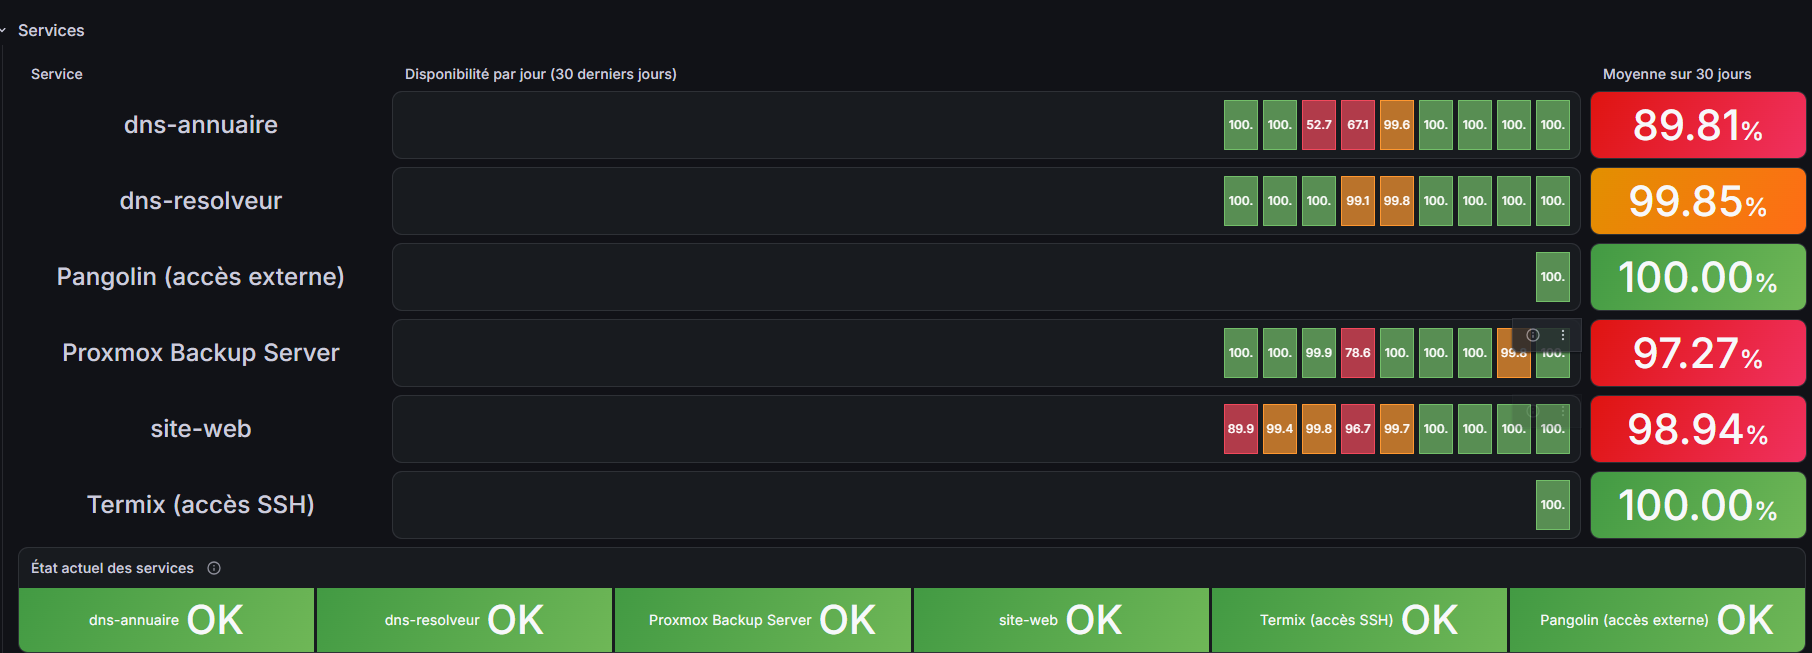
Figure 2 · Le tableau de bord de production : disponibilité de chaque service, jour par jour, et moyenne sur 30 jours.
Tests et recette
Mon plan de tests compte 39 tests, 38 réalisés et prouvés au 12 novembre ; mon rapport de tests donne les heures relevées dans Prometheus, dans l’historique des règles et dans l’en-tête des mails. Les plus parlants :
| Test | Résultat |
|---|---|
| Service arrêté (bastion, 5 minutes) | Panne vers 13:55, règle en attente à 13:56, alerte à 13:58, mail critique à 13:58:11, mail de résolution après le retour |
| Arrêt réel d’une machine virtuelle web | Mail « Machine injoignable » en 2 minutes ; le site reste servi par l’autre serveur |
| Un nœud de base arrêté 5 minutes | Mail « Galera incomplet » ; le site n’a jamais cessé de répondre |
| Prometheus arrêté 5 minutes | Premier essai : trois mails trompeurs ; après correction : un seul mail « Supervision aveugle » |
| Perte de la majorité du cluster | Le dernier nœud refuse d’écrire ; une seule alerte ; la règle a été reformulée pour nommer les deux causes possibles |
| Cinq mots de passe faux en SSH | Alerte « Connexions refusées en rafale » lue dans la base des journaux |
| Seuil du site abaissé à 0,05 s | Alerte « Site lent » : l’engagement de 2 s est bien surveillé |
| Sauvegarde : seuil abaissé à 1 h | Un seul mail regroupé pour les 12 machines, puis un mail de résolution |
| Purge des journaux | Simulation à 10 jours : 98 179 lignes comptées sans rien supprimer ; premier passage automatique sans erreur |
| Délai de détection mesuré | De 2 min 16 s à environ 3 min entre la panne et le mail critique |
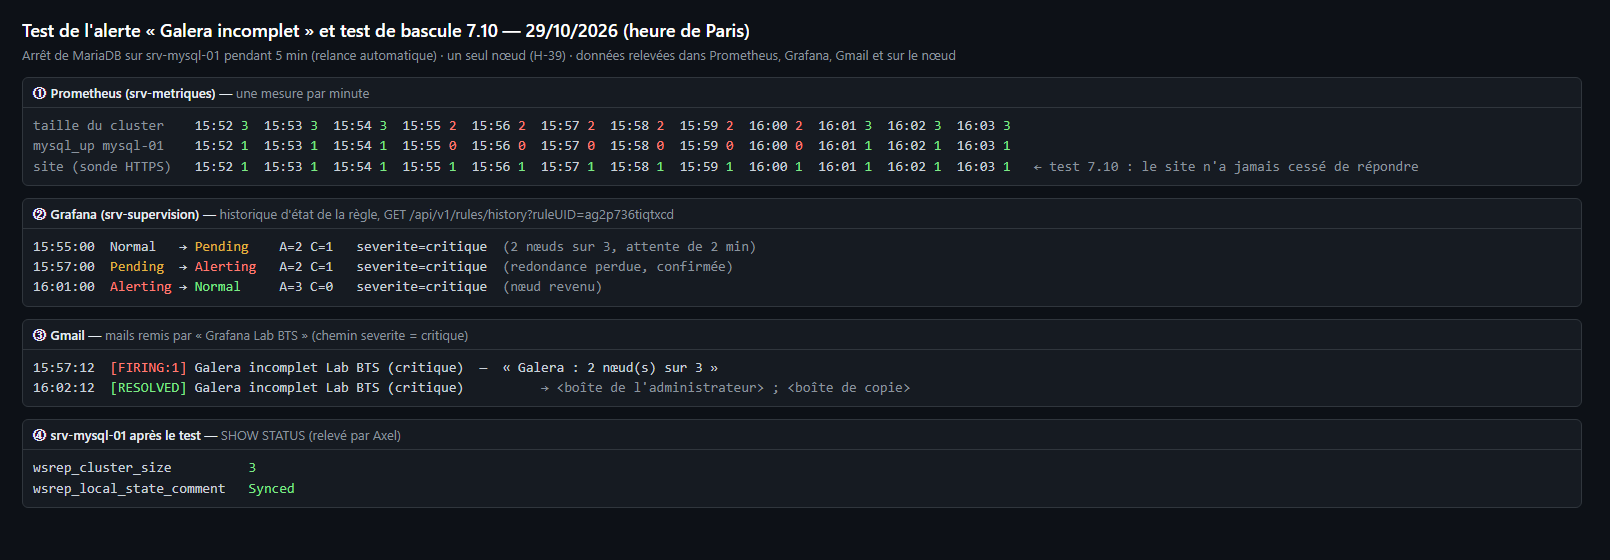
Figure 3 · Un nœud de base arrêté : les trois sources concordent (mesure, historique de la règle, mails).
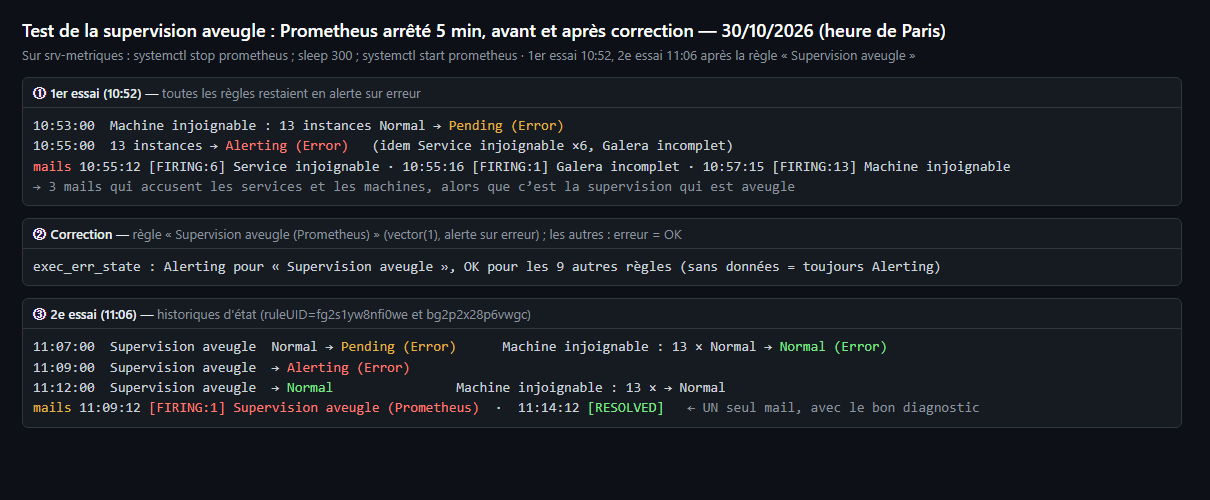
Figure 4 · Prometheus arrêté : trois mails trompeurs au premier essai, un seul après correction.
Bilan critique
Ce qui a coincé. Toutes les règles passaient en alerte quand Prometheus ne répondait plus : trois mails accusaient les services et les machines alors que seule la supervision était aveugle. J’ai séparé l’état d’erreur de l’absence de données et créé une règle dédiée. Plus tard, en perdant la majorité du cluster, c’est Grafana qui est tombé avec sa base : une seule alerte est partie, mais son résumé accusait Prometheus à tort. J’ai gardé la base dans le cluster, parce que l’utiliser fait partie du projet, et reformulé la règle avec ses deux causes possibles ; le risque est écrit comme dette technique.
Les tests ont aussi montré deux faiblesses de la détection : la seconde de deux intrusions rapprochées n’envoyait qu’un mail de résolution (fenêtre de comptage portée de 5 à 15 minutes), et un serveur retiré par le répartiteur pendant 18 minutes n’avait déclenché aucun mail (une règle « Serveur retiré par HAProxy » a été ajoutée). Enfin, une sonde ajoutée le 5 novembre produisait 77 % des journaux : le bruit a été coupé à la source, les erreurs gardées.
Les limites que j’assume.
- Le délai de détection annoncé était de 2 minutes ; mesuré, il va jusqu’à 3 minutes (intervalle de mesure et attente avant envoi). Le dossier dit maintenant 3 minutes.
- Seul le premier niveau de l’escalade est automatisé ; les niveaux 2 et 3 décrivent ce que GSB ferait en entreprise.
- L’hyperviseur est unique : une panne de l’hyperviseur coupe aussi la supervision.
- L’exercice d’incident conduit par un tiers reste à faire (janvier 2027).
Ce que je referais autrement. Je testerais chaque règle en coupant sa source dès sa création, au lieu de tester toutes les règles d’un coup à la fin : les trois défauts trouvés l’auraient été plus tôt.
Outils et aides. Les choix et les décisions sont les miens, ainsi que les étapes écrites à la première personne. Un assistant IA (Claude Code) a exécuté une partie des commandes et m’a aidé à rédiger la documentation, que j’ai relue.
Documents et productions associés
- MO-13 · Superviser un lab avec Prometheus
- MO-14 · Accès sûr au cluster Galera par un HAProxy local
- MO-15 · Centraliser les journaux avec rsyslog
- MO-16 · Journaux Windows avec Fluent Bit
- MO-17 · Grafana, sa base dans le cluster, et les alertes
- Première alerte de bout en bout (29 octobre 2026)
- Contrat de service, dossier de choix, dossier d'architecture technique
- Plan de tests (39 tests) et rapport de tests
Compétences mobilisées
- Exploiter des référentiels, normes et standards adoptés par le prestataire informatique
- Traiter des demandes concernant les services réseau et système, applicatifs
- Analyser les objectifs et les modalités d'organisation d'un projet
- Planifier les activités
- Évaluer les indicateurs de suivi d'un projet et analyser les écarts