


Supervision, journaux centralisés et alertes sur l'infrastructure de GSB
Prometheus, Grafana et rsyslog sur le cluster de bases : un tableau de bord, 17 alertes éprouvées panne par panne, un contrat de service mesuré.
Fiche officielle · bientôt disponible
Conditions de réalisation
Ressources fournies : le laboratoire existant (pare-feu pfSense, cinq zones VLAN : WEB, BDD, ADM, USERS et VISITEURS, serveurs web et base en grappe de trois nœuds, Active Directory, bastion, sauvegarde nocturne), son plan d’adressage et son schéma (le schéma et les flux du lab).
Contexte et besoin de GSB. Les serveurs du siège rendent des services à toute l’entreprise (annuaire, DHCP / DNS, messagerie, intranet, bases de données, application de suivi des visites). Les visiteurs répartis sur le territoire ont besoin d’un service continu. La DSI veut être alertée avant les utilisateurs, réagir selon la gravité et protéger les services essentiels quand le réseau est chargé.
Cadre juridique. Les journaux contiennent des données personnelles (identifiants, adresses, connexions). Base légale : l’intérêt légitime de GSB à garantir la sécurité de son système d’information (RGPD, article 6.1.f). Durées : recommandation CNIL 2021-122, soit authentification 1 an, autres journaux 6 mois, métriques 30 jours. Information des personnes par la charte informatique de GSB, inscription au registre des traitements, accès en lecture seule, aucun transfert hors de l’Union européenne pour les journaux.
Description des ressources documentaires, matérielles et logicielles utilisées
| Type | Liste (avec versions) |
|---|---|
| Documentaires | Lettre de mission N4 ; conventions GSB ; DAT d’infrastructure v1.0 ; modes opératoires MO-13 à MO-17 ; recommandation CNIL 2021-122 sur la journalisation |
| Matérielles | Hyperviseur pve-01 (Proxmox VE 9.1.2) ; deux machines virtuelles dédiées dans la zone d’administration (srv-metriques, srv-supervision), 2 vCPU, 2 Gio en ballooning, 32 Gio chacune ; une machine de test dans la zone VISITEURS (poste-visiteur, 1 vCPU, 1 Gio, 16 Gio) |
| Logicielles | Prometheus 2.53.3 ; blackbox exporter 0.26.0 ; node_exporter (pfSense 1.11.0) ; mysqld_exporter 0.17.2 ; windows_exporter 0.31.9 ; Grafana 13.2.4 (base dans le cluster) ; rsyslog 8.2504 ; Fluent Bit 5.1.3 ; HAProxy 3.0 local ; MariaDB 11.8.6 (Galera) ; Debian 13 ; Wazuh 4.14 et Suricata ; GLPI 11.0.12 et son agent 1.21 ; LogAnalyzer 5.0.2 ; relais SMTP chiffré pour les alertes |
Descriptif de la réalisation
Solution retenue et alternatives écartées. Retenue : Prometheus (mesures), rsyslog vers le cluster de bases (journaux), Grafana (écran et alertes, sa base dans le cluster) : un seul écran, et le cluster héberge des données réelles. Écartées : Zabbix seul (journaux faibles) ; Graylog (MongoDB et OpenSearch, trop lourd) ; Loki (journaux hors du cluster) ; Centreon et Icinga (pas de journaux, Icinga exige Redis) ; Uptime Kuma (disponibilité seulement).
Impact sur mon laboratoire existant. Deux machines supplémentaires dans la zone d’administration ; alias et règles de pare-feu dédiés (flux de mesures et de journaux, limités à un hôte source et à des ports précis, voir la matrice de flux) ; écriture des journaux et de la base de Grafana dans le cluster ; bruit des journaux réduit à la source ; horloges des zones web et base corrigées (NTP) ; zone VISITEURS ajoutée pour l’extension qualité de service. Mémoire globale du laboratoire à surveiller (30 Gio).
Mise en place. Étapes 46 à 52 de la documentation du laboratoire
et procédures MO-13 à MO-17 ; un script, ajouter-machine.sh, installe l’exporteur et le transfert des
journaux sur une nouvelle machine.
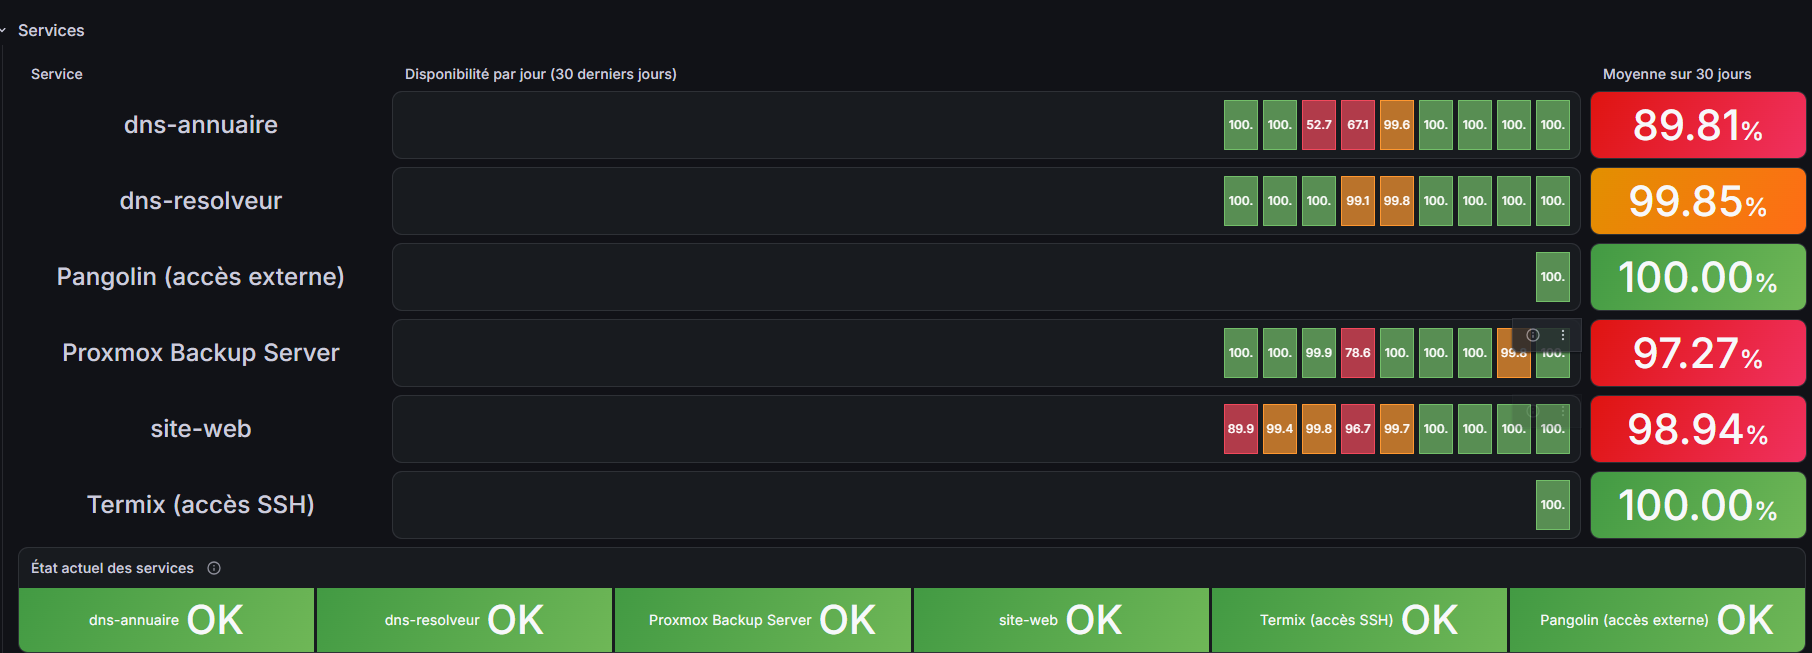
Tests réalisés. Sondes à probe_success = 1, cibles up, test de bout en bout d’un échec SSH et d’un
événement Windows 4625 dans le tableau de bord. Pannes provoquées avec alerte reçue : service, machine,
vrai arrêt de VM, nœud de base, sauvegarde, disque, mémoire, processeur, connexions refusées, arrêt de
Prometheus, site lent (29 et 30 octobre), perte de quorum du cluster (2 novembre). Non-régression du
cloisonnement vérifiée. Plan de tests : 39 tests, 38 réalisés ; reste l’exercice d’incident (janvier 2027).
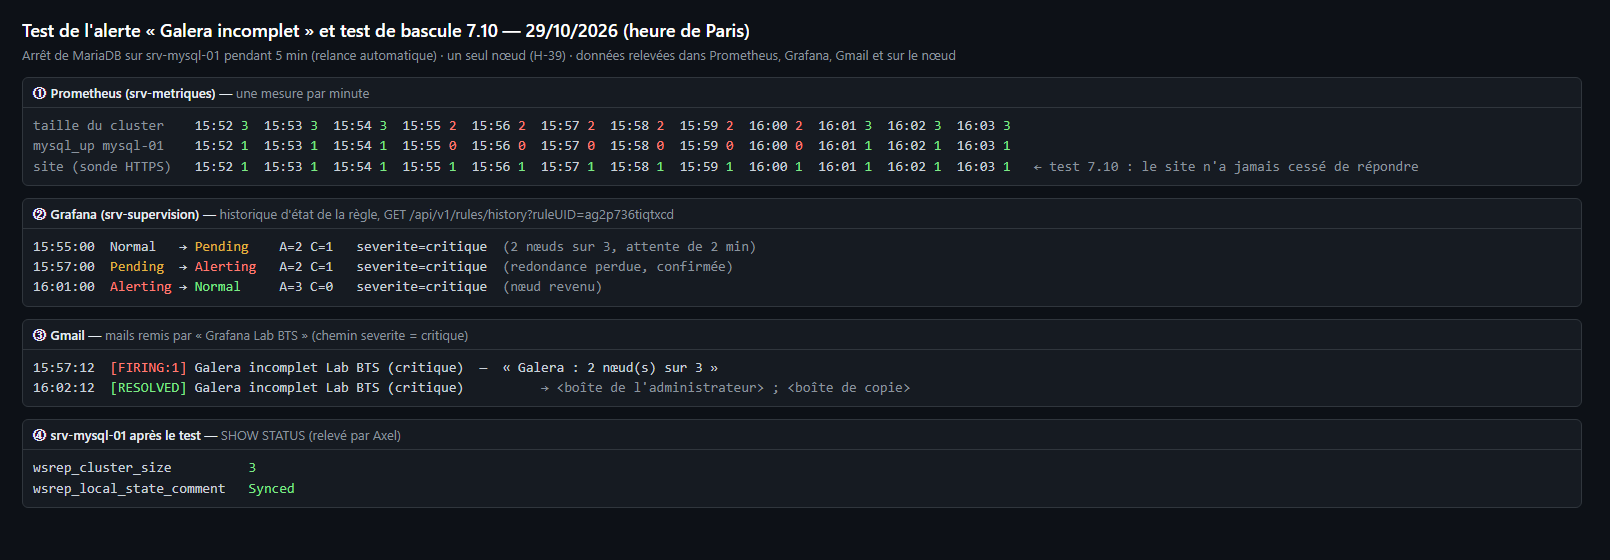
Exploitation : supervision, incident, mode dégradé. Alertes par e-mail, 17 règles, toutes éprouvées par une panne provoquée, à deux niveaux de gravité (critique : rappel toutes les heures ; avertissement : rappel toutes les 24 h) ; une règle « supervision aveugle » évite les mails trompeurs quand Prometheus tombe ou quand Grafana perd sa base. Les alertes de sécurité et celles qui durent plus de 2 heures ouvrent un ticket GLPI, rattaché à la machine et résolu automatiquement au retour à la normale. Détection d’intrusion (Wazuh dans les machines, Suricata sur le réseau des zones USERS et VISITEURS) : ses alertes graves arrivent par le même circuit de mails. Escalade en trois niveaux : technicien, puis responsable du service Réseau et Système après 2 h, puis DSI avant le délai de reprise. Mode dégradé : un nœud de base arrêté, le site reste disponible ; arrêt réel d’une VM web sans coupure du site ; perte de quorum : le dernier nœud refuse d’écrire, puis le cluster se reforme seul.
Amélioration proposée au-delà du besoin. Limitation de débit de la zone VISITEURS, réalisée et mesurée le 12 novembre : plafond de 50 Mbit/s par sens pour toute la zone. Page d’accueil du site vue d’un poste salarié : 138 ms à vide, 344 ms quand un poste invité sature la zone sans limite, 136 ms avec la limite. La priorité au trafic de l’application de suivi n’est pas mise en place.
Modalités d’accès aux productions et à leur documentation
- MO-13 · Superviser un lab avec Prometheus
- MO-14 · Accès sûr au cluster Galera par un HAProxy local
- MO-15 · Centraliser les journaux avec rsyslog
- MO-16 · Journaux Windows avec Fluent Bit
- MO-17 · Grafana, sa base dans le cluster, et les alertes
- Première alerte de bout en bout (29 octobre 2026)
- Journal des incidents du laboratoire
- Fiches réflexes en cas d'incident
- Matrice de flux et règles de pare-feu
- Contrat de service, dossier de choix, DAT R1, plan et rapport de tests
Compétences travaillées
- Analyser un besoin exprimé et son contexte juridique
- Étudier l'impact d'une évolution d'un élément d'infrastructure sur le système informatique
- Élaborer un dossier de choix d'une solution d'infrastructure et rédiger les spécifications techniques
- Choisir les éléments nécessaires pour assurer la qualité et la disponibilité d'un service
- Maquetter et prototyper une solution d'infrastructure permettant d'atteindre la qualité de service attendue
- Déterminer et préparer les tests nécessaires à la validation de la solution d'infrastructure retenue
- Installer et configurer des éléments d'infrastructure
- Installer et configurer des éléments nécessaires pour assurer la continuité des services
- Installer et configurer des éléments nécessaires pour assurer la qualité de service
- Rédiger ou mettre à jour la documentation technique et utilisateur d'une solution d'infrastructure
- Tester l'intégration et l'acceptation d'une solution d'infrastructure
- Déployer une solution d'infrastructure
- Administrer sur site et à distance des éléments d'une infrastructure
- Automatiser des tâches d'administration
- Gérer des indicateurs et des fichiers d'activité des éléments d'une infrastructure
- Identifier, qualifier, évaluer et réagir face à un incident ou à un problème
- Évaluer, maintenir et améliorer la qualité d'un service