Contexte : BTS SIO — option SISR
Auteur : Axel GOUIRAND — BTS SIO option SISR (session 2027)
Environnement : Proxmox VE 9.1.2 (serveur pve-01 de l’établissement), pool SIO2527_AxelDate de début : 11/09/2026
Dernière mise à jour : 12/11/2026 (étape 76 : limitation de débit de la zone VISITEURS mesurée, test T21 ; étape 75 : charte informatique écrite, connue, contrôlée ; étape 74 : GPO « poste prêt à l’arrivée », LAPS, SSH par clé, phase 21 ; T-8, T-9, T-23 ; relecture complète des parties « état actuel » : §1 à §3 remis à jour (zone VISITEURS, machines, adresses, systèmes, schéma actuel)) ; 11/11/2026 (étape 73 : portail GLPI des salariés, connexion par l’annuaire en LDAPS ; H-97) ; 10/11/2026 (étape 72 : Matomo et site de GSB en ligne ; H-94 à H-96) ; 06/11/2026 (étapes 68 à 70 : alerte « serveur retiré », inventaire GLPI par entité, alertes → tickets ; étape 67 : LogAnalyzer, journaux bruts en direct, sonde Galera rendue silencieuse ; étape 65.3 : machine restaurée depuis la copie du NAS, phase 13 terminée ; règle « VM absente » réactivée) ; 05/11/2026 (étape 61 : GPO bannière et ping, posées et prouvées en PowerShell ; étape 62 : sonde de synchronisation Galera pour HAProxy, 10.23 ; étape 63 : export SQL nocturne, 13.8 ; étape 64 : site de GSB, public et intranet ; H-84 : lsyncd ; étape 65 : 2e copie hors site sur S3, H-85 ; étape 66 : GLPI, H-86) ; 04/11/2026 (59.7 : bruit des alertes Windows filtré, règles 100210 à 100213) ; 03/11/2026 (étape 59 : Wazuh, serveur de détection d’intrusion, premiers agents et mails (59.8) ; étape 60 : Suricata sur pfSense, zones VISITEURS et USERS, alertes lues par Wazuh (60.6) ; dettes T-17 et T-18)Documents liés : SUIVI-TP.md (avancement) · Matrice-de-flux.md (règles de pare-feu) · Troubleshooting.md (incidents) · Architecture.md (schémas)
Légende des statuts
Symbole
Signification
Étape réalisée et vérifiée (fonctionne)
Étape en cours
Étape planifiée, pas encore réalisée
Point d’attention / configuration temporaire à corriger
Seules les étapes sont considérées comme validées. Une étape n’est marquée qu’après vérification effective (capture d’écran ou test réseau à l’appui).
1. Objectif du lab
Mettre en place un pare-feu pfSense en frontal de 5 réseaux virtuels (VLAN) isolés, hébergés sur un hyperviseur
Proxmox VE, afin de simuler l’infrastructure d’une PME (le laboratoire GSB, entreprise fictive du BTS SIO).
Le projet est parti de 4 VLAN (septembre) ; la zone VISITEURS (VLAN 50) a été ajoutée le 30/10 (étape 55).
État au 12/11/2026 : 15 machines virtuelles (et un modèle de clonage), toutes supervisées et sauvegardées chaque nuit.
VLAN
Nom
Rôle
Machines en service
10
WEB
Zone applicative (« DMZ »)
srv-ha — répartiteur HAProxy (TLS) · srv-web-01 / srv-web-02 — Debian, Apache + PHP : WordPress (site de GSB, public par Pangolin depuis le 10/11), GLPI 11, Matomo (actif / secours)
AD-Core-01 — Windows Server 2025 Core, contrôleur du domaine sio.internal(un second contrôleur AD-Core-02 est prévu, reporté : dette T-8) · srv-docker — bastion Termix (SSH et RDP) · srv-pbs — sauvegarde · srv-metriques — Prometheus · srv-supervision — journaux, Grafana, LogAnalyzer · srv-wazuh — détection d’intrusion
40
USERS
Zone utilisateurs
poste-win11 — Windows 11 Pro, membre du domaine (un poste Debian joint par SSSD était prévu : abandonné le 05/11, inutile pour le lab)
50
VISITEURS
Zone invités, Internet seul(30/10)
poste-visiteur — Debian 13 sans interface, poste de test de la zone
pfSense assure : le routage inter-VLAN, le filtrage entre zones, le NAT vers le réseau
de l’établissement, le DHCP des VLAN 40 et 50, la résolution DNS de l’ensemble du lab, la détection
d’intrusion (Suricata, zones USERS et VISITEURS) et l’accès distant (Tailscale).
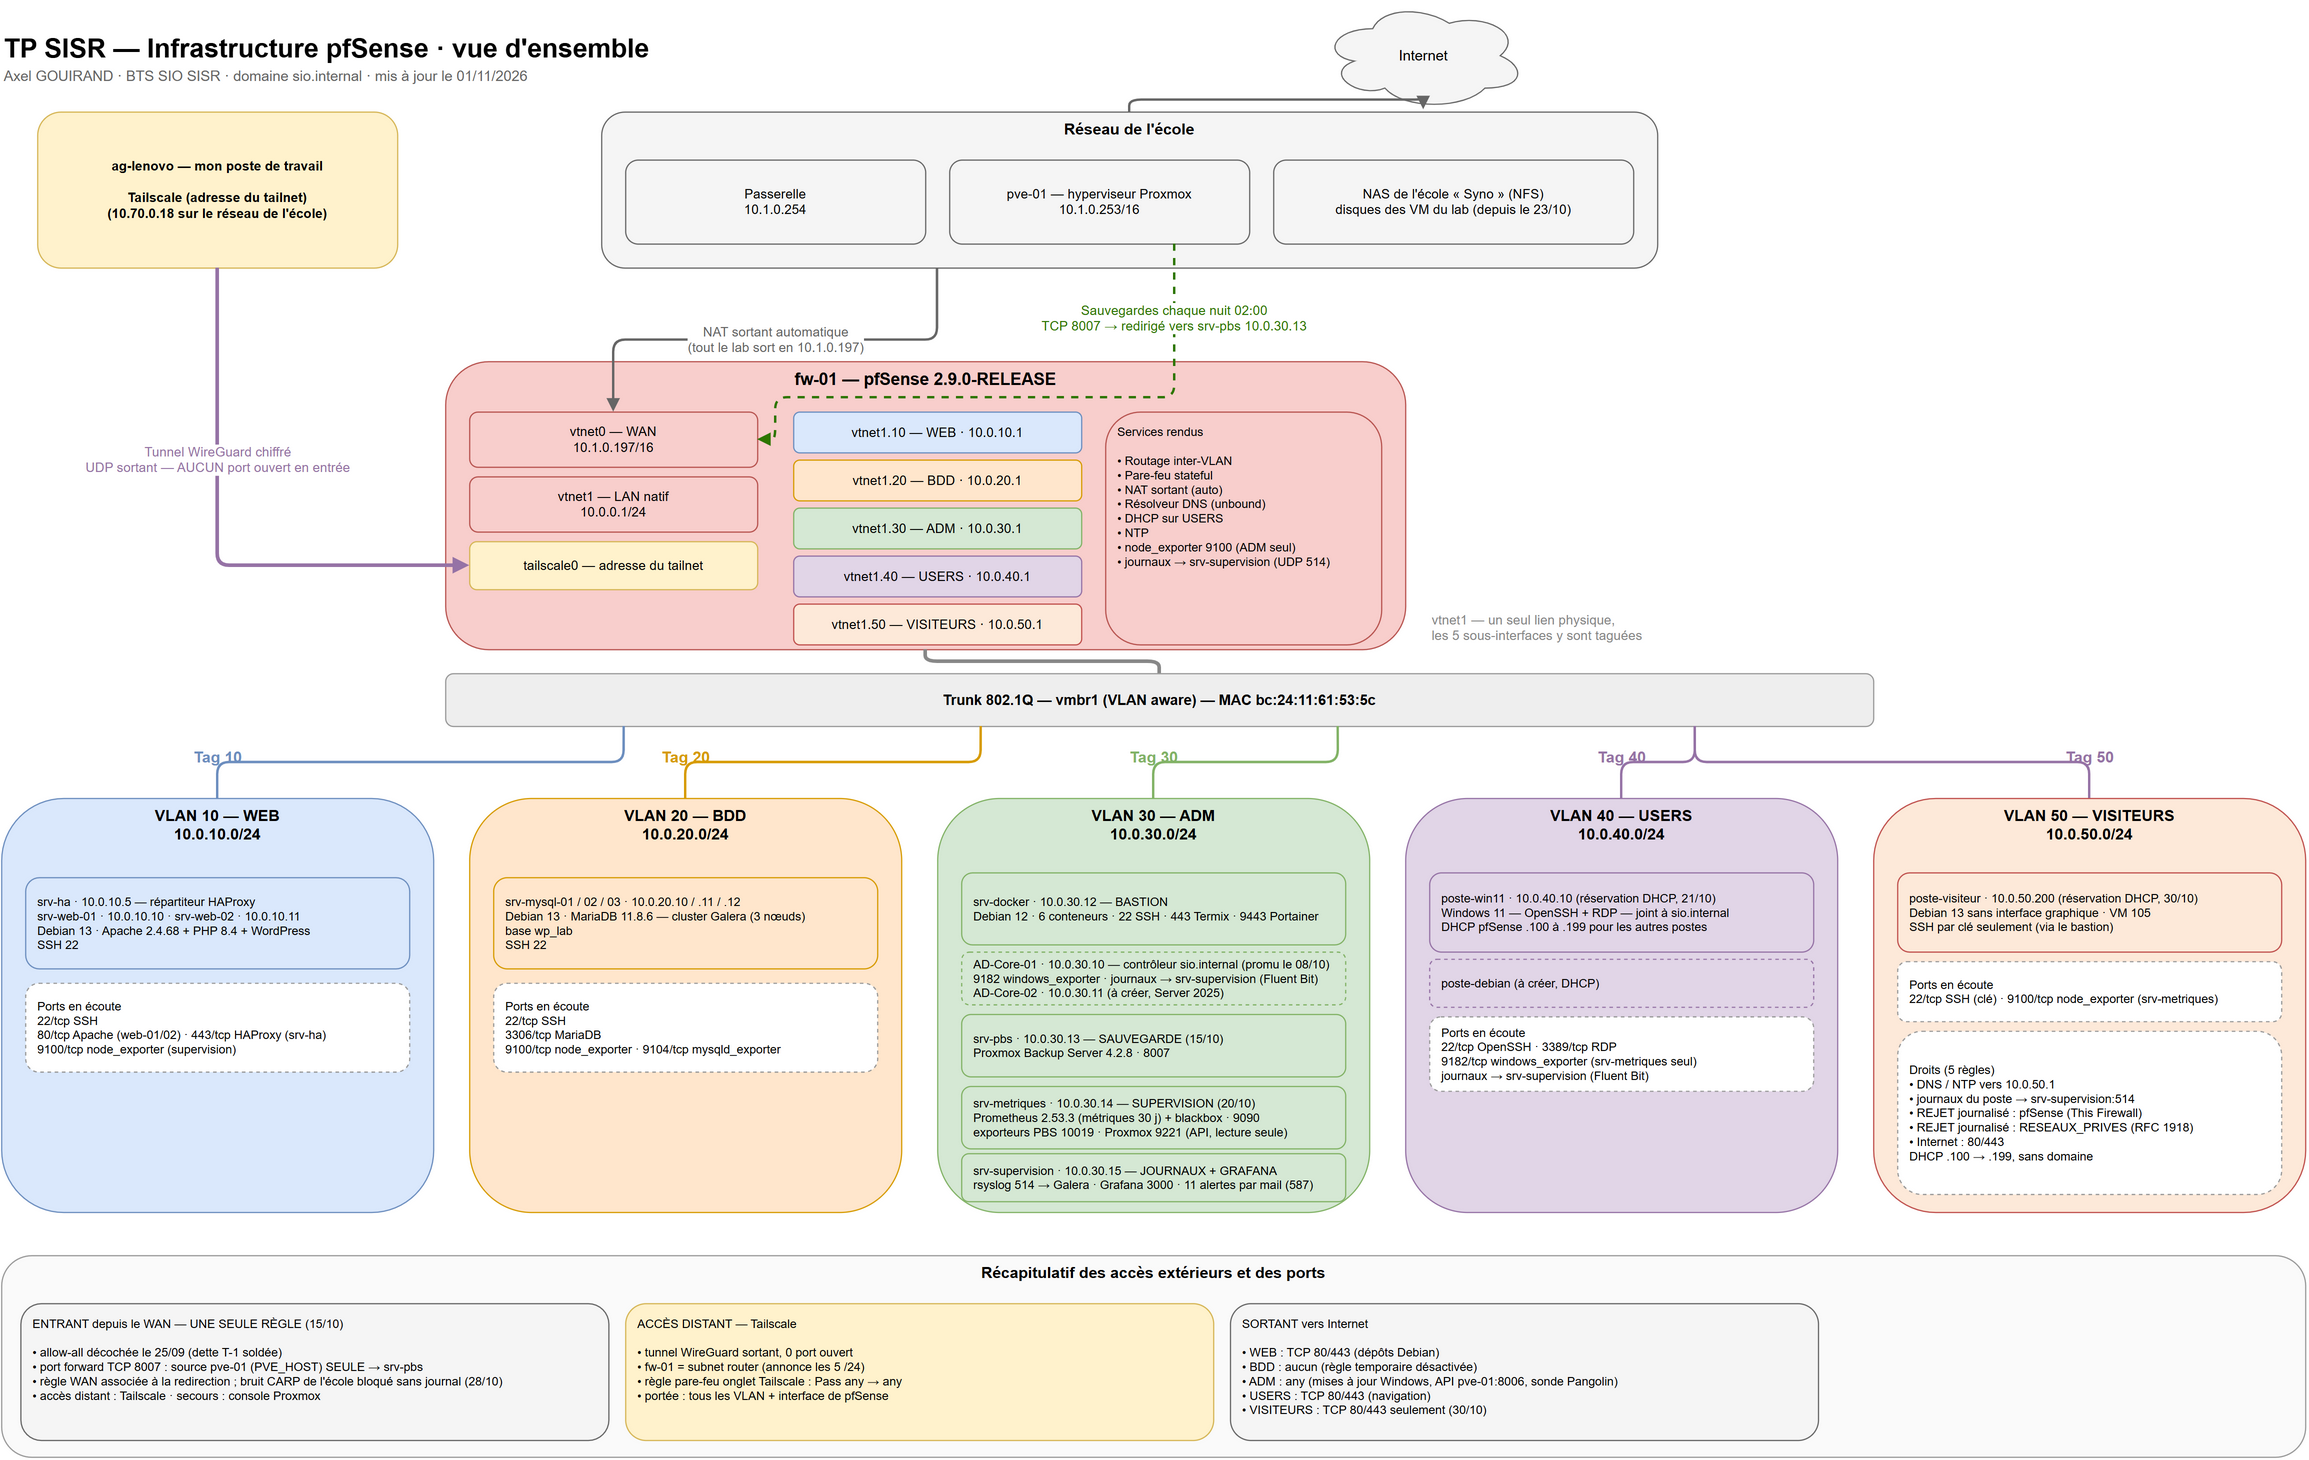
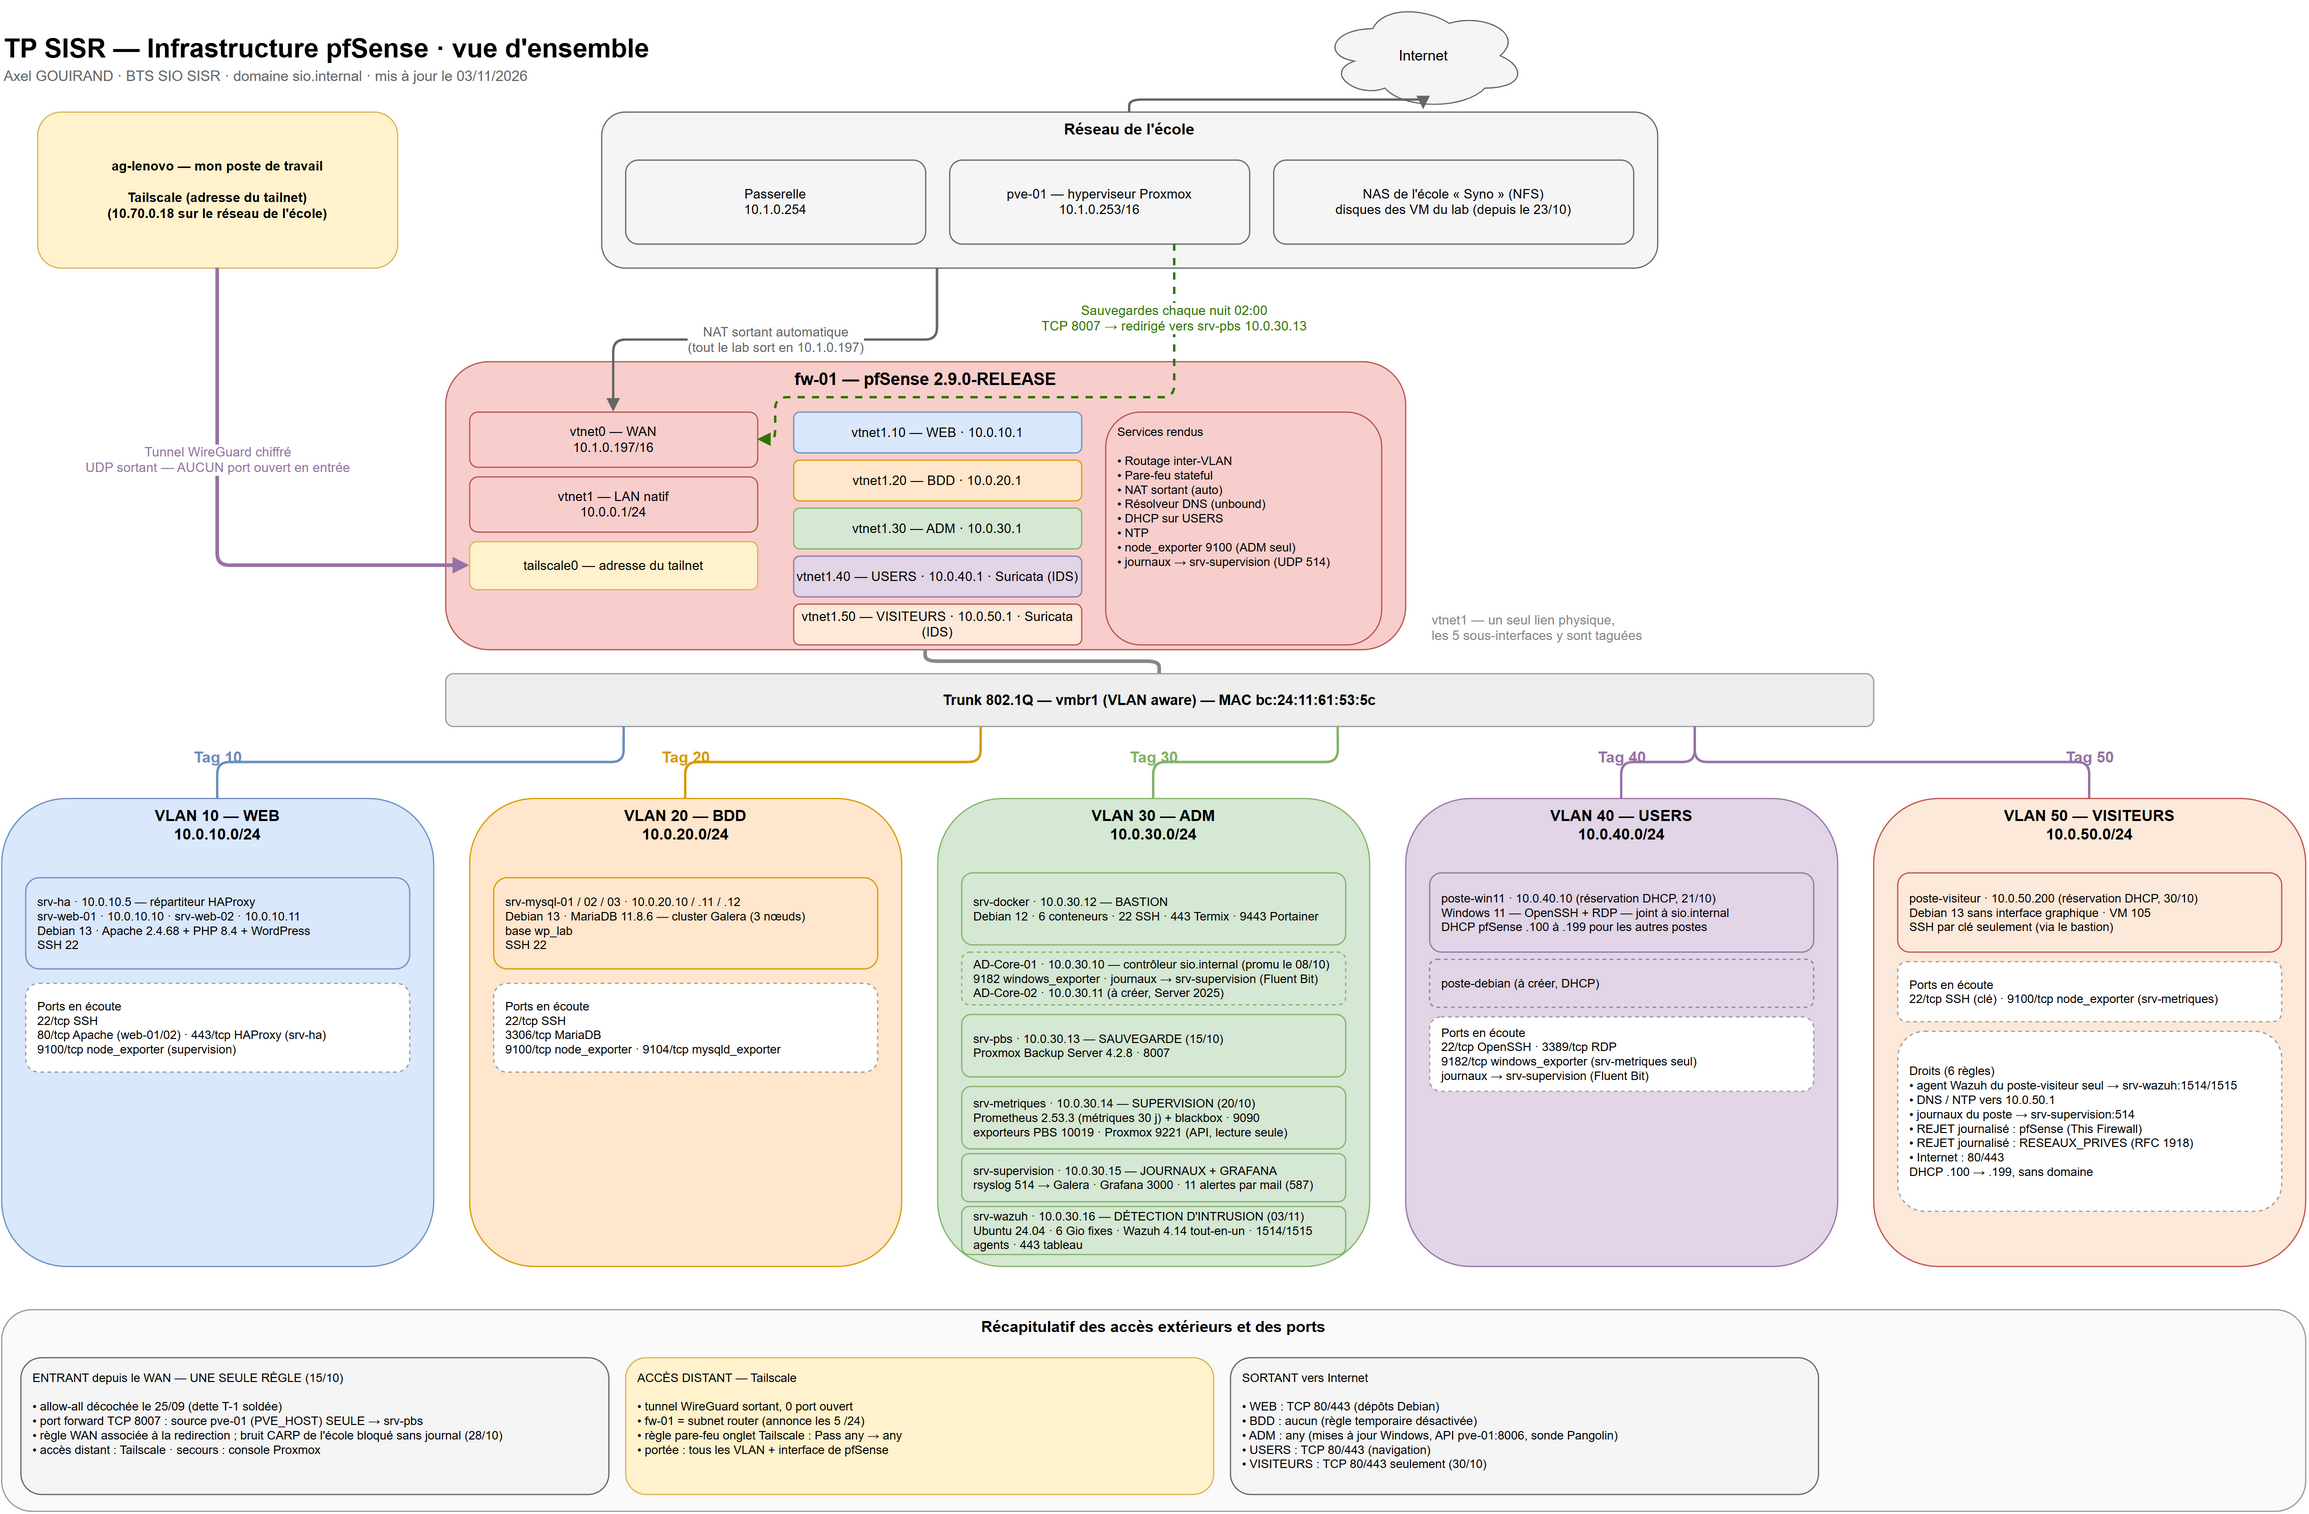
Schéma actuel
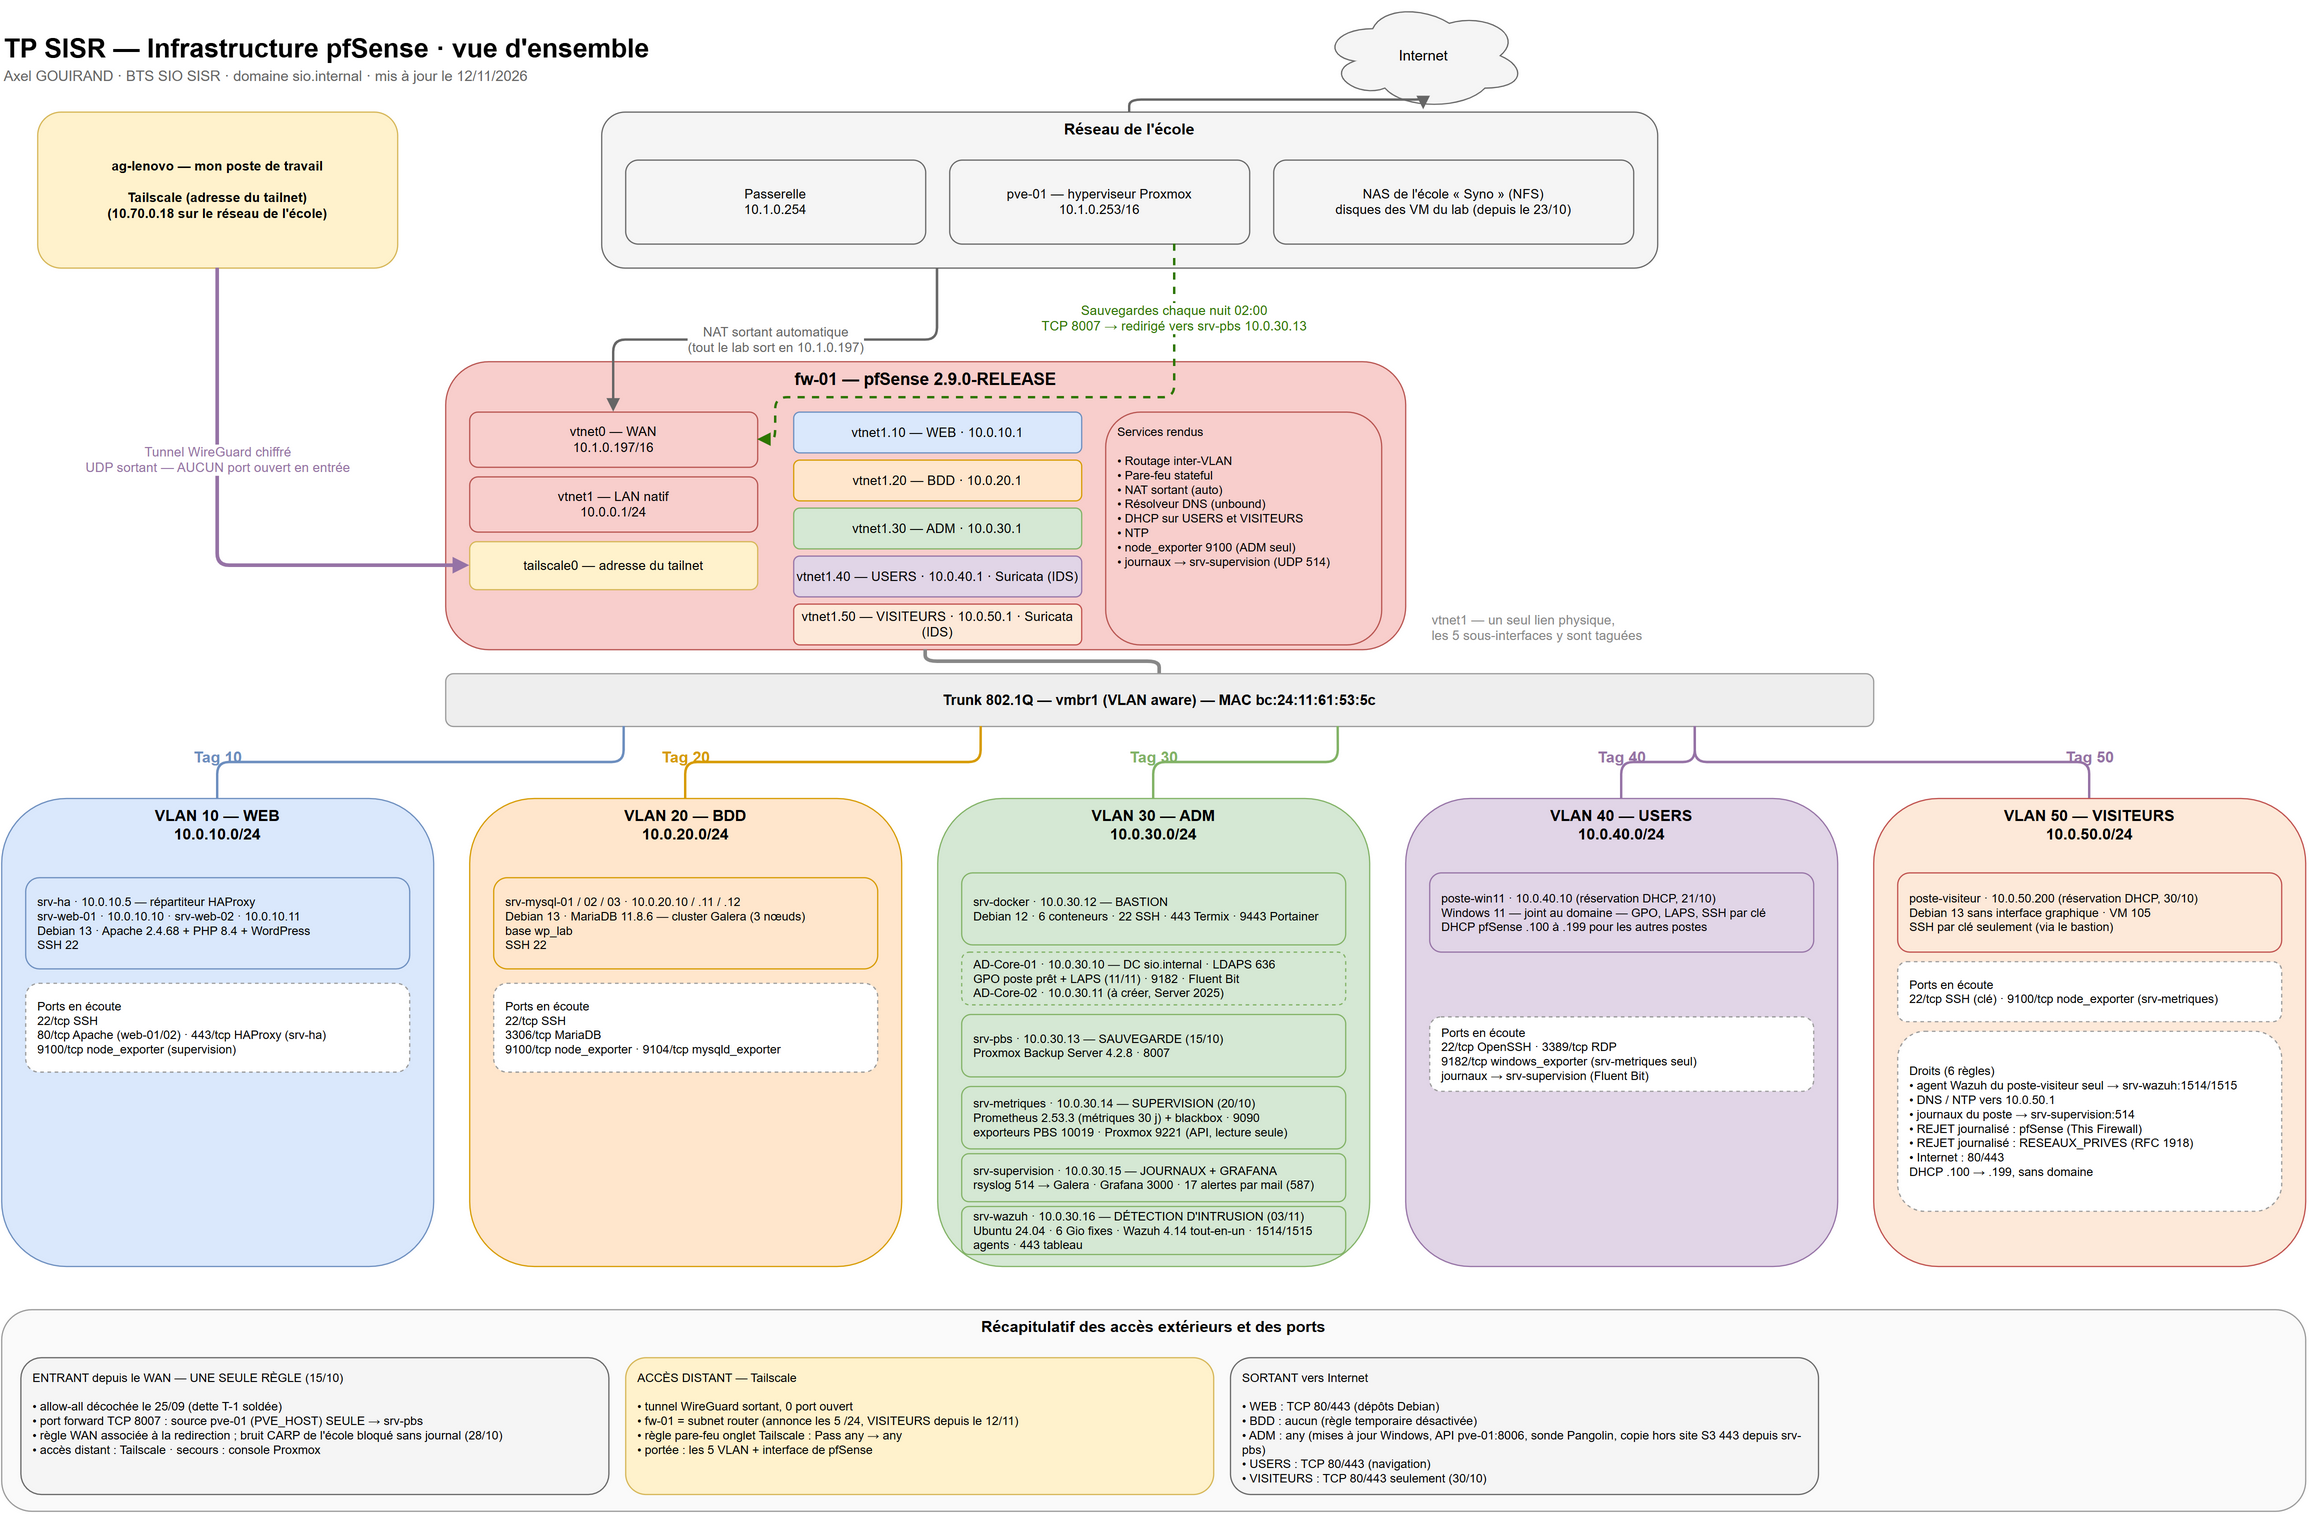
Vue d’ensemble au 11/11/2026, exportée du schéma schemas/Infrastructure-TP.drawio (7 pages : vue d’ensemble, flux et
ports, accès distant, cluster, Pangolin, sauvegarde, supervision).
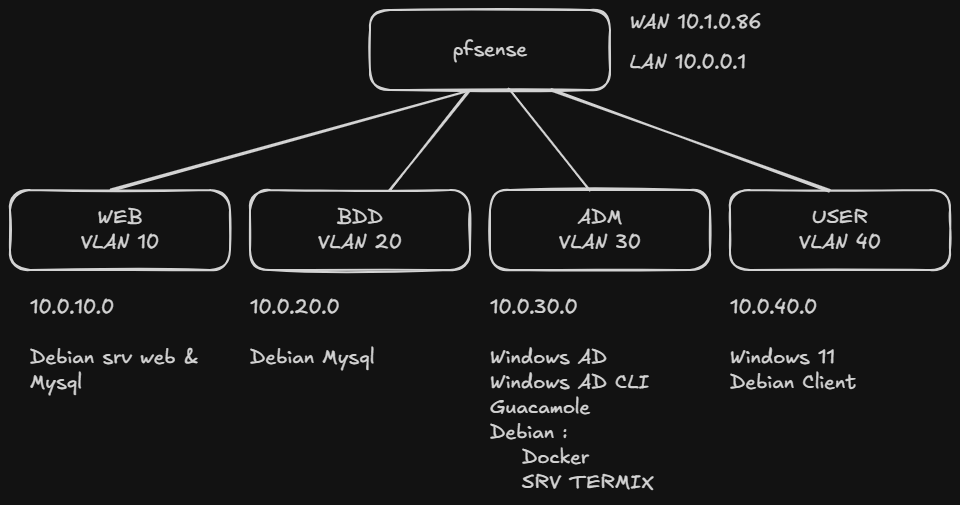
Schéma initial de septembre (au propre) — historique
Premier schéma (13/09), avant les phases suivantes : il montre encore le WAN en 10.1.0.86, un serveur Guacamole
(remplacé par Termix) et un client Debian (abandonné). Gardé pour l’historique.
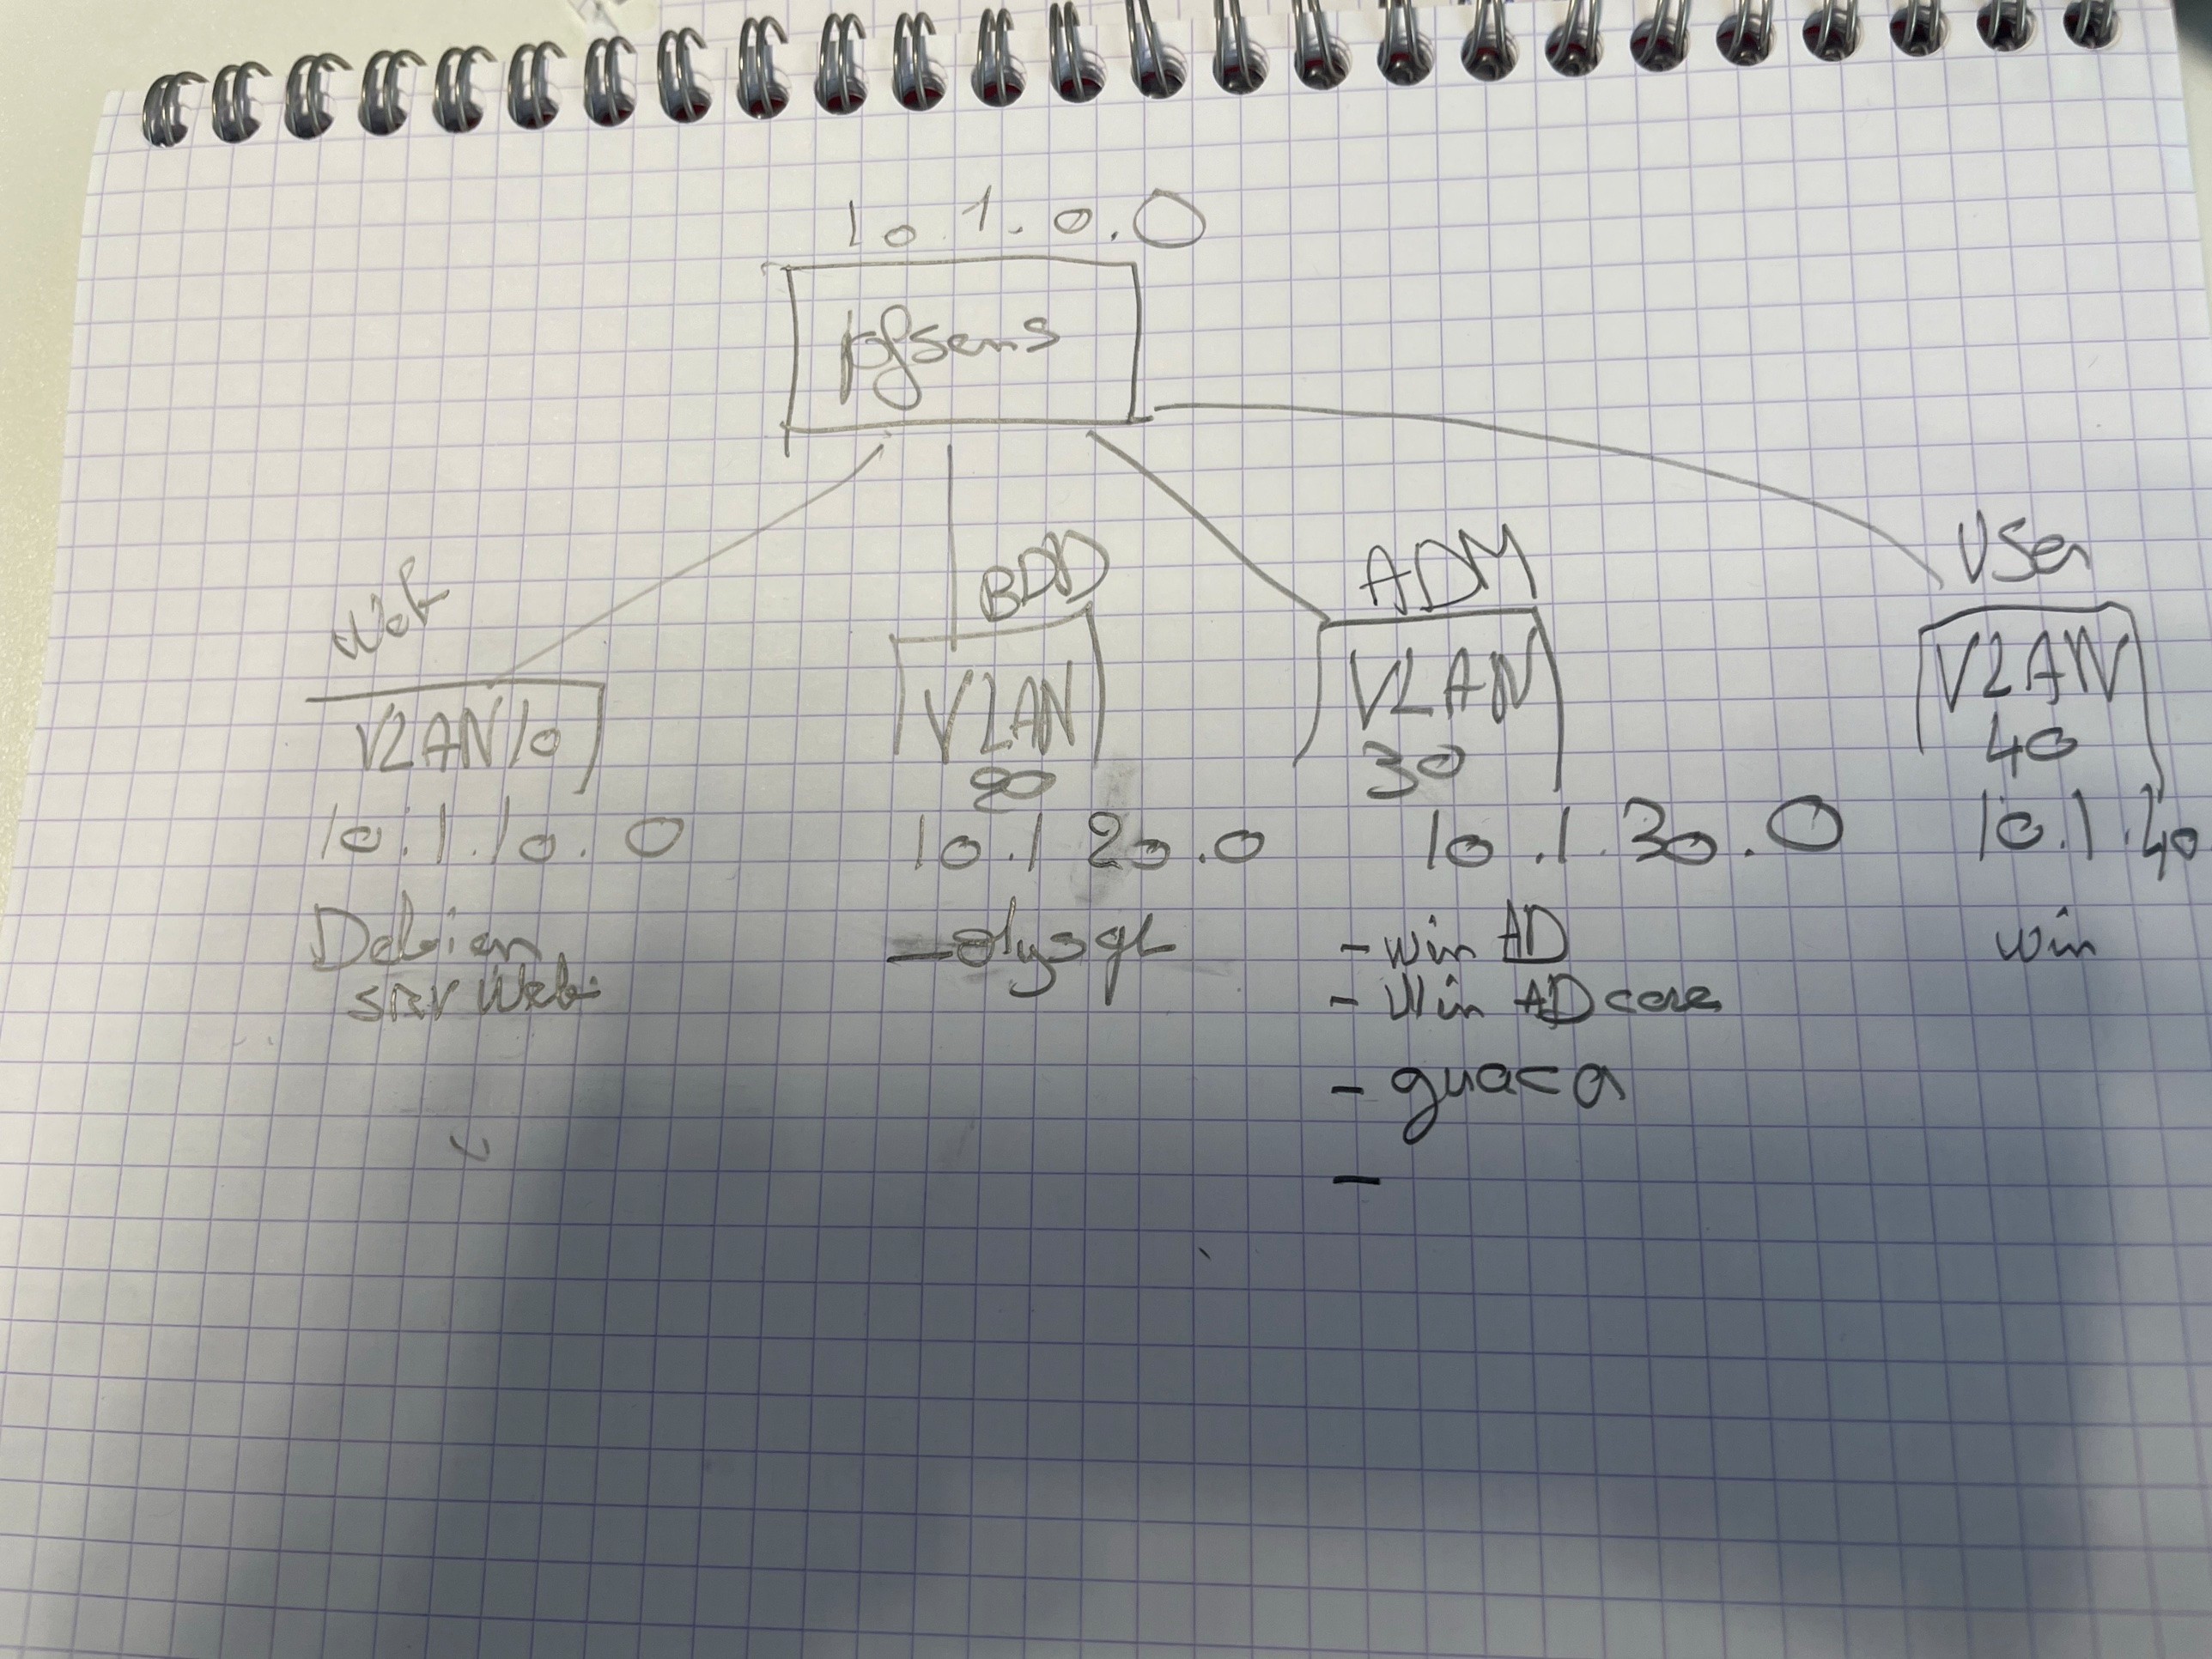
Schéma manuscrit d'origine
2. Plan d’adressage retenu
2.1 Tableau de référence
Interface
VLAN
Réseau
Masque
IP pfSense (passerelle)
Rôle
WAN (vtnet0)
—
10.1.0.0/16
255.255.0.0
10.1.0.197(adresse fixe depuis l’étape 15 ; 10.1.0.86 donnée par le DHCP de l’école au début du TP)
Sortie vers le réseau de l’établissement
LAN (vtnet1)
—
10.0.0.0/24
255.255.255.0
10.0.0.1
Interface de secours / trunk parent
WEB (vtnet1.10)
10
10.0.10.0/24
255.255.255.0
10.0.10.1
Zone applicative
BDD (vtnet1.20)
20
10.0.20.0/24
255.255.255.0
10.0.20.1
Zone données
ADM (vtnet1.30)
30
10.0.30.0/24
255.255.255.0
10.0.30.1
Zone administration
USERS (vtnet1.40)
40
10.0.40.0/24
255.255.255.0
10.0.40.1
Zone utilisateurs
VISITEURS (vtnet1.50)
50
10.0.50.0/24
255.255.255.0
10.0.50.1
Zone invités : Internet seul (30/10, étape 55)
L’attribution des adresses à l’intérieur de chaque réseau suit la convention par blocs du §2.4
et le détail du §2.5.
2.2 Justification de l’écart avec le schéma initial
Le schéma manuscrit prévoyait 10.1.10.0, 10.1.20.0, 10.1.30.0, 10.1.40.0. (Les adresses de cette section sont celles de septembre ; le WAN est depuis en adresse fixe 10.1.0.197, étape 15.)
Problème identifié : l’interface WAN reçoit par DHCP l’adresse 10.1.0.86 avec un masque /16. Le réseau de l’établissement couvre donc :
10.1.0.0/16 = 10.1.0.0 → 10.1.255.255
Cette plage contient déjà les quatre sous-réseaux du schéma. pfSense se serait retrouvé avec deux routes concurrentes vers les mêmes adresses (une via le WAN, une via le VLAN). En pratique la règle du longest prefix match fait gagner le /24, mais toute machine réelle de l’établissement située en 10.1.10.x, 10.1.20.x, 10.1.30.x ou 10.1.40.x serait devenue définitivement injoignable depuis le lab.
Correction retenue : bascule sur le préfixe 10.0.X.0/24, qui :
ne chevauche aucune plage de l’établissement,
conserve la logique de lecture du schéma (VLAN 20 → 10.0.20.0),
reste cohérent avec l’adresse LAN déjà en place (10.0.0.1).
2.3 Pourquoi un masque /24 et pas /16
Un masque /16 ne prend en compte que les deux premiers octets :
Tous les VLAN désigneraient le même réseau. pfSense refuse cette configuration (subnet overlaps with interface LAN), et surtout cela annulerait l’intérêt même du découpage en VLAN : séparer les domaines de diffusion.
Un masque /24 prend en compte les trois premiers octets, ce qui rend chaque VLAN distinct, avec 254 adresses utilisables — largement suffisant pour ce lab.
2.4 Découpage interne de chaque /24 (convention canonique)
Chaque VLAN suit le même découpage par blocs, plutôt qu’une attribution au fil de l’eau :
Plage
Usage
.1
Passerelle (pfSense)
.2 → .9
Équipements réseau
.10 → .49
Serveurs à IP fixe
.50 → .99
Périphériques fixes (imprimantes, NAS)
.100 → .199
Plage DHCP
.200 → .249
Réservations DHCP / invités
.250 → .254
Réservé
Pourquoi des blocs ? L’adresse devient auto-documentée. 10.0.30.11 se lit immédiatement
« serveur du VLAN 30 » ; 10.0.40.137 se lit « poste client en DHCP ». Cela accélère le
diagnostic et permet d’écrire des règles de pare-feu sur des plages plutôt que machine par machine.
Le schéma initial plaçait WordPress dans le VLAN 20 avec MySQL. WordPress étant une application
web (PHP + Apache) et non une base de données, les deux couches ont été séparées :
VLAN 10 WEB                        VLAN 20 BDD
┌──────────────────┐               ┌──────────────────┐
│ Apache + PHP     │── 3306 ──────►│ MySQL            │
│ WordPress        │               │ base wp_lab      │
│ 10.0.10.10       │               │ 10.0.20.10       │
└──────────────────┘               └──────────────────┘
   joignable par                      jamais joignable
     les USERS                          par les USERS
Justification : si le site WordPress est compromis — ce qui est fréquent sur un CMS non à jour
— l’attaquant obtient un accès dans le VLAN 10. Il ne peut alors atteindre la base que sur le
port 3306, et non prendre le contrôle du serveur de données. Les deux couches réunies sur une
même machine s’effondreraient ensemble.
C’est également ce qui donne un usage concret à la règle SRV_WEB → SRV_MYSQL : 3306 de la
matrice de flux, et un flux inter-VLAN réellement démontrable en phase de tests.
Depuis la phase 10 (étapes 28 à 31) : la même séparation est gardée, mais redondée : deux serveurs web derrière
le répartiteur srv-ha, et une base en cluster Galera de trois nœuds. Les serveurs web ne joignent plus la base
directement : seul srv-ha le fait (règle SRV_HA → GALERA_NODES : 3306). Voir le schéma, page « Cluster et répartition ».
Conséquence du DHCP désactivé sur les VLAN 10, 20 et 30 : les VM de ces zones ne
recevront aucune adresse au démarrage. L’IP doit être saisie manuellement — pendant
l’installation pour Debian, après installation pour Windows Server. Une VM sans réseau au
premier démarrage dans ces VLAN n’est pas une panne.
Client VLAN 40 membre du domaine hébergé en VLAN 30
Nom de domaine AD
sio.internal
TLD réservé par l’ICANN (2024) pour l’usage privé
DNS
pfSense = résolveur central · AD = autoritaire sur sio.internal, forward vers pfSense
Architecture applicative
2-tier : WordPress en VLAN 10, MySQL en VLAN 20
séparation applicatif / données
Bastion
srv-docker (10.0.30.12) : Termix, en conteneurs — SSH et bureau à distance. Entrée depuis ADM et USERS, sortie limitée à 3389 + 22
Poste client Linux
poste-debian joint au domaine via realmd / SSSD
abandonné le 05/11 (décision d’Axel : inutile pour le lab)
ICMP
Autorisé entre VLAN pendant le TP, restreint en phase 8
Adressage serveurs
IP fixes, DHCP réservé aux postes clients
Publication du site web
Non publié côté WAN ; depuis le 10/11, site public de GSB par un tunnel Pangolin sortant (aucun port ouvert sur le WAN, règles HAProxy du nom public, étape 72)
Nommage des interfaces
WEB / BDD / ADM / USERS / VISITEURS (fonctionnel)
Contrôleurs de domaine
Deux DC prévus ; un seul en service (AD-Core-01, Core) : le second est reporté
dette T-8 (point de défaillance unique)
Admin de pfSense
VLAN 30 + accès distant par Tailscale (VPN) ; l’accès depuis le WAN est fermé depuis le 25/09 (dette T-1 soldée)
Installation MySQL
Ouverture Internet temporaire puis fermeture
dérogation — le canon impose un miroir/proxy de dépôts
Les dérogations restantes sont des compromis de lab assumés et documentés. Le canon est rappelé
en regard afin de pouvoir l’exposer et le justifier.
Architecture DNS : résolveur centralisé
Le réseau de l’établissement présentant des défaillances DNS récurrentes, le réflexe naturel
serait de distribuer un résolveur public (8.8.8.8) en secours aux postes clients. Cette
approche a été écartée au profit d’une centralisation sur pfSense :
poste-win11 (10.0.40.10)
     │  DNS = 10.0.40.1   ← une seule adresse, jamais modifiée
     ▼
  pfSense / unbound  ──►  1.1.1.1  ou  8.8.8.8
     ▲                    (le secours vit ici)
     │
  cache partagé par toutes les VM, journaux centralisés
Réglage
Emplacement
Valeur
Serveurs DNS de pfSense
System → General Setup
1.1.1.1, 8.8.8.8
DNS Server Override
System → General Setup
décoché
Mode de résolution
Services → DNS Resolver
Forwarding Mode activé
DNS distribué aux clients
Services → DHCP Server → USERS (et → VISITEURS)
10.0.40.1seul (VISITEURS : 10.0.50.1)
Trois raisons de ce choix :
① La cause racine était l’option DNS Server Override. Activée par défaut, elle laisse le
bail DHCP du WAN injecter les serveurs de l’établissement (10.1.0.150, 10.2.0.150) dans la
liste de pfSense — qui interrogeait donc lui-même les serveurs défaillants. La décocher supprime
le problème pour pfSense et pour toutes les VM d’un coup.
② Un DNS public en secours sur les postes casserait l’Active Directory. Interrogé sur
SRV-AD.sio.internal, un résolveur public répond — il répond NXDOMAIN, « ce nom n’existe
pas ». Windows prend cette réponse pour définitive et ne réessaie pas ailleurs. Ouvertures de
session, GPO et réplication deviennent intermittentes selon le serveur interrogé. La
recommandation Microsoft est catégorique : une machine membre d’un domaine ne liste que des
DNS internes.
③ Le secours ne disparaît pas, il remonte d’un étage. Les postes ne connaissent qu’une
adresse ; c’est pfSense qui détient les deux résolveurs publics et bascule de l’un à l’autre. La
redondance est conservée, et un changement de fournisseur DNS se fait à un seul endroit sans
toucher aucune VM.
Mode Forwarding plutôt que récursif : en récursif, unbound interroge lui-même les
serveurs racine puis les TLD — plus autonome, mais multipliant les échanges sortants, donc
sensible à un réseau filtrant que l’on ne maîtrise pas. En Forwarding, une seule destination,
comportement prévisible. 1.1.1.1 et 8.8.8.8 gérant DNSSEC, la validation reste active.
Aucune règle de pare-feu n’est nécessaire pour que pfSense sorte en DNS : les règles
d’interface filtrent ce qui traverse le pare-feu, pas ce qu’il génère lui-même.
Pourquoi sio.internal et pas sio.local
.local est réservé au protocole mDNS (RFC 6762) et explicitement déconseillé par Microsoft
pour un domaine Active Directory. .internal a été réservé par l’ICANN en 2024 pour l’usage
privé — c’est l’équivalent, pour les noms, de ce que sont les adresses RFC 1918 pour les IP.
En production, le canon Microsoft reste un sous-domaine d’un domaine réellement possédé
(ad.masociete.fr).
Windows Server 2025 — installation Core (sans interface graphique)
poste-win11
Windows 11 Pro(édition Pro ou Entreprise obligatoire pour joindre un domaine)
2.7 Règles de pare-feu
La matrice de flux complète et les règles détaillées par interface font l’objet d’un document
dédié : Matrice-de-flux.md.
3. Environnement technique
Élément
Valeur
Hyperviseur
Proxmox VE 9.1.2 (pve-01, 10.1.0.253)
Version pfSense installée
2.9.0-RELEASE (amd64), base FreeBSD 16.0-CURRENT
Image d’installation d’origine
pfSense CE 2.7.0 (mise à jour ensuite en 2.9.0)
vCPU
2
RAM
2 Go
Identifiant VM Proxmox
103 — SIO2527-pfSense-Axel, nœud pve-01
Nom d’hôte pfSense
SIO2527-pfSense-axel.home.arpa
Disque
32 Go (scsi0, qcow2) — partitionnement UFS / GPT
Carte réseau 1
VirtIO → vtnet0 → WAN
Carte réseau 2
VirtIO → vtnet1 → LAN / trunk VLAN
Serveurs DNS transmis par le DHCP école (au début du TP, avant l’adresse WAN fixe)
10.1.0.150, 10.2.0.150
Serveurs DNS publics ajoutés
8.8.8.8, 1.1.1.1
4. Procédure pas à pas
Étape 1 — Création de la VM pfSense sous Proxmox
Paramètres retenus :
Onglet
Paramètre
Valeur
General
Name
pfsense
OS
Type
Other
Disks
Taille
32 Go
CPU
Cores
2
Memory
RAM
2048 Mo
Network
Bridge
vmbr0
Network
Model
VirtIO (paravirtualized)
Pourquoi VirtIO ? C’est le pilote paravirtualisé de Proxmox : la VM « sait » qu’elle est virtualisée et dialogue directement avec l’hyperviseur, sans émulation de matériel. Résultat : de bien meilleures performances réseau. C’est aussi ce qui donne le nom d’interface vtnet côté FreeBSD/pfSense (une carte émulée Intel E1000 s’appellerait em0).
Étape 2 — Installation de pfSense
Déroulé de l’installateur :
Acceptation de la licence
Install pfSense
Choix du clavier : French (AZERTY)
Partitionnement : Auto (UFS) — GPT
Installation, puis Reboot
UFS ou ZFS ? ZFS apporte snapshots et sommes de contrôle, mais consomme nettement plus de RAM. Avec 2 Go alloués, UFS est le choix adapté.
Résultat attendu au reboot : le menu console pfSense s’affiche avec ses options numérotées.
Étape 3 — Affectation des interfaces
À l’issue de l’installation, pfSense n’a détecté qu’une seule carte (vtnet0), assignée en WAN en DHCP. Elle a obtenu l’adresse 10.1.0.86/16 du serveur DHCP de l’établissement.
Une seconde carte réseau a ensuite été ajoutée à la VM depuis Proxmox (VM → Hardware → Add → Network Device), puis assignée en LAN dans pfSense (menu console, option 1) Assign Interfaces), avec l’adresse temporaire 10.0.0.1.
Configuration temporaire : cette interface LAN sert d’accès de secours. Elle deviendra l’interface parente du trunk portant les VLAN 10/20/30/40.
Étape 4 — Activation de l’accès webConfigurator depuis le WAN
Par défaut, pfSense bloque tout accès à son interface d’administration depuis le WAN. Or dans ce lab, le poste de travail se trouve du côté WAN (réseau de l’école).
Depuis la console pfSense (option 8) Shell) :
pfSsh.php playback enableallowallwan
L’interface est alors joignable sur https://10.1.0.86.
RÈGLE TEMPORAIRE — À SUPPRIMER
Cette commande crée une règle allow all sur le WAN. Elle ouvre le pare-feu en grand et doit être retirée une fois l’administration possible depuis le VLAN 30 (ADM) :
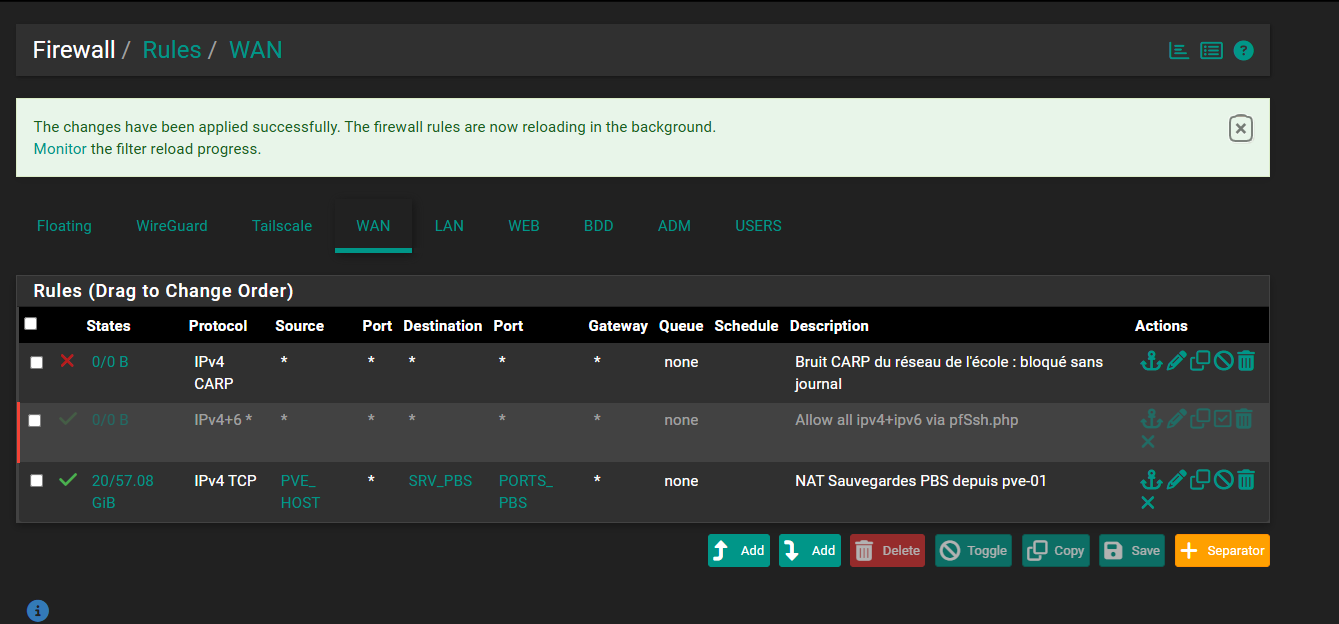
Pare-feu → Règles → onglet WAN → supprimer la règle générée.
À remplacer par une règle restreinte à l’IP du poste d’administration.
Étape 5 — Assistant de configuration initiale (Setup Wizard)
Lancé automatiquement à la première connexion web.
Écran
Paramètre
Valeur
Justification
General Information
Hostname / Domain
(renseignés)
General Information
DNS Servers
8.8.8.8, 1.1.1.1
résolution de secours
Time Server
Fuseau
Europe/Paris
horodatage correct des logs
WAN
Type
DHCP
l’adresse est fournie par l’établissement
WAN
Block RFC1918 Private Networks
décoché
voir encadré ci-dessous
WAN
Block bogon networks
décoché
inutile ici, ralentit le démarrage
LAN
IP / masque
10.0.0.1
interface de secours
Admin
Mot de passe
(défini)
Pourquoi décocher « Block RFC1918 » ? Cette option fait jeter par pfSense tout trafic provenant d’une adresse privée sur le WAN. Elle est pertinente pour un pare-feu branché sur une vraie connexion Internet publique. Ici, le « WAN » est un réseau privé (10.1.0.0/16) : laisser l’option cochée reviendrait à bloquer l’intégralité du trafic, y compris l’accès à l’interface d’administration.
Étape 6 — Mise à jour du système
System → Update → System Update
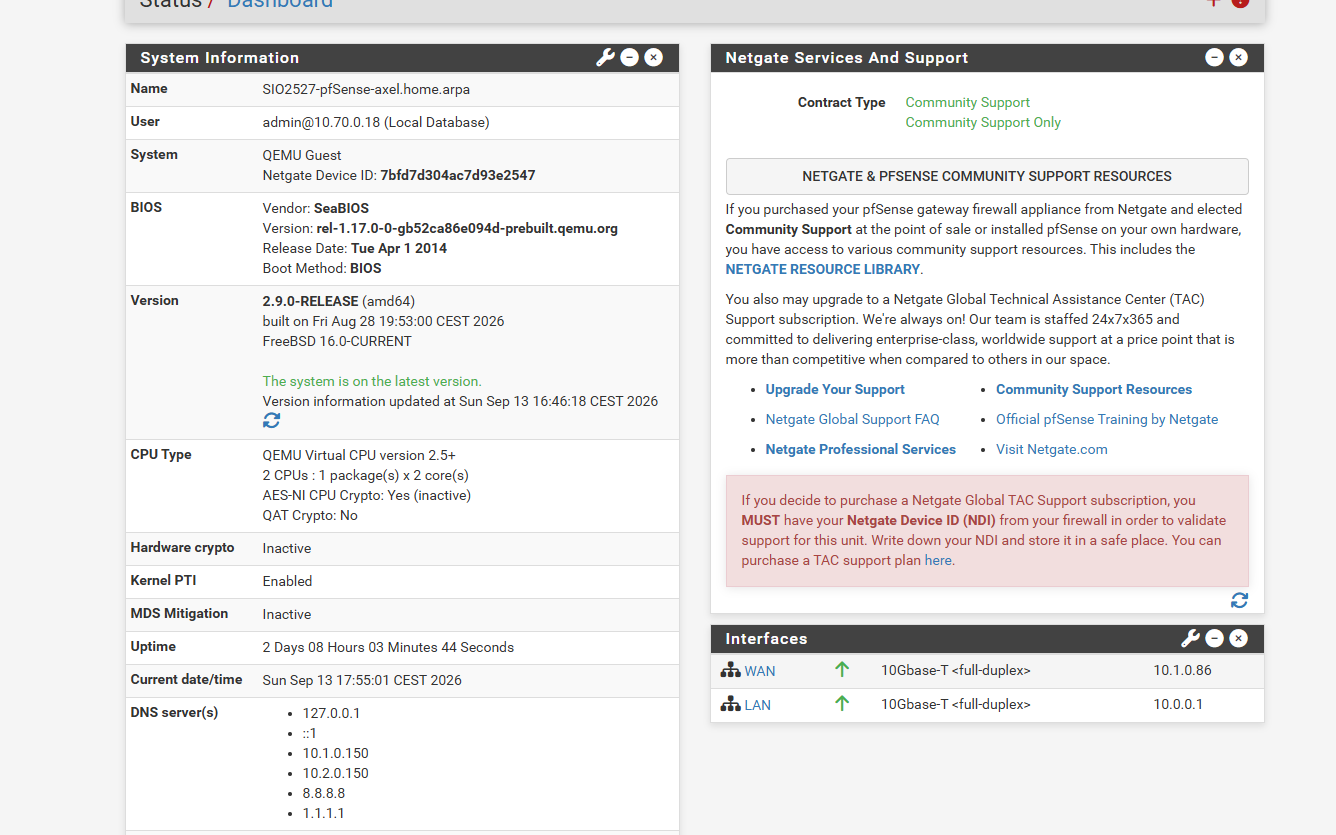
Passage de pfSense CE 2.7.0 à 2.9.0-RELEASE.
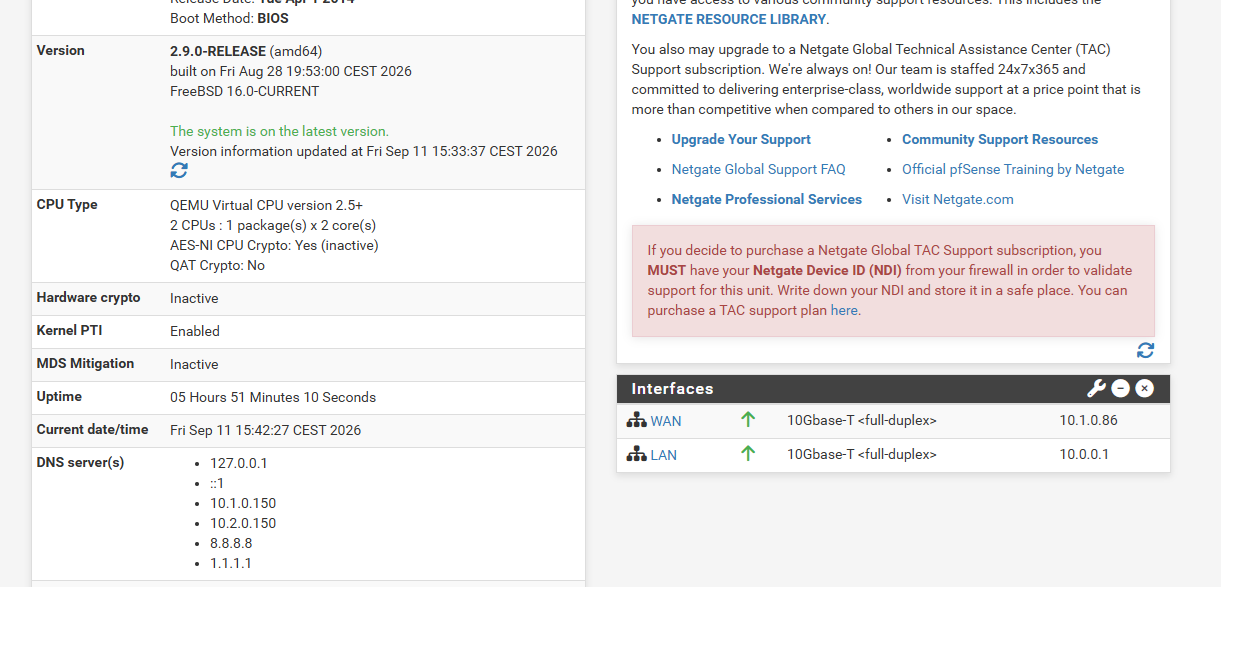
Points vérifiés sur cette capture :
Contrôle
Résultat
Version
2.9.0-RELEASE (amd64) — The system is on the latest version
Interface WAN
up — 10.1.0.86
Interface LAN
up — 10.0.0.1
DNS
10.1.0.150, 10.2.0.150 (école) + 8.8.8.8, 1.1.1.1
CPU / RAM
2 vCPU — conforme au dimensionnement
Étape 7 — Création des interfaces VLAN
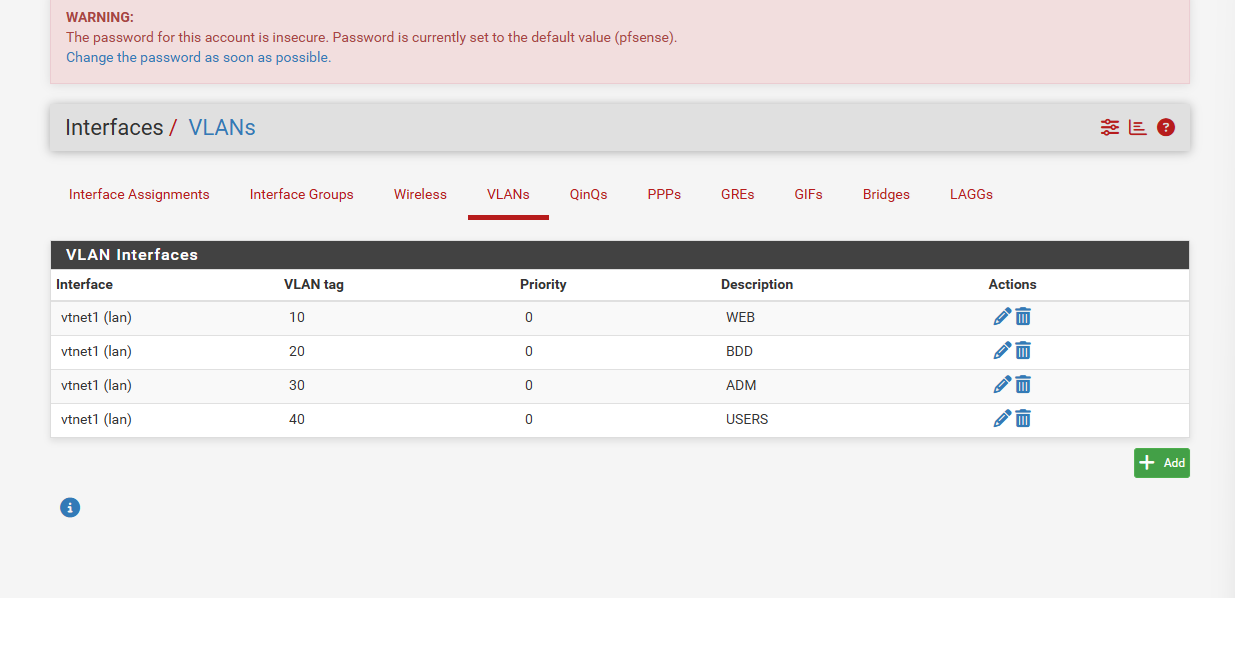
Interfaces → Assignments → onglet VLANs → Add
Quatre VLAN créés, tous rattachés à l’interface parente vtnet1 :
Parent Interface
VLAN Tag
Priority
Description
vtnet1 (lan)
10
0
WEB
vtnet1 (lan)
20
0
BDD
vtnet1 (lan)
30
0
ADM
vtnet1 (lan)
40
0
USERS
Que fait cette page exactement ? Elle crée des sous-interfaces virtuelles (vtnet1.10, vtnet1.20…) sur une seule carte physique. Chaque trame émise sur vtnet1.20 se voit ajouter une étiquette 802.1Q contenant le numéro 20. Un switch compatible VLAN lit cette étiquette et sait dans quel réseau livrer la trame. C’est le principe du « router on a stick » : un seul lien physique transporte plusieurs réseaux logiques.
À ce stade les VLAN sont créés mais pas encore utilisables : ils ne sont ni assignés à une interface pfSense, ni adressés.
Étape 8 — Changement du mot de passe administrateur
System → User Manager → onglet Users → crayon sur admin → Password + Confirmation → Save
Validation : le bandeau rouge « The password for this account is insecure. Password is
currently set to the default value (pfsense) » disparaît du tableau de bord.
Pourquoi c’était urgent : le webConfigurator était exposé sur le WAN (étape 4) et le
compte admin conservait le mot de passe par défaut. Toute machine du réseau de l’établissement
pouvait prendre le contrôle du pare-feu. C’est la combinaison de vulnérabilités la plus
classique — et la plus sanctionnée en soutenance.
Étape 9 — Création du bridge trunk vmbr1
Les VLAN existent dans pfSense, mais les trames taguées doivent encore traverser Proxmox. La
carte vtnet1 était initialement raccordée à vmbr0, le bridge relié à la carte physique : les
trames VLAN du lab seraient donc parties sur le réseau de l’établissement.
Principe
Un bridge Proxmox est un switch virtuel :
Type de bridge
Équivalent physique
Usage
Avec port physique (vmbr0)
switch branché sur la prise murale
le WAN
Sans port physique (vmbr1)
switch isolé posé sur le bureau
le lab
A — Création du bridge
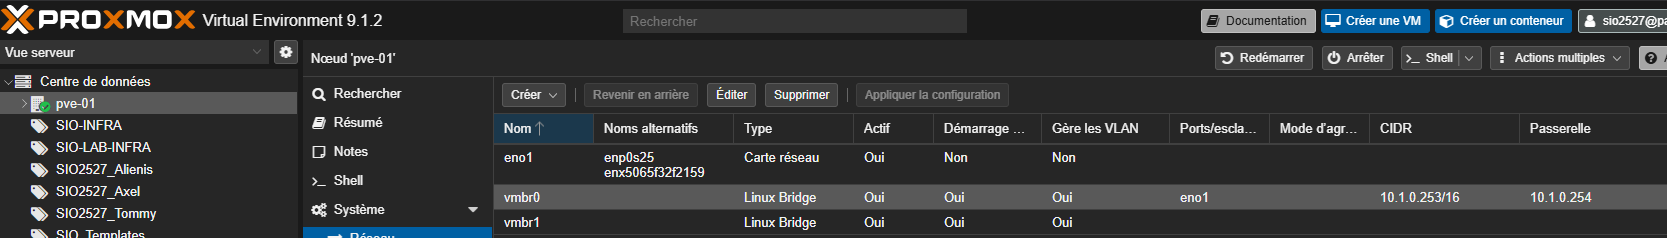
Proxmox → nœud pve-01 → Système → Réseau → Créer → Linux Bridge
Champ
Valeur
Justification
Name
vmbr1
IPv4/CIDR
(vide)
c’est pfSense le routeur, pas Proxmox
Gateway
(vide)
jamais deux passerelles par défaut sur un hyperviseur
Ports/Interfaces de pont
VIDE
aucun lien vers la carte physique : le lab reste confiné
VLAN aware
coché
autorise le transport des trames taguées 802.1Q
Comment
Trunk LAB - VLAN 10/20/30/40
Puis Appliquer la configuration (bouton en haut) pour activer sans redémarrer le nœud.
Validation : vmbr1 — Gère les VLAN = Oui, Ports/esclaves vide, aucun CIDR ni
passerelle. À comparer avec vmbr0, qui porte bien la carte physique eno1 et l’adresse de
l’hyperviseur (10.1.0.253/16, passerelle 10.1.0.254).
Ne pas modifier vmbr0 : le WAN y transite, et une erreur fait perdre l’accès à Proxmox
lui-même.
B — Bascule de la carte réseau de pfSense
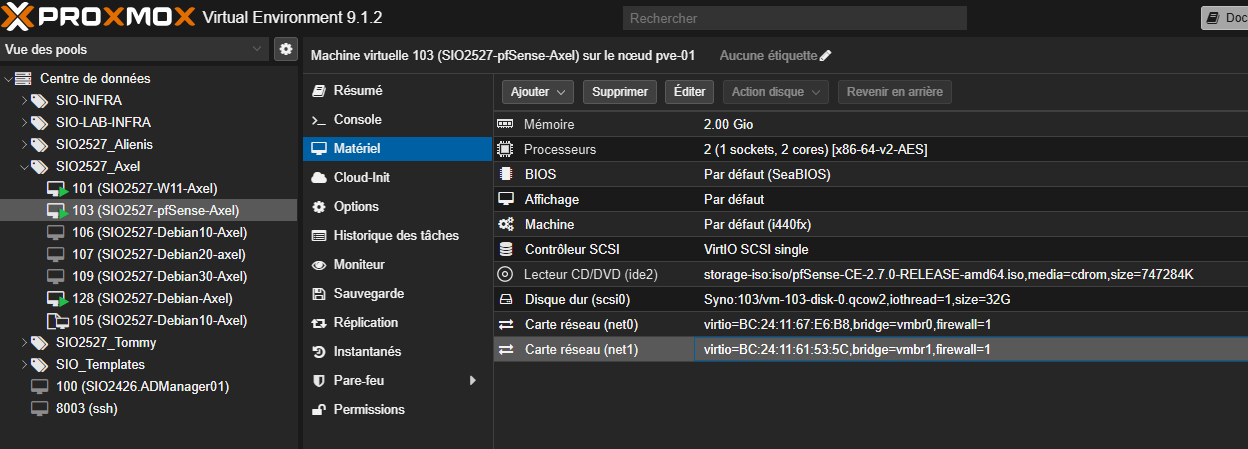
VM 103 → Matériel → double-clic sur Carte réseau (net1)
Champ
Valeur
Justification
Bridge
vmbr1
on rebranche le câble sur le bon switch
VLAN Tag
(vide)
vide = mode trunk : pfSense tague lui-même
Model
VirtIO (paravirtualized)
conserve le nom d’interface vtnet1
Pare-feu
décoché
le filtrage est le rôle de pfSense, pas de Proxmox
Validation : la vue Matériel affiche
Carte réseau (net1) : virtio=BC:24:11:61:53:5C,bridge=vmbr1.
Trunk et access — la distinction à maîtriser : ici le champ VLAN Tag reste vide
car pfSense gère les étiquettes lui-même (port trunk). Pour les VM applicatives ce sera
l’inverse : on y saisira 10, 20, 30 ou 40, et Proxmox taguera à leur place (port
access) — la VM n’aura rien à configurer et croira être sur un réseau ordinaire.
C — Points d’hygiène relevés sur la VM
Constat
Correction
Pourquoi
firewall=1 sur net0 et net1
décocher Pare-feu sur les deux cartes
deux pare-feux empilés : un blocage au niveau du bridge Proxmox serait invisible dans les journaux pfSense, et peut perturber les trames 802.1Q
ISO pfSense-CE-2.7.0 toujours monté dans ide2
passer le lecteur sur « Ne pas utiliser de média »
si le disque ne démarre pas, la VM booterait sur l’installateur 2.7.0 et risquerait d’écraser le système 2.9.0
Étape 10 — Mise en service des VLAN
A — Passage du LAN en /24 (préalable obligatoire)
Interfaces → LAN → masque 24 au lieu de 16 → Save → Apply Changes.
Pourquoi c’est un préalable : le LAN en 10.0.0.1/16 couvrait 10.0.0.0 →
10.0.255.255, donc englobait les quatre futurs VLAN. Toute tentative d’adresser
10.0.10.1/24 aurait été rejetée par pfSense avec l’erreur :
« IPv4 address 10.0.10.1 is being used by or overlaps with: LAN ».
C’est la manifestation concrète de la règle du §2.3.
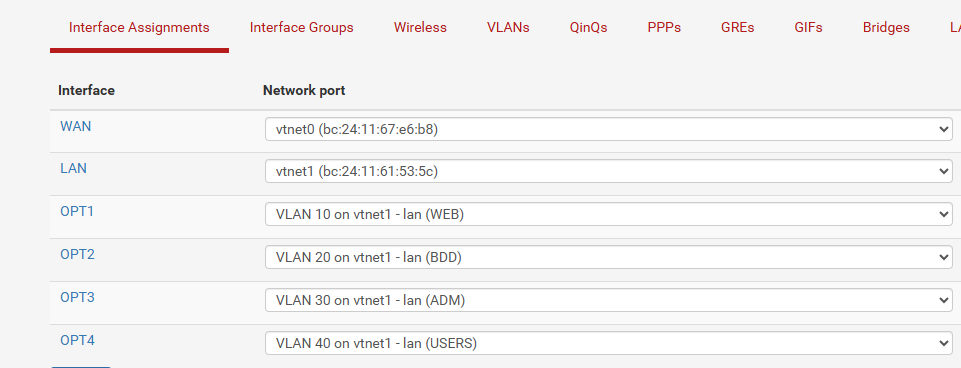
B — Assignation des interfaces
Interfaces → Assignments → liste Available network ports → sélectionner chaque VLAN → + Add
Interface créée
Port réseau
OPT1
VLAN 10 on vtnet1 - lan (WEB)
OPT2
VLAN 20 on vtnet1 - lan (BDD)
OPT3
VLAN 30 on vtnet1 - lan (ADM)
OPT4
VLAN 40 on vtnet1 - lan (USERS)
OPT = « Optional » : nom générique donné par pfSense à toute interface autre que WAN et
LAN. La numérotation suit l’ordre d’ajout, pas les tags VLAN.
C — Activation et adressage
Pour chaque interface : Interfaces → OPTx
Champ
Valeur
Enable
Enable interface(décoché par défaut)
Description
WEB / BDD / ADM / USERS
IPv4 Configuration Type
Static IPv4
IPv4 Address
10.0.X.1 / 24
IPv6 Configuration Type
None
Block private networks / bogon
décochés
Pourquoi laisser décochées les cases « Block private / bogon networks » ? Elles servent à
rejeter des adresses illégitimes arrivant d’Internet et n’ont de sens que sur une interface WAN.
Sur un VLAN interne en 10.0.x.0/24, les cocher reviendrait à bloquer son propre réseau.
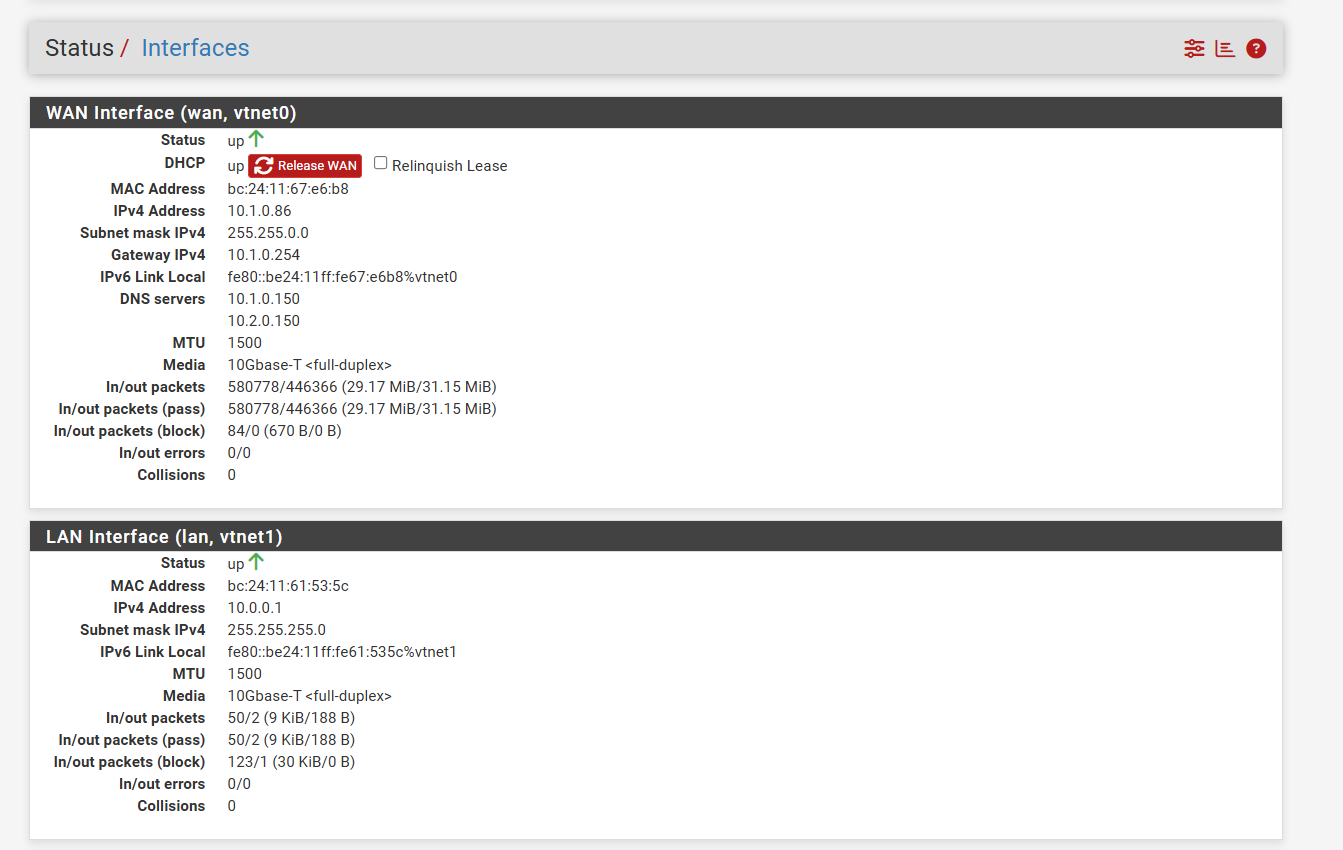
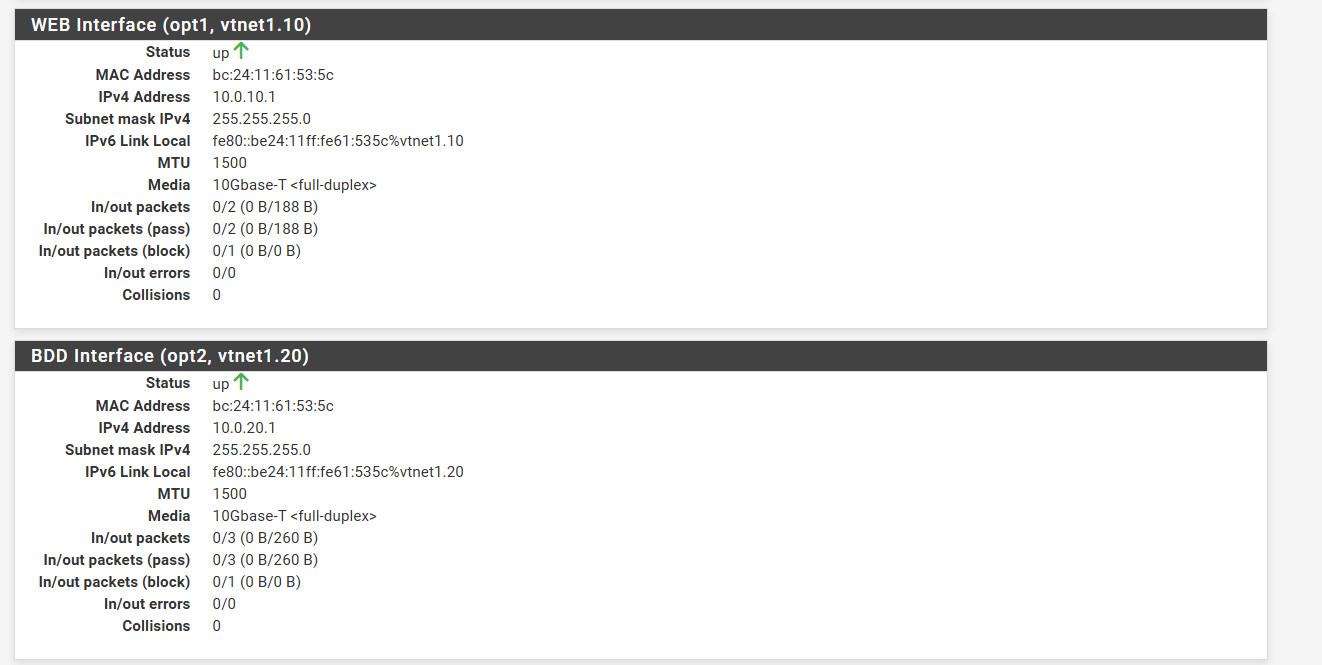
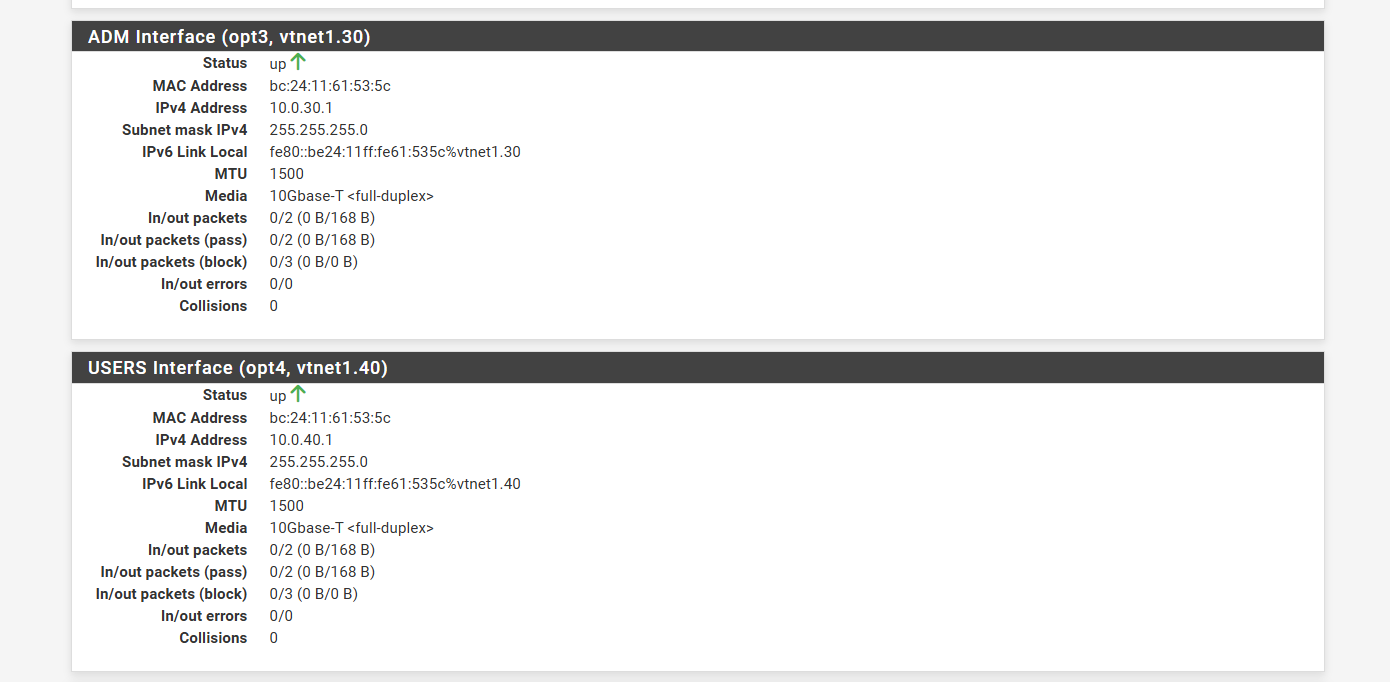
Validation — critère de fin de phase
Status → Interfaces :
Interface
Périphérique
Adresse
Masque
Statut
WAN
vtnet0
10.1.0.86
255.255.0.0
up
LAN
vtnet1
10.0.0.1
255.255.255.0
up
WEB
vtnet1.10
10.0.10.1
255.255.255.0
up
BDD
vtnet1.20
10.0.20.1
255.255.255.0
up
ADM
vtnet1.30
10.0.30.1
255.255.255.0
up
USERS
vtnet1.40
10.0.40.1
255.255.255.0
up
Deux observations à relever dans cette page — elles valident toute la théorie du TP :
1. Les quatre interfaces VLAN partagent la même adresse MAC (bc:24:11:61:53:5c, celle de
vtnet1). C’est la preuve matérielle du router-on-a-stick : une seule carte physique, une
seule adresse MAC, quatre réseaux logiques distingués uniquement par l’étiquette 802.1Q.
Le nom vtnet1.10 se lit « sous-interface de vtnet1, tag 10 ».
2. Le compteur In/out packets (block) est déjà non nul sur chaque interface VLAN, alors
qu’aucune règle n’a été écrite. C’est la règle implicite block all (règle d’or n°3) qui
travaille. Le pare-feu refuse déjà tout ce qui se présente — c’est le comportement attendu,
pas une panne.
D — Serveur DHCP du VLAN 40
Services → DHCP Server → onglet USERS
Champ
Valeur
Justification
Enable
active le service sur cette interface uniquement
Address Pool Range
10.0.40.100 → 10.0.40.199
bloc DHCP de la convention §2.4
DNS Servers
10.0.40.1
temporaire — voir encadré
Gateway
(vide)
pfSense distribue automatiquement l’adresse de l’interface
Domain name
sio.internal
suffixe DNS des clients
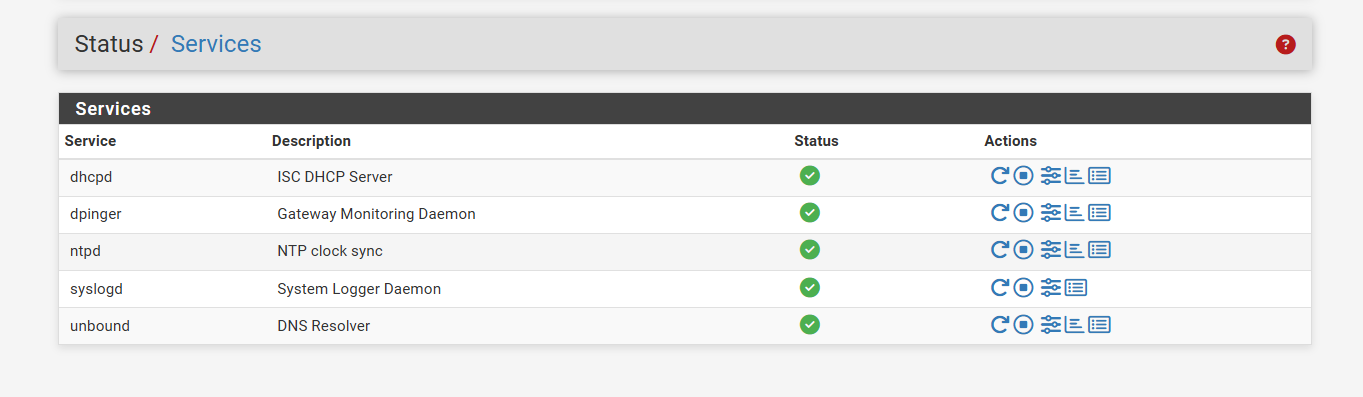
Validation : Status → Services affiche dhcpd (ISC DHCP Server) en running,
aux côtés de unbound (DNS Resolver), ntpd, dpinger et syslogd.
Modification prévue en phase 6. Tant que l’Active Directory n’existe pas, les clients
doivent résoudre via pfSense. Dès la création du domaine sio.internal (tâche 6.5), ce
champ devra être remplacé par les deux contrôleurs :
DNS Servers : 10.0.30.10
              10.0.30.11
Sans cette modification, les clients Windows ne trouveront pas leur contrôleur de domaine :
ils recherchent des enregistrements SRV (_ldap._tcp.dc._msdcs.sio.internal) que seul le
DNS d’Active Directory détient. C’est la cause la plus fréquente d’échec de jonction au domaine.
La phase 3 est terminée. L’infrastructure réseau est opérationnelle : pfSense route entre les
quatre VLAN. Aucun trafic ne circule encore, faute de règles de pare-feu — c’est l’objet de la
phase suivante.
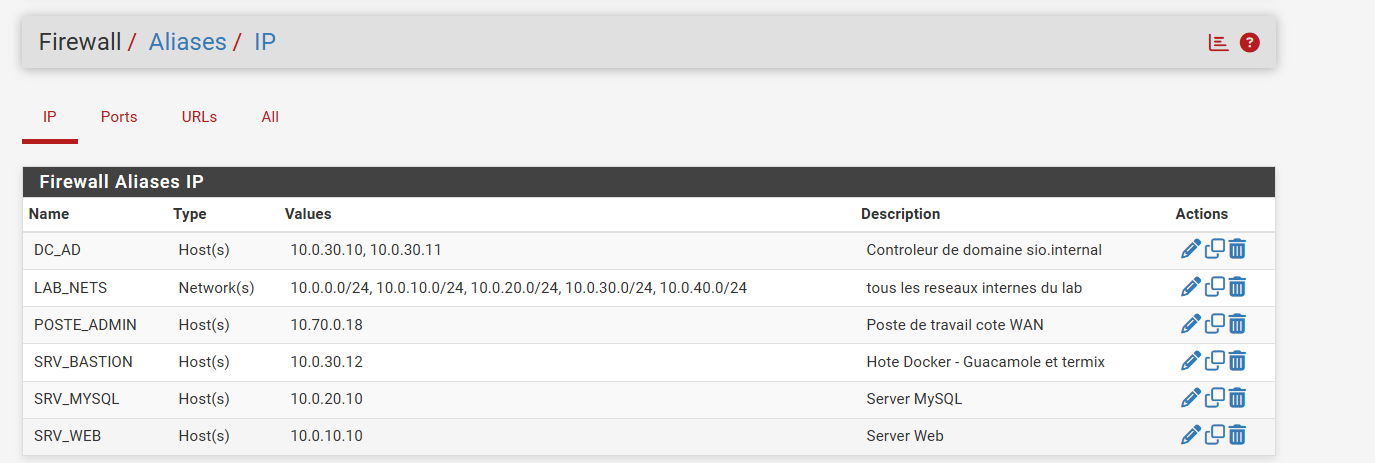
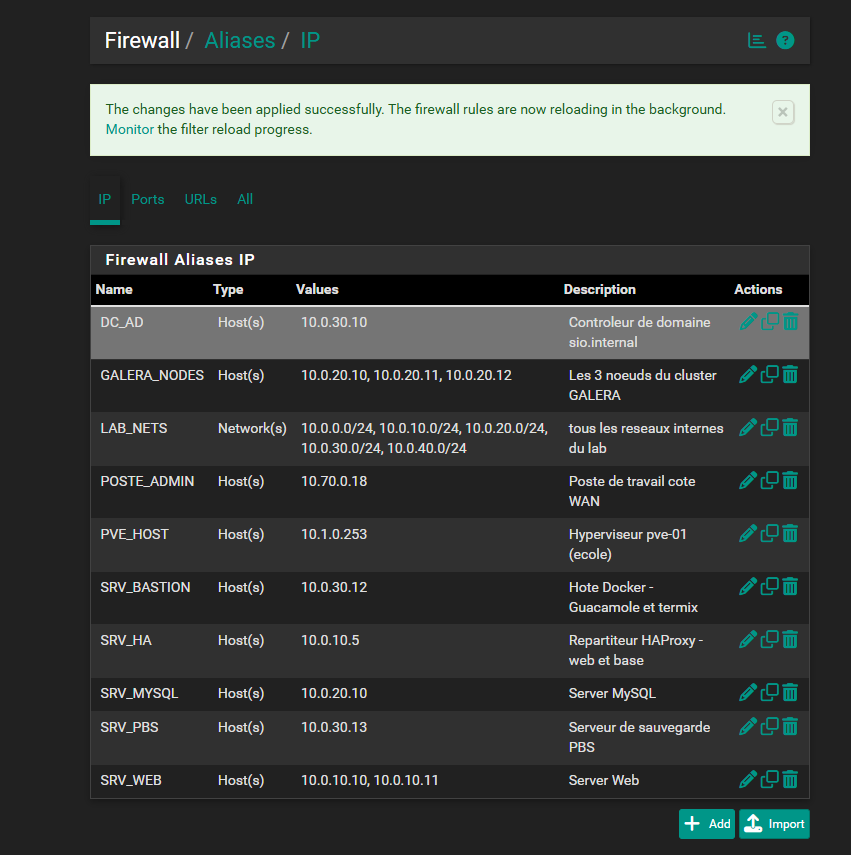
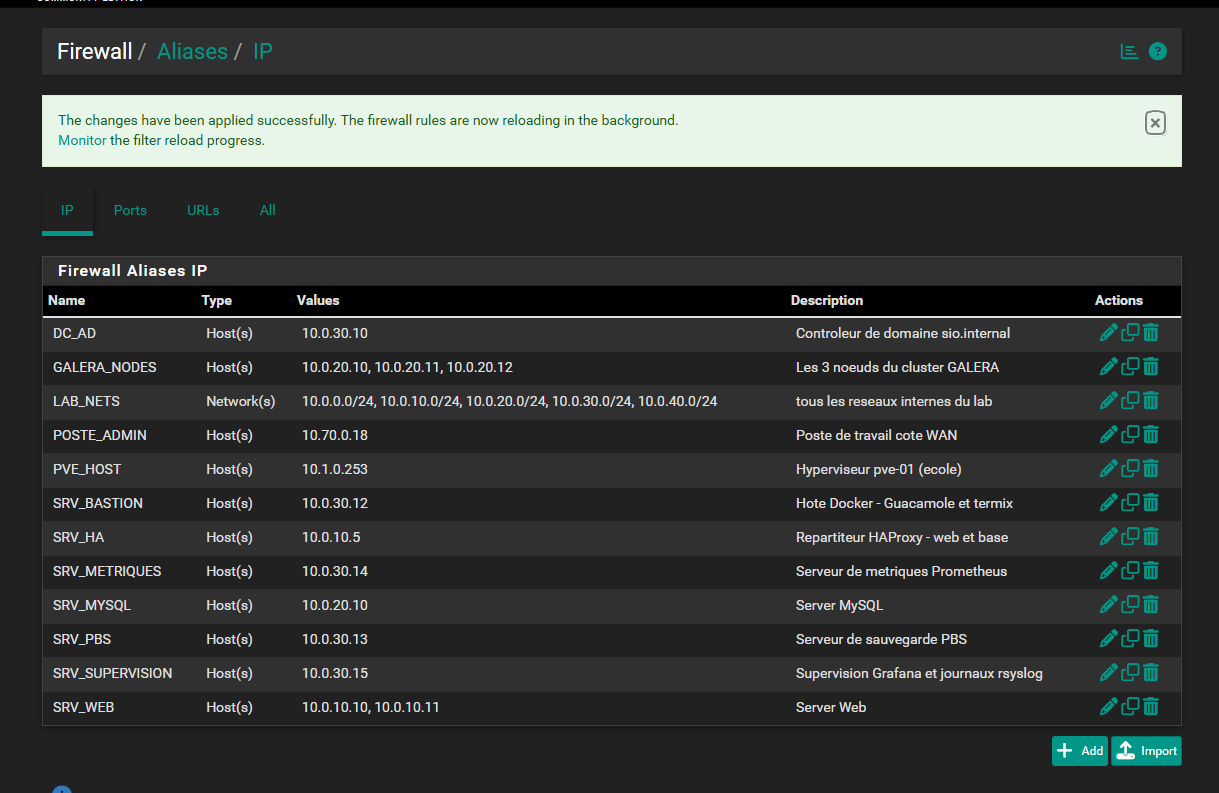
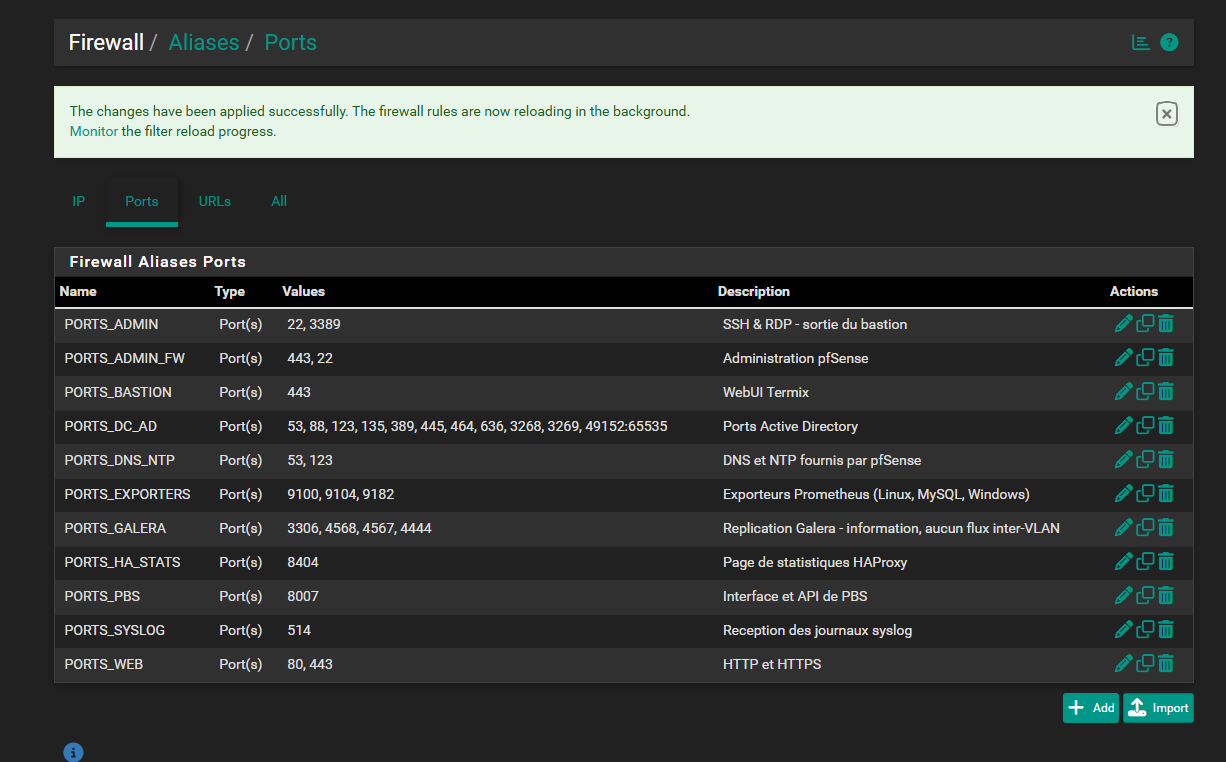
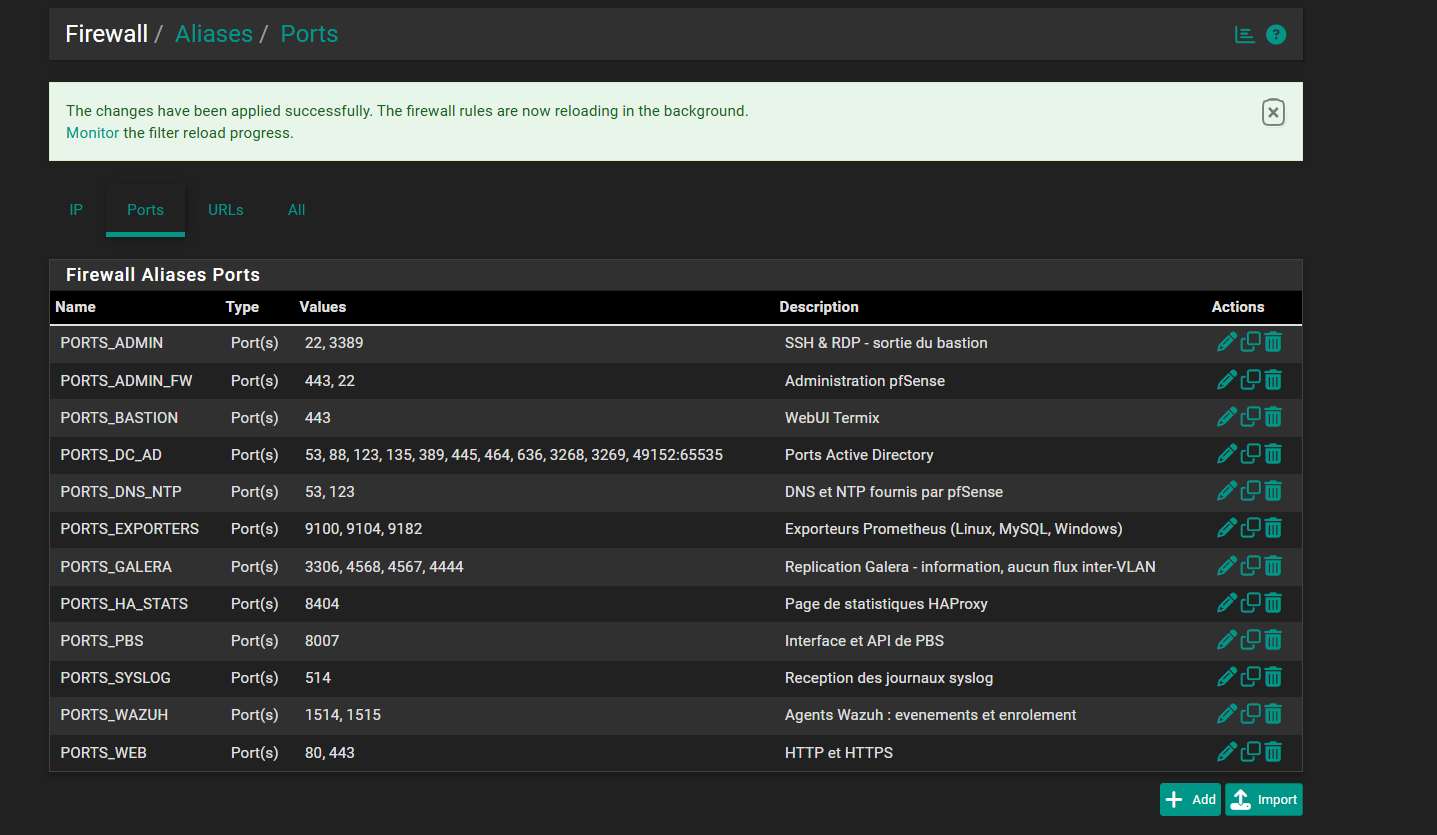
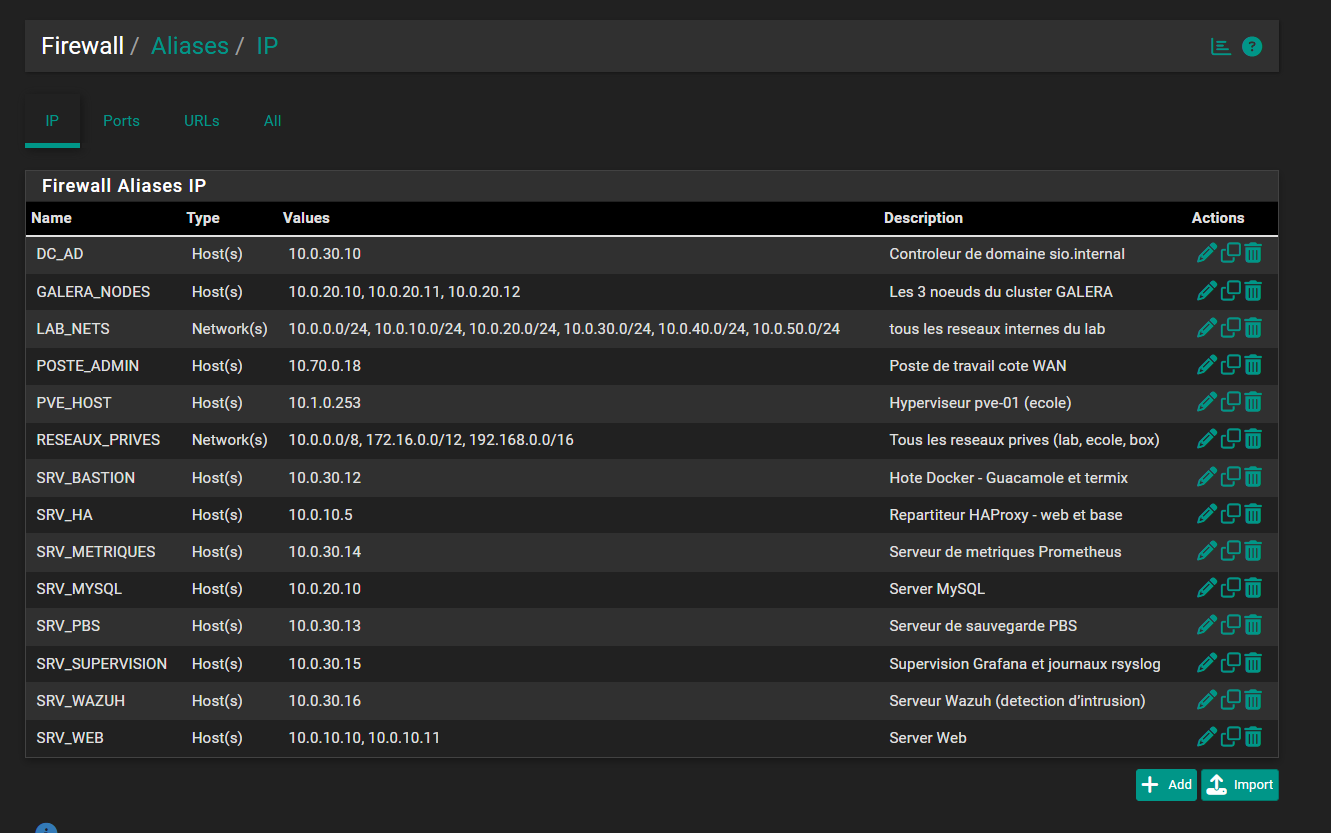
Étape 11 — Création des alias de pare-feu
Firewall → Aliases
Un alias est une variable nommée réutilisable dans les règles. Trois bénéfices :
maintenabilité (l’adresse d’un serveur change → un seul endroit à modifier, toutes les règles
suivent), lisibilité (SRV_WEB → SRV_MYSQL : 3306 se lit, 10.0.10.10 → 10.0.20.10 : 3306
se déchiffre) et fiabilité (pas de faute de frappe répétée dans plusieurs règles).
LAB_NETS est de type Network(s), pas Host(s) : il attend une notation CIDR. Se tromper
de type produit une règle qui ne correspondra jamais.
Le LAN (10.0.0.0/24) y figure car cet alias sert aux règles de blocage
(Reject → LAB_NETS) : il doit couvrir tout l’interne, sinon un flux pourrait s’échapper
vers le LAN de secours au lieu d’être refusé.
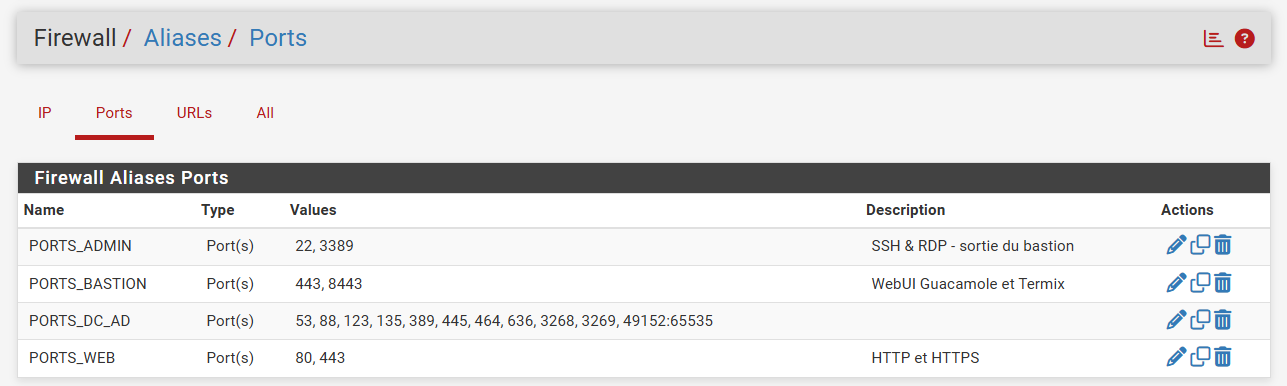
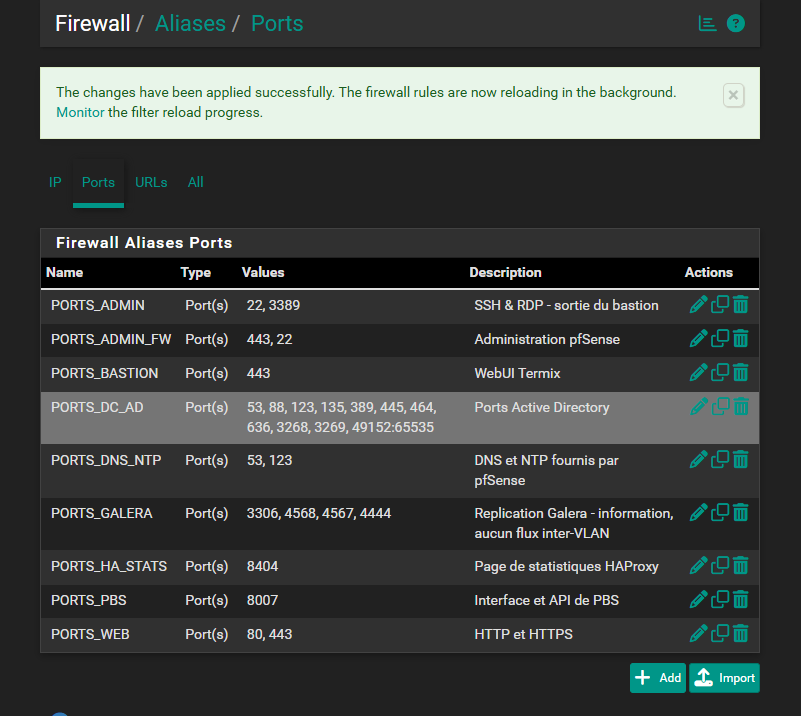
Pourquoi autant de ports pour Active Directory ? AD n’est pas un protocole mais un
empilement : DNS (53) pour localiser le contrôleur, Kerberos (88/464) pour l’authentification,
LDAP (389/636) pour l’annuaire, SMB (445) pour SYSVOL et les GPO, NTP (123) car Kerberos refuse
un écart d’horloge supérieur à 5 minutes, et RPC (135 + plage dynamique) pour la réplication.
La plage 49152:65535 (syntaxe pfSense : début:fin) correspond aux ports dynamiques
de Windows : les appels RPC négocient un port au hasard dans cet intervalle, impossible à
prévoir. C’est la cause la plus fréquente d’échec de jonction au domaine à travers un pare-feu.
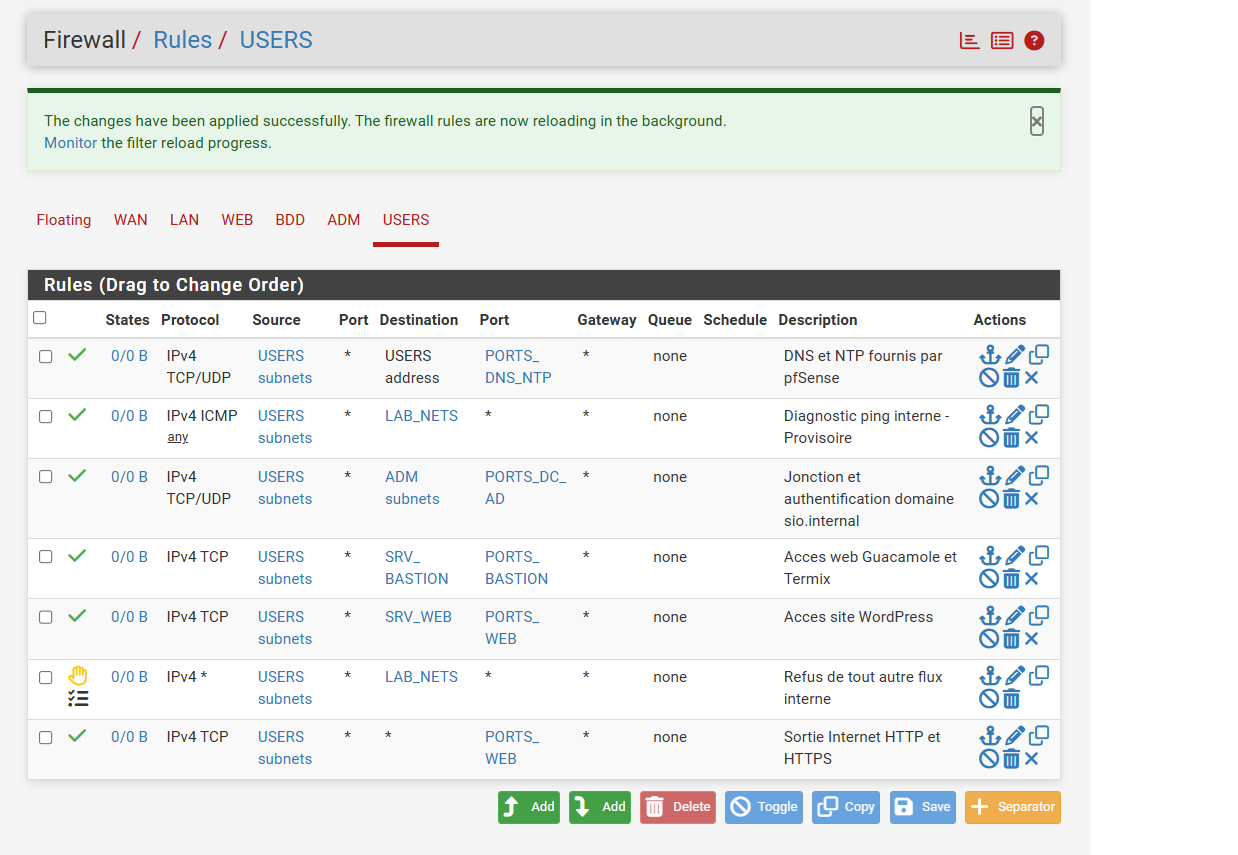
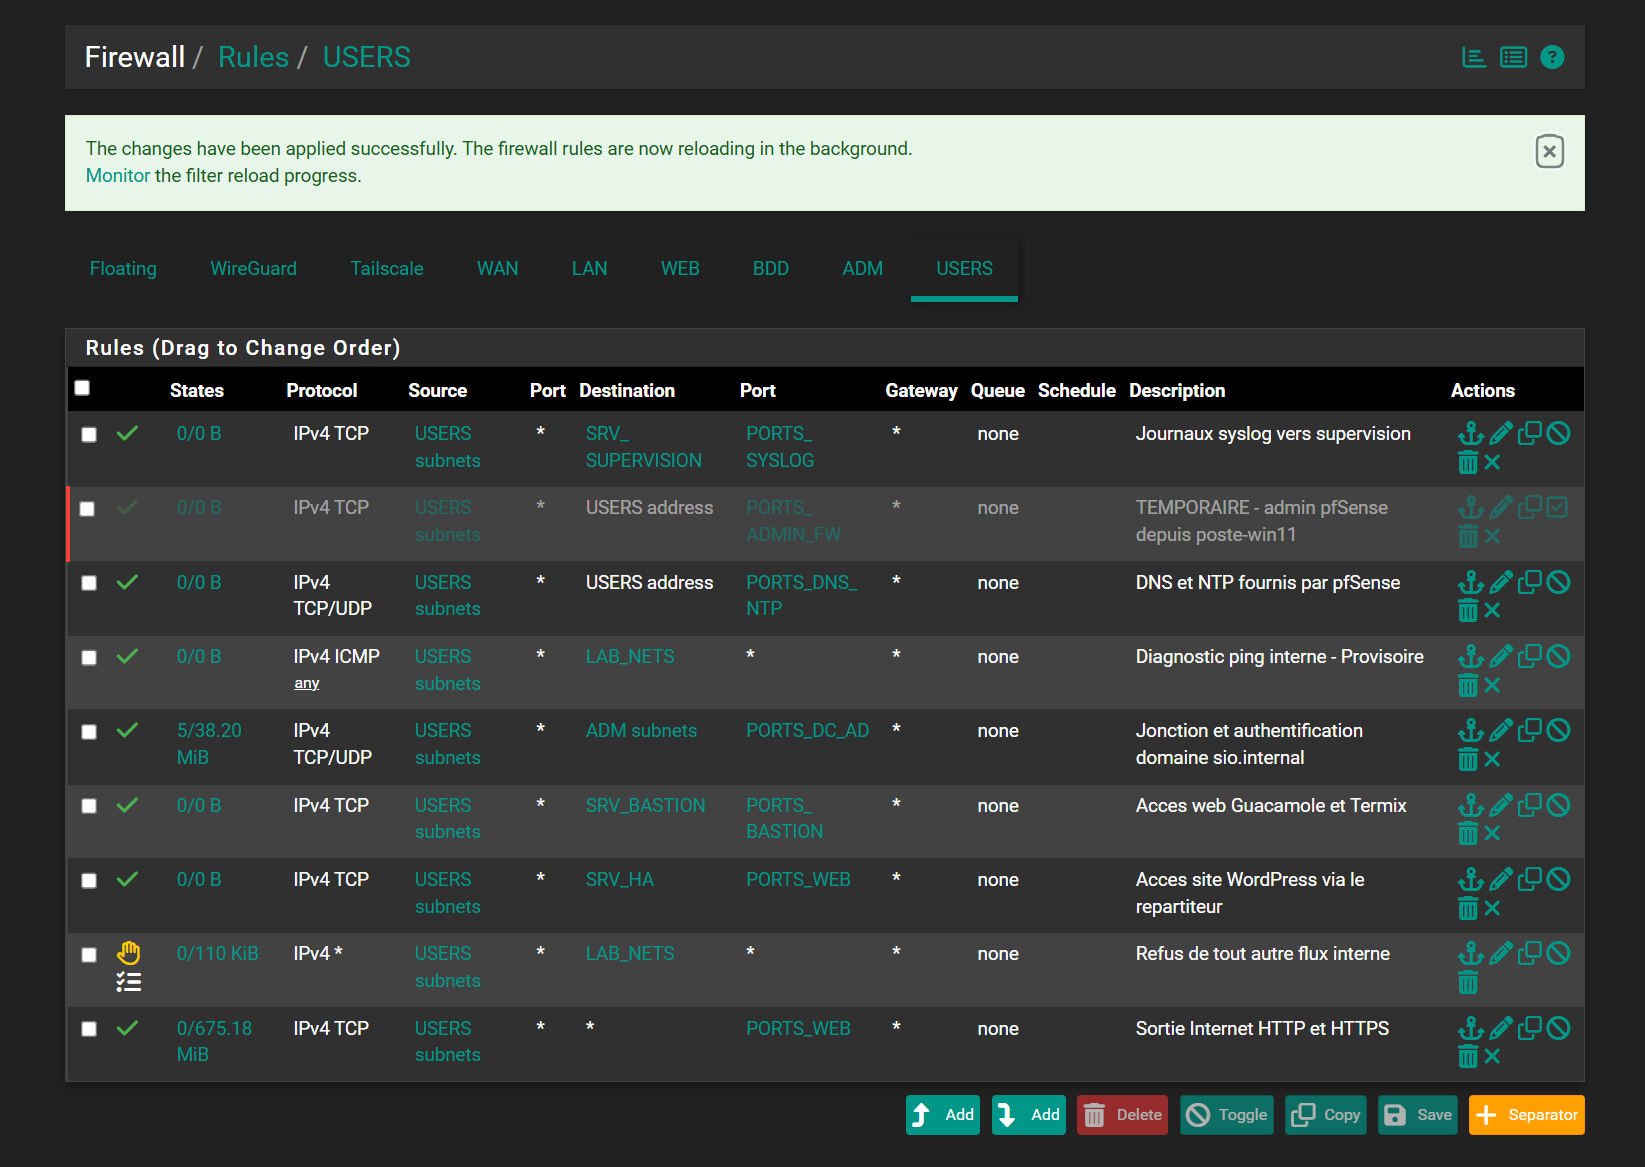
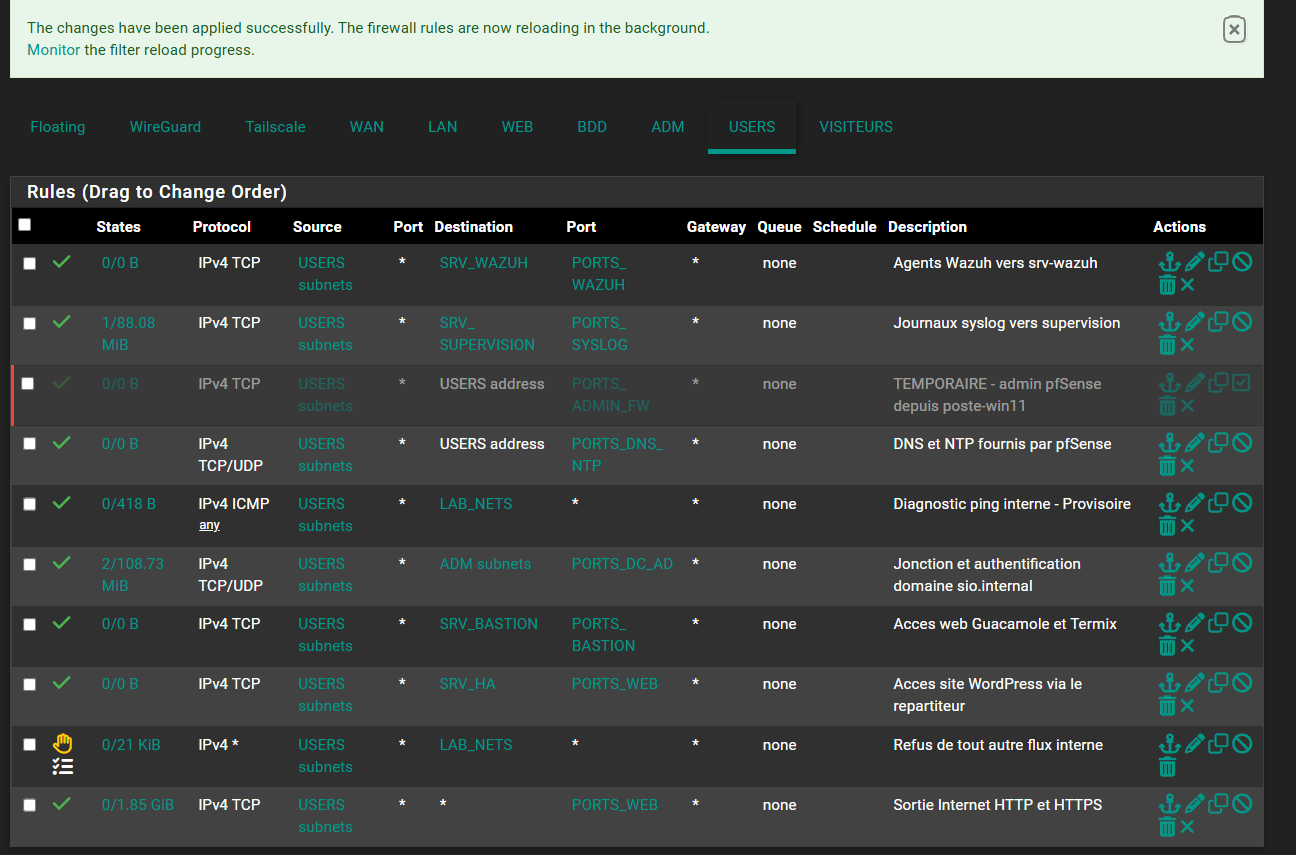
Étape 12 — Règles de pare-feu de l’onglet USERS (VLAN 40)
Firewall → Rules → onglet USERS
Première des quatre séries de règles. La conception complète figure dans
Matrice-de-flux.md ; on reprend ici le résultat appliqué.
#
Action
Proto
Source
Destination
Port
Log
Description
1
Pass
TCP/UDP
USERS subnets
USERS address
PORTS_DNS_NTP
—
DNS et NTP fournis par pfSense
2
Pass
ICMP (any)
USERS subnets
LAB_NETS
—
—
Diagnostic ping interne — provisoire
3
Pass
TCP/UDP
USERS subnets
ADM subnets
PORTS_DC_AD
—
Jonction et authentification domaine sio.internal
4
Pass
TCP
USERS subnets
SRV_BASTION
PORTS_BASTION
—
Accès web Termix
5
Pass
TCP
USERS subnets
SRV_WEB
PORTS_WEB
—
Accès site WordPress
6
Reject
any
USERS subnets
LAB_NETS
any
Refus de tout autre flux interne
7
Pass
TCP
USERS subnets
any
PORTS_WEB
—
Sortie Internet HTTP et HTTPS
Le motif d’ordonnancement
1-5  autorisations précises   (vers telle machine, sur tel port)
 6   Reject vers LAB_NETS     (tout le reste de l'interne)
 7   Pass vers any            (ne désigne plus qu'Internet)
La règle 7 vise any, qui inclut normalement les réseaux internes. Mais la règle 6 les a déjà
interceptés (principe : première correspondance gagne), donc any ne désigne plus en pratique
qu’Internet. C’est le motif canonique, réutilisé à l’identique sur les trois autres onglets.
Points de vigilance rencontrés
Constat
Conséquence
Correction
Vocabulaire pfSense 2.9 : X net est devenu X subnets, Single host or alias est devenu Address or Alias
Les tutoriels en ligne ne correspondent plus aux menus
Table de correspondance ajoutée en §4 de la matrice
Un alias se saisit toujours via Address or Alias, jamais via Network — même pour LAB_NETS qui contient des réseaux
Network attend un CIDR tapé à la main
Documenté en §4 de la matrice
Le port se saisit uniquement dans Destination Port Range ; Source Port Range reste à any
Le port source est tiré au hasard par le client à chaque connexion : le filtrer rendrait la règle inopérante
Documenté en §4 de la matrice
Règle 4 créée initialement sans port destination (*)
Les postes auraient pu joindre le bastion sur tous les ports TCP, dont SSH 22 en direct — contournant le bastion lui-même
Port PORTS_BASTION ajouté
La quatrième ligne mérite d’être retenue. Une règle « bonne machine, port any » donne
l’illusion d’être précise puisqu’elle nomme un seul hôte — alors qu’elle est grande ouverte.
En audit, on lit toujours les colonnes Destination et Port ensemble.
La colonne States affiche 0/0 B sur toutes les règles : normal, aucune machine
n’existe encore dans les VLAN. Ce compteur deviendra le principal outil de diagnostic en
phase 5 — une règle restée à 0/0 alors que du trafic est généré signifie qu’elle ne
correspond pas, ou qu’une règle placée au-dessus l’intercepte.
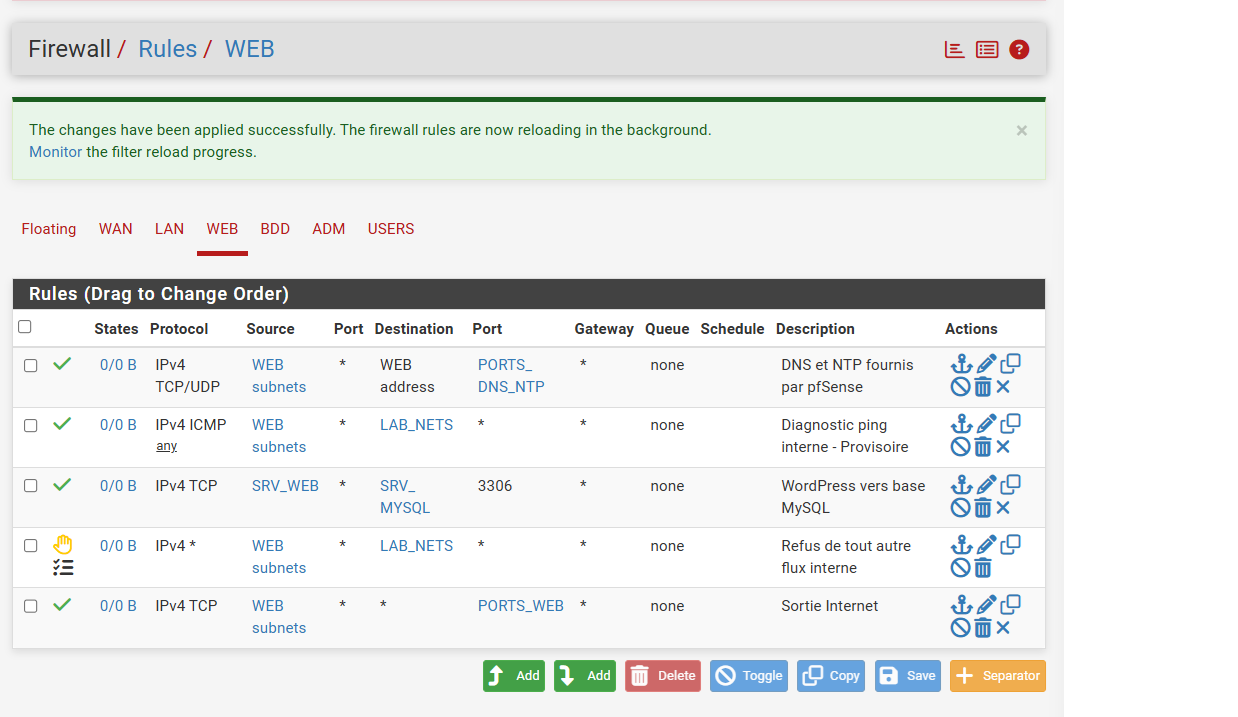
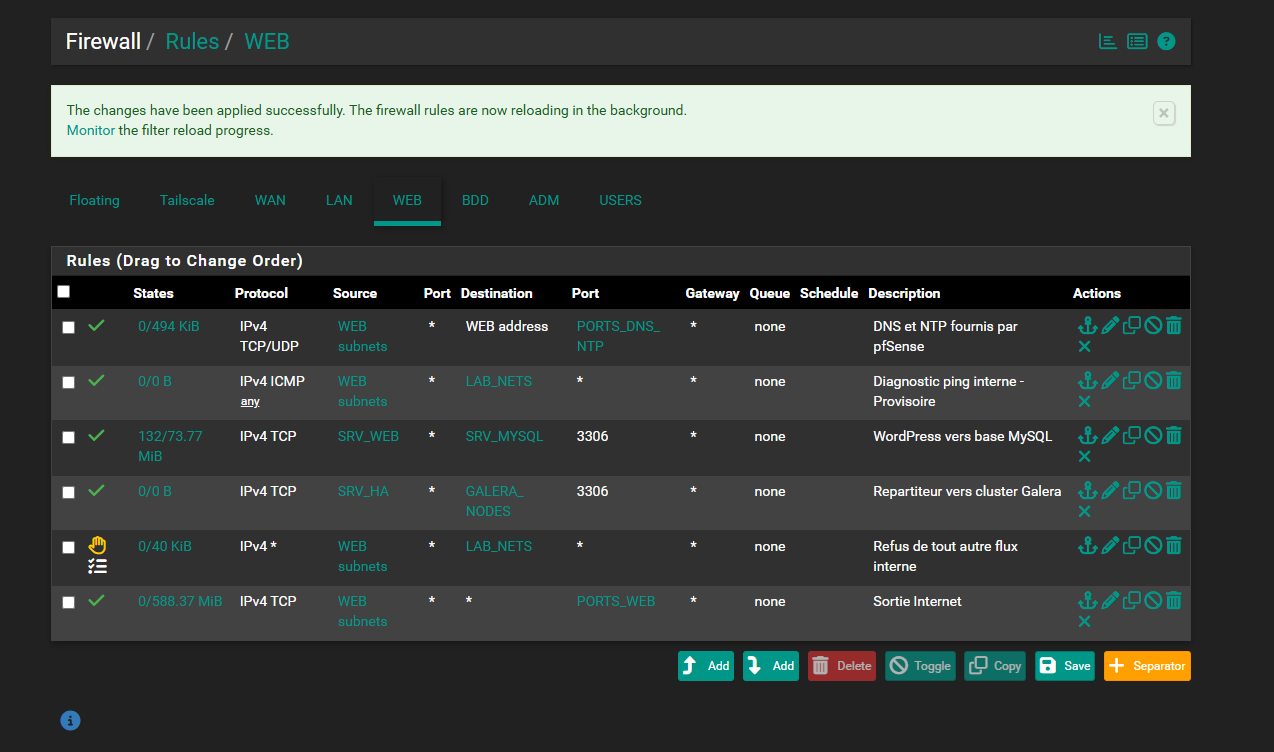
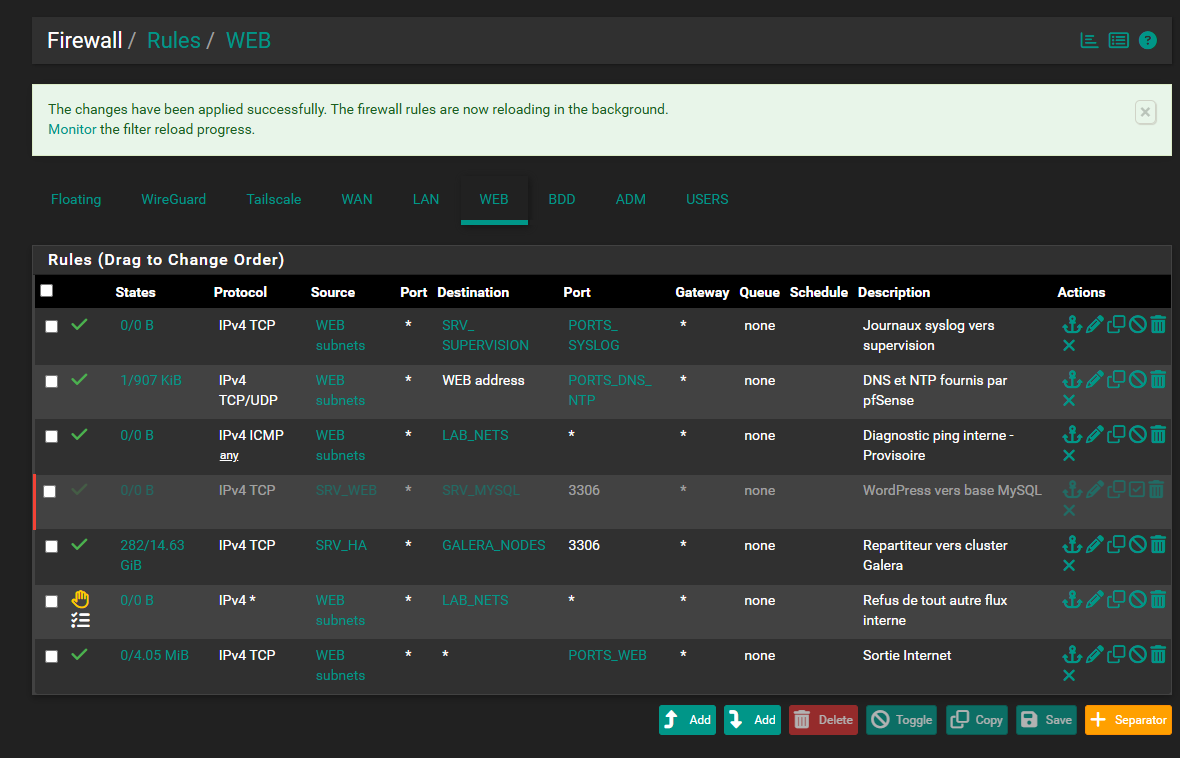
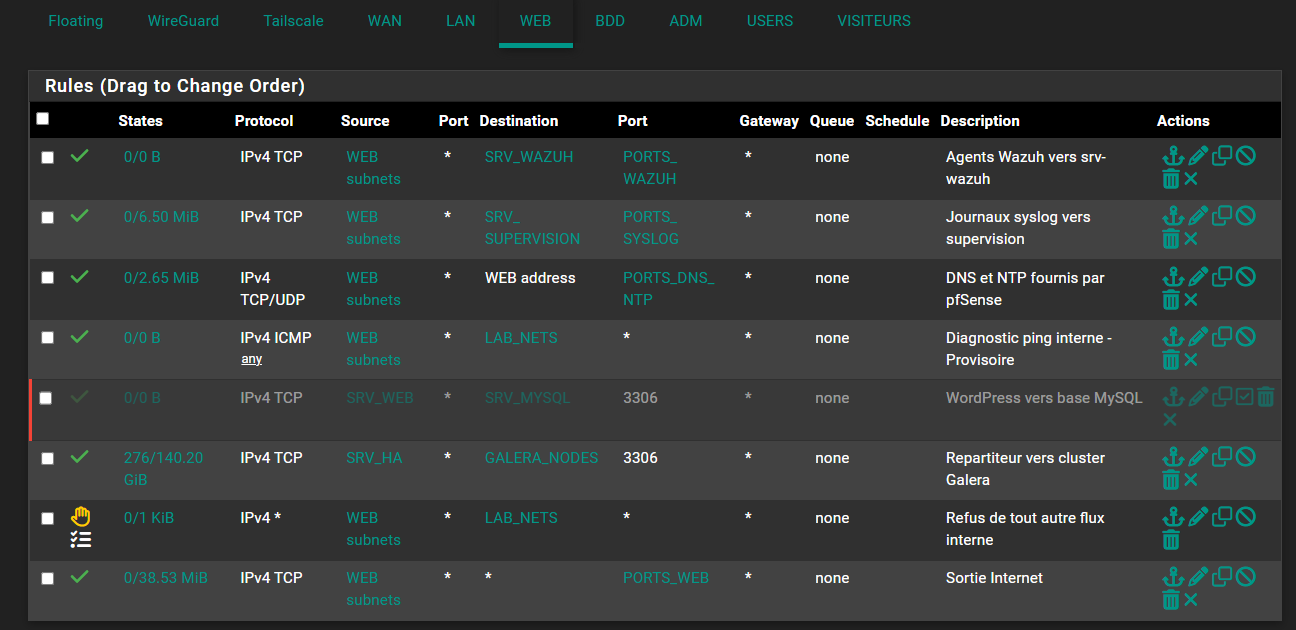
Étape 13 — Règles de pare-feu de l’onglet WEB (VLAN 10)
Firewall → Rules → onglet WEB
#
Action
Proto
Source
Destination
Port
Log
Description
1
Pass
TCP/UDP
WEB subnets
WEB address
PORTS_DNS_NTP
—
DNS et NTP fournis par pfSense
2
Pass
ICMP (any)
WEB subnets
LAB_NETS
—
—
Diagnostic ping interne — provisoire
3
Pass
TCP
SRV_WEB
SRV_MYSQL
3306
—
WordPress vers base MySQL
4
Reject
any
WEB subnets
LAB_NETS
any
Refus de tout autre flux interne
5
Pass
TCP
WEB subnets
any
PORTS_WEB
—
Sortie Internet — dépôts Debian
La règle 3 — le flux inter-VLAN du TP
C’est la seule règle du lab écrite d’hôte à hôte plutôt que de réseau à réseau :
Une machine supplémentaire ajoutée dans le VLAN 10 n’aurait pas accès à la base : elle serait
interceptée par la règle 4. C’est le moindre privilège appliqué à la lettre — et l’argument à
présenter quand on demande pourquoi cette règle n’est pas écrite WEB subnets → BDD subnets.
Le port 3306 est saisi en dur plutôt que via un alias : il n’est utilisé qu’ici, et un alias
pour une règle unique n’apporterait aucune maintenabilité.
Le pare-feu n’est que le premier des trois verrous sur ce flux. En phase 6, si WordPress
ne joint pas la base malgré cette règle, vérifier dans l’ordre :
la règle de pare-feu (faite ici) ;
l’écoute réseau de MySQL — par défaut bind-address = 127.0.0.1, donc le service
refuse tout ce qui vient du réseau ;
les droits applicatifs — le compte doit être déclaré pour l’hôte d’origine :
CREATE USER 'wp'@'10.0.10.10'.
Points de vigilance rencontrés
Constat
Conséquence
Correction
Règle 5 créée avec la source USERS subnets(copie depuis l’onglet USERS)
Règle morte : sur l’onglet WEB, seuls entrent des paquets de 10.0.10.0/24. srv-web n’aurait eu aucun accès Internet — apt update en échec, sans message d’erreur côté pare-feu
Source corrigée en WEB subnets
Règle 4 (Reject) créée avec le protocole TCP au lieu de Any
Un flux UDP interne échappait à la règle et finissait sur le block all implicite : blocage effectif, mais non journalisé par la règle — donc pas de preuve exploitable en phase 7
Protocole passé à Any
Le point le plus important de cette étape. Une règle dont la source n’appartient pas au
réseau de l’onglet est silencieusement inopérante : pfSense l’accepte, l’affiche en vert,
et elle ne correspondra jamais à aucun paquet. Le bouton Copy fait gagner du temps entre
onglets mais ne met pas la source à jour.
Réflexe de contrôle : avant de valider un onglet, relire la colonne Source de haut en
bas. Elle ne peut contenir que le réseau de l’onglet, ou un hôte de ce réseau. Toute autre
valeur saute alors aux yeux.
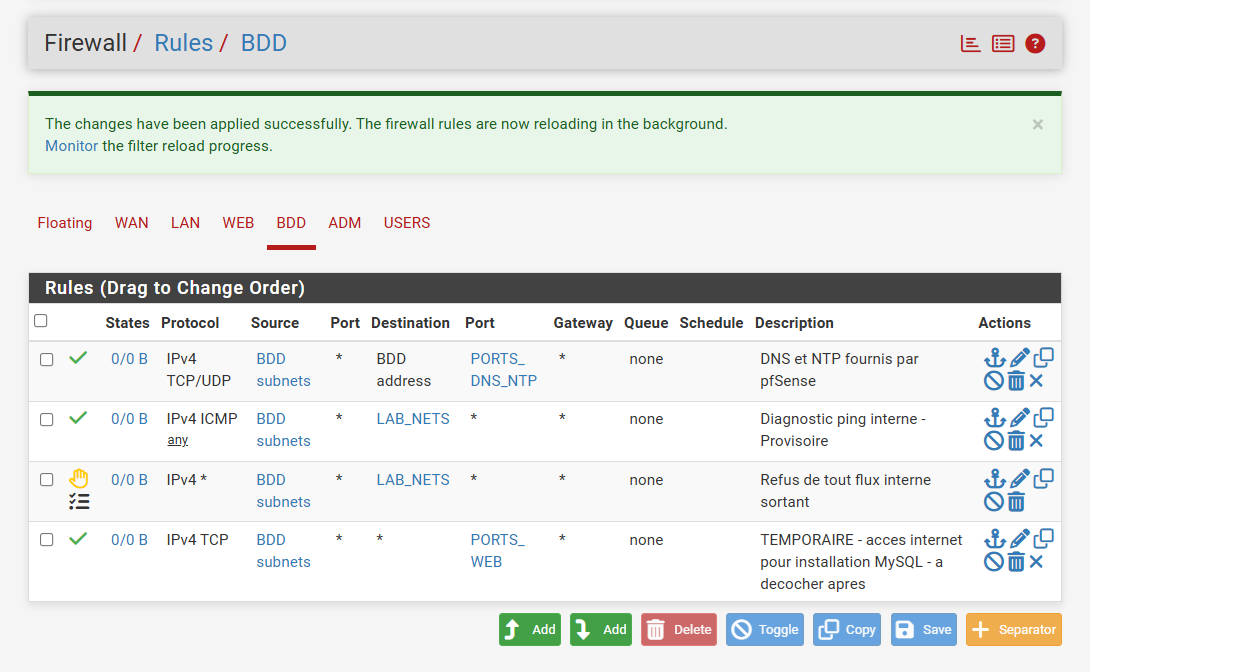
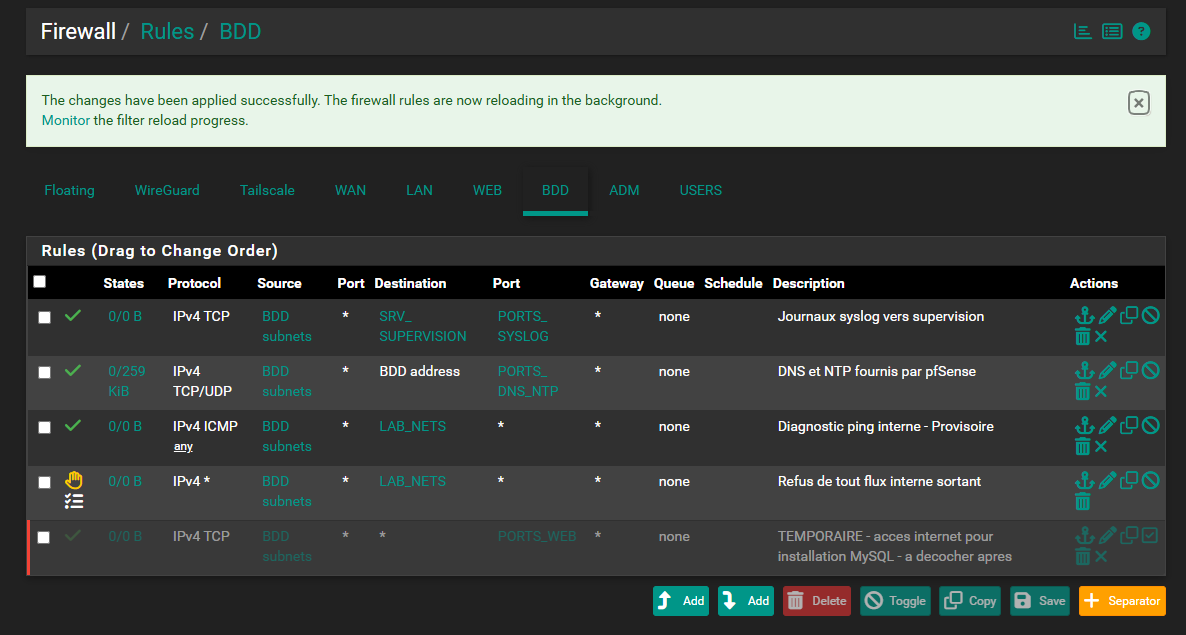
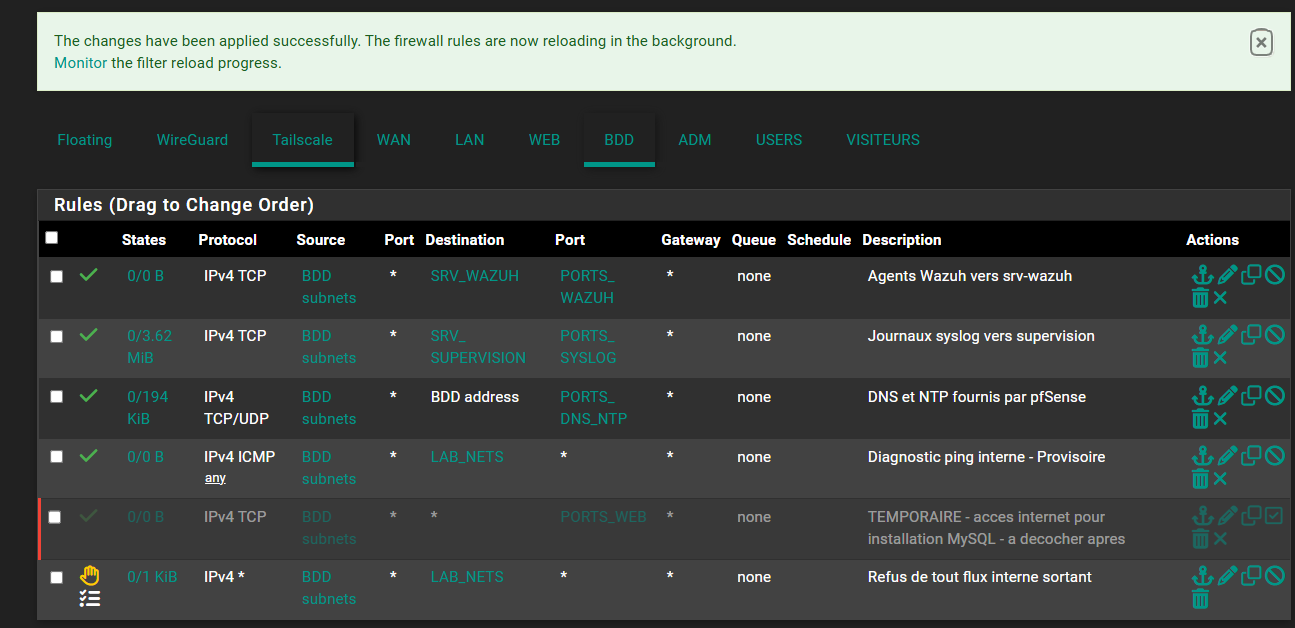
Étape 14 — Règles de pare-feu de l’onglet BDD (VLAN 20)
Firewall → Rules → onglet BDD
C’est la zone la plus fermée du lab : la base n’initie aucun flux.
#
Action
Proto
Source
Destination
Port
Log
Description
1
Pass
TCP/UDP
BDD subnets
BDD address
PORTS_DNS_NTP
—
DNS et NTP fournis par pfSense
2
Pass
ICMP (any)
BDD subnets
LAB_NETS
—
—
Diagnostic ping interne — provisoire
3
Reject
any
BDD subnets
LAB_NETS
any
Refus de tout flux interne sortant
4
Pass
TCP
BDD subnets
any
PORTS_WEB
—
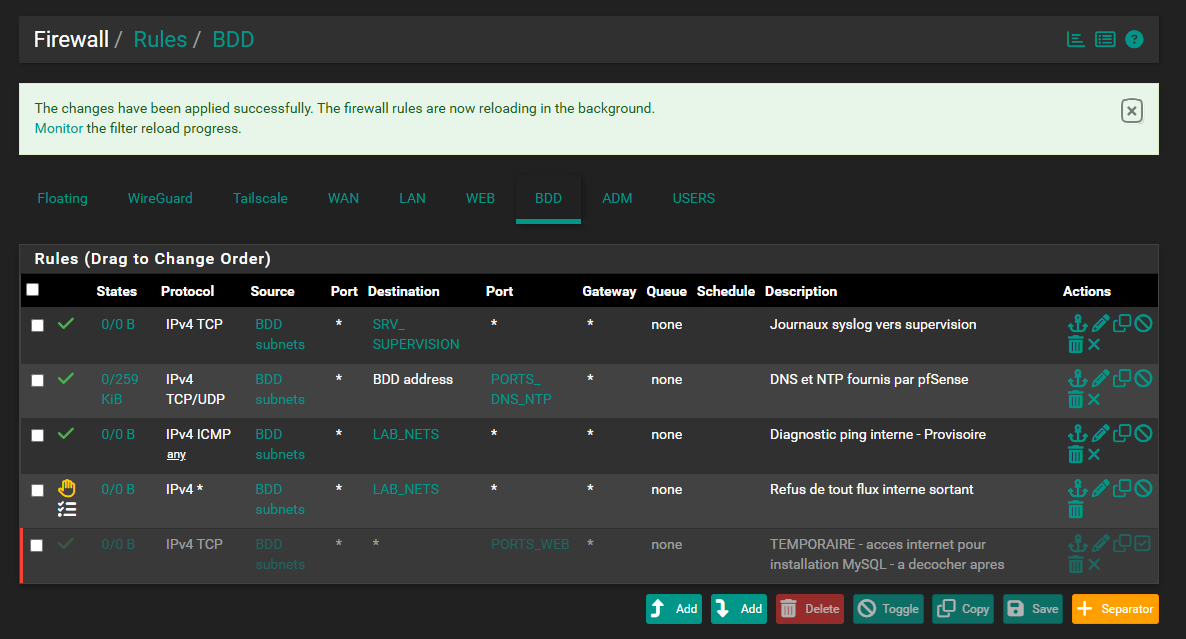
TEMPORAIRE — accès Internet pour installation MySQL, à décocher après
Aucune règle n’autorise le serveur web à entrer. C’est volontaire et correct : le flux
SRV_WEB → SRV_MYSQL : 3306 est autorisé sur l’onglet WEB (étape 13, règle 3), et les
réponses reviennent seules grâce à la table d’états. Ajouter une règle d’entrée ici ouvrirait
la base dans un sens qui ne doit jamais l’être.
La règle 4 est à DÉCOCHER, pas à supprimer (tâche 6.3). pfSense permet de désactiver une
règle sans l’effacer : elle reste grisée dans la liste et devient la trace documentaire de
la démarche — ouverture pour l’installation, fermeture ensuite.
Le log de la règle 3 est particulièrement important ici. Un flux sortant depuis la base
vers un autre VLAN serait le signe d’une exfiltration : une base de données n’a aucune
raison d’initier une connexion. C’est le journal le plus pertinent du lab à présenter.
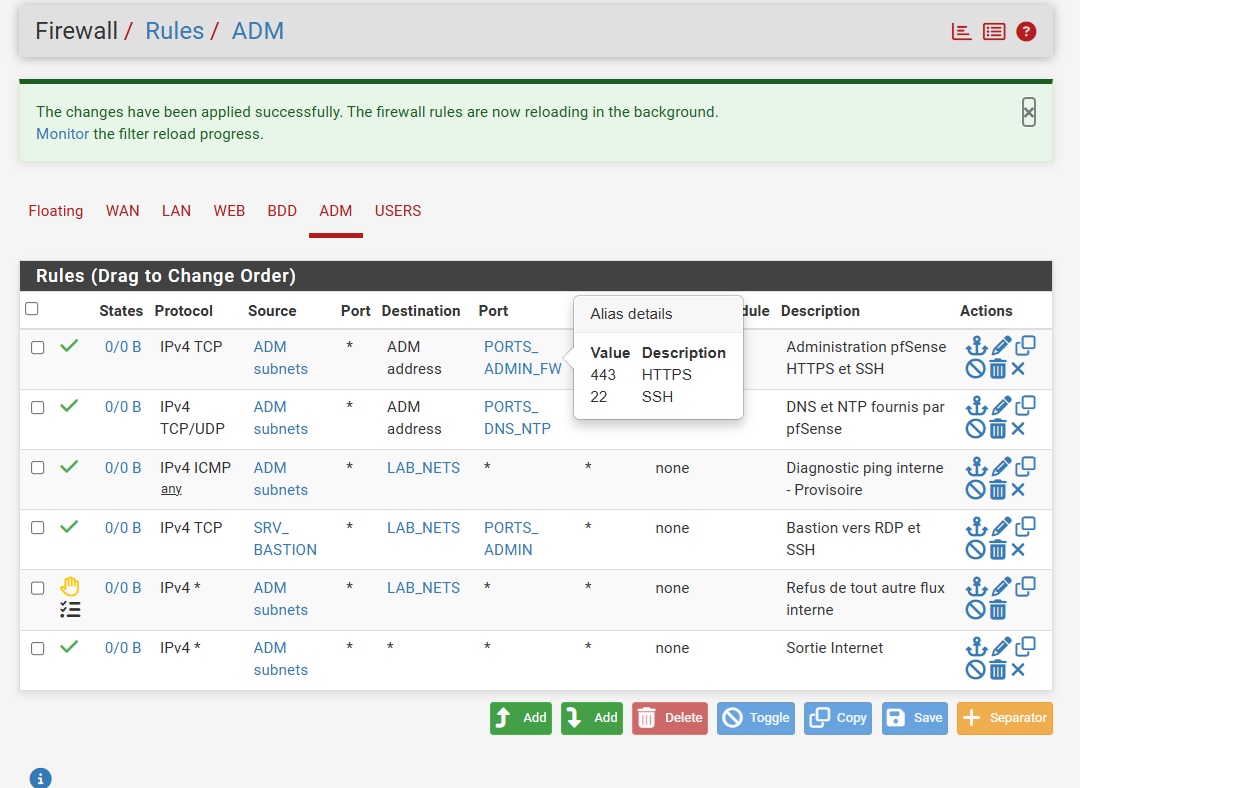
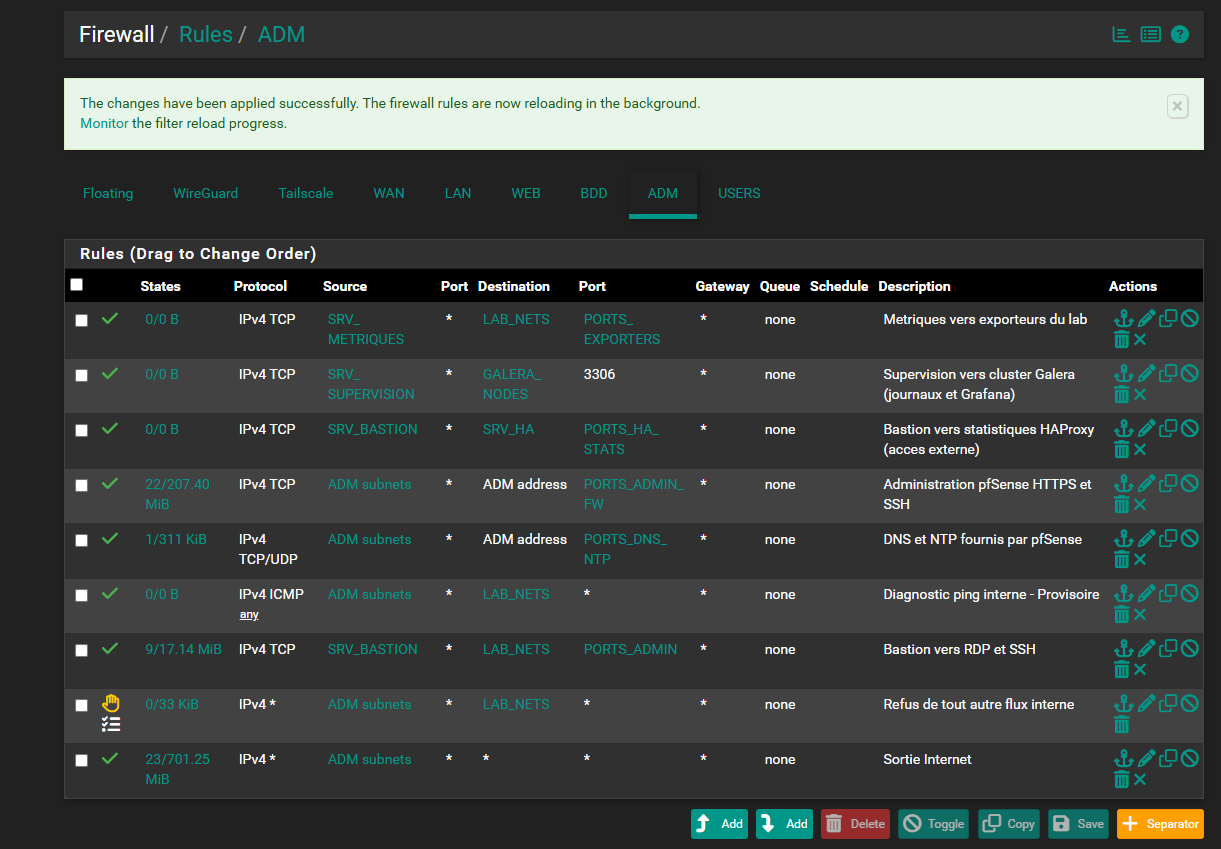
Étape 15 — Règles de pare-feu de l’onglet ADM (VLAN 30)
Firewall → Rules → onglet ADM
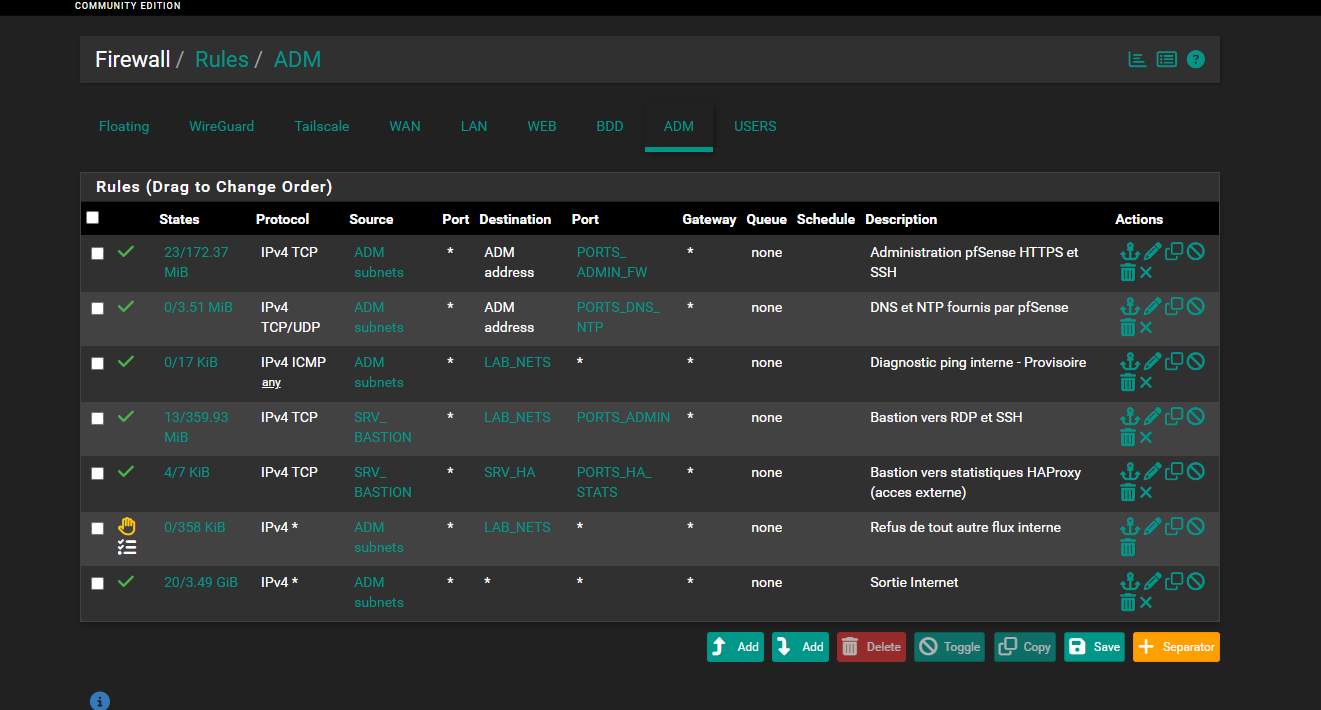
Cette série nécessite un alias supplémentaire : PORTS_ADMIN_FW (Port(s) : 443, 22).
#
Action
Proto
Source
Destination
Port
Log
Description
1
Pass
TCP
ADM subnets
ADM address
PORTS_ADMIN_FW
—
Administration pfSense HTTPS et SSH
2
Pass
TCP/UDP
ADM subnets
ADM address
PORTS_DNS_NTP
—
DNS et NTP fournis par pfSense
3
Pass
ICMP (any)
ADM subnets
LAB_NETS
—
—
Diagnostic ping interne — provisoire
4
Pass
TCP
SRV_BASTION
LAB_NETS
PORTS_ADMIN
—
Bastion vers RDP et SSH
5
Reject
any
ADM subnets
LAB_NETS
any
Refus de tout autre flux interne
6
Pass
any
ADM subnets
any
any
—
Sortie Internet
La règle 4 — la traduction du bastion
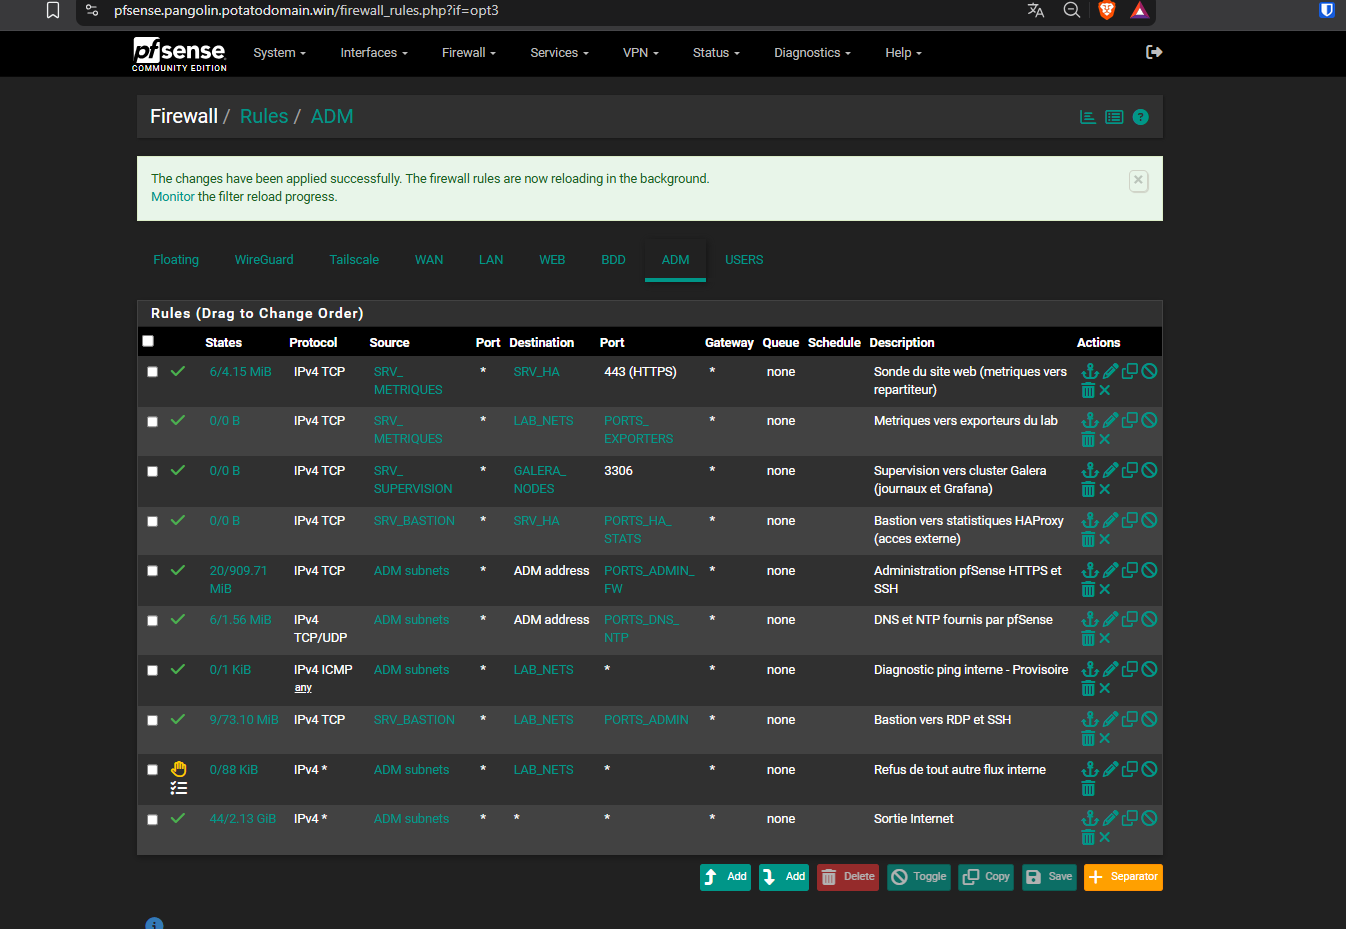
Sa source est SRV_BASTION (10.0.30.12) seul, pas ADM subnets. Combinée à la règle 5 qui
refuse tout le reste, elle impose que même les contrôleurs de domaine passent par Termix
pour administrer les autres VLAN.
        entrée étroite                      sortie limitée
  ADM / USERS ────────►  SRV_BASTION  ──────────────────►  tous les VLAN
   443 / 8443            10.0.30.12          22 / 3389
Conséquence assumée : pour administrer srv-web ou srv-mysql, on passe par le bastion, pas
par un SSH direct depuis un serveur AD. C’est exactement le comportement attendu — et ce qui rend
la règle démontrable. Un contrôleur de domaine compromis ne peut rien faire vers les autres
zones.
Deux alias de ports à ne pas confondre
Alias
Contenu
Usage
Règle
PORTS_ADMIN_FW
443, 22
joindre pfSense
1
PORTS_ADMIN
22, 3389
le bastion vers les serveurs
4
Deux usages distincts, donc deux alias. Les fusionner en un seul (22, 443, 3389) ferait qu’une
modification destinée au bastion — l’ajout de VNC sur 5900, par exemple — ouvrirait silencieusement
ce même port vers l’administration du pare-feu. Un alias = un usage, comme une variable en
programmation.
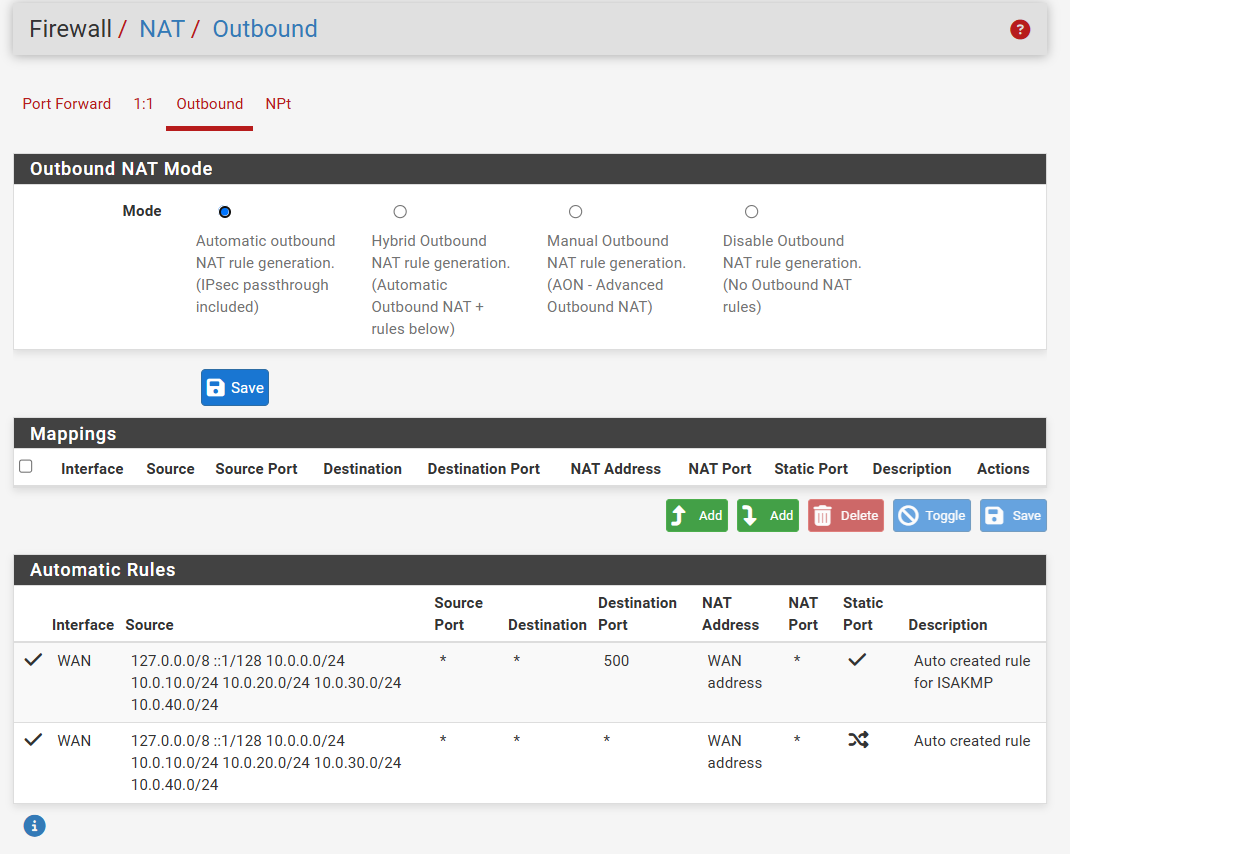
Validation : les cinq réseaux internes du lab apparaissent bien dans la liste des sources.
Toute machine des VLAN sortira donc en 10.1.0.197 — l’adresse WAN fixe retenue à l’étape 15.
Pourquoi le NAT est indispensable ici
Le réseau de l’établissement ne connaît pas les réseaux 10.0.x.0/24 et n’a aucune route vers
eux. Sans traduction, les paquets sortiraient bien, mais aucune réponse ne reviendrait : le
routeur de l’école ne saurait pas où les renvoyer.
Le NAT réécrit l’adresse source de chaque paquet sortant en 10.1.0.197. Vu de l’établissement,
l’ensemble du lab ressemble à une machine unique. pfSense conserve la table de correspondance
et restitue la bonne adresse interne au retour.
Pourquoi deux règles, et à quoi sert « Static Port »
Par défaut, le NAT ne réécrit pas seulement l’adresse source mais aussi le port source, en
tirant un numéro au hasard (icône ⇄ de la seconde règle). C’est ce qui permet à plusieurs machines
internes de partager la même adresse publique sans confusion.
La première règle est une exception pour ISAKMP (port 500, la négociation de clés IPsec) :
ce protocole exige que le port source reste 500. La case Static Port désactive donc la
réécriture pour ce trafic précis. pfSense crée cette exception automatiquement, même sans VPN
configuré.
Le mode Hybrid ne serait nécessaire que pour ajouter une règle de NAT particulière à une
machine donnée, tout en conservant les règles automatiques. Inutile ici.
Aucune règle de NAT entrante (Port Forward) n’est créée : le site web n’est pas publié vers
le réseau de l’établissement (décision §2.6).
La phase 4 est terminée. Le lab compte 12 alias, 22 règles de filtrage réparties sur 4 zones,
et un NAT sortant fonctionnel. Une sauvegarde XML de la configuration a été réalisée à ce stade
(Diagnostics → Backup & Restore) avant d’entamer la création des machines virtuelles.
Étape 17 — Première VM raccordée : poste-win11 (VLAN 40)
Première machine du lab. Volontairement choisie dans le VLAN 40 en DHCP plutôt qu’un serveur
en IP fixe : c’est la seule qui éprouve toute la chaîne d’un coup.
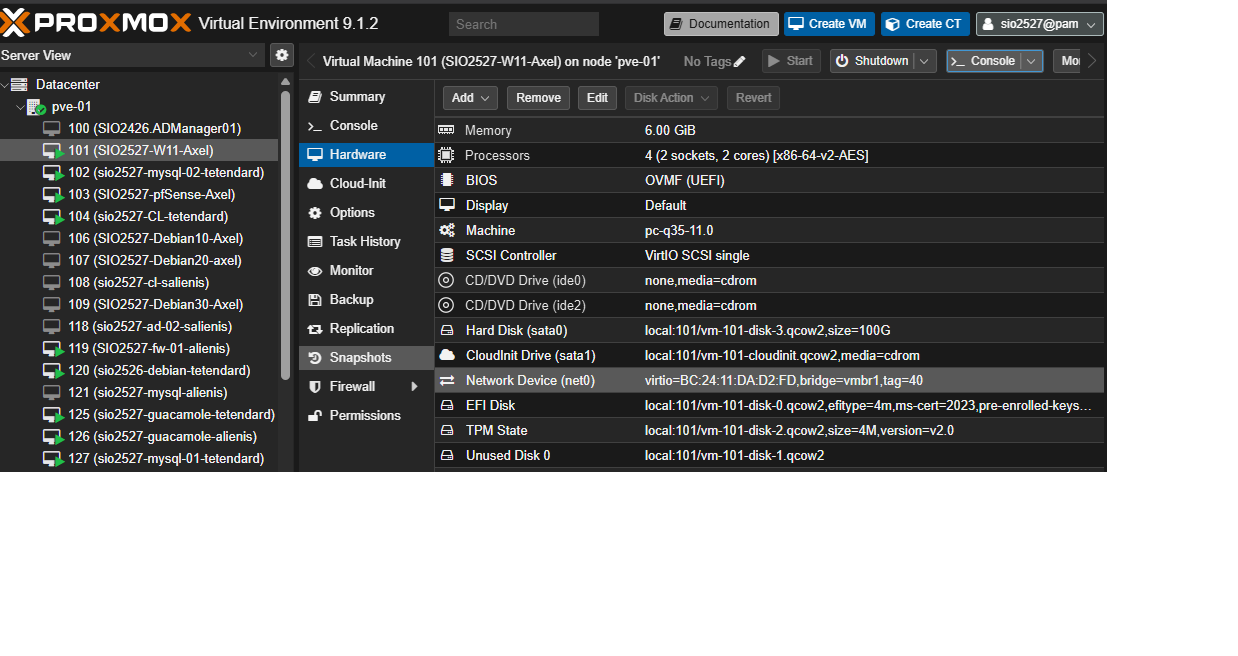
virtio → pilote paravirtualisé, reconnu par Windows comme Red Hat VirtIO Ethernet Adapter
bridge=vmbr1 → le switch virtuel isolé du lab
tag=40 → port access : Proxmox tague et détague pour la VM, qui n’a rien à configurer
absence de firewall=1 → le filtrage est laissé à pfSense seul
Différence avec pfSense : la VM pfSense a la même ligne sanstag — c’est son mode
trunk, elle gère les étiquettes elle-même. Ici, la VM ignore totalement l’existence des VLAN.
B — Résultat côté Windows
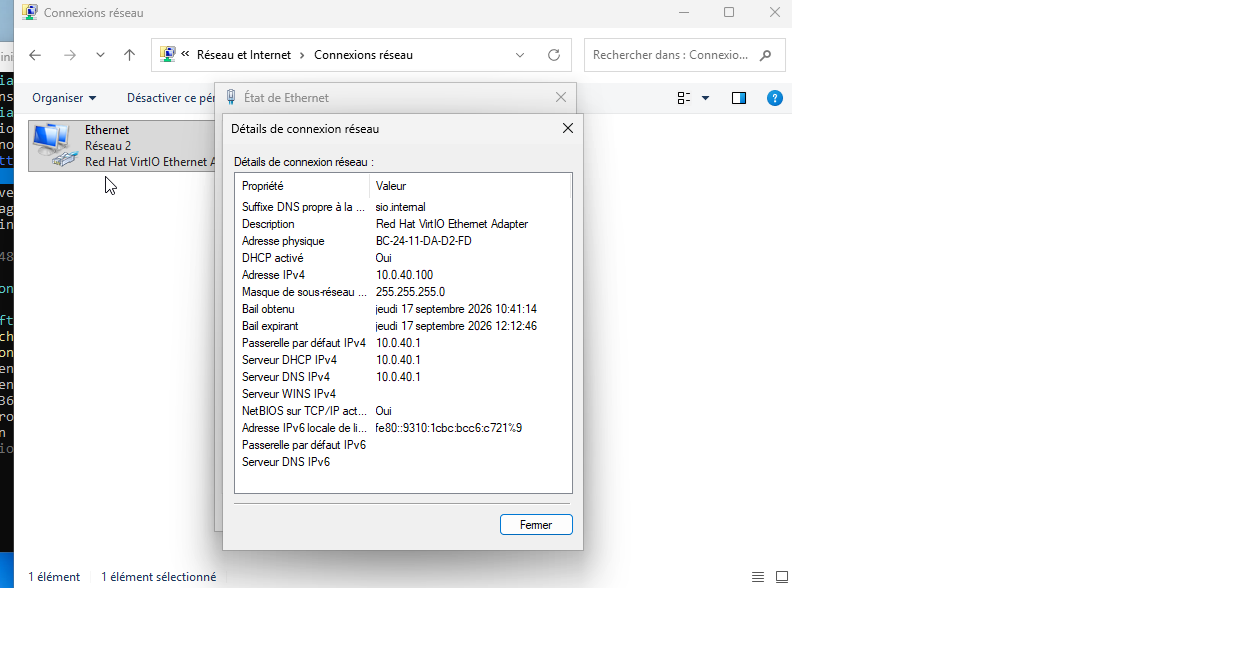
Panneau de configuration → Centre Réseau et partage → État de Ethernet → Détails
Propriété
Valeur
Validation
Description
Red Hat VirtIO Ethernet Adapter
pilote VirtIO actif
Adresse physique
BC-24-11-DA-D2-FD
correspond à la VM 101
DHCP activé
Oui
Adresse IPv4
10.0.40.100
première adresse de la plage .100 → .199
Masque
255.255.255.0
le /24
Passerelle
10.0.40.1
interface USERS de pfSense
Serveur DHCP
10.0.40.1
c’est bien pfSense qui a répondu
Serveur DNS
10.0.40.1
résolveur centralisé
Suffixe DNS
sio.internal
option de domaine du DHCP
Validation : cette seule capture valide les phases 1 à 4. Si un maillon de la chaîne avait
été erroné, la machine n’aurait obtenu aucune adresse — ou une adresse dans la mauvaise plage.
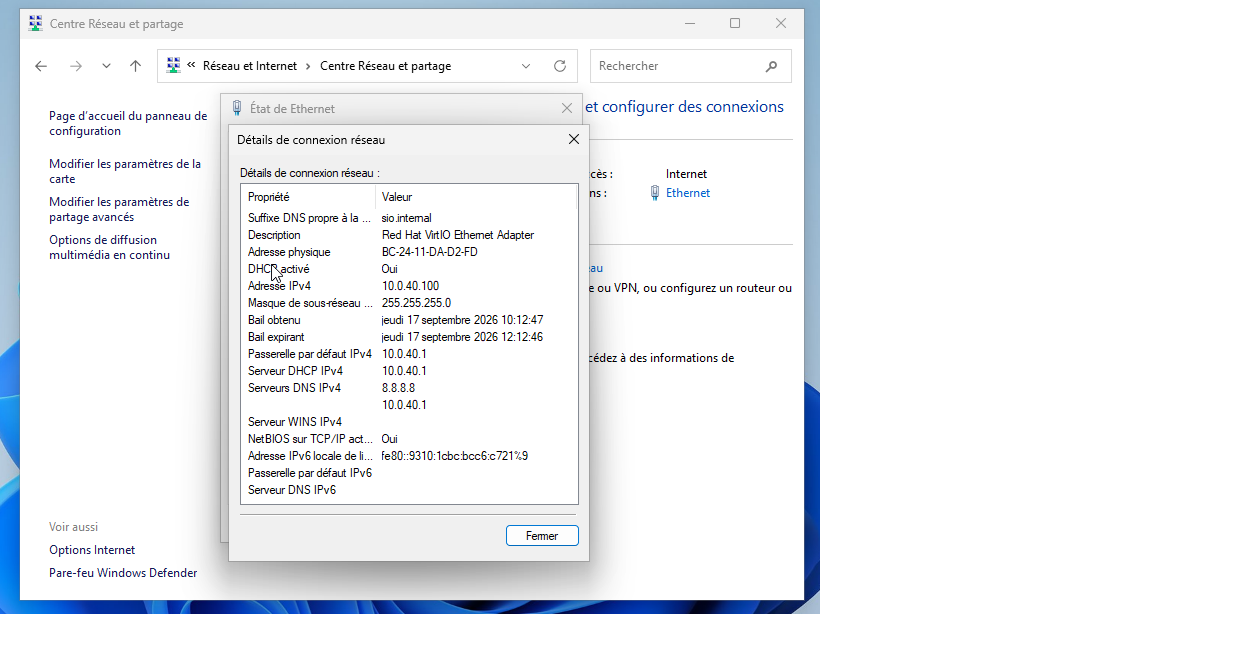
Point d’attention rencontré : les serveurs DNS distribués
Au premier bail, le poste a reçu 8.8.8.8 et 1.1.1.1 comme serveurs DNS au lieu de 10.0.40.1 :
Cause : le champ DNS Servers du serveur DHCP avait été laissé vide. Dans ce cas, pfSense ne
distribue pas sa propre adresse mais les serveurs configurés dans System → General Setup.
Conséquence : aucune résolution de noms possible. Les requêtes partaient vers 8.8.8.8 en
UDP 53, or aucune règle de l’onglet USERS ne couvre ce flux — la règle 1 vise USERS address,
la règle 6 ne concerne que l’interne, et la règle 7 n’autorise que les ports 80/443. Les requêtes
tombaient donc sur le block all implicite. Le pare-feu fonctionnait exactement comme prévu.
Correction : Services → DHCP Server → USERS → DNS Servers = 10.0.40.1 seul, puis
ipconfig /release && ipconfig /renew côté client.
Le diagnostic à retenir : « l’adressage fonctionne mais pas les noms » désigne
toujours le DNS, jamais le routage. Un ping par adresse IP qui passe et un ping par
nom qui échoue localisent la panne en deux commandes.
Étape 18 — srv-web : première VM en IP fixe (VLAN 10)
VM 110, Debian 13 « Trixie ». Première machine d’une zone sans DHCP : les paramètres réseau
sont saisis manuellement pendant l’installation.
A — Configuration réseau à l’installation
L’installateur affiche d’abord « La configuration automatique a échoué — Le protocole DHCP n’est
probablement pas utilisé sur le réseau ». Ce message est attendu, pas une panne : le DHCP est
volontairement désactivé sur le VLAN 10 (§2.5).
Continuer → Configurer le réseau vous-même :
Écran
Valeur
Adresse IP
10.0.10.10/24(la notation CIDR évite l’écran du masque)
Passerelle
10.0.10.1
Serveurs de noms
10.0.10.1
Nom de machine
srv-web
Domaine
sio.internal
Côté Proxmox : vmbr1 + VLAN Tag 10, modèle VirtIO, pare-feu décoché.
L’écran Serveurs de noms est celui qu’on bâcle, et aucun DHCP ne vient rattraper
l’oubli dans cette zone. Sans lui : adressage correct, mais apt inopérant.
B — Validation
# ip -4 addr show
2: ens18 ... inet 10.0.10.10/24 brd 10.0.10.255 scope global ens18

# ip route
default via 10.0.10.1 dev ens18 proto static metric 100
10.0.10.0/24 dev ens18 proto kernel scope link src 10.0.10.10 metric 100

# cat /etc/resolv.conf
nameserver 10.0.10.1

# apt update
Atteint : 1 http://deb.debian.org/debian trixie InRelease
Atteint : 2 http://deb.debian.org/debian trixie-updates InRelease
Atteint : 3 http://security.debian.org/debian-security trixie-security InRelease
Tous les paquets sont à jour.
apt update valide à lui seul quatre mécanismes : résolution DNS via pfSense, routage par
la passerelle, règle 5 de l’onglet WEB (WEB subnets → any : PORTS_WEB), et NAT sortant.
Ce n’est pas pfSense. Le pare-feu autorise bien ce flux (règle 2 de l’onglet WEB), et le
routage vers le VLAN 40 est fonctionnel — la même commande vers 10.0.40.1 répond.
Cause réelle : le pare-feu de Windows. Windows Defender bloque par défaut les demandes d’écho
ICMP entrantes provenant d’un autre sous-réseau, sauf si la règle Partage de fichiers et
d’imprimantes (demande d’écho — ICMPv4-Entrant) est activée.
Vérification : le ping en sens inverse (depuis Windows vers 10.0.10.10) fonctionne, ce qui
prouve que la connectivité et les règles pfSense sont correctes dans les deux sens.
Le point de cours : un pare-feu réseau n’est pas le seul filtre du chemin. Chaque hôte
possède son propre pare-feu, et Windows est particulièrement restrictif en entrée. Avant
d’incriminer pfSense, vérifier systématiquement que la machine cible accepte le flux — les
compteurs States et les journaux du pare-feu permettent de trancher en quelques secondes.
Étape 19 — srv-docker : le bastion (VLAN 30)
VM 114, Debian 12 « Bookworm ». Machine destinée à héberger Termix (SSH et RDP)
sous forme de conteneurs.
A — Paramètres retenus
Élément
Valeur
Justification
CPU
2 cœurs, type host
expose le vrai processeur : meilleures performances
Mémoire
4096 Mo, minimum 2048, ballooning
Plusieurs piles de conteneurs coexistent
Disque
32 Go
les images Docker sont volumineuses
BIOS
SeaBIOS
pas d’UEFI nécessaire sous Linux, évite le disque EFI
Qemu Agent
activé
Proxmox affiche l’IP et éteint proprement la VM
Réseau
vmbr1 + Tag 30, VirtIO, pare-feu décoché
Réseau invité
10.0.30.12/24, passerelle et DNS 10.0.30.1
saisis manuellement, pas de DHCP sur ce VLAN
Logiciels
sans environnement de bureau, serveur SSH coché
Mot de passe root laissé vide à l’installation. L’installateur Debian désactive alors le
compte root et ajoute automatiquement le premier utilisateur au groupe sudo — sudo est
opérationnel dès la première connexion, sans usermod ni redémarrage. C’est aussi plus sûr :
aucun compte root avec mot de passe à forcer par SSH.
B — Installation de Docker
Le dépôt officiel Docker a été retenu plutôt que les paquets Debian, pour disposer de
Compose v2 — la syntaxe supposée par la documentation de Termix.
Validation : docker run --rm hello-world puis docker ps sans sudo.
hello-world valide toute la chaîne réseau : résolution de registry-1.docker.io via
pfSense, sortie Internet par la règle 6 de l’onglet ADM, NAT, téléchargement, exécution.
Appartenir au groupe docker équivaut à un accès root sur la machine : un membre peut
lancer un conteneur montant / et modifier tout le système. Acceptable sur un serveur
d’administration mono-utilisateur, à proscrire sur une machine partagée.
C — Points d’attention rencontrés
Constat
Cause
Correction
E: Impossible de trouver le paquet docker-compose-v2
Ce paquet n’existe qu’à partir de Debian 13. srv-docker tourne sous Debian 12
Passage au dépôt officiel Docker, qui fournit docker-compose-plugin
docker-ce n'a pas de version susceptible d'être installée
Le fichier /etc/apt/sources.list.d/docker.list n’avait pas été créé — la commande echo | tee avait été collée en même temps qu’une autre
Commande relancée seule, puis vérifiée avec cat
Le réflexe de diagnostic : après l’ajout d’un dépôt, contrôler la sortie de apt update.
Si la nouvelle source n’y figure pas, inutile de chercher ailleurs. Le message « il existe
dans la base de données » signifie précisément : « je connais ce nom de paquet, mais aucune
source ne me le fournit ».
Et une règle générale : coller plusieurs commandes d’un coup dans un terminal est une
source d’erreurs silencieuses — une ligne avale la suivante, un caractère est mal interprété.
Pour les commandes qui écrivent des fichiers, une ligne à la fois, puis on vérifie.
D — Hétérogénéité des versions Debian
VM
Version
srv-web
Debian 13 Trixie
srv-docker
Debian 12 Bookworm
Écart constaté et assumé : les deux versions sont maintenues et fonctionnent. En production,
l’homogénéité serait recherchée — un seul cycle de mises à jour, une seule procédure, un seul jeu
de paquets à maîtriser.
Étape 20 — Les trois services du bastion
srv-docker héberge trois piles Compose indépendantes, chacune dans son propre réseau Docker.
Pile
Conteneurs
Publication
Accès
Termix
termix, termix-guacd
0.0.0.0:443
http://10.0.30.12:443
Portainer
portainer
127.0.0.1:9443
tunnel SSH uniquement
Chaque pile Compose crée son propre réseau isolé (termix-net, portainer_default).
Les conteneurs d’une pile ne peuvent pas joindre ceux d’une autre. C’est du cloisonnement à
l’échelle des conteneurs — la même logique que les VLAN, un étage plus bas.
A — Termix
Portail d’accès unique : SSH, bureau à distance — via le moteur guacd qu’il embarque —,
transfert de fichiers, gestion Docker et métriques. Base SQLite par défaut, aucun serveur de
base de données à déployer à côté.
/opt/termix/docker-compose.yml
services:termix:image:ghcr.io/lukegus/termix:latestcontainer_name:termixrestart:unless-stoppedports:- "443:8080"environment:PORT:"8080"volumes:- termix-data:/app/datanetworks:- termix-netdepends_on:- termix-guacdtermix-guacd:image:guacamole/guacd:1.6.0 # moteur de rendu embarque par Termixcontainer_name:termix-guacdrestart:unless-stoppednetworks:- termix-netvolumes:termix-data:driver:localnetworks:termix-net:driver:bridge
Le moteur de rendu est nommé termix-guacd : les noms de conteneurs sont uniques
sur l’hôte, un préfixe explicite évite toute collision avec une autre pile. Le port 4822
n’est pas publié — il n’est joignable qu’à l’intérieur du réseau termix-net.
B — Portainer
Supervision des conteneurs. Volontairement non exposé au réseau : la publication est liée à
127.0.0.1, et l’accès se fait par tunnel SSH depuis le poste de travail.
puis https://localhost:9443(certificat auto-signé).
Pourquoi Portainer n’est pas dans PORTS_BASTION. Termix est un portail d’accès
destiné aux utilisateurs. Portainer est un outil d’exploitation : il
monte /var/run/docker.sock, donc quiconque y accède peut lancer un conteneur montant / et
obtenir root sur srv-docker. Un tel outil n’a pas à être joignable depuis le VLAN
utilisateurs.
Le tunnel SSH -L fait écouter le port 9443 sur le poste de travail et ressortir le
trafic à l’autre bout de la session SSH, sur srv-docker. Le navigateur croit parler à sa
propre machine ; rien n’est exposé, aucune règle n’est ajoutée. Il fonctionne à travers le
ProxyJump — le tunnel s’établit sur le dernier saut.
C — Contrainte de ports imposée par le pare-feu
L’alias PORTS_BASTION n’autorise que le 443. Termix y est donc publié — alors qu’il sert
du HTTP en clair.
Conséquence : aucune URL courte ne fonctionne. http://10.0.30.12 part sur le port 80,
https://10.0.30.12 tenterait une négociation TLS que Termix ne sait pas faire. Il faut écrire
http://10.0.30.12:443.
Un cas où la contrainte de sécurité a forcé un choix technique discutable — et il faut
savoir le reconnaître plutôt que le masquer. Deux corrections possibles :
Correction
Effet
Ajouter 80 à PORTS_BASTION et republier Termix sur le 80
http://10.0.30.12 fonctionne naturellement
Reverse proxy (Traefik/Nginx) sur le 443, avec TLS
https://termix.sio.internal servi en vrai HTTPS, et tout service futur sur le même port — la solution canonique
Le reverse proxy résout aussi le problème de fond : chaque port ouvert dans le pare-feu est une
ligne à justifier. Un point d’entrée unique en réduit le nombre à un.
Validation : Termix répond depuis poste-win11 (VLAN 40), ce qui valide la règle 4 de
l’onglet USERS.
Étape 21 — Accès distant par Tailscale (subnet router)
Objectif : joindre l’intégralité du lab depuis n’importe où, sans ouvrir le moindre port
entrant sur le réseau de l’établissement.
A — Pourquoi Tailscale, et pourquoi sur pfSense
Le lab est derrière le NAT de l’établissement, que l’on ne maîtrise pas : aucune redirection de
port n’est possible, et un VPN classique (WireGuard, OpenVPN) exigerait un port entrant depuis
Internet. Un tunnel sortant contourne cette contrainte : c’est l’agent qui va vers le service.
Le choix du subnet router — plutôt qu’un agent sur chaque machine — permet d’exposer des
réseaux entiers avec un seul nœud enrôlé.
Et ce nœud doit être pfSense, pas srv-docker :
Emplacement
Conséquence
srv-docker
Tailscale applique du SNAT : le trafic semble venir de 10.0.30.12 = SRV_BASTION. La règle 4 de l’onglet ADM ne l’autoriserait qu’en 22 et 3389 — il faudrait élargir les règles du bastion
pfSense
Le trafic entre directement dans le routeur, qui le distribue vers les VLAN. Une interface de plus, avec ses propres règles, sans toucher au reste
Cohérent avec toute l’architecture : pfSense reste le point de passage unique entre le
lab et l’extérieur. Tailscale devient sa troisième patte, à côté du WAN et du trunk.
B — Isolation vis-à-vis du réseau personnel
Un tailnet dédié au BTS a été créé, avec une identité distincte de celle du réseau personnel
déjà existant.
Une même identité = un même tailnet. Se reconnecter avec le compte Google personnel
aurait ramené sur le tailnet existant. Il faut une identité différente (adresse scolaire,
second compte, GitHub…).
L’alternative aurait été un tailnet unique avec des tags et des ACL — plus souple
(les deux réseaux visibles simultanément), mais demandant d’écrire une politique JSON. Le
compte séparé garantit l’isolation par construction, au prix d’une bascule de profil
(tailscale switch).
C — Configuration du paquet pfSense
System → Package Manager → installer Tailscale, puis VPN → Tailscale
Onglet Authentication
Champ
Valeur
Login Server
https://controlplane.tailscale.com
Pre-authentication Key
clé tskey-auth-… générée dans la console (non réutilisable)
Onglet Settings
Champ
Valeur
Justification
Enable Tailscale
Accept DNS
décoché
sinon pfSense adopterait les DNS de Tailscale (MagicDNS), écrasant la configuration du §2.6
Accept Subnet Routes
pfSense n’a pas besoin des routes annoncées par d’autres nœuds
Advertise Exit Node
optionnel — ferait de pfSense une sortie Internet pour le tailnet
une route annoncée n’est pas diffusée tant qu’elle n’est pas validée — on ne laisse pas un nœud s’auto-déclarer routeur d’un réseau entier
Disable key expiry sur le nœud pfSense
sans cela, déconnexion silencieuse au bout de ~180 jours
E — Côté poste de travail
Installation du client, connexion au tailnet BTS, puis — l’étape que l’on oublie :
cocher « Use Tailscale subnets ». Sans elle, le nœud pfSense est visible mais aucun des
réseaux 10.0.x.0/24 n’est joignable.
F — La règle de pare-feu
Le paquet crée une interface tailscale0, placée dans un groupe pf nommé Tailscale — ce
qui fait apparaître un onglet dédié dans Firewall → Rules, sans assignation d’interface.
L’onglet est vide à la création : « No rules are configured for this interface ». Règle d’or
n°3 — rien ne passe.
Champ
Valeur
Action
Pass
Address Family
IPv4+IPv6
Protocol
Any
Source
any
Destination
any
Description
Acces complet au lab depuis le tailnet BTS
Pourquoi any en source plutôt que la plage CGNAT 100.64.0.0/10 :
L’interface est elle-même la frontière. Sur Tailscale, il n’arrive que du trafic sorti du
tunnel WireGuard, donc que des machines authentifiées du tailnet. Le filtrage réel a déjà eu
lieu — il est assuré par Tailscale (clés, identités, appareils autorisés), pas par pfSense.
De plus, 100.64.0.0/10casserait l’IPv6 : Tailscale attribue aussi une adresse
fd7a:115c:a1e0::/48 à chaque nœud.
La bonne granularité n’est pas toujours la plus fine : ici, la restriction utile se
configure dans la console Tailscale, pas dans le pare-feu.
Décision à assumer : cette règle fait du tailnet une zone de confiance disposant d’un
accès complet au lab. C’est l’objectif recherché, mais c’est une entrée de plus dans la matrice
de flux, au même titre que le WAN.
G — Validation
PS> tailscale status
100.84.62.27  sio2527-pfsense-axel  freebsd  active; direct 10.1.0.197:41641, tx 572 rx 156

PS> ping 10.0.30.12
Réponse de 10.0.30.12 : octets=32 temps=12 ms
Paquets : envoyés = 2, reçus = 2, perdus = 0 (0% de perte)

PS> ssh [email protected]
Linux SRV-WEB 6.12.107+deb13-amd64
Le poste de travail joint l’intégralité du lab — SSH direct, interfaces web, interface
d’administration de pfSense — sans rebond, sans tunnel manuel, et sans aucun port ouvert sur
le réseau de l’établissement.
Ce que révèle tailscale status : direct 10.1.0.197:41641 signifie que la liaison est
pair-à-pair, sans passer par les serveurs relais de Tailscale — les deux machines étant sur
le réseau de l’établissement. Depuis l’extérieur, la mention deviendrait relay "..." : plus
lent, mais fonctionnel.
Et tx 572 rx 156 prouve que des octets circulent dans les deux sens. C’est ce qui a permis
d’écarter le réseau et de conclure au pare-feu lors du diagnostic.
Étape 22 — Configuration du bastion : identifiants et hôtes
Termix sépare les identifiants des hôtes : un même identifiant se réutilise sur
plusieurs machines, et un changement de mot de passe se fait à un seul endroit. Même principe
que les alias de pfSense — définir une fois, réutiliser partout.
Pour pfSense, viser 10.0.30.1 et non 10.1.0.197. Termix se connecte depuis
srv-docker, situé dans le VLAN 30 : il doit viser pfSense sur son propre réseau. C’est
la règle d’or n°1 appliquée au client — on vise le pare-feu sur le réseau d’où l’on vient.
Clé dédiée pour pfSense
pfSense étant configuré en SSHd Key Only, le bastion a reçu sa propre paire de clés plutôt
que de réautoriser les mots de passe :
La clé publique est ajoutée sur une nouvelle ligne dans User Manager → admin → Authorized
SSH Keys, sous celle du poste de travail. La clé privée est importée comme identifiant dans
Termix.
Résultat : pfSense n’accepte aucun mot de passe en SSH. Deux clés seulement y ont accès
— celle du poste de travail et celle du bastion. Voir l’incident
G-05 pour le détail du diagnostic.
Deux paramètres à corriger
Réglage
Valeur
Incident
Paramètres administrateur → URL GUACD
localhost:4822 → termix-guacd:4822
G-06 — localhost désigne le conteneur Termix lui-même
Sur l’hôte RDP → « Ignorer le certificat du serveur »
activé
G-07 — Windows présente un certificat auto-signé que guacd refuse
Validation : les quatre hôtes s’ouvrent dans le navigateur depuis n’importe où via
Tailscale — trois terminaux SSH et le bureau Windows 11 en RDP.
Cela valide les deux ports de la règle 4 de l’onglet ADM :
L’image à garder pour le dossier : le bureau d’une machine du VLAN 40, affiché dans
un navigateur, servi par un bastion du VLAN 30, depuis un poste extérieur au lab connecté
en Tailscale. Toute l’architecture tient dans une capture.
Serveur SSH sur le poste Windows
Windows 11 installe le client OpenSSH par défaut, pas le serveur. La première tentative
de session SSH échouait donc en timeout — et non en connexion refusée, signe que le pare-feu
Windows jetait le paquet faute de règle pour le port 22.
L’installation de la fonctionnalité crée automatiquement la règleOpenSSH-Server-In-TCP
dans le pare-feu Windows — comme pour le Bureau à distance. Seul l’ICMP demande une intervention
manuelle (incident E-04).
Optionnel — obtenir PowerShell plutôt que cmd.exe à l’ouverture de session :
Une seule règle de pare-feu pour deux protocoles.poste-win11 est désormais
administrable en SSH et en RDP, et l’alias PORTS_ADMIN (22, 3389) couvrait les deux cas
dès le départ — sans qu’il ait fallu y revenir. C’est le bénéfice concret d’avoir conçu la
matrice de flux avant de toucher à l’interface.
Étape 23 — Agent QEMU sur pfSense
Permet à Proxmox d’afficher l’adresse IP de la VM, de l’arrêter proprement et de réaliser des
sauvegardes cohérentes.
Installation
Le paquet figure dans le dépôt officiel pfSense — ce n’est donc pas un ajout non supporté :
pkg install -y qemu-guest-agent
Côté Proxmox : VM 103 → Options → QEMU Guest Agent → Enabled, puis Shutdown + Start.
Un reboot ne suffit pas. Le périphérique virtio-serial fait partie du matériel
virtuel : Proxmox ne peut l’ajouter qu’au démarrage du processus QEMU. Un redémarrage vu de
l’intérieur ne détruit pas ce processus.
Règle générale : tout changement de matériel dans Proxmox demande un cycle
Shutdown → Start ; tout changement logiciel se contente d’un reboot. C’est la même
contrainte que pour l’ajout de la carte net1 à l’étape 3.
Vérification du canal de communication :
ls -l /dev/vtcon/
org.qemu.guest_agent.0 -> ../ttyV0.1
Démarrage automatique — par Shellcmd
La commande sysrc qemu_guest_agent_enable="YES" proposée par le paquet ne suffit pas :
pfSense possède son propre processus de démarrage (/etc/rc.bootup) et ne traite pas
/etc/rc.conf comme un FreeBSD standard. Le service ne repartait pas après redémarrage.
System → Package Manager → Shellcmd, puis Services → Shellcmd :
Champ
Valeur
Command
/usr/sbin/service qemu-guest-agent start
Shellcmd Type
shellcmd
Description
Demarrage de l'agent QEMU pour Proxmox
Pourquoi Shellcmd plutôt qu’un fichier système : la commande est enregistrée dans la
configuration XML de pfSense. Elle est donc incluse dans les sauvegardes, restaurée
automatiquement, et visible dans l’interface — donc documentée. Une ligne ajoutée à la main
dans /etc/rc.conf disparaîtrait à la première restauration.
Sur un équipement à configuration gérée, on n’édite pas les fichiers système : on utilise
le mécanisme d’extension prévu.
On appelle le service, pas l’exécutable : le script rc connaît le chemin, les
arguments et gère le fichier PID. Si une mise à jour déplace le binaire, la commande continue
de fonctionner.
Validation : après redémarrage, service qemu-guest-agent status répond
running as pid ... sans intervention, et Proxmox affiche l’adresse IP dans l’onglet Résumé.
Étape 24 — srv-mysql : la base de données
Objectif : déployer la 4ᵉ VM, y installer le SGBD, le durcir, puis l’ouvrir au seul flux
qui en a besoin — srv-web sur le port 3306.
24.1 — Création de la VM sous Proxmox
Paramètre
Valeur
Nom
SIO2527-srv-mysql-Axel
Système
Debian 13 · SeaBIOS · VirtIO SCSI single
Agent
Qemu Agent (coché dès la création)
Disque / CPU / RAM
32 Go · 2 cœurs host · 2048 Mo
Réseau
vmbr1 + VLAN Tag 20 · VirtIO · Firewall
24.2 — Installation de Debian
Le message « La configuration automatique du réseau a échoué » est attendu : le DHCP est
volontairement absent du VLAN 20. Configuration manuelle :
À faire pendant que la fenêtre est ouverte. La règle 4 de l’onglet BDD autorise
temporairement la sortie Internet ; elle sera décochée ensuite (tâche 6.3). Après quoi
aucun paquet ne pourra plus être téléchargé depuis ce VLAN.
Validation de l’agent — trois contrôles :
uptime -s
systemctl status qemu-guest-agent --no-pager
ls -l /dev/virtio-ports/
L’agent démarre à l’heure exacte du démarrage système, donc au boot.
systemctl is-enabled répond static, ce qui n’est pas un problème : sous Debian
l’agent est lancé par une règle udev dès que le périphérique virtio apparaît, et non par
un lien dans multi-user.target.wants.
24.4 — Sécurisation
sudo mariadb-secure-installation
Question
Réponse
Pourquoi
Enter current password for root
(vide)
aucun mot de passe défini
Switch to unix_socket authentication
n
déjà actif sous Debian
Change the root password
n
inutile avec unix_socket
Remove anonymous users
y
comptes sans identifiant
Disallow root login remotely
y
root reste local
Remove test database
y
base ouverte à tous
Reload privilege tables
y
application immédiate
Debian 13 affiche désormais : « MariaDB is secure by default in Debian. Running this
script is useless at best ». C’est exact — le script est conservé par compatibilité avec le
monde MySQL amont. On le lance quand même pour pouvoir prouver l’état, pas le supposer.
Validation fonctionnelle — la commande qui tranche :
mariadb -u root
(sans sudo, donc en tant qu’ipfixe)
ERROR 1698 (28000): Access denied for user 'root'@'localhost'
Le code 1698 est la signature de unix_socket : il signifie que le greffon
d’authentification a refusé, et non qu’un mot de passe était faux (ce serait 1045).
La vue mysql.user affiche pourtant mysql_native_password. La source de vérité est
mysql.global_priv :
auth_or énumère les méthodes alternatives. La première est verrouillée : le champ
authentication_string contient le mot invalid, qui n’est pas une empreinte valide —
aucun mot de passe ne peut produire cette valeur. Seul unix_socket fonctionne. La vue
mysql.user ne lit que le champ plugin de premier niveau et ignore auth_or.
24.5 — Écoute réseau : bind-address
Par défaut Debian lie MariaDB à la boucle locale. Aucun service n’étant posté sur
10.0.20.10:3306, une connexion de srv-web serait refusée — pas bloquée : le paquet
arrive, mais personne n’écoute.
AVANT   LISTEN 0 80 127.0.0.1:3306
APRÈS   LISTEN 0 80 10.0.20.10:3306
Pourquoi l’adresse explicite plutôt que 0.0.0.0 — le joker exposerait automatiquement
le service sur toute interface ajoutée plus tard. L’adresse explicite ne bouge pas, et le
fichier documente l’intention. C’est le principe de moindre exposition.
Effet de bord assumé : mariadb -h 127.0.0.1 ne fonctionne plus en local.
sudo mariadb continue de fonctionner — il passe par la socket Unix, qui est de toute façon
le bon moyen en local.
24.6 — Base wp_lab et compte distant
sudo mariadb -e "CREATE DATABASE wp_lab CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci; CREATE USER 'wp_user'@'10.0.10.10' IDENTIFIED BY '<mot-de-passe-wp_user>'; GRANT ALL PRIVILEGES ON wp_lab.* TO 'wp_user'@'10.0.10.10';"
Élément
Choix
Justification
Jeu de caractères
utf8mb4
le utf8 de MySQL est tronqué à 3 octets et ne gère pas les emoji — WordPress exige utf8mb4
Compte
'wp_user'@'10.0.10.10'
dans MySQL une identité est le couple qui + d’où ; le compte n’existe pas depuis une autre adresse
Privilèges
ON wp_lab.*
WordPress crée et modifie ses tables, mais n’a aucune raison de voir les autres bases
Ne jamais écrire 'wp_user'@'%'. Le joker % autorise la connexion depuis n’importe
quelle adresse. Le mot de passe figurant en clair dans wp-config.php, la restriction
d’origine est ce qui le rend inexploitable en cas de fuite.
FLUSH PRIVILEGES est inutile ici : il ne sert que si l’on modifie les tables de droits
à la main par INSERT/UPDATE. CREATE USER et GRANT rechargent les privilèges seuls.
Validation :
| wp_lab |

GRANT USAGE ON *.* TO `wp_user`@`10.0.10.10` IDENTIFIED BY PASSWORD '*2DB29C...'
GRANT ALL PRIVILEGES ON `wp_lab`.* TO `wp_user`@`10.0.10.10`
GRANT USAGE ON *.* ne donne aucun droit : USAGE signifie littéralement « aucun
privilège ». Cette ligne matérialise l’existence du compte et porte l’empreinte du mot de
passe. Le privilège réel est sur la seconde ligne.
24.7 — Les trois verrous, récapitulés
C’est le point à retenir de cette étape : l’accès à la base est protégé par trois mécanismes
indépendants, chacun couvrant la défaillance des autres — c’est la défense en profondeur.
#
Mécanisme
Où
Ce qu’il arrête
1
bind-address = 10.0.20.10
srv-mysql
personne n’écoute ailleurs → connexion refusée
2
Règle 3 de l’onglet WEB
pfSense
le paquet n’atteint même pas la machine
3
GRANT ... @'10.0.10.10'
MariaDB
le service répond, mais l’identité est refusée
Étape 25 — WordPress sur srv-web et validation du flux inter-VLAN
Objectif : monter la chaîne applicative complète et démontrer qu’une application d’un VLAN
consomme une base d’un autre VLAN, routée et filtrée par pfSense.
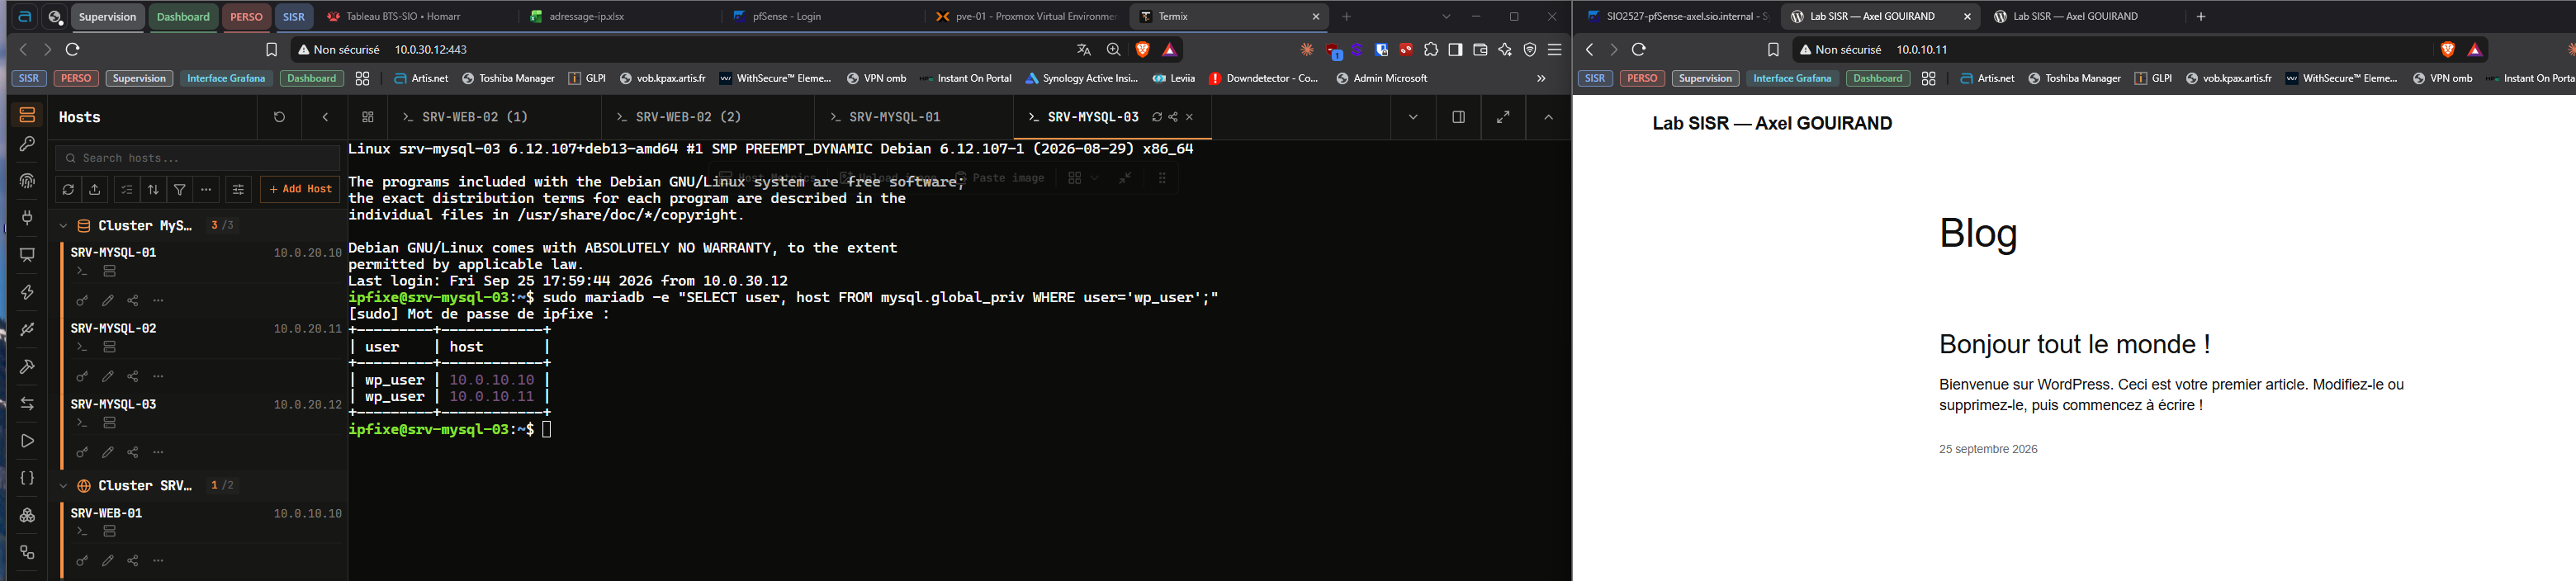
La démonstration du moindre privilège : la même commande renvoie 5 bases en root
sur srv-mysql et 2 depuis wp_user. MariaDB masque ce à quoi le compte n’a pas droit.
Une erreur de frappe sur le mot de passe a fourni la meilleure preuve du TP :
ERROR 1045 (28000): Access denied for user 'wp_user'@'10.0.10.10' (using password: YES)
Ce message est revenu de srv-mysql : le routage inter-VLAN et la règle de pare-feu
étaient donc déjà franchis. Le serveur a même reconnu exactement le compte créé. Seul le
verrou 3 a joué. Les trois couches sont ainsi démontrées indépendamment.
Code
Signification
1045
mot de passe incorrect
1698
le greffon d’authentification a refusé (cf. étape 24.4)
25.3 — Déploiement des fichiers
cd /tmp && curl -O https://fr.wordpress.org/latest-fr_FR.tar.gz
tar xzf latest-fr_FR.tar.gz && sudo mv wordpress /var/www/wordpress
sudo chown -R www-data:www-data /var/www/wordpress
sudo find /var/www/wordpress -type d -exec chmod 755{}\;sudo find /var/www/wordpress -type f -exec chmod 644{}\;
Réglage
Justification
chown www-data
Apache tourne sous ce compte ; il doit posséder les fichiers pour écrire médias et mises à jour
755 sur les dossiers
le bit x d’un dossier signifie « le traverser » — sans lui Apache ne descend pas dans l’arborescence
644 sur les fichiers
aucun bit d’exécution
Pourquoi retirer x des fichiers, et ne jamais faire chmod -R 777. Si un attaquant
dépose un fichier dans wp-content/uploads, le bit d’exécution lui permettrait de le lancer
comme programme. Sans lui, le fichier reste une donnée inerte — une des protections les plus
efficaces contre le dépôt de webshell. PHP n’a pas besoin de ce bit : Apache lit le
fichier et le passe à l’interpréteur.
autorise les .htaccess — WordPress en a besoin pour ses permaliens
Require all granted
contrôle d’accès Apache 2.4 (l’ancienne Allow from all ne fonctionne plus)
a2enmod rewrite
sans lui, WordPress ne produit que des URL en ?p=123
a2dissite 000-default
retire la page « It works! » qui répondrait à la place du site
apache2ctl configtest avant tout rechargement. Il valide la syntaxe sans toucher au
service : recharger une configuration invalide arrête Apache.
Validation intermédiaire, avant même de configurer la base :
curl -I http://localhost
→ HTTP/1.1 302 Found
→ Location: http://localhost/wp-admin/setup-config.php
WordPress est servi et réclame sa configuration : la couche web est validée indépendamment
de la couche données.
25.5 — wp-config.php, la jonction entre les deux serveurs
cd /var/www/wordpress && sudo -u www-data cp wp-config-sample.php wp-config.php
sudo -u www-data sed -i "s/'database_name_here'/'wp_lab'/; s/'username_here'/'wp_user'/; s/'password_here'/'<mot-de-passe-wp_user>'/; s/'localhost'/'10.0.20.10'/" wp-config.php
Paramètre
Valeur
DB_NAME
wp_lab
DB_USER
wp_user
DB_PASSWORD
<mot-de-passe-wp_user>(Bitwarden)
DB_HOST
10.0.20.10
DB_HOST est la ligne qui matérialise toute l’architecture. Dans une installation LAMP
classique elle vaut localhost : web et base sur la même machine. Ici elle désigne une
machine d’un autre VLAN — chaque requête de WordPress traverse pfSense. C’est cette seule
ligne qui transforme un WordPress banal en démonstration de segmentation réseau.
Clés de sécurité(salts) :
curl -s https://api.wordpress.org/secret-key/1.1/salt/ | sudo tee /tmp/salts.txt > /dev/null
sudo sed -i '/put your unique phrase here/d' wp-config.php
sudo sed -i '/^\$table_prefix/r /tmp/salts.txt' wp-config.php && sudo rm /tmp/salts.txt
sudo chown www-data:www-data wp-config.php && sudo chmod 640 wp-config.php
WordPress ne stocke pas le mot de passe dans le cookie de session : il y place une signature
cryptographique calculée à partir de huit chaînes secrètes. Les valeurs par défaut du fichier
d’exemple étant publiques, n’importe qui pourrait forger un cookie valide sans les remplacer.
Effet de bord utile : changer les salts invalide toutes les sessions en cours.
C’est la façon canonique de déconnecter tout le monde après une compromission.
chmod 640 : le fichier contient le mot de passe de la base en clair. ipfixe ne
peut pas le lire sans sudo — vérifié : grep renvoie « Permission non accordée ».
C’est aussi la raison d’être de la restriction @'10.0.10.10' sur le compte.
Le passage de setup-config.php à install.php est la preuve que WordPress a joint
la base à travers le pare-feu. S’il n’y parvenait pas, il afficherait « Erreur lors de la
connexion à la base de données » au lieu de proposer l’installation.
25.6 — Installation depuis poste-win11 (VLAN 40)
L’assistant est lancé depuis le poste Windows, à l’adresse http://10.0.10.10, afin de
valider simultanément le flux USERS → WEB.
Champ
Valeur
Titre du site
Lab SISR — Axel GOUIRAND
Identifiant
≠ admin — premier identifiant testé par les robots
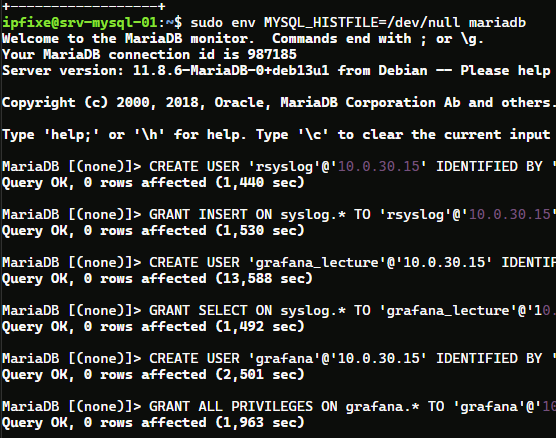
Trois VLAN, deux règles de pare-feu distinctes, trois verrous sur la base. Aucun de ces
sauts n’est possible sans une autorisation explicitement écrite et justifiée.
Validation finale, depuis srv-mysql :
sudo mariadb -e "SHOW TABLES FROM wp_lab;"
Une douzaine de tables wp_* créées à distance, depuis l’autre VLAN, par le compte
wp_user — preuve que ses privilèges CREATE s’appliquent, et uniquement sur wp_lab.
25.8 — Le test miroir : prouver que ce qui doit être bloqué l’est (test 7.3)
Démontrer que le flux autorisé passe ne suffit pas. Il faut démontrer que tout le reste est
refusé, et le prouver par un journal — un pare-feu qui bloque sans le tracer ne démontre rien.
Ces deux dernières lignes ensemble constituent la preuve. Même machine, même destination,
deux protocoles, deux résultats opposés :
Hypothèse alternative
Écartée par
« la machine est éteinte »
elle répond au ping
« le routage inter-VLAN ne fonctionne pas »
aller-retour VLAN 40 ↔ VLAN 20 en 0 ms
« c’est un problème réseau »
le réseau fonctionne parfaitement
Il ne reste qu’une explication : un filtrage volontaire, sur ce protocole et ce port précis.
La trace côté pfSense
Status → System Logs → Firewall → Advanced Log Filter
— Source IP10.0.40.100, Destination IP10.0.20.10
Interface
Rule
Source
Destination
Protocol
USERS
Refus de tout autre flux interne (1789628871)
10.0.40.100:49729
10.0.20.10:3306
TCP:S
La description saisie à la création de la règle apparaît telle quelle dans le journal.
C’est le retour sur investissement des descriptions rédigées une par une : un journal
lisible par un tiers, là où @4:6 n’aurait rien signifié. Le nombre entre parenthèses est
le Rule Tracker ID, utilisable comme critère de filtre.
TCP:S = drapeau SYN seul. Aucun paquet autre qu’un SYN n’apparaît : la poignée de
main TCP n’a jamais dépassé sa première étape. Ni session, ni octet de donnée.
Les ports source 49729 puis 49849 correspondent à deux exécutions successives de
la commande. Ils tombent tous deux dans la plage éphémère 49152-65535 — démonstration
concrète de la raison pour laquelle on ne filtre jamais sur le port source (§4, matrice
de flux) : il change à chaque connexion.
Même destination, même port, deux sources différentes, deux résultats opposés. C’est le
moindre privilège en action : la règle 3 de l’onglet WEB vise SRV_WEB en hôte à hôte, et
non le réseau entier.
Phase 10 — Haute disponibilité
Passage d’une architecture mono-serveur à une architecture redondée : cluster Galera à
3 nœuds pour la base, répartiteur HAProxy devant deux serveurs web.
La distinction à poser d’emblée : HAProxy est une machine, Galera n’en est pas une.
   HAProxy INTERCEPTE le trafic          Galera COORDONNE des serveurs
   ────────────────────────────          ────────────────────────────
   client ─► srv-ha ─► srv-web-01        srv-mysql-01 ◄══╗
                   └─► srv-web-02        srv-mysql-02 ◄══╬══ pair-à-pair
                                         srv-mysql-03 ◄══╝
   il est SUR le chemin                  rien ne s'intercale
   → il lui faut sa propre VM            → AUCUNE VM supplémentaire
Galera est la bibliothèque /usr/lib/galera/libgalera_smm.so, livrée avec mariadb-server et
déjà présente depuis l’étape 24.3 — on l’a vue défiler dans la sortie d’apt
(Paramétrage de galera-4). On ne l’installe pas : on l’active par configuration.
Étape 26 — Renommage srv-web-01 et srv-mysql-01
Préalable à tout le reste : une numérotation homogène entre les membres d’un même cluster.
Pourquoi réécrire la ligne entière au lieu de s/ancien/nouveau/g. Un remplacement de
srv-web par srv-web-01 est dangereux rejoué : la seconde exécution produirait
srv-web-01-01. En ancrant sur l’adresse IP (^10.0.10.10) et en réécrivant toute la ligne,
la commande devient idempotente.
Validation : hostname renvoie le nouveau nom, et /etc/hosts contient
10.0.10.10 srv-web-01.sio.internal srv-web-01.
L’avertissement sudo: impossible de résoudre l'hôte est attendu : sudo lit le nom de la
machine au lancement, donc avant que sed n’ait modifié le fichier.
Répercussion : les 7 livrables, les alias pfSense, les hôtes Termix.
Étape 27 — Clonage Proxmox et régénération des identités
Le principe central : un clone n’est pas une nouvelle machine tant qu’on n’a pas régénéré ce
qui doit être unique.
27.1 — Préparation
Shutdown de srv-mysql-01 — jamais Stop. L’agent QEMU permet l’extinction propre :
MariaDB ferme ses fichiers. Un clone pris pendant une écriture donne une image incohérente,
qu’on dupliquerait ensuite deux fois.
Clic droit → Clone → Full Clone.
Le sélecteur Mode n’apparaît pas lorsque la source est une VM ordinaire : Proxmox
n’autorise le Linked Clone que depuis un template. La copie est donc forcément complète.
Et c’est heureux. Un linked clone n’enregistre que les différences par rapport au
disque parent, dont il reste dépendant à vie. Pour un cluster ce serait un contresens :
trois nœuds sur un même disque parent, c’est un seul point de panne déguisé en trois.
27.2 — Déconnecter la carte réseau avant le premier démarrage
Le clone a hérité de 10.0.20.10. Le démarrer tel quel provoquerait un conflit d’adresses
avec la machine d’origine — deux hôtes répondant à la même adresse, et des symptômes
incompréhensibles sur tout le VLAN.
On corrige l’adresse par la console Proxmox, réseau coupé, puis on rebranche :
sudo sed -i 's/10\.0\.20\.10/10.0.20.11/' /etc/network/interfaces
Le motif 10\.0\.20\.10 exige un 0 final : la passerelle 10.0.20.1 n’est pas touchée.
Les points sont échappés pour désigner des points littéraux.
Les DEUX fichiers, pas seulement /etc/machine-id.systemd-machine-id-setup cherche
une source dans l’ordre : /etc/machine-id → /var/lib/dbus/machine-id → UUID SMBIOS →
aléatoire. En n’effaçant que le premier, il recopie celui du clone et les deux machines
restent jumelles. Le message affiché est la seule alerte :
Effet de bord à connaître : après ce changement, journalctl répond
« No journal files were found ». Le démon écrit dans un répertoire nommé d’après l’ancien
identifiant, alors que journalctl cherche avec le nouveau. Correction :
sudo systemctl restart systemd-journald.
Validation — depuis le bastion, les trois identifiants doivent différer :
for h in 10.0.20.10 10.0.20.11 10.0.20.12;doecho -n "$h : "; ssh ipfixe@$h cat /etc/machine-id;done
Les trois empreintes ED25519 affichées à la connexion doivent différer également — ce qui valide
du même coup la régénération des clés d’hôte.
27.4 — Vider le répertoire de données des futurs nœuds Galera
Pourquoi effacer des données qu’on vient de copier ? Le clone contient une copie
figée de wp_lab. S’il rejoignait le cluster avec ses propres données, Galera verrait deux
historiques divergents. Un répertoire vide l’oblige à demander un SST — une copie
intégrale et cohérente, prise à l’instant de la jonction.
disable empêche MariaDB de tenter un démarrage au prochain boot sur un répertoire
vide. On réactivera après la jonction réussie.
Dette héritée : srv-web-02, clone de srv-web-01, hérite de son environnement de
bureau — dette H-3.
Étape 28 — Le cluster Galera à 3 nœuds
28.1 — Préalables
Rouvrir temporairement la règle 4 de l’onglet BDD (dette T-3), le temps des installations,
puis la refermer.
sudo apt install -y mariadb-backup curl
Sur les trois nœuds : chacun peut devenir donneur ou receveur.
Méthode SST
Fonctionnement
Le donneur pendant ce temps
rsync
copie brute des fichiers
bloqué en lecture seule
mariabackup
sauvegarde à chaud, cohérente
continue de servir
Compte de synchronisation, sur srv-mysql-01 uniquement — les autres le recevront par SST :
sudo mariadb -e "CREATE USER 'sst_user'@'localhost' IDENTIFIED BY '<mot-de-passe-sst_user>'; GRANT RELOAD, PROCESS, LOCK TABLES, BINLOG MONITOR ON *.* TO 'sst_user'@'localhost';"
Privilège
Ce qu’il autorise
RELOAD
poser un verrou global cohérent le temps du cliché
PROCESS
lire la liste des transactions en cours
LOCK TABLES
verrouiller les tables non transactionnelles
BINLOG MONITOR
lire la position du journal binaire — le point de reprise
BINLOG MONITOR s’appelait REPLICATION CLIENT avant MariaDB 10.5 ; l’ancien nom reste
accepté comme alias.
Surtout pas GRANT ALL, que donnent la moitié des tutoriels. Même raisonnement que
wp_user limité à wp_lab.* : un compte de service n’a que les privilèges de son service.
28.2 — 60-galera.cnf, une commande pour les trois nœuds
Le <<EOF sans guillemets autorise le shell à évaluer les $( ) avant d’écrire : chaque
nœud y inscrit sa propre adresse et son nom. Une seule commande pour trois machines, zéro
risque de recopier la mauvaise valeur.
(À l’inverse, le <<'EOF' du VirtualHost Apache — étape 25.4 — protégeait ${APACHE_LOG_DIR}
de toute substitution.)
Les trois directives que l’on oublie toujours :
Directive
Pourquoi elle est obligatoire
binlog_format = ROW
Galera réplique les lignes modifiées, pas les requêtes. Un UPDATE … WHERE id = RAND() donnerait un résultat différent sur chaque nœud.
default_storage_engine = InnoDB
Galera ne réplique que l’InnoDB, transactionnel. Une table MyISAM ne serait pas répliquée, silencieusement.
innodb_autoinc_lock_mode = 2
Sans cela, deux nœuds insérant simultanément attribueraient le même identifiant auto-incrémenté. Le mode 2 décale les plages par nœud.
bind-address = 0.0.0.0 — renoncement assumé, à ne pas masquer. L’étape 24.5 avait posé
bind-address = 10.0.20.10 comme premier verrou. Galera impose de l’élargir : le processus
doit écouter sur plusieurs ports pour la réplication.
Ce n’est pas un recul, pour deux raisons : le verrou 2 reste entier — la règle
SRV_HA → GALERA_NODES : 3306 est la seule porte depuis l’extérieur du VLAN 20 — et le
verrou 3 aussi, le GRANT restreint par adresse d’origine.
Effet de bord bienvenu : les clones avaient hérité de bind-address = 10.0.20.10, une
adresse qu’ils ne portent pas — MariaDB aurait refusé de démarrer avec
Can't assign requested address. 60-galera.cnf étant lu après50-server.cnf (ordre
alphabétique), sa valeur écrase la précédente et corrige le problème au passage.
28.3 — Amorçage — l’ordre est impératif
# sur srv-mysql-01 UNIQUEMENTsudo systemctl stop mariadb
sudo galera_new_cluster
# puis sur srv-mysql-02, attendre « Synced », ENSUITE srv-mysql-03sudo systemctl start mariadb
sudo systemctl enable mariadb
galera_new_cluster ne se lance qu’une fois, et sur un seul nœud. Elle démarre MariaDB
avec --wsrep-new-cluster, ce qui signifie : « je ne cherche personne, le cluster commence
avec moi, mes données font référence ».
   galera_new_cluster  →  « je suis la semence »     → CRÉE le cluster
   systemctl start     →  « je cherche un cluster »  → le REJOINT
L’exécuter sur deux nœuds produirait deux clusters distincts portant le même nom, chacun
convaincu d’être le vrai : c’est le split-brain, irréparable sans sacrifier des données.
C’est srv-mysql-01, et lui seul, parce qu’il détient WordPress.
Un nœud à la fois. Deux SST simultanés font travailler le donneur deux fois, sans gain.
enable à ne pas oublier sur les nœuds 2 et 3 : on les avait désactivés à l’étape 27.4.
Sans cela, un redémarrage de VM les sortirait du cluster sans prévenir.
28.4 — Validation
sudo mariadb -e "SHOW STATUS WHERE Variable_name IN ('wsrep_cluster_size','wsrep_cluster_status','wsrep_local_state_comment','wsrep_incoming_addresses');"
nombre de membres vus par ce nœud — les trois doivent dire 3
wsrep_cluster_status
Primary = cette partition détient le quorum, elle a le droit d’écrire
wsrep_local_state_comment
Synced = ce nœud est à jour et opérationnel
wsrep_incoming_addresses
la liste des membres, vue par ce nœud
Primary ne signifie pas « nœud principal ». C’est l’état de la partition. On
retrouvera ce mot au test 7.11, où il basculera en non-Primary avec deux nœuds arrêtés.
28.5 — Le vocabulaire à maîtriser
Terme
Définition
Réplication synchrone
la transaction n’est validée qu’après acceptation par tous les nœuds — contrairement à l’asynchrone, où le maître valide seul et les esclaves rattrapent
Certification
le contrôle, avant validation, qu’aucune transaction concurrente ne modifie les mêmes lignes ailleurs
Quorum
la majorité des membres. Trois nœuds survivent à la perte d’un ; deux nœuds ne survivraient à rien — d’où le nombre impair
SST(State Snapshot Transfer)
copie complète — pour un nœud au répertoire vide. Port 4444
IST(Incremental State Transfer)
rattrapage des seules transactions manquées — pour un nœud brièvement absent. Port 4568
gcomm
le protocole de communication du groupe. Port 4567
Pourquoi trois nœuds et non deux. Avec deux nœuds, la perte de l’un laisse le survivant
avec 50 % des voix — pas la majorité. Il passerait en non-Primary et refuserait d’écrire.
Deux nœuds n’apportent donc aucune disponibilité supplémentaire, seulement une copie des
données. Le premier nombre utile est trois.
Clone de srv-web-01, adressé en 10.0.10.11. Procédure identique à l’étape 27, à une
différence majeure près : ici on n’efface rien.
   Nœuds Galera  →  /var/lib/mysql VIDÉ    (forcer un SST cohérent)
   Serveur web   →  on garde TOUT          (fichiers, wp-config.php, salts)
Les salts identiques sont indispensables. Ils signent les cookies de session. Avec des
salts différents, un visiteur connecté sur un nœud serait vu déconnecté dès que le
répartiteur l’enverrait sur l’autre. Le clonage garantit cette identité gratuitement —
deuxième raison de cloner plutôt que réinstaller.
srv-web-01 utilise NetworkManager, pas ifupdown — conséquence de son environnement
de bureau (dette H-3). L’adresse se change par nmcli, pas par /etc/network/interfaces.
Incident H-12.
Une démonstration involontaire du verrou n°3
Au premier démarrage, srv-web-02 affiche « Error establishing a database connection »
alors que srv-web-01 sert le site au même instant. 39-srv-web-02-grant-refuse.png
   GRANT ALL PRIVILEGES ON wp_lab.* TO 'wp_user'@'10.0.10.10'
                                                    ▲▲▲▲▲▲▲▲▲▲▲
                                        le clone arrive en 10.0.10.11
Une machine clonée à l’identique — mêmes fichiers, même mot de passe — est refusée
uniquement parce que son adresse a changé. C’est la valeur concrète de la restriction
d’origine posée à l’étape 24.6. Avec un 'wp_user'@'%', le clone aurait fonctionné du premier
coup… et n’importe quelle machine du lab aurait pu joindre la base.
Un contrôle de sécurité qui te gêne toi est un contrôle qui gênerait aussi un attaquant.
Validation : compte temporaire créé pour 10.0.10.11, puis constaté répliqué sur le
nœud 3 sans intervention — Galera réplique aussi les tables système.
Étape 30 — srv-ha et HAProxy
VM dédiée 10.0.10.5, Debian 13 sans bureau, HAProxy 3.0.11.
Élément
Choix
Frontend
:80 redirigé vers :443 · terminaison TLS, certificat auto-signé avec SAN
ACL
/wp-admin et /wp-login.php → srv-web-01seul · le reste en roundrobin
Backend base
mode tcp · nœud 1 actif, nœuds 2 et 3 en backup · timeouts 1 h
Statistiques
:8404, jointes par Tailscale
Nouvelle règle de pare-feu — SRV_HA → GALERA_NODES : 3306, placée avant le Reject
de l’onglet WEB. 42-regle-web-srv-ha-galera.png
Avant cette règle, les trois nœuds apparaissaient DOWN avec L4CON in 0ms.L4CON = échec au niveau transport ; 0ms = refus immédiat, donc un Reject renvoyant
un TCP RST — et non un Block silencieux, qui aurait produit un délai d’attente.
41-haproxy-galera-down.png puis 43-haproxy-stats-tout-vert.png — la même page, une
règle d’écart.
Mis à jour le 05/11 : le contrôle mysql-check du bloc listen galera est remplacé par une sonde de
synchronisation sur le port 9200 (tâche 10.23) : voir l’étape 62.
Étape 31 — Bascule de WordPress derrière le répartiteur
Modification
Valeur
Pourquoi
DB_HOST
10.0.10.5
la base est jointe via le répartiteur — bascule transparente
WP_HOME / WP_SITEURL
https://www.sio.internal
définis dans le fichier, donc modifiables même site cassé
Détection X-Forwarded-Proto
bloc PHP avant wp-settings.php
sans elle : boucle de redirection infinie
Host Override pfSense
www.sio.internal → 10.0.10.5
donne son sens au certificat
Règle USERS n°5
destination SRV_WEB → SRV_HA
les clients ne joignent plus les serveurs web directement
L’oubli de la règle USERS a produit un ERR_CONNECTION_REFUSED depuis poste-win11,
alors que le DNS résolvait correctement. 44-users-vers-srv-ha-refuse.png
Le message du navigateur indique la couche en échec : ERR_NAME_NOT_RESOLVED aurait désigné
le DNS, ERR_CONNECTION_REFUSED désigne le filtrage.
Validation : HTTP/2 200 avec l’en-tête link: <https://www.sio.internal/wp-json/> —
trois preuves en une réponse (pas de boucle, WP_SITEURL appliqué, chaîne complète fonctionnelle).
Nettoyage — troisième temps de la migration : suppression des comptes [email protected]
et @10.0.10.11, puis désactivation de l’ancienne règle WEB n°3.
Le bilan de la phase 10 sur la surface d’accès à la base :
Avant
Après
Machines autorisées à joindre la base
1
1
Machines ayant besoin d’y accéder
1
2
Machines déployées
5
9
L’infrastructure a presque doublé, les autorisations n’ont pas bougé.
Étape 32 — lsyncd et le confinement par clé
Synchronisation à sens unique de wp-content, de srv-web-01 vers srv-web-02.
La clé SSH de root est enfermée dans une seule commande :
PTY allocation request failed + rrsync error: Not invoked via sshd
Écrire dans wp-content
autorisé
Écrire dans /etc
remappé dans wp-content/etc
Remonter avec ..
do not use .. in arg
Une clé root qui ne donne aucun accès root. Le privilège appartient à la commande
forcée, pas au compte. Motif réutilisable pour toute automatisation : sauvegardes,
supervision, déploiements.
rrsync confine par remappage, pas par refus — quel que soit le chemin demandé, il
est préfixé par le répertoire autorisé. Plus robuste qu’une logique de refus, qui devrait
anticiper toutes les formes d’échappement.
Deux pièges rencontrés : www-data a pour interpréteur /usr/sbin/nologin et ne peut
donc pas servir de compte SSH ; et lsyncd ajoute par défaut l’option --protect-args
(-s), que rrsyncrefuse — elle déplacerait les chemins hors de la ligne de commande et
le rendrait aveugle. Correction : protect_args = false.
Étape 33 — AD-Core-01 : contrôleur de domaine sio.internal
Objectif : disposer d’un annuaire centralisé — un compte par personne, créé à un seul
endroit et valable sur toutes les machines du laboratoire.
A — Pourquoi Server Core, et pourquoi une seule fois
L’installation retenue est Server Core : pas d’interface graphique, administration en
ligne de commande et à distance.
Le mode d’installation est définitif. Depuis Windows Server 2016, on ne convertit plus
une installation Core en installation avec interface graphique, ni l’inverse. La VM
AD-GUI qui existait auparavant a donc été supprimée, et son adresse 10.0.30.10
réattribuée à la nouvelle machine.
B — Préparer avant de promouvoir
Quatre éléments devaient être figés avant la promotion, parce qu’ils sont inscrits dans
l’annuaire au moment où il se crée :
Élément
Valeur
Pourquoi avant
Nom de la machine
AD-Core-01
Devient le nom du contrôleur dans l’annuaire
Adresse
10.0.30.10/24, manuelle
Un contrôleur de domaine ne prend pas son adresse en DHCP
Passerelle et résolveur
10.0.30.1
—
Source de temps
10.0.30.1,0x8
Kerberos refuse toute authentification au-delà de 5 minutes d’écart
La promotion exige d’être connecté en tant qu’Administrateur local de la machine.
C’est une exigence documentée par Microsoft, pas une recommandation : un autre compte
d’administration, même membre du groupe des administrateurs locaux, ne suffit pas pour
créer une nouvelle forêt.
-IncludeManagementTools n’est pas facultatif. Sans lui, le rôle s’installe mais les
commandes qui le pilotent — Install-ADDSForest, Get-ADDomain — n’existent pas. Sur Core,
aucune console graphique ne vient compenser.
Un instantané Proxmox a été pris avant la promotion : c’est la seule opération de la
séquence qui transforme la machine.
Le nom court, hérité des anciens protocoles — 15 caractères, sans point
-InstallDns:$true
Installe le serveur DNS et crée la zone (déjà le comportement par défaut ; écrit pour l’expliciter)
Le mot de passe de restauration (DSRM) n’est pas le mot de passe administrateur. Il
permet de démarrer le contrôleur en mode réparation quand l’annuaire lui-même est hors
d’usage — donc le jour où les comptes du domaine, qui vivent dans l’annuaire, sont
inutilisables. Il est demandé de façon masquée, et se note ailleurs que sur cette
machine.
L’avertissement sur la délégation DNS est normal et ne se corrige pas. Le suffixe
.internal n’existe pas sur Internet : il n’y a aucune zone parente à qui déléguer.
Niveaux fonctionnels : non précisés, donc laissés par défaut — ce qui donne ici
Windows2025Domain et Windows2025Forest, les plus élevés disponibles.
Conséquence à connaître : un second contrôleur devra être un Windows Server 2025.
Une version antérieure serait refusée. Élever un niveau fonctionnel est irréversible ; ici
la valeur par défaut est déjà le maximum, ce qui ferme la porte aux contrôleurs plus
anciens.
D — Le DNS
Après promotion, le contrôleur s’interroge lui-même — la promotion bascule le résolveur
sur 127.0.0.1 sans intervention. Il fait autorité sur sio.internal ; pour tout le reste,
il transmet la question :
Dette T-11 — la sortie affiche UseRootHint : True : si le résolveur de pfSense ne
répond pas, le contrôleur interroge directement les serveurs racine d’Internet, ce que la
règle 6 de l’onglet ADM lui permet effectivement. Conservé délibérément : le pare-feu
reste le point de passage unique, seul le résolveur cesse de l’être, et uniquement en mode
dégradé. Voir §5.1 et MO-6 §8.3.
E — L’autorité de temps
AD-Core-01 détient le rôle PDC Emulator : dans un domaine, ce rôle est l’horloge de
référence sur laquelle tous les membres s’alignent.
w32tm/config/reliable:yes/update
La panne que ce réglage évite est la plus déroutante d’un domaine. Un poste dont
l’horloge a dérivé de plus de cinq minutes ne peut plus s’authentifier — et le message parle
de mot de passe incorrect, de ticket invalide, de relation d’approbation rompue. Jamais de
l’heure.
F — La relation d’approbation, et le piège des instantanés
Le mot désigne deux choses différentes, et la confusion coûte du temps :
Entre quoi
Existe ici ?
Le canal sécurisé
Un poste et son domaine
Un par machine jointe
L’approbation de domaine
Deux domaines ou deux forêts
Un seul domaine : aucune
Le message « La relation d’approbation entre cette station de travail et le domaine principal
a échoué » désigne toujours le premier. Quand un poste rejoint le domaine, il y reçoit un
compte d’ordinateur (POSTE-WIN11$) doté d’un mot de passe que les deux côtés conservent, et
qui se renouvelle seul tous les 30 jours. La relation d’approbation, c’est la concordance
de ces deux copies — rien de plus.
Ce qui la casse ici en priorité : la restauration d’un instantané Proxmox. Une VM
jointe au domaine, restaurée à un état antérieur au dernier changement de mot de passe de
machine, revient avec un secret périmé. Ce n’est pas une raison de renoncer aux instantanés
— c’est une raison de savoir que, après une restauration, c’est la première panne à
suspecter.
Ne pas sortir le poste du domaine pour le rejoindre ensuite. C’est le réflexe
répandu, et il est destructeur : l’objet ordinateur est supprimé puis recréé, avec ses
appartenances à des groupes et ses stratégies ciblées. -Repair remet les deux secrets
d’accord en quelques secondes, sans redémarrage.
Windows2025Forest · catalogue global AD-Core-01.sio.internal
Services
NTDS, DNS, Netlogon, kdc — tous Running / Automatic
Partages
SYSVOL et NETLOGON présents, chemins conformes
Résolution interne
AD-Core-01.sio.internal → 10.0.30.10
Résolution externe
microsoft.com → 150.171.109.106(via le redirecteur)
Temps
source 10.0.30.1,0x8, dernière synchronisation réussie
dcdiag /q signale un échec du test DFSREvent, et c’est normal ici. Ce test lit le
journal de réplication DFS sur 24 heures — fenêtre qui englobe la promotion. L’avertissement
6016 (« configuration non mise à jour dans AD ») a été émis à 10:30:21, pendant que
l’annuaire démarrait ; 4602 confirme SYSVOL initialisé six secondes plus tard, et 6018
à 10:35:25 montre que le service a refait l’opération avec succès.
La méthode à retenir : devant une erreur dans un journal, chercher d’abord s’il existe
un événement postérieur qui l’annule. Beaucoup d’avertissements de démarrage sont des
tentatives qui finissent par aboutir.
Un point à surveiller : la zone contient aussi une adresse IPv6 lien-local
(fe80::…) pour le contrôleur. Un client qui la reçoit en premier peut tenter de la
joindre, échouer, puis basculer sur IPv4 — ce qui se traduit par des ouvertures de session
lentes, sans message d’erreur. Première piste si la jonction d’un poste traîne.
Procédure réutilisable complète :
MO-6-Windows-Server-Core.md — §6 la forêt,
§8 le DNS, §11 la relation d’approbation
Étape 34 — Jonction de poste-win11 au domaine
Objectif : qu’un compte de l’annuaire ouvre une session sur le poste utilisateur, sans
avoir jamais été créé localement.
A — L’ordre, et pourquoi il n’est pas interchangeable
   1. RENOMMER le poste            il s'appelait encore 26-09-MDS-01
   2. Basculer le DNS du VLAN 40   le poste doit pouvoir TROUVER le domaine
   3. Joindre
   4. Verifier des DEUX cotes
Renommer avant de joindre. Le nom du poste au moment de la jonction devient le nom de
l’objet ordinateur dans l’annuaire. Le renommer ensuite impose de reprendre cet objet, ou
laisse un orphelin portant l’ancien nom.
Rename-Computer-NewName"poste-win11"-Restart
Basculer le DNS avant de joindre, et non l’inverse. Un poste ne trouve pas un domaine
par une adresse : il interroge le DNS. Avec 10.0.40.1 comme résolveur, il demanderait à
pfSense, qui ne connaît pas sio.internal — la jonction échouerait sur un message ne
mentionnant jamais le DNS.
B — Le DNS distribué au VLAN 40
Services → DHCP Server → onglet USERS → Servers
Champ
Avant
Après
DNS Servers
10.0.40.1
10.0.30.10 — seul
Ne pas conserver 10.0.40.1 en résolveur secondaire. C’est le réflexe naturel et c’est
un piège : un membre du domaine qui dispose d’un second résolveur ignorant le domaine y
basculera au moindre délai de réponse du premier, recevra NXDOMAIN sur un enregistrement de
service, et conclura que le domaine n’existe pas. Les échecs deviennent intermittents,
donc très difficiles à reproduire.
La résilience ne vient pas d’un second résolveur étranger au domaine, mais d’un second
contrôleur — c’est l’objet de la dette T-8 et de AD-Core-02.
_ldap._tcp.dc._msdcs.sio.internal   SRV   ad-core-01.sio.internal   Priority 0  Weight 100  Port 389
ad-core-01.sio.internal              A     10.0.30.10               Section: Additional
Élément
Lecture
_ldap._tcp · dc._msdcs
Le service recherché, parmi les contrôleurs de domaine
NameTarget · Port 389
Qui répond et sur quel port — le poste n’a rien à deviner
Priority · Weight
De quoi répartir entre plusieurs contrôleurs ; sans objet avec un seul
Section: Additional
L’adresse est jointe à la même réponse, sans seconde requête
C’est littéralement ainsi qu’un poste trouve un domaine. Tout Active Directory repose
sur ces enregistrements de service — d’où le fait qu’une panne de domaine soit presque
toujours une panne de résolution de noms.
D — Joindre
$c=New-ObjectSystem.Management.Automation.PSCredential("SIO\Administrateur",(Read-Host"Mot de passe"-AsSecureString))Add-Computer-DomainName"sio.internal"-Credential$c-VerboseRestart-Computer-Force
Get-Credential ne fonctionne pas en session SSH : il ouvre une fenêtre graphique,
qu’aucun bureau n’affiche. Read-Host -AsSecureString fait la même chose en console, avec une
saisie masquée.
-Restart séparé de la jonction, volontairement. Tant que la jonction n’est pas
confirmée, on ne redémarre pas : un redémarrage effacerait le message d’erreur. On sépare
l’opération de sa conséquence.
-Force sur le redémarrage parce qu’une autre session était ouverte (la console de
l’hyperviseur). À peser sur un serveur en production : la commande coupe le travail des
utilisateurs connectés sans préavis.
E — Vérifier des deux côtés
Une seule vérification ne suffit pas. La relation d’approbation a deux moitiés : le
poste peut se croire membre alors que l’objet a disparu de l’annuaire. C’est exactement la
panne décrite au §F de l’étape 33.
True — la relation d’approbation est fonctionnelle
NetworkCategory
DomainAuthenticated — Windows a authentifié le contrôleur et a basculé seul sur le profil Domaine
Objet dans l’annuaire
POSTE-WIN11 · poste-win11.sio.internal · créé le 03/10/2026 17:46:13 · activé
Session SSH
ouverte sous SIO\Administrateur, profil C:\Users\administrateur créé à la volée
La preuve la plus parlante est la dernière ligne. Ce compte n’a jamais été créé sur
poste-win11. Il vient de l’annuaire, et il y ouvre une session comme il en ouvre une sur le
contrôleur. C’est l’objectif de l’étape, démontré : un compte par personne, créé à un seul
endroit, valable partout.
Trois pertes d’accès SSH ont jalonné cette étape, pour trois causes différentes — une
commande coupant sa propre session, un profil réseau basculé en Public, et une règle de
pare-feu liée à un seul profil. Le détail et les enseignements sont dans l’incident
H-15.
Procédure réutilisable complète :
MO-6-Windows-Server-Core.md — §10 la
jonction, §11 la relation d’approbation
Étape 35 — L’arborescence de l’annuaire
Objectif : ranger l’annuaire avant d’y créer quoi que ce soit, parce que l’emplacement
d’un objet décide des stratégies qu’il recevra.
CN=Users et CN=Computers ne sont pas des unités d’organisation. Ce sont des
conteneurs : aucune stratégie de groupe ne peut s’y lier. Un compte laissé là ne reçoit
jamais que la stratégie du domaine entier.
Pourquoi une racine OU=SIO. La racine du domaine contient OU=Domain Controllers, où
vit AD-Core-01. Une stratégie posée à la racine retomberait aussi sur le contrôleur. Avec
une racine d’organisation distincte, on vise toute l’entreprise sans jamais toucher à
l’annuaire lui-même.
Un DistinguishedName se lit de droite à gauche : OU=Direction,OU=Utilisateurs,OU=SIO,DC=sio,DC=internal
va du plus précis au plus général. Un chemin écrit à l’envers donne « objet introuvable »,
sans jamais dire que l’ordre est faux.
Validation : les sept unités sont créées (SIO, Utilisateurs, Direction, Administratif,
Technique, Ordinateurs, Groupes).
Étape 36 — Rediriger les emplacements par défaut, et ranger le poste
Un compte créé sans -Path va dans OU=Utilisateurs au lieu de CN=Users
redircmp
Une machine qui rejoint le domaine va dans OU=Ordinateurs au lieu de CN=Computers
redircmp corrige une limite réelle d’Active Directory : au moment de la jonction, un
poste ne peut pas indiquer où il veut atterrir. Sans cette redirection, chaque poste joint
doit être déplacé à la main, et celui qu’on oublie ne reçoit aucune stratégie machine,
sans qu’aucun message ne le signale.
POSTE-WIN11 avait été joint avant la redirection : il était dans CN=Computers. Le
déplacement le range, en conservant son SID et sa relation d’approbation.
Six comptes, deux par service : de quoi démontrer un groupe et une stratégie ciblée.
$mdp=Read-Host"Mot de passe initial"-AsSecureString$users=@(@{P="Axel";N="Gouirand";I="a.gouirand";S="Technique"},@{P="Marie";N="Durand";I="m.durand";S="Technique"},@{P="Claire";N="Moreau";I="c.moreau";S="Direction"},@{P="Julien";N="Petit";I="j.petit";S="Direction"},@{P="Sophie";N="Lefevre";I="s.lefevre";S="Administratif"},@{P="Thomas";N="Bernard";I="t.bernard";S="Administratif"})foreach($uin$users){$p=@{Name="$($u.P)$($u.N)"GivenName=$u.PSurname=$u.NDisplayName="$($u.P)$($u.N)"SamAccountName=$u.IUserPrincipalName="$($u.I)@sio.internal"Path="OU=$($u.S),OU=Utilisateurs,OU=SIO,$racine"AccountPassword=$mdpEnabled=$trueChangePasswordAtLogon=$true}New-ADUser@pWrite-Host"cree : $($u.I) -> $($u.S)"}
Paramètre
Pourquoi il compte
Path
Construit depuis la colonne Service : ajouter un service = créer l’unité et écrire son nom
AccountPassword
Saisi masqué, jamais dans la ligne de commande donc jamais dans l’historique
ChangePasswordAtLogon
Chaque utilisateur choisit son mot de passe : l’administrateur ne le connaît pas, ce qui rétablit l’imputabilité
Trois pièges rencontrés pendant cette étape.
Piège
Ce qui s’est passé
Parade
Collage tronqué
La commande New-ADUser sur une seule ligne a été coupée par le terminal : -Path et la suite ont disparu, Write-Host s’est retrouvé collé derrière, d’où « paramètre positionnel introuvable ». Les six appels ont échoué, rien n’a été créé
Le splatting ci-dessus : une table de hachage, un paramètre par ligne, passée avec @p
Bloc en attente
Les >> en début de ligne signalent un bloc multiligne non terminé : PowerShell n’exécute que sur une ligne vide
Appuyer sur Entrée une fois de plus
Variables perdues
Une nouvelle session SSH a effacé $users, $mdp et $racine : la boucle s’est exécutée sur une variable vide, sans erreur ni création
Reposer les variables. Dès qu’une suite de commandes en dépend, en faire un fichier .ps1
Une boucle sur une variable vide ne signale rien : zéro itération, zéro message. Un
silence n’est pas un succès : il faut toujours contrôler le résultat.
Validation : les six comptes sont créés dans les trois unités de service (confirmé).
Étape 38 — Les groupes, selon la règle AGDLP
   A                    G                      DL                            P
   a.gouirand  ──►  GG-Technique  ──►  DL-Partage-Technique-Modifier  ──►  le dossier
   m.durand                                                                 (plus tard)
   QUI                 le rôle              la ressource + le niveau
Porte un droit sur une ressource, ici modifier le partage technique
-GroupCategory Security est obligatoire. Un groupe de distribution ne donne aucun
droit : on lui attribue des permissions et rien ne s’applique.
Pourquoi deux groupes au lieu d’un.Qui est dans une équipe change souvent ; quelles
ressources elle atteint change rarement. Avec cette chaîne, une arrivée se règle par un seul
Add-ADGroupMember dans GG-Technique, sans jamais rouvrir les permissions d’un dossier.
Un seul groupe DL- a été créé, celui qui démontre la chaîne : en créer six maintenant, c’est
six objets à maintenir pour rien.
Validation : la console Utilisateurs et ordinateurs Active Directory liste dans
OU=SIO → Groupes les quatre groupes de sécurité attendus.
Étape 39 — La console graphique sur poste-win11 (RSAT)
Objectif : retrouver la console classique pour explorer l’annuaire, alors que le
contrôleur est en Server Core et n’en a pas.
Les quatre tildes font partie du nom : Windows nomme ses composants
Nom~Éditeur~Architecture~Langue~Version, et les champs vides laissent les séparateurs.
Être administrateur local ne donne aucun droit dans l’annuaire.POSTE-WIN11\admin
suffit pour installer les outils, pas pour les utiliser : d’où runas avec
SIO\Administrateur. Ce sont deux autorités distinctes que la jonction ne mélange pas.
L’installation a d’abord semblé bloquée
La barre de progression est restée figée plus de 20 minutes. Le diagnostic a porté sur la
résolution de noms :
Le contraste entre les tests est ce qui a désigné la cause. Les deux serveurs DNS
répondaient quand on les interrogeait directement, mais le test passant par le résolveur du
système échouait : c’est le cache DNS du poste qui servait un échec mémorisé. Windows
met en cache les échecs, pas seulement les succès.
Piège de lecture : Resolve-DnsName … | select -First 2 n’affichait que les CNAME de la
chaîne, sans adresse. Une colonne IPAddress vide ne signifie pas un échec. Pour voir
l’adresse : | ? IPAddress | select Name, IPAddress.
La cause exacte de la lenteur de l’installation n’est pas établie. Le vidage du cache a
rétabli la résolution, l’installation a été relancée, puis s’est terminée. Rien ne prouve que
le cache en était la seule responsabilité.
Validation : la console s’ouvre sur poste-win11 et affiche sio.internal avec
l’arborescence SIO (Groupes, Ordinateurs, Utilisateurs).
Procédures réutilisables :
MO-9-Comptes-Active-Directory.md —
les unités, les comptes, les groupes et le quotidien d’un administrateur
Étape 40 — Un accès externe sans rien ouvrir côté lab (Pangolin)
Objectif : permettre à une personne extérieure (formateur, puis examinateurs) de voir le lab, sans
ouvrir le moindre port sur le réseau de l’école et sans donner l’accès à tout le réseau comme le fait le
tailnet (dette T-6).
Le principe : le lab ne reçoit rien, il sort. Un conteneur « connecteur » installé sur
srv-docker ouvre un tunnel WireGuard sortant (UDP 51820) vers un serveur Pangolin placé hors du
lab (sur l’hyperviseur personnel d’Axel, qui a une adresse publique). Les visiteurs arrivent sur ce
serveur, s’authentifient, puis sont acheminés à travers le tunnel vers une ressource précise.
Élément
Où
Détail
Serveur Pangolin
hors du lab
un conteneur sur l’hyperviseur personnel d’Axel ; reverse proxy Nginx Proxy Manager devant, avec une entrée et un certificat joker
Connecteur
srv-docker (10.0.30.12)
conteneur pangolin-site, secrets dans un fichier en droits 600
Flux
lab → serveur
UDP 51820 sortant ; aucun flux entrant
Ressource de test
Termix
http://10.0.30.12:443
Ressource de test
interface de pfSense
https://10.0.30.1:443 (étape 41)
Aucune règle de pare-feu n’a été ajoutée au lab. Le connecteur agit depuis srv-docker, déjà dans
l’onglet ADM : la règle n°1 de l’onglet (ADM subnets → ADM address : PORTS_ADMIN_FW) laisse passer le
flux vers l’interface d’administration, et la règle n°6 (ADM subnets → any) laisse sortir le tunnel.
Le tunnel hérite de ce que srv-docker atteint. Le connecteur se trouve dans le VLAN 30, donc
tout ce que ce VLAN peut joindre, le tunnel le peut. La parade n’est pas dans Pangolin mais dans le
pare-feu du lab : borner ce que srv-docker peut atteindre, et ne publier que des ressources ciblées.
Voir la dette T-12.
Validation :
docker logs pangolin-site affiche Tunnel connection to server established successfully!, sansPing attempt … failed ensuite ;
la liste d’états de pfSense (Diagnostics → States, filtrée sur l’adresse publique du serveur) montre
une ligne UDP vers le port 51820, côté ADM et côté WAN ;
dans une fenêtre de navigation privée, l’URL d’une ressource affiche l’écran d’authentification de
Pangolin, pas l’application.
56-pangolin-ressource-termix-saine.png · à déposer : 61-pangolin-tunnel-etabli.png, 62-pangolin-auth-navigation-privee.png
Étape 41 — Publier l’interface de pfSense : les noms alternatifs
Objectif : atteindre l’interface d’administration de pfSense par un nom de domaine
(pfsense.pangolin.<domaine>) à travers Pangolin, en plus de l’adresse IP.
Contexte : la cible de la ressource est https://10.0.30.1:443 (HTTP/2 200 constaté depuis
srv-docker ; le port 80 ne répond pas). pfSense a un certificat auto-signé.
Le problème rencontré : appelée par son nouveau nom, l’interface répond
Potential DNS Rebind attack detected, see https://en.wikipedia.org/wiki/DNS_rebinding
Try accessing the router by IP address instead of by hostname.
pfSense ne sert son interface qu’aux noms qu’il connaît (son nom d’hôte, ses adresses). Un nom inconnu est
traité comme une possible attaque par « DNS rebinding » : un site hostile qui ferait pointer son propre nom
vers l’adresse privée du pare-feu pour atteindre son interface depuis le navigateur d’un administrateur.
La modification de pfSense (il s’agit d’un changement de configuration du pare-feu) :
Où
Valeur
System → Advanced → onglet Admin Access
Champ Alternate Hostnames
pfsense.pangolin.<domaine>
Bouton
Save
Ne pas cocher « Disable DNS Rebinding Checks » : ce serait contourner la protection au lieu de
déclarer ce nom comme légitime.
Le nom alternatif dit à pfSense : « ce nom m’appartient », sans désactiver la vérification pour les
autres. C’est le même principe qu’un certificat qui énumère les noms qu’il couvre.
Validation :
https://pfsense.pangolin.<domaine> affiche l’écran de connexion de pfSense (et non le message
rouge). Aucune connexion n’est nécessaire pour le test.
En navigation privée, l’écran d’authentification de Pangolin s’affiche d’abord.
Non vérifié : le comportement de pfSense après connexion (vérification de l’en-tête Referer)
n’a pas été éprouvé : seul l’écran de connexion a été constaté. À contrôler avant tout usage.
On publie ici l’administration du pare-feu. C’est un essai, sans aucun compte externe sur
cette ressource. Les deux barrières sont l’authentification de Pangolin puis le mot de passe de pfSense
(voir H-08). À retirer à la fin de l’essai : supprimer la ressource et le nom alternatif. Dette
T-12.
60-pfsense-dns-rebind.png · à déposer : 63-pfsense-alternate-hostnames.png,
64-pfsense-connexion-par-pangolin.png
Étape 42 — Publier la page de statistiques de HAProxy : un alias et une règle très étroite
Objectif : afficher la page de statistiques de HAProxy (http://10.0.10.5:8404, VLAN 10) dans
l’accès externe, sans élargir ce que le connecteur peut atteindre.
Constat : depuis srv-docker, le test était resté sans réponse :
curl -sI --max-time 5 http://10.0.10.5:8404/ | head -1
Normal : le connecteur est sur SRV_BASTION, dont la règle ADM 4 n’autorise que PORTS_ADMIN (22 et 3389)
vers LAB_NETS, et la règle 5 refuse le reste. La page est joignable depuis le poste de travail par
Tailscale (non filtré), pas depuis le bastion.
Modification du pare-feu (deux temps, selon la convention « un alias = un usage ») :
Où
Valeur
Firewall → Aliases → Ports → Add
nom PORTS_HA_STATS, type Port(s), port 8404, description Page de statistiques HAProxy ; Save puis Apply Changes
Une règle plus large aurait suffi à faire marcher la page, et c’est précisément ce qu’on évite :
SRV_BASTION → LAB_NETS : tout donnerait à l’accès externe un chemin vers tout le lab. Ici, un hôte et un
port.
Validation : le même curl répond désormais HTTP/1.1 401 Unauthorized. Le 401 est la bonne
nouvelle : la page est atteinte et réclame son propre identifiant. La colonne States de la règle se
remplit (4 / 7 KiB constaté).
Le deuxième piège : « no available server »
La ressource Pangolin (type HTTP, cible http://10.0.10.5:8404) affichait « no available server » même
après authentification. Le contrôle de santé de Pangolin demandait la page d’accueil, recevait un 401, et
jugeait la cible hors service : le reverse proxy ne lui envoyait alors plus personne. Retirer le contrôle de
santé de cette cible a réglé le problème. Incident H-18.
Contrepartie : sans contrôle de santé, Pangolin ne détecte plus que cette cible tombe. C’est acceptable
pour une page de statistiques (elle est justement un indicateur), pas pour un service critique.
La page de statistiques affiche l’état des serveurs web et du cluster : à traiter comme les autres
ressources d’essai (dette T-12).
Étape 43 — Sauvegarder les VM du lab sur le NAS de l’école, et restaurer pour prouver
Objectif : une sauvegarde automatique et testée de toutes les VM du pool SIO2527_Axel, sur le stockage
réseau déjà déclaré dans Proxmox. L’annexe II.E exige une solution de sauvegarde ; jusque-là il n’existait que des
exports manuels (DAT §8.4).
État des lieux (lecture seule) : stockage Syno (NFS, /mnt/pve/NAS-01, contenu « Backup » autorisé), 766 Go
utilisés sur 2,87 To ; aucune tâche de sauvegarde dans Datacenter → Backup ; 11 VM dans le pool.
Essai sur une VM (srv-web-01, VM 110, mode snapshot, zstd) :
Test de restauration : l’archive restaurée en VM 136 (nouvel identifiant) sur storage-images en 3 min
20 s. La copie démarre, hostname = srv-web-01, Apache actif, fichiers de WordPress présents dans
/var/www/wordpress. La copie de test a ensuite été supprimée et la VM d’origine relancée.
Une sauvegarde jamais restaurée n’est pas une sauvegarde. Le test a eu lieu avant la planification.
Deux pièges : restaurer sur l’identifiant d’origine écraserait la VM en service ; et sans la case « Unique »,
la copie garde la même adresse MAC que l’original (conflit si elle démarre en réseau). Voir MO-11 §5.3.
La tâche planifiée (Datacenter → Backup → Add) :
Champ
Valeur
Stockage / heure
Syno / chaque jour à 02:00
Sélection
Pool based, pool SIO2527_Axel (les 11 VM)
Mode / compression
Snapshot / ZSTD
Rétention
7 quotidiennes + 4 hebdomadaires
« Pool based » : sur un hyperviseur partagé, la tâche ne touche que ses propres VM. Réglée sur « All », elle
sauvegarderait toutes les VM de tous les élèves.
Validation : la tâche apparaît dans Datacenter → Backup avec son Next Run. Première exécution automatique contrôlée le 15/10 : lancée à 02:00:03, terminée à 04:25:39 (2 h 25), TASK OK, les 11 VM sauvegardées, ≈ 75 Go d’archives pour la nuit (poste Windows 41 Go, contrôleur de domaine 14 Go, les autres de 0,8 à 5,5 Go). Deux avertissements : l’agent invité de la VM Windows ne tourne pas (pas de gel du système de fichiers) et le gel a échoué sur la VM du pare-feu (Resource deadlock avoided) ; dans les deux cas la sauvegarde s’est terminée.
Limites constatées (dette T-13) : plusieurs VM avaient leur disque sur le même NAS que leur
sauvegarde, et chaque nuit recopiait tout (≈ 75 Go). Ces deux points sont traités à l’étape 44.
Étape 44 — Passer à des sauvegardes incrémentales : Proxmox Backup Server
Objectif : ne plus recopier chaque nuit ce qui n’a pas changé, et séparer les disques des VM de leurs
sauvegardes. Réalisé le 15/10/2026.
44.1 Préalable : déplacer les disques des VM hors du NAS et du NVMe
Défait les 22-23/10 : les disques des VM sont revenus sur Syno (plus rapide) et c’est le datastore de PBS qui est
passé sur storage-images. Voir l’étape 49.2.
Constat (relevé sur pve-01)
Conséquence
Pool rpool (système et stockage local) : miroir de 2 NVMe dont un est REMOVED : plus de redondance
les VM sur local dépendaient d’un seul disque
Pool storage (stockage storage-images) : miroir de 2 × 6 To, ONLINE, 0 erreur, ≈ 4,8 To libres
destination saine et spacieuse
6 VM avaient leur disque sur Syno, le NAS qui reçoit aussi les sauvegardes
donnée et sauvegarde sur le même support
Action : VM → Hardware → disque → Disk Action → Move Storage, cible storage-images, « Delete source »
décoché (l’ancien disque reste en Unused Disk pour un retour arrière). Fait pour les 10 VM (disques
système, efidisk et tpmstate des VM Windows compris), chaque tâche TASK OK. Filet de sécurité : les
sauvegardes vzdump de la nuit.
Avertissement de Proxmox sur AD-Core-01 : moving disk with snapshots, snapshots will not be moved! : ses
instantanés Proxmox ne suivent pas le disque. Les anciens disques ne seront supprimés qu’après décision sur ces
instantanés (tâche 13.12).
Rallumage : le cluster Galera a dû être redémarré à froid (incident H-19) ; ensuite, tests réseau depuis
le poste de travail : bases 3306 (×3 et via HAProxy), sites 200, AD (DNS, LDAP, Kerberos, SMB, RDP), Termix,
pfSense, poste Windows : tous OK.
44.2 Le serveur PBS
Élément
Valeur
VM
137 SIO2527-srv-PBS-Axel, nom srv-pbs, VLAN 30, adresse fixe 10.0.30.13
Système
Proxmox Backup Server 4.2.8 (ISO 4.2-1 à empreinte vérifiée), dépôt no-subscription, à jour
Disques
système 32 Gio sur storage-images ; données 500 Gio sur Syno, « Backup » décoché(depuis le 23/10 : système sur Syno, données sur storage-images, étape 49.2)
Pool Proxmox
hors du pool SIO2527_Axel depuis le 16/10 : dedans, la tâche de sauvegarde échouait chaque nuit sur cette VM (incident H-21)
Ressources
4 cœurs, 6 Gio de RAM avec ballooning (minimum 2 Gio)
Durcissement
agent invité actif ; compte nominatif par clé SSH ; root interdit en SSH (sshd_config.d/00-no-root.conf)
Datastore
sio2527-lab, ext4, ≈ 500 Go
Accès de Proxmox
utilisateur backup-pve01@pbs + jeton pve01, rôle DatastoreBackup (envoyer, pas supprimer) sur l’utilisateur et le jeton
Chiffrement côté client
non retenu (décision du 15/10 : une clé perdue rendrait tout illisible)
44.3 La modification de pfSense : la première règle entrante du WAN
L’hyperviseur (10.1.0.253, côté WAN) ne connaît pas les réseaux du lab : il vise l’adresse WAN de pfSense, qui
redirige vers PBS.
WAN · TCP · source PVE_HOST · destination WAN address:PORTS_PBS → SRV_PBS:PORTS_PBS · règle de filtrage associée · Sauvegardes PBS depuis pve-01
Une source, un port, une destination : toute autre machine de l’école reste refusée. C’est une exception
assumée au « zéro règle entrante » de la phase 8 (voir T-1 et la matrice de flux §4.5).
Validation : depuis l’hyperviseur, curl -k https://10.1.0.197:8007/ → 200.
44.4 Branchement, sauvegarde, restauration
Étape
Résultat vérifié
Stockage pbs-lab-axel dans Proxmox (serveur 10.1.0.197, empreinte du certificat)
actif
1ʳᵉ sauvegarde de la VM 110
TASK OK, 1 min 33 s (contre 10 min 58 s en vzdump vers le NAS)
image de 32 Gio en 100,75 s, TASK OK (premier essai interrompu trop tôt : incident H-20) ; copie ensuite supprimée
44.5 Rétention et planification
Où
Réglage
PBS · Prune
05:00, Keep Daily 7 (7 jours maximum, décision du 15/10), rien d’autre
PBS · Garbage Collection
06:00
PBS · Verify
samedi 10:00, ne revérifie qu’après 30 jours
Proxmox · tâche Save Pool Axel
02:00, Pool basedSIO2527_Axel, stockage pbs-lab-axel, Keep all backups (la rétention est faite par PBS), Repeat missed coché
Le jeton de Proxmox ne peut pas supprimer : la rétention doit être faite par PBS. Si l’hyperviseur était
compromis, l’historique des sauvegardes ne pourrait pas être effacé par lui.
Validation : configuration relevée sur captures. Première nuit automatique vers PBS (16/10), journal lu :
lancée à 02:00:03, terminée à 02:36:11 (36 min, contre 2 h 25 en vzdump), 11 VM sauvegardées sans erreur
(la plus longue : le poste Windows, 13 min ; la VM web, déjà suivie par sa carte des blocs modifiés : 25 s). La
VM du serveur PBS a échoué (http upgrade request timed out) : elle a été sortie du pool (incident H-21),
correction confirmée par la nuit suivante (voir ci-dessous). Relevés du même jour : Prune de 05:00 et Garbage Collection de 06:00 OK (0 B supprimé, 26,56 Mo en attente : un bloc n’est supprimé qu’après 24 h 05) ; Content : 11 groupes, un instantané daté du 16/10 pour chacun (deux pour la VM web) ; Summary : 75,95 Go utilisés sur 500 (15 %), facteur de déduplication 11,75 pour 795 Gio de disques provisionnés. Deuxième nuit (journal du 17/10 lu) : lancée à 02:00:05, terminée à 02:16:42 (16 min 37 s), 11 VM, TASK OK, VM du serveur PBS absente : la sortie du pool a réglé l’échec. Toutes les sauvegardes sont incrémentales (carte des blocs conservée) : ≈ 31 Gio modifiés au total, dont 23,2 Gio pour le poste Windows, 5,1 Gio pour le contrôleur de domaine et moins de 0,6 Gio pour chacune des 9 autres. Le datastore passe à 104,94 Go sur 500 (21 %), soit +29 Go en une nuit. Premier Verify réussi (54 min 52 s, tableau de bord PBS du 17/10). Anciennes archives vzdump supprimées le 17/10 (11 archives de la nuit du 15/10, 33 fichiers, ≈ 75 Go) : contrôle du nombre et de la taille avant, suppression nommée, fichiers d’autres personnes laissés (une archive de VM 101 de janvier 2025 : le numéro de VM ne suffit pas à désigner ses fichiers sur un NAS partagé). Reste : les anciens disques « Unused » (13.12).
Étape 45 — Préparer le pare-feu pour la supervision et les journaux (phase 14)
Objectif : poser à l’avance les alias et les règles dont auront besoin les deux futures machines de la
supervision (VLAN 30, pas encore créées : srv-metriques10.0.30.14 avec Prometheus, srv-supervision10.0.30.15 avec Grafana, la réception des journaux et un accès au cluster Galera). Projet cadré le 15/10 ; rien
n’est installé.
45.1 Quatre alias
Où
Nom
Valeur
Rôle
Aliases → IP
SRV_METRIQUES
10.0.30.14
serveur de métriques
Aliases → IP
SRV_SUPERVISION
10.0.30.15
Grafana, journaux, accès à la base
Aliases → Ports
PORTS_EXPORTERS
9100, 9104, 9182
exporteurs : Linux, MariaDB, Windows (ports par défaut des outils)
Aliases → Ports
PORTS_SYSLOG
514
réception des journaux (TCP)
45.2 Quatre règles
Onglet
Règle
Pourquoi
ADM
SRV_SUPERVISION → GALERA_NODES : 3306
écrire les journaux et la base de Grafana dans le cluster
ADM
SRV_METRIQUES → LAB_NETS : PORTS_EXPORTERS
Prometheus vient chercher les métriques : un hôte source, trois ports
WEB
WEB subnets → SRV_SUPERVISION : PORTS_SYSLOG
les serveurs web et le répartiteur envoient leurs journaux
BDD
BDD subnets → SRV_SUPERVISION : PORTS_SYSLOG
les nœuds Galera envoient leurs journaux : exception assumée à « la base n’initie rien »
Toutes sont des « Pass » au-dessus du refus de leur onglet, sans journalisation. Les alias sont utilisés tels
quels (un alias = un usage) ; seul le port 3306 est saisi en clair, comme la règle du répartiteur vers Galera.
45.3 Ce qui est volontairement laissé de côté
Sujet
Pourquoi
Règle de l’onglet USERS
poste-win11 ne sait pas envoyer ses événements en syslog sans logiciel complémentaire : outil à choisir (14.5) avant d’ouvrir un flux
Règles du VLAN 30
AD, bastion et PBS sont dans le même VLAN que les deux machines : leur trafic ne traverse pas pfSense
Journaux de pfSense
envoyés depuis 10.0.30.1, dans le VLAN 30 : pas de règle
Sondes de service (site, base)
règle à poser à la construction de srv-metriques (14.3), quand on saura ce qu’on sonde
45.4 Un piège rencontré : la règle sans port de destination
La première version de la règle BDD avait été enregistrée sans port : la colonne Port affichait *, donc tout le
TCP de la zone BDD vers SRV_SUPERVISION passait. Repéré à la lecture de la capture, corrigé le jour même (champ
Destination Port Range → PORTS_SYSLOG). C’est le cas décrit en B-04 (règle sans port de destination).
84-pfsense-regle-bdd-sans-port.png(la règle avant correction)
Validation : alias et règles relevés sur captures, bandeau « The changes have been applied successfully » à
chaque onglet. Les flux eux-mêmes ne sont pas testés : les deux machines n’existent pas encore (test à la
construction : 14.3 et 14.5). Adresses .14 et .15vérifiées libres le 18/10 : aucune réponse au ping ni au SSH depuis le poste d’administration (par Tailscale), alors que .12 et .13 répondent (témoins).
Étape 46 — Construire la supervision (1/2) : deux machines, Prometheus et les premières sondes (phase 14)
Objectif : poser les deux machines du projet de supervision (cadré le 15/10) et mettre en service la mesure de disponibilité : Prometheus lit
des sondes de service, un blackbox exporter les exécute. La partie journaux (rsyslog vers le cluster), Grafana et les alertes restent à faire
(tâche 14.5 et suivantes).
46.1 Les deux machines
srv-metriques
srv-supervision
VM Proxmox
139SIO2527-srv-metriques-Axel
140SIO2527-srv-supervision-Axel
Rôle prévu
Prometheus, blackbox exporter
Grafana, réception des journaux, accès au cluster (à installer)
Adresse
10.0.30.14/24
10.0.30.15/24(vérifiées libres le 18/10 : aucune réponse au ping ni au SSH)
Système
Debian 13.6 « trixie », installée à la main depuis l’image netinst
SIO2527_Axel : prise par PBS dès la nuit du 19 au 20/10 (32 Gio lus en moins d’une minute, disque vide à 91-92 %)
idem
Installation (une VM à la fois, mêmes réponses) : réseau saisi à la main (adresse, passerelle 10.0.30.1, serveur de noms 10.0.30.1, domaine sio.internal),
mot de passe root laissé vide (compte désactivé, sudo pour l’utilisateur ipfixe), disque entier en une partition, aucun bureau,
seulement « serveur SSH » et « utilitaires usuels du système ». L’ISO est retiré avant le premier démarrage.
Vérifications faites sur chaque machine : route par défaut 10.0.30.1 et DNS 10.0.30.1 ; ping de pfSense (et, depuis srv-supervision, du VLAN 20) ;
apt update sans erreur sur les trois dépôts ; apt full-upgrade : 0 mise à jour, noyau en cours 6.12.113 = le plus récent installé, pas de redémarrage requis ;
agent QEMU installé et active ; Machine ID différent d’une machine à l’autre (installations propres, pas de clonage).
Accès : clé personnelle déposée par ssh (méthode du MO-4), puis les deux machines ajoutées à Termix avec une clé dédiée au portail (termix_lab, MO-7 §8.2).
curl n’est pas fourni par l’installation minimale : sudo apt install -y curl.
30 jours (défaut : 15), vérifiée par l’API (/api/v1/status/flags)
/etc/default/prometheus
Écoute de Prometheus
10.0.30.14:9090(jamais *)
idem
Écoute du node exporter
10.0.30.14:9100
/etc/default/prometheus-node-exporter
Configuration
minimale : intervalle 15 s, jobs prometheus et node, étiquette host
/etc/prometheus/prometheus.yml(original en .orig)
Le bloc alerting de l’exemple Debian (un Alertmanager qui n’existe pas) est retiré : les alertes viendront de Grafana. La configuration est validée par promtool check configavant chaque rechargement.
Le paquet Debian n’inclut pas la nouvelle interface web : seule l’« interface classique » (/classic/targets) existe, annoncée comme retirée dans un futur paquet. Ce n’est pas gênant : l’écran de travail sera Grafana, via l’API.
85-prometheus-cibles-up.png(les deux premières cibles à l’état UP, avec leurs étiquettes)
46.3 Le blackbox exporter
Blackbox exporter 0.26.0 (paquet Debian) : il exécute les sondes à la demande de Prometheus. Écoute 127.0.0.1:9115 (seul Prometheus, sur la même machine, l’interroge).
Sa configuration (/etc/prometheus/blackbox.yml, original en .orig) ne contient que les modules utilisés :
Module
Rôle
http_2xx_insecure
une page web répond en 2xx ; ne vérifie pas le certificat (ceux du lab sont auto-signés) : mesure la disponibilité, pas la validité du certificat
dns_ad
l’AD résout sio.internal
dns_resolveur
pfSense résout www.sio.internal
tcp_connect
un port TCP accepte la connexion (non utilisé pour l’instant)
Tous demandent l’IPv4 (preferred_ip_protocol: "ip4") : le lab n’a pas d’IPv6.
46.3 bis Les quatre sondes en service
Chaque sonde est un job de Prometheus qui demande au blackbox de tester une cible ; les étiquettes host et service rendront les tableaux de bord et les alertes lisibles.
Sonde (job)
Cible
Module
host / service
Règle pfSense
sonde_https
https://10.0.30.13:8007
http_2xx_insecure
srv-pbs / sauvegarde
aucune (même VLAN)
sonde_dns_ad
10.0.30.10
dns_ad
AD-Core-01 / dns-annuaire
aucune (même VLAN)
sonde_dns_resolveur
10.0.30.1
dns_resolveur
fw-01 / dns-resolveur
déjà autorisée (ADM, DNS et NTP)
sonde_site
https://www.sio.internal/
http_2xx_insecure
srv-ha / site-web
SRV_METRIQUES → SRV_HA : 443
La sonde du site suit le parcours d’un utilisateur : résolution du nom par pfSense, répartiteur, serveur web, PHP et base de données (WordPress lit sa page dans MariaDB).
Validation (20/10) : promtool : SUCCESS ; 6 jobs (grep -c job_name) ; 6 cibles up (2 de Prometheus et du node exporter, 4 sondes) ;
probe_success = 1 pour sauvegarde, dns-annuaire, dns-resolveur et site-web.
La sonde DNS de l’AD a d’ailleurs détecté une vraie panne : elle donnait 0 pendant que l’AD était éteint (expérience sur les sauvegardes) et 1 après son redémarrage.
86-pfsense-regles-adm-sondes.png(onglet ADM : règle de la sonde du site, au-dessus du refus)
46.4 Ce qui a été essayé puis abandonné : la sonde de la base de données
Une sonde TCP attendant la bannière « MariaDB » sur 10.0.10.5:3306 a été écrite, puis abandonnée : le blackbox lit ligne par ligne, la bannière de MariaDB n’a pas de retour à la ligne
et la sonde n’aboutit qu’à l’expiration de son délai ; elle aurait de plus laissé des connexions non authentifiées sur le serveur (risque de blocage de l’adresse du répartiteur).
Incident H-23. La règle SRV_METRIQUES → SRV_HA : 3306 posée pour elle a été retirée. L’état du cluster sera mesuré par mysqld_exporter (tâche 14.4).
46.5 Un piège rencontré à l’écriture de la configuration
Un bloc de sondes collé deux fois dans nano a produit des jobs en double (Prometheus les refuse). Incident H-22 ; depuis, la configuration s’écrit par une commande idempotente, avec deux garde-fous
avant tout rechargement : un décompte des jobs et promtool check config.
86b-pfsense-regles-adm-avant-retrait-3306.png(onglet ADM le 20/10, avec la règle 3306 de la sonde abandonnée, avant son retrait)
Étape 47 — Construire la supervision (2/2) : un exporteur sur chaque machine, déployé par script (phase 14)
Objectif : que Prometheus mesure toutes les machines du lab de l’intérieur (processeur, mémoire, disques, réseau) et l’état du cluster
Galera, en plus des sondes de l’étape 46. Chaque machine reçoit un exporteur, un petit service qui publie ses mesures sur un port ;
Prometheus vient les lire toutes les 15 secondes. Tâche 14.4, faite les 20 et 21/10.
88a à 88d-prometheus-cibles-*.png(page Targets : les 21 cibles en vert, avec leurs étiquettes)
47.1 Comment Prometheus connaît ses cibles : un fichier par machine
La configuration ne liste plus les machines une par une. Chaque job (node, mysql, windows) lit un dossier de fiches
(file_sd_configs) : /etc/prometheus/cibles/<job>/*.yml, une fiche par machine, avec trois étiquettes.
- targets:['10.0.10.10:9100']labels:host:'srv-web-01'# nom lisible dans les tableaux de bord et les alerteszone:'WEB'# VLAN : WEB, BDD, ADM ou USERSos:'linux'# linux, windows ou freebsd
Prometheus relit ces dossiers seul : ajouter une fiche ne demande aucun rechargement (prise en compte en moins d’une minute).
Seul l’ajout d’un job modifie prometheus.yml ; il passe alors par les garde-fous de l’étape 46 (copie de sauvegarde, grep -c job_name,
promtool check config, puis systemctl reload). Copies conservées sur srv-metriques : prometheus.yml.avant-filesd, .avant-mysql, .avant-windows.
Le fichier de configuration se transfère, il ne se colle plus. Un collage de ~70 lignes dans le terminal web de Termix est arrivé
corrompu : prometheus.yml est désormais écrit sur le PC (annexes/scripts/supervision/prometheus.yml), envoyé par scp dans /tmp,
puis installé par sudo install -m 644 -o root -g root. Incident H-24.
Configuration finale : 8 jobs — prometheus, node, mysql, windows, sonde_https, sonde_dns_ad, sonde_dns_resolveur, sonde_site.
47.2 Linux : un script lancé depuis le bastion
Le déploiement se fait par deux scripts (dans annexes/scripts/supervision/), lancés depuis le bastion srv-docker avec le compte ipfixe :
Script
S’exécute
Rôle
ajouter-machine.sh
sur le bastion
demande l’adresse IP et le compte (ipfixe par défaut) ; déduit la zone du réseau (10.0.10 WEB, 10.0.20 BDD, 10.0.30 ADM) ; lit le nom de la machine (hostname -s) et le propose ; copie et lance l’installeur ; dépose la fiche sur srv-metriques
installer-node-exporter.sh
sur la machine cible, en sudo
installe prometheus-node-exportersans les paquets recommandés ; limite l’écoute à l’adresse de la machine (--web.listen-address=<IP>:9100, jamais *) ; vérifie avec ss ; en zone BDD, télécharge seulementmysqld_exporter
bash ajouter-machine.sh 10.0.10.10 ipfixe
Pourquoi le bastion, et pas srv-metriques ? Seul le bastion a le droit d’ouvrir du SSH vers toutes les zones (règle ADM 4). Donner ce droit à
srv-metriques en ferait un serveur d’administration : le pirater donnerait accès à tout le lab. Un serveur de supervision regarde, il n’administre pas.
Aucun mot de passe n’est enregistré : chaque machine demande le sien ; une seule connexion SSH est ouverte par machine (ControlMaster).
--no-install-recommends n’est pas un détail. Sans lui, prometheus-node-exporter installe une trentaine de paquets via ses
« recommandés » (smartmontools, ipmitool, nvme-cli, snmp…, dont des services qui démarrent). Ils ont été retirés de srv-metriques
et srv-supervision (apt purge prometheus-node-exporter-collectors puis apt autoremove --purge : 23 paquets, 30,9 Mo). Incident H-25.
Versions : node exporter 1.9.0 sur les machines Debian 13 ; 1.5.0 sur srv-docker, resté en Debian 12 (dette H-4).
Validation (20/10) : chaque passage affiche OK : node_exporter ecoute sur <IP>:9100 puis la liste des fiches ; Prometheus : 15 cibles up.
47.3 La zone BDD : une fenêtre Internet de 20 minutes
Le VLAN 20 n’a pas d’accès Internet (règle « TEMPORAIRE » décochée, T-3). Décision d’Axel : la rouvrir le temps de l’installation, puis la refermer —
une base exposée en permanence est un risque, une fenêtre de vingt minutes, encadrée, est acceptable. Une copie des paquets par scp avait été proposée
et jugée trop compliquée.
#
Garde-fou
Preuve
1
Une seule fenêtre : on y installe node_exporteret on télécharge mysqld_exporter (installé ensuite sans Internet)
mysqld_exporter : paquet mis en cache (non installe) sur les 3 nœuds
2
Le script demande confirmation que la règle est ouverte, et rappelle de la refermer
La règle n’ouvre que TCP 80/443 : un ping 8.8.8.8 échoue même règle ouverte, c’est normal (le test doit viser le protocole de la règle).
Compteur de la règle à la fermeture : 28,14 Mio.
aucun mot de passe : MariaDB accepte le compte seulement si la connexion vient de l’utilisateur système prometheus de la machine elle-même, par le socket local. Rien à stocker, rien à voler
@'localhost'
inutilisable depuis le réseau
droits de statistiques seulement
le compte ne lit aucune donnée. La documentation de l’exporteur propose aussi SELECT ON *.* : inutile pour les mesures Galera, donc non accordé
MariaDB affiche REPLICATION CLIENT sous son nom actuel, BINLOG MONITOR.
Le service — le paquet s’installe avec des options vides (ARGS="") et échoue au démarrage : c’est attendu, il ne sait pas encore où se connecter.
Le fichier d’exemple de Debian évoque la variable DATA_SOURCE_NAME, que les versions récentes n’utilisent plus ; on suit la méthode actuelle, un fichier .cnf :
Validation (21/10), depuis srv-metriques (le test traverse donc aussi le pare-feu) : mysql_up 1, mysql_global_status_wsrep_cluster_size 3,
mysql_global_status_wsrep_local_state 4 (Synced) sur les 3 nœuds ; job mysql ajouté → 18 cibles up.
88a-prometheus-cibles-mysql.png
47.5 Windows : windows_exporter, ouvert à srv-metriques seul
Les deux machines Windows ont un accès Internet (règles « Sortie Internet » d’ADM et d’USERS) : l’installeur officiel est téléchargé directement
(projet GitHub prometheus-community/windows_exporter, version 0.31.9). Commandes passées une à une dans un PowerShell administrateur
(regroupées dans annexes/scripts/supervision/installer-windows-exporter.ps1) :
télécharger le .msi de la dernière version publiée ;
installer sans question : msiexec /i … /qn → service windows_exporterRunning ;
créer la règle du pare-feu Windows et lister toutes les règles du port 9182 (pour repérer une règle plus large que l’installeur aurait créée — il n’en a créé aucune) :
Le poste passe en adresse réservée. Prometheus a besoin d’une adresse stable ; le poste recevait .100 du DHCP. Une réservation est créée dans pfSense
(Status > DHCP Leases, icône Add static mapping), MAC bc:24:11:da:d2:fd. Le serveur DHCP (ISC) refuse une réservation dans la plage .100–.199
(incident H-29) : le poste reçoit donc 10.0.40.10, hors plage (ipconfig /release puis /renew).
Validation (21/10) :
Test
Depuis
Attendu
Obtenu
curl http://10.0.30.10:9182/metrics
srv-metriques
répond
version="0.31.9", Windows Server 2025 Standard Evaluation
idem
srv-docker
bloqué
BLOQUE — la règle n’ouvre qu’à srv-metriques
curl http://10.0.40.10:9182/metrics
srv-metriques
répond
version="0.31.9", Windows 11 Pro
Job windows ajouté → 20 cibles up.
88d-prometheus-cibles-windows.png
47.6 pfSense : le paquet node_exporter
pfSense propose le paquet node_exporter (paquet 0.18.1_8, exporteur 1.11.0) dans System > Package Manager. Réglages (Services > node_exporter) :
Enable coché, Interface : ADM (jamais WAN), port 9100, collecteurs par défaut.
joignables par srv-metriques seul : règle pfSense 4 quater entre zones, pare-feu Windows sur les postes Windows, interface ADM seule sur pfSense
Écoute
toujours sur l’adresse de la machine, jamais * (Linux, pfSense)
Comptes
un seul compte nouveau (prometheus@localhost dans MariaDB), sans mot de passe et sans accès aux données
Internet zone BDD
rouvert ~20 min, refermé et vérifié
Règles pfSense ajoutées
aucune (celles de l’étape 45 suffisaient)
Un mot de passe affiché
tapé avant l’invite [sudo], un mot de passe s’est affiché en clair dans Termix (incident H-28) — mot de passe conservé par décision d’Axel (23/10, risque assumé en laboratoire)
Étape 48 — Centraliser les journaux de toutes les machines dans le cluster Galera (phase 14)
Objectif : répondre à la question « depuis quand, et vers quoi ? ». Chaque machine du lab envoie une copie de ses journaux à
srv-supervision, qui les range dans le cluster MariaDB/Galera — c’est la contrainte du sujet : la supervision s’appuie sur le cluster.
Les journaux d’authentification sont séparés (conservés 1 an), les autres conservés 6 mois (recommandation CNIL 2021-122, décision du 15/10).
Tâche 14.5, faite le 21/10.
 10 Linux ── rsyslog ──── TCP 514 ──┐
 pfSense ─── syslogd ──── UDP 514 ──┤        srv-supervision (10.0.30.15)
 AD, poste ─ Fluent Bit ─ TCP 514 ──┴──► rsyslog ──► HAProxy local ──► Galera (3 nœuds)
                                         │  tri        127.0.0.1:3306     base syslog :
                                         │  auth/reste                    journaux (6 mois)
                                         └─ file d'attente sur disque     journaux_auth (1 an)
48.1 Un HAProxy local : une seule machine parle au cluster
srv-supervision (VM 140) n’écrit jamais directement dans un nœud : un HAProxy local écoute sur 127.0.0.1:3306 (joignable depuis la
machine elle-même seulement) et transmet au nœud principal, srv-mysql-01, ou à un nœud de secours s’il tombe — le même montage que srv-ha
(MO-3) : bascule, pas répartition, pour éviter les conflits d’écriture de Galera.
Élément
Valeur
Paquets
haproxy3.0.11 et mariadb-client11.8.6 (--no-install-recommends) — le client sert aux tests, il n’y a pas de serveur de base sur la VM
Configuration
bloc listen galera ajouté à /etc/haproxy/haproxy.cfg (original en .orig) : bind 127.0.0.1:3306, mode tcp, option mysql-check user haproxy_check, mysql-01 principal, mysql-02/03 en backup, timeout client/server 1h (rsyslog garde sa connexion ouverte)
Compte de sonde
'haproxy_check'@'10.0.30.15' — sans mot de passe et sans aucun droit (connexion seule), créé sur un nœud, recopié par Galera
Règle pfSense
ADM 4 ter SRV_SUPERVISION → GALERA_NODES : 3306 (posée à l’étape 45)
Validation : connexion directe aux 3 nœuds depuis srv-supervision → srv-mysql-01/02/03 ; par 127.0.0.1 → srv-mysql-01 ; journal HAProxy :
galera galera/mysql-01, aucun nœud DOWN. Le test direct avec le compte sans mot de passe a d’abord échoué sur le certificat (incident H-31).
48.2 Les bases, les tables et les comptes
Base
Contenu
syslog
deux tables de même structure : journaux (tout sauf l’authentification, 6 mois) et journaux_auth (catégories auth/authpriv, 1 an)
grafana
les réglages de Grafana (tableaux de bord, utilisateurs, alertes), à venir
Table conçue pour le besoin plutôt que le modèle de rsyslog (25 colonnes, dont 20 vides) : id (clé primaire, obligatoire pour Galera),
recu_le, emis_le, hote, programme, facilite, gravite, message, avec des index sur la date et sur (machine, date) pour les recherches
et la purge. Jeu de caractères utf8mb4.
Compte (@10.0.30.15)
Droits
Utilisé par
rsyslog
INSERT sur syslog — écrit, ne lit pas
rsyslog
grafana_lecture
SELECT sur syslog — lit, n’écrit pas
l’écran des journaux
grafana
tous les droits sur la base grafana seulement
Grafana
Mots de passe générés dans Bitwarden (24 lettres et chiffres, sans caractère spécial pour ne pas casser les fichiers de configuration), saisis dans une
session MariaDB sans historique (sudo env MYSQL_HISTFILE=/dev/null mariadb). Le compte qui supprimera les vieux journaux viendra avec la purge (14.6).
Validation : sur srv-mysql-02, SHOW GRANTS montre les trois comptes et leurs droits exacts (recopiés par Galera) ; depuis srv-supervision par
HAProxy : [email protected], SELECT COUNT(*) = 0, [email protected] — avec mot de passe, le certificat est vérifié sans option.
94-galera-comptes-journaux-crees.png(création des comptes ; la capture coupe les lignes avant les mots de passe)
48.3 La réception : rsyslog sur srv-supervision
rsyslog8.2504, rsyslog-mysql et dbconfig-no-thanks (sans lui, le module voudrait créer lui-même la base). Deux fichiers, en 600 root:root
(ils contiennent le mot de passe du compte rsyslog, placé sur le serveur par read -rsp puis sed, jamais écrit dans le fichier du PC) :
Fichier
Écoute
Accepte
30-reception-galera.conf
TCP 514 sur 10.0.30.15
les machines Linux et Windows
31-reception-pfsense.conf
UDP 514 sur 10.0.30.15
seulement 10.0.30.1 (pfSense ne sait envoyer qu’en UDP) ; tout autre envoi UDP est ignoré
Chaque message reçu suit son propre ensemble de règles (ruleset) : il va dans la base, pas dans /var/log/ de srv-supervision. Le tri se fait sur la
catégorie (auth/authpriv → journaux_auth). Deux modèles SQL avec option.sql (les apostrophes des messages sont protégées), nom de machine et de programme
coupés à 64 caractères (taille des colonnes). File d’attente sur disque (1 Go, conservée au redémarrage) : si HAProxy ou Galera ne répondent pas, aucun
journal n’est perdu. Configuration validée par rsyslogd -N1 avant chaque redémarrage.
Validation : ss → tcp et udp sur 10.0.30.15:514 ; deux messages logger (ordinaire, puis auth.info) arrivent chacun dans sa table,
l’apostrophe de « d’authentification » intacte.
48.4 Les machines Linux : intégré à ajouter-machine.sh
« Ajouter une machine à la supervision » fait désormais mesures et journaux : ajouter-machine.sh (étape 47) lance un second installeur,
installer-rsyslog-client.sh, qui :
envoie tout à 10.0.30.15:514 en TCP (/etc/rsyslog.d/90-vers-supervision.conf : omfwd, file d’attente sur disque de 200 Mo) ;
règle l’heure sur pfSense (48.6) ;
envoie deux messages de test.
Les deux installeurs ont été rendus plus robustes en chemin : attente du verrou d’apt jusqu’à 5 min (une mise à jour automatique occupait srv-metriques,
incident H-32), attente du port jusqu’à 15 s et redémarrage de node_exporter seulement si son réglage change (srv-mysql-01, chargé, ouvrait
son port après plus d’une seconde, incident H-33), et plus aucun appel à Internet si tout est déjà installé.
Zone BDD : rsyslog était absent des nœuds → deuxième fenêtre Internet (règle « TEMPORAIRE » cochée, 3 nœuds, décochée, test ferme). Le script
s’arrête désormais avec un message clair si un paquet manque sans Internet.
Validation (21/10) — comptage en base, la seule vraie preuve (pour la zone BDD, les messages ont dû franchir le pare-feu) : les 10 machines Linux
dans les deux tables, de 213 à 341 événements d’authentification et de 111 à 313 autres chacune, en quelques heures.
48.5 pfSense
Status → System Logs → Settings : Log Message Format = syslog (RFC 5424) (le nom de la machine et l’heure exacte sont écrits clairement ; avec l’ancien
format, rsyslog risquerait de confondre programme et machine) ; Remote Logging coché, Source Address = ADM, IPv4, serveur 10.0.30.15:514, contenu
Everything ; Local Logging laissé actif (le désactiver couperait aussi la protection contre les tentatives de connexion répétées).
Validation : en 5 minutes, SIO2527-pfSense-axel.sio.internal envoie 107 messages du pare-feu (filterlog) et 30 de l’interface web (nginx).
Ce nom diffère de celui de Prometheus (fw-01) : la correspondance se fera dans Grafana.
C’est l’intérêt de voir tous les journaux au même endroit : deux anomalies invisibles machine par machine sont apparues dès la première heure.
Constat
Cause
Correction
srv-metriques envoie 35 709 lignes en quelques heures (les autres : 100 à 300)
le blackbox exporter écrit 5 lignes de niveau « info » par sonde réussie, soit plus de 100 000 par jour
--log.level=warn dans /etc/default/prometheus-blackbox-exporter ; 21 cibles toujours up ; 36 063 lignes effacées (compte d’administration sur un nœud) — incident H-34
systemd-timesyncd écrit ~3 messages par minute sur les machines WEB et BDD : Timed out waiting for reply from …(3.debian.pool.ntp.org)
les zones fermées ne peuvent pas joindre les serveurs de temps d’Internet (UDP 123) : leurs horloges n’avaient jamais été synchronisées
/etc/systemd/timesyncd.conf.d/pfsense.conf → NTP=<passerelle> (pfSense, déjà autorisé par « DNS et NTP fournis par pfSense ») sur srv-ha, srv-web-01/02, srv-mysql-01/02/03 → System clock synchronized: yes ; plus aucun échec ensuite ; ajouté à l’installeur — incident H-35
Des horloges justes sont la condition pour comparer des journaux (« depuis quand ? ») et pour la cohérence du cluster.
95-blackbox-deluge-puis-reception-udp.png(les 35 709 lignes du blackbox, le flot à 0 après correction, puis la réception UDP de pfSense en place)
48.7 Windows : Fluent Bit
Windows ne sait pas envoyer ses journaux en syslog : il faut un agent. NXLog Community Edition, prévu au départ, n’est plus téléchargeable sans compte, et
le site refusait l’authentification (H-37). Choix : Fluent Bit 5.1.3 (libre, Apache 2.0, projet de la fondation CNCF), téléchargé sur le site officiel.
Le .msi n’ayant pas d’empreinte publiée, c’est l’installeur .exe, dont l’empreinte SHA-256 figure dans la documentation officielle, qui est installé
(H-36) : EMPREINTE CONFORME avant l’installation (/S, sans question).
Élément
Valeur
Lecture
deux entrées winevtlog : Sécurité limitée à une sélection (4624/4625 connexions, 4634, 4648, 4672 droits d’administrateur, comptes créés/modifiés/supprimés 4720-4726, ajouts à un groupe 4728/4732/4756, 4740 verrouillage, 4771 échec Kerberos, 1102 journal effacé) ; Système et Application : erreurs et avertissements seulement. Position de lecture gardée (pas de doublon au redémarrage), pas de relecture de l’historique
Préparation (script Lua)
niveau Windows → gravité syslog ; Sécurité → authpriv (table journaux_auth) ; nom court de la machine ; EventID nnnn : en tête du message ; retours à la ligne remplacés par des espaces (en syslog TCP, ils couperaient le message)
Envoi
syslog RFC 5424, TCP vers 10.0.30.15:514, réessai sans limite
Fichiers
C:\ProgramData\fluent-bit\fluent-bit.conf et windows-vers-syslog.lua, copiés par scp depuis le PC ; validés par --dry-run (configuration test is successful)
Service
fluent-bit, démarrage automatique, compte système (le seul à pouvoir lire le journal de sécurité)
Règle pfSense
nouvelle : USERS USERS subnets → SRV_SUPERVISION : PORTS_SYSLOG, en tête (l’AD est dans la même zone que srv-supervision)
Les noms des champs (Level, Channel, Computer, EventID, Message, ProviderName), absents de la documentation, ont été vérifiés par un essai
qui affiche les événements à l’écran avant l’écriture du script.
Validation (21/10) : AD-Core-01 → journaux_auth, programme Microsoft-Windows-Security-Auditing, messages EventID 4624 : L'ouverture de session…,
accents lisibles ; poste-win11 → événement de test (eventcreate /ID 999) reçu en journaux, gravité 3, par la nouvelle règle USERS.
Volume à surveiller : l’AD a envoyé 796 événements de sécurité en quelques minutes, surtout son compte machine (AD-CORE-01$) qui ouvre et
ferme des sessions en boucle. La mesure de 48 h (tâche 14.6) dira s’il faut l’exclure.
Ce que les journaux de l’AD montrent déjà (à traiter hors de cette étape) : aucune source d’heure fiable (événements 12 et 134 ; réglé : le 26/10, l’AD prend son heure sur pfSense, étape 51), échecs de résolution DNS
(1014) et d’inscription DNS (5774), services qui ne démarrent pas (ADWS, Windows Update), réinitialisations du disque (129, 153).
48.8 Bilan sécurité de l’étape
Point
État
Accès au cluster
une seule machine (srv-supervision), par une seule règle, à travers un HAProxy joignable en local seulement
Comptes
moindre privilège : un compte écrit, un lit, un gère Grafana ; la sonde n’a aucun droit ; mots de passe dans Bitwarden, jamais dans la documentation ni l’historique
Fichiers contenant un mot de passe
600 root:root
Réception
adresse de la machine seulement ; UDP réservé à pfSense
Règles pfSense ajoutées
une (USERS → SRV_SUPERVISION : 514)
Internet zone BDD
rouvert le temps d’installer rsyslog, refermé et vérifié
Logiciel tiers Windows
empreinte SHA-256 vérifiée avant installation
Données personnelles
journaux d’authentification séparés pour une conservation limitée à 1 an (purge en 14.6)
Étape 49 — Sauvegardes : le poids des VM Windows, le retour des disques sur le NAS, les notifications et le ménage (phase 13)
Objectif : comprendre pourquoi les deux VM Windows pèsent autant dans les sauvegardes nocturnes, rendre au lab des
disques rapides, être prévenu par mail de ce que fait le serveur de sauvegarde, et retirer tout ce qui ne sert plus.
Travaux du 22 au 27/10/2026.
49.1 Pourquoi les VM Windows grossissaient la sauvegarde (tâche 13.15)
Le constat : chaque nuit, PBS ne relit que les blocs de 4 Mio modifiés depuis la veille (carte des blocs modifiés,
dirty-bitmap). Les VM Linux en modifient 0,2 à 0,9 Gio par jour ; le poste Windows en modifiait 9,5 à 11 Gio
(23,2 Gio le 17/10) et le contrôleur de domaine, presque inutilisé, 5 à 6 Gio.
Le diagnostic (22/10, en lecture seule dans les VM et dans Prometheus) :
Piste
Vérification
Conclusion
Indexation Windows
taille de l’index du poste : 3 Mio ; service absent de l’AD
écartée
Défragmentation planifiée
Get-ScheduledTask -TaskName ScheduledDefrag | Get-ScheduledTaskInfo : exécutée le 16/10 à 20:38 sur le poste
cause du pic de 23,2 Gio : les disques sata0 étaient présentés comme disques durs, que Windows défragmente chaque semaine (un SSD n’est jamais défragmenté)
Antivirus
processus qui écrivent le plus : Defender (MsMpEng) en tête sur les deux VM
écrivain principal du « fond » quotidien
Effet des blocs
Prometheus : l’AD écrit ≈ 2,6 Gio par jour ; la sauvegarde compte 5,9 Gio de blocs modifiés
amplification ≈ 2,3 : une petite écriture « salit » un bloc entier de 4 Mio
Les corrections (22-23/10), sur les deux VM : Hardware → disque sata0 : SSD emulation et Discard
cochés ; dans Windows, TRIM actif. Sur le poste, agent invité installé depuis l’ISO virtio-win-0.1.302
(virtio-win-guest-tools.exe /install /quiet /norestart, service QEMU-GA démarré et automatique ; qm agent 101 ping
répond) : Windows ignorait souvent les demandes d’arrêt de Proxmox. Les réglages de disque ne s’appliquent qu’après un
arrêt puis un démarrage depuis Proxmox (pas un redémarrage depuis Windows).
Le résultat — nuit du 26/10, la première où la carte des blocs était intacte depuis la veille :
VM
Avant
Nuit du 26/10
Données réellement nouvelles pour PBS
poste-win11
9,5 à 11 Gio (23,2 le jour de la défragmentation)
8,1 Gio
≈ 7 Gio
AD-Core-01
5,1 à 5,9 Gio
5,8 Gio
≈ 5,1 Gio
les autres VM réunies
—
—
≈ 8 Gio
Conclusion : les pics dus à la défragmentation ont disparu ; il reste un fond régulier de 5 à 8 Gio par jour
et par VM Windows (Defender, journaux, effet des blocs), qui représente 60 % des données nouvelles de la nuit. La
déduplication de PBS l’absorbe sans difficulté (49.6). Niveau accepté par Axel le 04/11 (tâche 13.15 close), après le relevé ci-dessous : le datastore est stable vers 36 %, la purge garde 7 jours.
Relevé du 04/11 et analyses de Defender espacées. Nuit du 03 au 04/11 (journaux vzdump de pve-01, lecture
seule) : poste-win1112,5 Gio de blocs modifiés sur 100, AD-Core-016,5 Gio sur 64 ; le datastore reste
stable entre 166 et 180 Gio sur 491 (≈ 36 %) sur les 7 derniers jours (mesure pbs_used de Prometheus), dans
la fourchette prévue en 49.6. Sur l’AD, les fichiers modifiés en 22 h ne pèsent que 1 Gio : le reste des blocs
modifiés ne correspond à aucun fichier visible (fichiers temporaires effacés, fichier d’échange, métadonnées du
disque : hypothèse, non prouvée).
Defender lançait une analyse rapide chaque jour (ScanScheduleDay = 0, « tous les jours »). Décision d’Axel
(04/11) : « c’est un lab, une fois tous les 15 jours c’est bien ». Sur les deux VM Windows, par l’agent invité :
tâche planifiée \Lab\Analyse rapide Defender (15 jours)
—
MpCmdRun.exe -Scan -ScanType 1 (analyse rapide), toutes les 2 semaines, le samedi à 04:00 (après les sauvegardes de 02:00), compte SYSTEM ; prochaine : 07/11
protection en temps réel
active
active (inchangée : c’est elle qui bloque un logiciel malveillant)
mises à jour des signatures
quotidiennes
quotidiennes (inchangées : une signature en retard, c’est une menace non reconnue)
Pourquoi une tâche à nous : Defender ne sait planifier qu’« un jour de la semaine » ou « tous les jours », et
supprime sa propre tâche quand on règle « jamais » (H-81). Pour revenir en arrière : Set-MpPreference -ScanScheduleDay 0 (Defender recrée sa tâche) puis supprimer la tâche \Lab\. Effet à mesurer sur les
sauvegardes des prochaines nuits (À COMPLÉTER).
Defender et Wazuh ne font pas doublon. Defender est un antivirus : il reconnaît et bloque un fichier
malveillant sur la machine. Wazuh observe et alerte : il lit les journaux, compare les fichiers sensibles,
corrèle les événements, mais ne bloque pas un virus. Wazuh contient même 113 règles prévues pour lire les alertes de
Defender ; l’agent ne lit pas encore ce journal (Microsoft-Windows-Windows Defender/Operational) : piste pour
l’extension des agents (16.7).
49.2 Les disques des VM reviennent sur le NAS, le datastore part sur le stockage de 6 To (22-23/10)
Pourquoi : l’étape 44.1 avait placé tous les disques sur storage-images (miroir de 2 disques de 6 To,
« fatigués » selon le formateur). Les mesures ont montré qu’ils freinaient tout le lab : avant la migration, les VM
Linux passaient 10 à 40 % de leur temps processeur à attendre leur disque (iowait), jour et nuit ; après,
≈ 0 %, et le processeur est retombé à ≈ 2 % (Grafana, captures 97 et 98).
Décision d’Axel (22/10) : remettre les disques de toutes les VM sur Syno (le NAS de l’école, en NFS, plus
rapide), et placer le disque de données de PBS (le datastore, 500 Go) sur storage-images. Ainsi les VM et leurs
sauvegardes restent sur deux supports distincts.
VM
Disques après migration
toutes les VM du pool
disque système sur Syno (format qcow2)
poste-win11
efidisk0 et tpmstate0 (≈ 5 Mio) restés sur storage-images
srv-pbs (137)
système 32 Gio sur Syno ; datastore 500 Gio sur storage-images, toujours exclu de la sauvegarde (backup=0)
Méthode : Hardware → disque → Disk Action → Move Storage, « Delete source » décoché, une VM à la fois, VM
arrêtée (copie plus rapide) puis redémarrée. Deux leçons, consignées en incidents :
des déplacements lancés en parallèle échouent (verrou du stockage, délais dépassés) : H-41 ;
les nœuds Galera arrêtés l’un après l’autre sans attendre le retour du précédent ont arrêté tout le cluster :
site hors service ≈ 25 min, réparé depuis le nœud le plus avancé : H-39. Règle : un nœud à la fois, attendre
3 / Synced.
Après la migration, ajouter-machine.sh relancé sur les 10 machines Linux (correction H-40) : 21 cibles up.
Validation : nuit du 24/10, journal lu : TASK OK, chaque disque système sauvegardé est lu depuis Syno: ; datastore
monté et utilisé (Garbage Collection du 24/10 réussie).
49.3 Notifications de PBS par mail (tâche 13.7)
Contrainte : l’hyperviseur pve-01 est partagé avec d’autres élèves : décision d’Axel, aucune adresse ni
aucun webhook dans sa configuration. Les notifications partent donc de PBS.
cible mail-assistant, type SMTP : smtp.gmail.com, port 587, STARTTLS (incident H-43), compte Gmail d’envoi, mot de passe d’application dédié (dans Bitwarden, jamais dans la documentation)
Notification Matchers
vers-assistant : tout, vers mail-assistant
Notification Matchers
default-matcher (intégré, vers mail-to-root) désactivé : il essayait de livrer directement sur le port 25, bloqué (H-44)
Mails reçus depuis : Pruning (05:00) et Garbage Collect (06:00) chaque jour, Verify le samedi, et les alertes de
sécurité locales (par exemple un sudo refusé sur srv-pbs). PBS ne prévient pas pour les sauvegardes elles-mêmes :
elles sont lancées par l’hyperviseur. Leur suivi passera par une alerte « VM non sauvegardée depuis 26 h » (14.8).
49.4 Le gel des systèmes de fichiers pendant la sauvegarde
Avant de sauvegarder une VM allumée, Proxmox peut demander à son agent invité de geler les écritures, pour
obtenir une copie aussi propre qu’après un arrêt. Trois VM posaient problème :
VM
Constat
Décision
pfSense (103)
le gel échoue à chaque fois : Resource deadlock avoided (H-48)
gel désactivé (24/10)
poste-win11 (101)
gel de 3 min 30 la nuit du 26/10, dégel hors délai (H-47)
gel désactivé (27/10) : un poste client n’a pas de base à protéger
AD-Core-01 (107)
dégel hors délai 4 nuits sur 5 ; le 24/10, agent figé (H-47)
gel conservé : il garantit une base d’annuaire propre ; la sauvegarde réussit malgré l’erreur ; à surveiller
Ce que la supervision a montré : pendant toute la sauvegarde (02:00 → 02:24), toutes les VM Linux attendent leur
disque (2 à 22 % d’iowait), et pas avant. La sauvegarde charge donc elle-même le NAS, au moment où Windows doit
écrire son instantané.
49.5 Le ménage (tâche 13.12)
Quoi
Fait
Instantané Proxmox de AD-Core-01 (ancien, plus utilisé ; il ralentissait le disque)
supprimé le 24/10
Anciens disques « Unused » de toutes les VM (local, storage-images, Syno), y compris les disques partiels des déplacements en échec
supprimés le 27/10, après trois nuits de sauvegarde réussies sur les nouveaux disques ; les suppressions en erreur ont réussi au 2ᵉ essai, une par une (H-41)
VM 113 (SIO2527-Debian40-Axel, éteinte) et 128 (SIO2527-Debian-Axel : aucune adresse IPv4, 0,3 % de processeur, clone du modèle de l’école, aucun rôle)
supprimées le 27/10 (décision d’Axel)
Les disques « Unused » n’étaient pas dans les sauvegardes (skip unused drive … (not included into backup)).
Le pool SIO2527_Axel compte désormais 12 VM sauvegardées. Reste : supprimer dans PBS le groupe vm/128, que la
règle « 7 dernières » ne videra jamais seule (plus aucune nouvelle sauvegarde n’y arrive).
49.6 Bilan chiffré et estimation de la place
Nuit
Durée
VM
Remarque
24/10
02:00 → 02:41
13
toutes relues en entier (VM déplacées la veille)
25/10
02:00 → 02:28
13
Windows relues en entier (redémarrées le 24)
26/10
02:00 → 02:19
13
toutes incrémentales
Datastore (mails de PBS)
Place occupée
24/10
139,9 Gio
26/10
151,8 Gio (≈ +6 Gio par jour, facteur de déduplication 39,6)
Estimation : avec 7 sauvegardes quotidiennes conservées (plus un jour d’attente avant effacement), la place doit se
stabiliser vers 160 à 190 Gio, soit 35 à 40 % des 500 Go du datastore. À confirmer par la ligne « On-Disk
usage » des mails de Garbage Collection jusqu’au 02/11 : seulement 3 jours de recul, après une migration.
Validation : trois nuits TASK OK (journaux lus), Verify hebdomadaire réussi le 24/10, mails reçus chaque
jour, ménage fait.
Étape 50 — Grafana : l’écran de la supervision (phase 14, tâche 14.7)
Objectif : un seul écran pour voir l’état du lab (mesures de Prometheus) et interroger ses journaux (base syslog
du cluster Galera). Installé le 23/10, pris en main dans l’interface par Axel du 23 au 27/10. Le tableau de bord
de production est décrit à l’étape 52.
50.1 Installation sur srv-supervision
Élément
Valeur
Paquet
dépôt officiel apt.grafana.com (clé dans /etc/apt/keyrings/grafana.gpg) ; version : À COMPLÉTER (non relevée)
Écoute
10.0.30.15:3000 (port par défaut), jamais toutes les adresses
Réglages
variables GF_* ajoutées à /etc/default/grafana-server (original gardé en .orig, fichier en 600 car il contient un mot de passe)
Base de Grafana
dans le cluster Galera : GF_DATABASE_TYPE=mysql, hôte 127.0.0.1:3306 (le HAProxy local de l’étape 48), base et compte grafana, SSL_MODE=skip-verify + CA_CERT_PATH=/etc/ssl/certs/ca-certificates.crt (H-45)
Statistiques d’usage envoyées à l’éditeur
désactivées (GF_ANALYTICS_*=false)
Compte admin
mot de passe changé à la première connexion (Bitwarden)
Contrôle Galera : Galera exige une clé primaire sur chaque table pour répliquer correctement ; Grafana en crée
113, toutes en ont une (requête sur information_schema).
50.2 Les deux sources de données
Nom
Type
Adresse
Compte
prometheus
Prometheus
http://10.0.30.14:9090
aucun (réseau d’administration)
mysql
MySQL
127.0.0.1:3306, base syslog
grafana_lecture : lecture seule (SELECT), vérification TLS ignorée (même raison qu’en 50.1)
Test de chaque source : réussi.
50.3 Le tableau de bord d’exercice « Lab BTS — vue d’ensemble »
Construit à la main par Axel, dans l’interface (choix : savoir reproduire et exploiter des données, pas seulement
importer un tableau tout fait). C’est un tableau d’exercice, pas le livrable.
Panneau
Requête
Visualisation
État des machines
up{job=~"node|windows"}, légende {{host}}
Stat : 1 → « En ligne » vert, 0 → « Hors ligne » rouge
Processeur utilisé (%)
A : 100 - (avg by (host) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) · B : la même avec windows_cpu_time_total
série chronologique, 0-100 %, seuils 80 / 90
Dernières connexions
SQL sur syslog.journaux_auth, 50 dernières lignes de la période, sans les tests de disponibilité de Termix (NOT LIKE '%Connection closed by 10.0.30.12%[preauth]%', idem 172.19.0.3)
tableau
Événements de l’AD par type (24 h)
SUBSTRING_INDEX(message, ' :', 1), COUNT(*), GROUP BY, sur hote = 'AD-Core-01' — écrit seul par Axel
jauge à barres
Pourquoi le processeur se calcule ainsi : Linux ne fournit pas un pourcentage mais un compteur de secondes passées
dans chaque mode ; rate(…[5m]) en donne la vitesse sur 5 minutes (0,95 = 95 % du temps au repos), avg by (host) fait
la moyenne des cœurs, et 100 - … donne l’utilisation.
Pourquoi filtrer [preauth] et pas l’adresse du bastion : toutes les connexions d’administration viennent aussi
de 10.0.30.12 ; on n’exclut que le message du test (connexion fermée avant authentification), et on garde les
tentatives d’intrusion du type « invalid user … [preauth] ».
oui : 10 à 40 % avant la migration, ≈ 0 après (étape 49.2)
La sauvegarde charge-t-elle le stockage ?
iowait le 26/10 de 01:30 à 03:00
oui, 2 à 22 % de 02:00 à 02:24 (étape 49.4)
Que se passe-t-il depuis le bastion ?
messages contenant 10.0.30.12, regroupés
≈ 12 600 tests de Termix en 24 h ; 17 vraies connexions ; 2 mots de passe refusés (Failed password for ipfixe), ceux d’Axel la veille sur srv-ha
Combien d’événements produit l’AD ?
regroupement par EventID sur 24 h
≈ 24 000 : 4624 (ouverture de session) 8 192, 4634 (fermeture) 7 932, 4672 (droits d’administrateur) 6 479, 4648 (identifiants explicites) 1 236 → cause à chercher en 14.6
50.5 Les journaux passent en UTC
Grafana affichait les journaux avec 2 h d’avance : rsyslog écrivait l’heure de Paris, Grafana suppose de l’UTC.
Correction à la source (date.inUTC="on" dans /etc/rsyslog.d/30-reception-galera.conf, copie à jour dans
annexes/scripts/supervision/srv-supervision/), puis anciennes lignes
décalées de −2 h et preuve par une requête (0 ligne « dans le futur »). Détail : H-46.
50.6 Accès
Depuis le poste d’administration par Tailscale (http://10.0.30.15:3000). Grafana est aussi publié par Pangolin (ressource d’essai, voir dette T-12).
Validation : service active, base dans Galera (113 tables avec clé primaire), deux sources testées, 4 panneaux
qui affichent des données réelles, heure juste (captures 99 et 103). Le tableau de bord de production a été
construit les 27 et 28/10 (étape 52). Reste : les alertes (14.8).
Pourquoi : le 26/10, un élève du groupe a eu un problème d’heure sur ses VM. Une heure fausse casse le domaine
(Kerberos refuse les connexions au-delà de 5 minutes d’écart) et rend les journaux incomparables.
Comment : depuis le Shell de pve-01, par l’agent invité de chaque VM (sans SSH), en ne visant que les VM du
pool :
# Linux : nom, fuseau, synchronisation, heurefor ID in 106110114129130131132137139 140;do qm guest exec$ID -- sh -c 'printf "%-16s %-14s synchro=%s %s\n" "$(hostname -s)" "$(timedatectl show -p Timezone --value)" "$(timedatectl show -p NTPSynchronized --value)" "$(date "+%F %T %Z")"'| sed -n 's/.*"out-data" : "\(.*\)\\n".*/\1/p';done# Windows : nom, fuseau, heure, source d'heurefor ID in 101 107;do qm guest exec$ID -- powershell -NoProfile -Command "(hostname)+' '+(Get-TimeZone).Id+' '+(Get-Date -Format 'yyyy-MM-dd HH:mm:ss')+' source='+((w32tm /query /source) -join '')"| sed -n 's/.*"out-data" : "\(.*\)".*/\1/p';done# pfSenseqm guest exec103 -- date
(La partie Linux a été faite le même soir depuis le bastion, en SSH, avec le même résultat.)
Résultat (26/10, 21 h 24-21 h 26) :
Machine
Fuseau
Source d’heure
Résultat
10 VM Linux
Europe/Paris, CET
pfSense (zones WEB et BDD, étape 48.6) ou serveurs publics
NTPSynchronized=yes partout
fw-01 (pfSense)
CET
serveurs de temps d’Internet
AD-Core-01
Romance Standard Time (nom Windows de Paris)
10.0.30.1 (pfSense)
poste-win11
Romance Standard Time
AD-Core-01
La chaîne de temps est celle d’une entreprise : pfSense → contrôleur de domaine → postes, et les serveurs sur
pfSense. Le passage à l’heure d’hiver (25/10) s’est fait partout. Le constat de l’étape 48.7 (« l’AD n’a pas de source
d’heure fiable ») n’est plus d’actualité.
Validation : 13 machines contrôlées, toutes à la même heure à quelques secondes près (temps de saisie), aucune
correction nécessaire.
Étape 52 — Le tableau de bord de production, les exporteurs PBS et Proxmox, et le ménage dans les journaux (phase 14, tâche 14.7)
Objectif : un tableau de bord d’administrateur qui répond, d’un coup d’œil, à trois questions : le lab rend-il
son service et est-il protégé ? · quelle machine souffre, et de quoi ? · qui essaie d’entrer, et que s’est-il passé ?
Construit les 27 et 28/10, bloc par bloc, chaque bloc validé par Axel avant le suivant.
Méthode retenue (guides de Stéphane Robert sur Grafana) : un tableau, trois sections repliables ; en haut de chaque
section l’état, dessous les tendances, en bas le détail ; unités explicites ; vert / orange / rouge de même sens partout ;
méthode USE (utilisation, saturation, erreurs) pour les machines ; seuils fixés au moment de chaque panneau, en
reprenant des valeurs d’usage courant, justifiées dans la description de chaque panneau (le « i »).
Comment il a été construit : Axel a créé le tableau, ses variables et le premier panneau dans l’interface ; la suite a
été appliquée par l’API de Grafana, avec un compte de serviceclaude de rôle Editor (il modifie les tableaux,
ni les comptes ni les sources), jeton à durée limitée (7 jours), rangé dans Bitwarden et dans un fichier du poste
d’administration lu sans jamais être affiché. Avant chaque envoi, l’ancienne version était sauvegardée ; Grafana garde
aussi l’historique des versions (62 versions le 28/10).
52.1 L’exporteur de Proxmox Backup Server (fraîcheur des sauvegardes)
Élément
Valeur
Outil
natrontech/pbs-exporterv0.9.4, archive vérifiée par somme de contrôle, binaire /usr/local/bin/pbs-exporter sur srv-metriques
Compte sur PBS
metriques@pbs + jeton exporteur, rôle Audit (lecture seule) ; secret dans Bitwarden et dans /etc/default/pbs-exporter (600)
Écoute
10.0.30.14:10019 ; service systemd sous un utilisateur dédié, avec protections (ProtectSystem=strict…)
Prometheus
job pbs, relevé toutes les 60 s
Mesures utilisées
pbs_snapshot_vm_last_timestamp (date de la dernière sauvegarde de chaque VM), pbs_used / pbs_size (datastore)
52.2 L’exporteur de Proxmox VE (ressources réglées des VM)
Pourquoi : les machines ne voient que ce que Proxmox leur laisse (ballooning) ; pour savoir ce que le lab réserve
sur l’hyperviseur, il faut la valeur réglée dans Proxmox. Axel avait d’abord écarté cet exporteur (« PBS seul, PVE
jamais » : l’hyperviseur est partagé avec d’autres élèves) ; il est revenu sur cette décision le 27/10 en imposant le
moindre privilège.
Élément
Valeur
Outil
prometheus-pve-exporter3.10.2 (pas de paquet Debian 13) : environnement Python isolé /opt/pve-exporter, utilisateur système pve-exporter
Où il tourne
sur srv-metriques : il interroge l’API de pve-01 (10.1.0.253:8006) à distance ; rien n’est installé sur l’hyperviseur
Compte sur pve-01
metriques-axel@pve + jeton exporteur (séparation des privilèges décochée : le jeton hérite des droits de l’utilisateur)
Droits
rôle PVEAuditor (lecture seule) sur /pool/SIO2527_Axel et sur /vms/137 (srv-pbs, hors du pool) : l’exporteur ne voit aucune VM des autres élèves (vérifié)
Configuration
/etc/prometheus/pve.yml (640 root:pve-exporter) ; secret saisi par read -rsp, jamais affiché ; modèle sans secret : pve.yml.exemple
Écoute
10.0.30.14:9221 ; service pve-exporter.service
Modules coupés
status, node, cluster, qdevice, backup-info : ils lisent l’état de tout l’hyperviseur et exigent Sys.Audit sur / (H-50). On garde resources
Prometheus
job pve, paramètres cluster=1, node=0 (rien n’est lu sur l’hyperviseur lui-même)
Flux
srv-metriques → 10.1.0.253:8006 : déjà permis par la règle ADM n°6 (ADM subnets → any), aucune règle ajoutée (test : 200)
Validation : up{job="pve"} = 1 ; 13 VM visibles (12 du pool + 137), mémoire réglée totale 36 Gio le 28/10.
52.3 Deux nouvelles sondes : les accès distants
Sonde
Cible
Ce qu’elle prouve
sonde_termix
http://10.0.30.12:443/ (module http_2xx_insecure)
le portail Termix répond
sonde_pangolin
https://grafana.pangolin.<domaine>/api/health (module http_2xx_grafana : certificat vérifié, et la réponse doit contenir "database": "ok")
toute la chaîne : internet → serveur Pangolin → tunnel → connecteur sur srv-docker → Grafana
Pour que la sonde Pangolin traverse l’authentification, une règle d’accès de la ressource Grafana dans Pangolin
laisse passer le seul chemin /api/health (action « toujours autoriser », correspondance « chemin »). Contrôle de
sécurité : /, /login, /api/healthx et /api/health/../search répondent toujours 401. Contrepartie acceptée :
la version de Grafana devient publique (dette T-12).
52.4 Le tableau « Lab BTS — Production »
Période par défaut : 30 derniers jours. Variables : zone et host (filtres de la section Machines), et deux
variables cachées qui servent à répéter une ligne de panneaux par service (service) et par VM sauvegardée (vm).
Section Services — « le lab rend-il son service, et est-il protégé ? »
Bloc
Contenu
Seuils
Disponibilité « à la Pangolin »
une ligne par service (DNS de l’AD, DNS de pfSense, PBS, site web, Termix, Pangolin) : nom, une case par jour sur 30 jours, moyenne sur 30 jours
vert ≥ 99,9 % (1 min 26 s de panne par jour), orange ≥ 99 % (14 min 24 s), rouge en dessous
État actuel + temps de réponse
OK / EN PANNE par service ; temps de réponse du site
0,5 s / 1 s
Cluster Galera
nœuds dans le cluster (3/3), état de chaque nœud (Synchronisé…), nœuds synchronisés dans le temps
3 vert, 2 orange (quorum tenu), 1 rouge
Sauvegardes
une ligne par VM : une case par jour (sauvegarde faite ce jour-là), et « OK » / « KO · 1 nuit » / « KO · 2 nuits + » pour la nuit dernière ; place occupée et remplissage du datastore
sauvegarde de plus de 26 h = KO ; datastore 80 % / 90 %
Section Machines — « quelle machine souffre, et de quoi ? » (filtres Zone et Machine)
Bloc
Contenu
Seuils
En ligne
une case par machine : démarrée depuis (jours) ; INJOIGNABLE si l’exporteur ne répond plus
orange si redémarrée depuis moins d’une heure
Processeur
maintenant (barres) et dans le temps
80 % / 90 %
Mémoire
total du lab et tableau par machine : réglée (Proxmox), vue par la VM, utilisée (sans le cache disque), %
80 % / 90 %
Disques
total du lab et tableau : réglé, utilisé, %, plein dans (jours, au rythme des 7 derniers jours)
temps moyen d’une lecture ou écriture, Linux et Windows (échelle logarithmique)
20 ms / 50 ms
Section Journaux et sécurité — « qui essaie d’entrer, et que s’est-il passé ? » (SQL sur la base syslog)
Bloc
Contenu
Seuils
Connexions refusées
refus sur 24 h, par jour et par machine, détail (heure, machine, compte, origine, message) : Failed password (SSH) et 4625 (Windows)
1 orange, 10 rouge
Comptes inconnus, événements graves
Invalid user (SSH), 4740 (compte verrouillé), 4771 (Kerberos), 1102 (journal effacé), avec détail
rouge dès 1
Connexions réussies
24 h et détail : SSH (clé ou mot de passe), ouvertures de session Windows sur place, déverrouillage, bureau à distance
information, sans seuil
Volume de journaux
lignes reçues sur la dernière heure, par machine ; lignes par jour (échelle logarithmique)
rouge à 0 (machine muette)
Les techniques à retenir (détail dans le MO-17) :
Difficulté
Solution
Une case « par jour » regardait la veille (Prometheus calcule à minuit sur les 24 h précédentes)
avg_over_time(…[1d] offset -1d) : chaque case regarde sa propre journée (H-51)
Aligner le nom, la barre des jours et le % sur une même ligne
une variable cachée et l’option Répéter de Grafana : une ligne de panneaux par valeur
Afficher « Proxmox Backup Server » au lieu de sauvegarde, sans toucher à l’historique
label_replace dans la requête, à l’affichage seulement
Relier une VM de Proxmox (SIO2527-W11-Axel) à sa machine (poste-win11)
label_replace + jointure on(id) group_left(host)
Une machine qui tombe disparaît au lieu de passer au rouge
… or on(host) (up == 0) - 1 : elle reste affichée, en INJOIGNABLE
Des séries anciennes sans étiquette (Value, doublons)
filtre host!="" et regroupement max by (host) (H-52)
Le compte Windows illisible dans le détail
Windows écrit « Nom du compte : » avec une espace insécable : lecture par expression régulière (H-54)
52.5 Ce que le tableau a révélé, et ce qui a été corrigé
Constat
Cause
Correction
srv-supervision : ≈ 26 000 lignes de journaux par jour depuis le 23/10
le contrôle de santé de Pangolin demandait la page d’accueil de Grafana toutes les 5 s (réponse 302, journalisée) : 17 227 lignes ; plus les lignes « info » de Grafana
contrôle de santé sur /api/health (réponse 200, non journalisée) ; GF_LOG_LEVEL=warn dans /etc/default/grafana-server (copie .avant-log) (H-53)
pfSense : ≈ 80 000 lignes par jour
57 600 annonces CARP du réseau de l’école (vers 224.0.0.18) bloquées et journalisées par la règle par défaut ; 17 200 requêtes du contrôle de santé de Pangolin sur l’interface web (nginx journalise tout)
règle WAN en tête « Bruit CARP du réseau de l’école : bloqué sans journal » (le blocage par défaut reste journalisé) ; contrôle de santé de Pangolin pour pfSense en TCP (H-53)
srv-supervision : mémoire à 95 % par moments
ballooning : Proxmox lui reprenait de la mémoire (1,6 Gio vus sur 2), Grafana en occupe ≈ 760 Mio
mémoire minimum = 2048 Mio (VM 140)
srv-supervision « plein dans 60 jours »
fausse alerte : l’installation de Grafana du 23/10 (+2,2 Gio) comptée comme un rythme ; depuis, 25 à 40 Mio par jour
aucune (la prévision se corrige seule)
Latence disque de 100 ms à 1 s du 21 au 24/10
stockage saturé pendant la migration des disques
retombée à 1 à 10 ms après l’étape 49.2
Poste Windows : 6 Gio réglés, ≈ 1,7 Gio utilisés
surdimensionné
réglé à 4 Gio (minimum 2 Gio) le 28/10
Test de bout en bout (28/10) : un ssh [email protected] depuis le bastion et deux mauvais mots de passe sur
l’écran de connexion de poste-win11 sont apparus en moins d’une minute dans les blocs « refus » et « comptes
inconnus » (comptes tototest, test, admin), puis la connexion réussie (admin, ouverture de session de type 2).
L’audit Windows des échecs fonctionne : aucune stratégie de groupe à ajouter.
Validation : chaque bloc affiche des données réelles et a été validé par Axel ; les seuils sont visibles ; les
filtres Zone et Machine filtrent ; les tests SSH et Windows remontent ; les deux corrections de bruit sont mesurées dans
la base minute par minute (CARP à 0 depuis 10:10 UTC, contrôles Pangolin à 0 depuis 10:15 UTC le 28/10).
Reste : compte lecteur formateur et export JSON du tableau (fin du lab), alertes (14.8).
Étape 53 — Réduire la mémoire et les disques surdimensionnés (28/10 - 01/11)
Contexte — le tableau de production (étape 52) montrait ≈ 34 Gio de mémoire réglés pour ≈ 10 utilisés, et
838 Gio de disques réglés pour ≈ 122 utilisés. L’hyperviseur pve-01 est partagé avec les autres élèves : rendre
ce qui ne sert pas est une question de bonne conduite, et une configuration bien dimensionnée se justifie devant un jury.
Objectif — ramener chaque VM à ce qu’elle utilise réellement, plus une marge, sans perte de données ni panne
longue, une VM à la fois.
53.1 La mémoire
Mesure (Prometheus, 7 jours, sauvegardes de nuit comprises) : mémoire utilisée vue par le système invité (sans le
cache, qui se libère tout seul), comparée à la mémoire réglée dans Proxmox.
0,52 / 0,58 Gio (10 jours, vérification du samedi comprise ; 5,68 Gio en comptant le cache)
écart volontaire à la recommandation de PBS (4 Gio) : 0,6 Gio mesurés au plus ; seul le cache diminue, d’où un nettoyage et une vérification peut-être plus lents. Durées à comparer pendant une semaine, retour à 3 Gio si elles s’allongent nettement ou si une sauvegarde échoue
poste-win11 (101)
6 Gio
4 Gio (minimum 2 Gio)
1,87 / 2,97 Gio
réduit par Axel (étape 52.5)
srv-web-01/02 (110, 130)
1 Gio
1,5 Gio puis 2 Gio (29/10)
0,6 / 0,9 Gio
augmenté : ils étaient à 90 % de leur 1 Gio, et accueilleront peut-être GLPI
Méthode : VM → Hardware → Memory → Edit, puis Shutdown et Start depuis Proxmox (une ligne orange =
modification en attente : un redémarrage depuis l’intérieur de la VM ne suffit pas).
Validation — node_memory_MemTotal_bytes : srv-ha 967 Mio, srv-docker 2971 Mio, srv-pbs 3914 Mio ; toutes les
sondes à 1. Bilan : 34 → 30 Gio réglés (le 29/10 : PBS −2 Gio, serveurs web +1 Gio chacun, total inchangé ; VM redémarrées une par une, site resté en ligne).
Avec un minimum (ballooning) à 2 Gio, Proxmox peut reprendre de la mémoire à PBS si l’hyperviseur en manque :
si les sauvegardes de nuit ralentissent ou échouent, remonter ce minimum (bloc « Sauvegardes » du tableau).
53.2 Les disques : état des lieux et choix
VM
Réglé
Utilisé
Système de fichiers
srv-docker (114)
150 Gio
6,3 Gio
ext4 (sda1) + swap (sda5), MBR, BIOS
srv-mysql-01/02/03 (106, 129, 131)
100 Gio chacun
2,6 Gio chacun
ext4 (sda1)
poste-win11 (101)
100 Gio
33 Gio
NTFS
AD-Core-01 (107)
64 Gio
13 Gio
NTFS
les 6 VM à 32 Gio
32 Gio
2 à 6 Gio
laissées telles quelles (décision d’Axel : « assez large »)
datastore de PBS
491 Gio
174 Gio
laissé : il grossit chaque nuit
À savoir avant de décider : les disques sont des fichiers qcow2 sur le NAS Syno (étape 49.2). Ce format ne
prend que la place réellement écrite (la sauvegarde de srv-docker le confirme : « backup is sparse: 135.55 GiB
total zero data »). Réduire la taille déclarée libère donc peu de place sur le NAS ; elle rend surtout la
configuration juste. Constat : l’ancien disque de srv-docker n’avait pas l’option Discard : les fichiers
supprimés dans la VM n’étaient jamais rendus au NAS.
Décision d’Axel : réduire quand même (configuration bien dimensionnée), en commençant par srv-docker.
Pourquoi pas « réduire en place » : Proxmox ne sait pas réduire un disque ; il faudrait rétrécir la partition depuis
un système autonome, puis le fichier qcow2 en ligne de commande sur l’hyperviseur partagé. Méthode retenue, plus sûre :
ajouter un disque plus petit, y recopier le système, démarrer dessus. L’ancien disque n’est jamais modifié :
c’est le retour en arrière.
53.3 srv-docker : 150 → 32 Gio
Sauvegarde : VM 114 → Backup → Backup now, stockage pbs-lab-axel, mode Snapshot → TASK OK (14:23).
Nouveau disque : Hardware → Add → Hard Disk : SCSI 1, Syno, 32 Gio, qcow2, Discard et IO thread cochés
(SCSI : branché à chaud ; la VM le voit après echo "- - -" | sudo tee /sys/class/scsi_host/host*/scan).
Partitions et formatage (dans la VM, sur sdb uniquement) :
sudo mkdir -p /mnt/neuf && sudo mount LABEL=racine /mnt/neuf
Recopie par un script/root/migrer-disque.sh, lancé par sudo systemd-run --unit=migrer-disque /bin/bash /root/migrer-disque.sh : il tourne détaché de la session, ce qui compte ici puisque arrêter Docker coupe Termix,
par lequel on est connecté. Il écrit tout dans /root/migrer-disque.log et, en cas d’erreur, s’arrête et relance
Docker (trap … ERR). Étapes : vérifier que /mnt/neuf est monté (mountpoint -q, ajouté après l’incident H-56) ;
arrêter Docker ; rsync -aAXHx --exclude=/mnt/neuf / /mnt/neuf/ ; remplacer les UUID de sda1 et du swap par ceux du
nouveau disque dans sa copie de /etc/fstab (et de initramfs-tools/conf.d/resume) ; chroot dans le nouveau
système pour grub-install /dev/sdb, update-grub, update-initramfs -u ; puis poweroff.
Démarrer sur le nouveau disque (SSH sur pve-01) :
qm set114 --boot order=scsi1
qm start 114
Retour en arrière prévu : qm set 114 --boot order=scsi0.
6. Débrancher l’ancien disque : Hardware → scsi0 → Detach → il devient Unused Disk 0 (fichier gardé sur le NAS).
Validation (28/10, 16:50) — findmnt / → /dev/sdb1 (étiquette racine, 31 Gio, 6,3 Gio utilisés) ; swap sur
sdb2 ; journal terminé par TERMINE OK et 23 entrées GRUB sur le nouveau disque ; les 7 conteneurs Up (Termix
healthy) ; sondes Termix et Pangolin à 1 ; node_filesystem_size_bytes de srv-docker = 30,3 Gio.
01/11 : après 4 jours sans incident, contrôle (findmnt / → /dev/sdb1 ; lsblk : seul le disque de 32 Gio est
monté), puis Unused Disk 0 → Remove dans Proxmox : les 150 Gio sont libérés.
Décision d’Axel (01/11) : la réduction des disques des 3 nœuds Galera (100 → 32 Gio) est abandonnée, ainsi
que celle des VM Windows : les disques restent tels quels.
Incident : H-56 (la copie qui se recopie dans elle-même).
Étape 54 — Les alertes par mail, et leurs tests (phase 14, tâches 14.8 et 14.9 ; test de bascule 7.10)
Contexte — le tableau de production (étape 52) ne sert que si quelqu’un le regarde. Objectif — que Grafana
prévienne par mail : tout de suite pour une panne, en regroupé pour un risque qui monte, et jamais pour un pic
passager. Chaque règle est prouvée par une panne provoquée ou un seuil abaissé.
smtp.gmail.com:587, STARTTLS obligatoire (GF_SMTP_STARTTLS_POLICY=MandatoryStartTLS, leçon de H-43)
Compte
compte Gmail d’envoi, mot de passe d’application dédié « Grafana Lab BTS » (16 caractères, sans espaces), entré par read -rsp, rangé dans Bitwarden (Grafana MDS - SMTP Gmail)
Expéditeur affiché
Grafana Lab BTS
Adresse publique
GF_SERVER_ROOT_URL=https://grafana.pangolin.<domaine>/ (copie .avant-rooturl) : sans elle, les liens des mails pointaient vers http://localhost:3000
Aucune règle pfSense ajoutée : la sortie de l’ADM vers Internet est déjà permise (règle ADM n°6).
54.2 Le circuit (construit par Axel dans l’interface)
Pièce
Valeur
Point de contact mail-axel
boîte de l’administrateur + une boîte de copie (même information en deux endroits) ; test « TestAlert » reçu
Politique par défaut
→ mail-axel
Chemin severite = critique
group wait 10s, group interval 5m, rappel 1h (escalade)
Chemin severite = avertissement
group wait 5m, group interval 30m, rappel 24h
Première règle, « Service injoignable », faite par Axel section par section ; aiguillage vérifié avec Afficher la
route (Politique par défaut → severite = critique).
54.3 Les onze règles (dossier Lab BTS)
Règle
Seuil · attente
Gravité
Test
Résultat
Service injoignable (6 services)
probe_success < 1 · 2m
critique
Termix arrêté 5 min
[FIRING] 13:58:11, [RESOLVED] 14:03:11
Machine injoignable (13 machines)
up < 1 · 2m
critique
exporteur de srv-ha arrêté 5 min
15:19:11 / 15:24:12
Galera incomplet
taille du cluster < 3 · 2m
critique
MariaDB arrêté sur srv-mysql-01 5 min
15:57:12 / 16:02:12
Sauvegarde trop ancienne (12 VM)
âge > 26 h · 10m
critique
seuil abaissé à 1 h
un seul mail [FIRING:12] 16:18:18 / 16:23:19
Disque presque plein (13 disques)
> 85 % · 15m
avertissement
seuil abaissé à 5 %
[FIRING:13] 17:25:27 / 17:55:26
Mémoire saturée (13 machines)
> 90 % · 15m
avertissement
seuil abaissé à 5 %
[FIRING:13] 09:15:29 / 09:45:29 (30/10)
Processeur saturé (13 machines)
> 90 % · 15m
avertissement
seuil abaissé à 0,1 %
[FIRING:13] 09:38:24 / 10:08:24
Datastore PBS presque plein
> 80 % · 30m
avertissement
seuil abaissé à 5 %
[FIRING:1] 10:16:21
Connexions refusées en rafale (base des journaux)
≥ 5 refus en 5 min sur une machine · 1m
critique
5 mots de passe faux en SSH vers srv-ha
[FIRING:1] 10:43:24 / 10:48:15 (30/10)
Supervision aveugle(nommée « (Prometheus) » jusqu’au 02/11, renommée après H-66)
Prometheus ne répond plus · 2m
critique
Prometheus arrêté 5 min
un seul mail [FIRING:1] 11:09:12 / 11:14:12
Site lent (contrat de service : réponse < 2 s)
temps de réponse > 2 s · 5m
avertissement
seuil abaissé à 0,05 s
[FIRING:1] 11:51:34
Machine injoignable : vrai arrêt de srv-web-02
critique
qm shutdown 130, 8 min
[FIRING:1] 10:42:25 / 10:52:15 ; le site reste servi
Absence de données (Prometheus répond, mais une mesure a disparu) : les règles passent en alerte. Erreur (Prometheus
ne répond plus) : seule la règle « Supervision aveugle » alerte, les autres restent silencieuses. Le premier essai,
où toutes alertaient sur erreur, envoyait 3 mails trompeurs (« Service injoignable », « Galera incomplet », « Machine
injoignable ») pour une seule cause : la supervision aveugle. Après correction : un seul mail, avec le bon diagnostic.
54.4 Le test de bascule 7.10
Pendant le test de « Galera incomplet », la sonde HTTPS du site est restée à 1 chaque minute : avec un nœud
arrêté, les deux autres ont servi le site. Le nœud est revenu en Synced, wsrep_cluster_size = 3. Test 7.10
réussi.
54.5 Ce que les tests ont appris
H-57 : la commande de panne lancée sur la mauvaise machine ; lire l’invite.
H-58 : une alerte d’avertissement plus courte que l’attente de groupe (5 min) ne produit aucun mail. C’est
voulu ; un test doit durer plus longtemps.
H-59 : une étiquette absente s’affiche « [no value] » ; {{ with … }} corrige.
H-60 : coupures de l’accès au lab depuis le poste d’administration (cause À COMPLÉTER).
H-61 : le 30/10 à partir de 09:30, le NAS de l’école répond 30 fois plus lentement (152 ms au lieu de 5 ms) :
toutes les VM ralentissent en même temps, sans que le lab en soit la cause.
H-62 : quand Prometheus tombe, plusieurs mails accusent à tort les services et les machines ; corrigé par la règle
« Supervision aveugle ».
Constat réel (30/10) : poste-win11 monte jusqu’à 95 % de mémoire entre 09:29 et 10:19 ; la règle passe en
Pending sans jamais tenir 15 minutes, donc aucun mail. Cause trouvée le 02/11 : le ballooning de Proxmox (H-67).
Validation — pour chaque règle testée, trois sources concordent : la mesure dans Prometheus, l’historique d’état
de la règle (Normal → Pending → Alerting → Normal) et les mails reçus. Détail et captures 118 à 129 ; test 7.13 (cloisonnement, 30/10) : poste-win11 → les trois nœuds en 3306 : refusé. Détail :
Preuve-alerte-termix-2026-10-29.md.
Procédure : MO-17-Grafana.md §11. Incidents : H-57
à H-62. Suite prévue : un second point de contact sur le chemin critique vers n8n,
pour ouvrir un ticket GLPI (phase 11).
Étape 55 — La zone Visiteurs : VLAN 50 et poste-visiteur (phase 15, 30/10 - 01/11)
Contexte — l’entreprise du contexte (GSB) a une zone « Visiteurs » : des invités qui n’ont droit qu’à Internet,
au DNS et au DHCP. Elle manquait au lab ; elle servira à la qualité de service (mission N4) et au VPN des visiteurs
(mission N1). Objectif — une cinquième zone, la plus fermée de toutes, avec un poste de test, et l’intégrer à tout
l’existant : supervision, journaux, alertes, sauvegarde.
55.1 Le réseau
Élément
Valeur
Pourquoi
VLAN
50 sur vtnet1 (interface VISITEURS, opt5, vtnet1.50)
même méthode que les quatre autres (étapes 7 et 10) ; vmbr1 transporte toutes les étiquettes, rien à changer dans Proxmox
Réseau
10.0.50.0/24, passerelle 10.0.50.1, sans passerelle amont
règle du lab : le 3ᵉ octet reprend le numéro du VLAN
DHCP
ISC DHCP, plage 10.0.50.100 → .199, DNS 10.0.50.1 seul, pas de domaine
RESEAUX_PRIVES couvre toutes les zones du lab et le réseau de l’école (10.1.0.0/16) en une ligne ; un alias Host(s) refuse un /8 (même piège que H-13)
Configuration de pfSense sauvegardée avant la modification ; interface up (capture 136), affectation du VLAN (capture 137).
55.2 Les cinq règles de l’onglet VISITEURS (dans l’ordre)
#
Action
Source
Destination
Port
Journal
Objet
1
Autoriser (TCP/UDP)
VISITEURS réseau
VISITEURS adresse
PORTS_DNS_NTP
—
résolution de noms et heure
2
Autoriser
poste-visiteur (10.0.50.200)
SRV_SUPERVISION
514
—
ses journaux vers la supervision (étape 48)
3
Rejeter
VISITEURS réseau
This Firewall
tout
aucune interface d’administration de pfSense, sur aucune de ses adresses
4
Rejeter
VISITEURS réseau
RESEAUX_PRIVES
tout
aucune zone du lab, ni le réseau de l’école
5
Autoriser
VISITEURS réseau
tout
PORTS_WEB
—
Internet (HTTP et HTTPS)
Les refus sont avant la sortie large : sinon la règle 5 laisserait passer le web interne. Le DHCP n’a pas besoin de
règle (pfSense l’autorise de lui-même sur une interface où le service est actif). Les mesures de srv-metriques vers le
poste passent déjà : elles partent de l’ADM, dont les règles visent LAB_NETS.
Erreur corrigée le 30/10 : la première version de la règle 1 était en TCP, port * : elle ouvrait
l’interface web de pfSense aux visiteurs, et bloquait le DNS (qui passe en UDP). Corrigée en TCP/UDP et
PORTS_DNS_NTP, et la règle 3 réactivée. Leçon : vérifier protocole et port de chaque règle, pas seulement les
adresses.
55.3 Le poste de test poste-visiteur
Élément
Valeur
VM
105SIO2527-poste-visiteur-Axel, pool SIO2527_Axel : Debian 13 sans interface graphique, 1 vCPU, 16 Gio
Réseau
vmbr1, étiquette 50 ; réservation DHCP 10.0.50.200 (sur l’adresse matérielle de la carte)
Installation
faite sur le VLAN 40 (les règles VISITEURS n’existaient pas encore, il fallait Internet), puis carte passée en VLAN 50
Agent QEMU
actif, vu par Proxmox (adresse affichée dans Summary)
Accès
hôte Termix par clé SSH ; mot de passe SSH interdit (/etc/ssh/sshd_config.d/10-cle-seulement.conf : PasswordAuthentication no, vérifié par sudo sshd -T) ; la clé des scripts du bastion déposée avant la fermeture (dette T-15)
ssh-copy-id échoue une fois le mot de passe interdit (il en a besoin pour se connecter) : la clé a été ajoutée
avant, à la main, par une session Termix déjà ouverte. Toujours valider le nouvel accès avant de fermer l’ancien.
55.4 Les tests (tâche 15.6)
Test depuis poste-visiteur
Attendu
Résultat
bail DHCP, résolution d’un nom externe
adresse 10.0.50.200, nom résolu
curl -I https://… vers Internet
réponse
HTTP/2 200
pfSense, HAProxy, Galera, Termix, RDP de poste-win11, hyperviseur de l’école
refus immédiat
6 refus, chacun dans le journal du pare-feu avec la description de la règle 3 ou 4
up{host="poste-visiteur", zone="VISITEURS"} = 1 ; 11 lignes de journaux dans la base dans l’heure
Grafana
aucune modification du tableau : le filtre Zone propose VISITEURS de lui-même
captures 132 à 135
Alertes
couvert par les règles par machine
« Machine injoignable » compte 14 machines
Sauvegarde
la tâche de nuit porte sur le pool : la VM y est entrée seule
sauvegarde du 01/11 à 02:13 ; PBS compte 13 VM
Validation — le poste obtient son adresse, sort sur Internet et se voit refuser toutes les autres zones,
journal du pare-feu à l’appui ; il apparaît dans la supervision, les alertes et la sauvegarde sans réglage
supplémentaire : c’est l’intérêt d’avoir construit chaque brique par zone et par pool.
Limite constatée : le bloc Journaux du tableau (requêtes SQL) ne suit pas les filtres Zone et Machine.
12/11 : la qualité de service de cette zone est en place et mesurée (tâche 15.11, étape 76).
Schéma mis à jour (schemas/Infrastructure-TP.drawio, page 1 : VLAN 50 ; page 7 nouvelle : supervision, journaux et
alertes telles que construites) :
12/11 : la zone est aussi joignable par Tailscale. Jusque-là, fw-01 n’annonçait au tailnet que les quatre premiers
réseaux : la zone VISITEURS n’était joignable que par le bastion. depuis le 12/11, fw-01 annonce les 5 réseaux : 10.0.10.0/24, 10.0.20.0/24, 10.0.30.0/24, 10.0.40.0/24 et 10.0.50.0/24 (VISITEURS), ajouté par Axel dans VPN → Tailscale → Settings → Advertised Routes puis approuvé dans la console (Edit route settings) ; vérifié depuis le poste d’Axel : poste-visiteur (10.0.50.200) joignable sur le port 22 par l’interface Tailscale (captures 271, 272). Conséquence assumée : le tailnet
atteint aussi la zone invités (dette T-6, §5.4).
Étape 56 — Les journaux : durée de conservation, bruit filtré à la source, purge automatique (phase 14, tâche 14.6, 30/10 - 01/11)
Contexte — les journaux de toutes les machines s’accumulent dans Galera depuis le 21/10 (étape 48), sans limite.
Objectif — décider combien de temps les garder (et le justifier), réduire ce qui ne sert à rien, et supprimer
automatiquement le reste.
56.1 Mesurer d’abord (48 h)
≈ 60 Mo par jour au total, dont 32 Mo pour AD-Core-01 : environ 24 800 événements de sécurité par jour.
Le détail par compte montre que l’essentiel vient des comptes machine (nom terminé par $ : le contrôleur et le
poste qui parlent à l’annuaire) et du compte Système au démarrage des services Windows.
56.2 La durée : 6 mois
Référence
Ce qu’elle dit
CNIL (recommandation sur la journalisation)
conserver les traces de 6 mois à 1 an
ANSSI, guide de journalisation (§3.4.5, recommandations R24 à R26)
reprend cette durée et demande de fixer une politique de conservation
Décision d’Axel : 6 mois pour les deux tables (journaux et journaux_auth), ce qui suffit pour remonter le fil
d’un incident et reste dans la fourchette.
56.3 Le bruit filtré à la source (Fluent Bit, script Lua)
Deux filtres dans windows-vers-syslog.lua, sur les événements 4624 (ouverture de session), 4634 (fermeture) et 4672
(privilèges) :
Filtre
Événements écartés
Effet mesuré
1
ceux des comptes machine (nom terminé par $)
− 50 %
2
ceux du compte Système quand un service démarre (ouverture de type 5, et ses privilèges 4672)
≈ 10 % de plus ; plus aucun de ces événements après le redémarrage de l’agent (01/11, ≈ 19:25)
Restent tous les échecs (4625), les identifiants explicites (4648), les comptes humains et les événements graves
(4740 verrouillage, 1102 journal effacé). Script déployé sur AD-Core-01 et poste-win11, agent redémarré :
configuration validée (--dry-run : configuration test is successful) puis service relancé, Running sur les deux.
Filtrer à la source plutôt que dans la base : ce qui n’est pas envoyé ne coûte ni réseau, ni réplication
Galera, ni sauvegarde. Et on filtre ce qu’on sait inutile, jamais un échec de connexion.
56.4 La purge automatique
Pièce
Valeur
Compte MariaDB
[email protected], droits SELECT et DELETE sur syslog seulement (mot de passe dans Bitwarden)
Connexion
/etc/purge-journaux.cnf (600 root) sur srv-supervision : le mot de passe n’apparaît jamais dans une commande
Script
/usr/local/sbin/purger-journaux.sh (750 root) : supprime ce qui a plus de 180 jours, par paquets de 5 000 lignes (une suppression géante bloquerait la réplication sur les 3 nœuds), utilise l’index idx_recu ; mode SIMULATION=1 qui compte sans supprimer
Lancement
purger-journaux.timer, chaque nuit à 04:30 (après les sauvegardes de 02:00), Persistent=true
Incident : H-63 (le fichier de connexion créé sur la mauvaise machine).
Procédures : MO-15 (conservation et purge),
MO-16 (filtres Lua).
Étape 57 — L’accès du formateur aux machines par Termix (01/11)
Contexte — le formateur a un compte Termix (profsio2527), mais aucun hôte n’y apparaissait : chaque compte Termix
a ses propres hôtes. Objectif — qu’il puisse ouvrir une session sur les machines du lab sans voir les secrets.
Réglage
Valeur
Pourquoi
Partage
les dossiers d’hôtes du lab, partagés par sio2527 au compte du formateur
un partage suit les ajouts au dossier
Niveau
Connect
ouvrir une session, sans voir ni modifier les réglages, les mots de passe ou les clés
Authentification
chaque hôte partagé utilise des identifiants enregistrés de Termix
une authentification saisie directement dans l’hôte n’est pas transmise : le formateur obtenait « no password provided » (H-65)
pve-01
non partagé
c’est l’hyperviseur de l’école, ouvert par la clé root d’Axel
Pendant les essais, pve-01 a aussi refusé la clé d’Axel : la clé n’était plus dans le fichier des clés autorisées de
l’hyperviseur depuis le 15/10 (H-64) ; Axel l’a redéposée lui-même, après une copie du fichier.
Validation — depuis le compte du formateur, les hôtes partagés s’ouvrent (constaté par Axel le 01/11) ; ses
réglages et secrets ne sont pas visibles.
Étape 58 — Test 7.11 : la perte de quorum du cluster Galera (02/11)
Contexte — le test 7.10 (29/10) a montré qu’avec un nœud perdu sur trois, le site reste servi. Objectif —
prouver l’autre face du quorum : avec deux nœuds perdus, le survivant refuse d’écrire plutôt que de risquer deux
bases qui divergent (split-brain).
58.1 La méthode : débrancher, pas arrêter
Un systemctl stop mariadb est un départ annoncé : les survivants recalculent la majorité entre eux et restent
Primary, même à un seul (H-39 l’avait montré). Pour perdre le quorum, il faut que les nœuds disparaissent sans
prévenir : on débranche leur carte réseau dans Proxmox (link_down=1), ce qui imite une panne de réseau.
MO-2 §7.4, qui disait d’arrêter les nœuds, est corrigé.
Exécution depuis pve-01 (accès d’Axel), après lecture de la ligne net0 de chaque VM, en ne touchant qu’aux VM
129 (srv-mysql-02) et 131 (srv-mysql-03) : d’autres élèves ont des VM aux noms proches sur cet hyperviseur.
(idem pour 131 avec sa propre adresse matérielle ; retour : la même commande sans link_down=1). La lecture de l’état
de srv-mysql-01 et l’essai d’écriture passent par l’agent QEMU (qm guest exec 106 -- mariadb -e "…"), le seul
chemin encore ouvert vers la zone BDD pendant la panne.
58.2 Le déroulé
Heure
Étape
Constat
13:24:34
avant
3 nœuds Primary, taille 3 ; sonde du site à 1
13:24:56
cartes de 129 et 131 débranchées
13:25:16
état de srv-mysql-01
taille 1, non-Primary, wsrep_ready OFF
13:25:19
CREATE DATABASE test_quorum;
refusé : ERROR 1047 (08S01): WSREP has not yet prepared node for application use
13:25:27
site, Prometheus
https://10.0.10.5/ → 503 ; sonde du site 0 ; up des nœuds 2 et 3 à 0
13:27:12
mail
[FIRING:1] Supervision aveugle (Prometheus), seule alerte (voir 58.4)
13:28:08
cartes rebranchées
13:28:17
état des 3 nœuds
3 / Primary / Synced / ON partout ; test_quorum n’existe nulle part
13:28:32
site, Grafana
200 ; API de Grafana de nouveau joignable ; les 11 règles en bonne santé à 13:28:44
Validation — écritures refusées sans majorité, et retour automatique dès que la majorité est revenue,
sans réamorçage (galera_new_cluster inutile) : le cluster a préféré l’indisponibilité à l’incohérence.
Panne totale : 3 min 12 s.
58.3 Ce que le site a fait
HAProxy a vu les trois nœuds inutilisables et a répondu 503 aussitôt : le site est indisponible, mais il n’a
écrit aucune donnée qui aurait pu diverger. C’est l’engagement attendu d’un cluster à quorum, à énoncer tel quel dans un
contrat de service.
58.4 Le constat : la supervision tombe avec le cluster (H-66)
La base de Grafana est dans Galera. Sans quorum, Grafana ne lit plus sa configuration : toutes les règles passent en
erreur, et seule « Supervision aveugle (Prometheus) » prévient, avec un résumé qui accuse Prometheus à tort. La
vraie cause (Error 1047) n’est que dans le détail du mail. L’alerte est quand même partie, ce qui prouve que la panne
n’est pas passée inaperçue.
Décisions d’Axel (02/11) :
la base de Grafana reste dans Galera : utiliser le cluster fait partie des exigences du projet ;
le risque est donc accepté : à la perte de 2 nœuds sur 3, on perd aussi la supervision (dette T-16) ;
la règle est reformulée (fait le 02/11, même identifiant fg2s1yw8nfi0we, toujours Alerting sur erreur) :
titre « Supervision aveugle (Grafana ne calcule plus les alertes) », résumé « lire le champ Error », et une
description qui donne les deux causes possibles : Prometheus muet, ou Error 1047 … WSREP = base de Grafana
indisponible (perte de quorum), avec quoi vérifier dans chaque cas.
Pistes étudiées :
Piste
Effet
Coût
Renommer et reformuler la règle, et citer les deux causes possibles (Prometheus muet ou base de Grafana indisponible)
le mail dit vrai
fait le 02/11
Base de Grafana hors du cluster (SQLite locale sur srv-supervision, sauvegardée par PBS)
les alertes survivent à une panne de Galera, et « Galera incomplet » se déclenche
écartée : la base dans Galera est une exigence du projet
Alerte de secours hors Grafana (Alertmanager de Prometheus sur srv-metriques) pour le cluster et le site
un second chemin indépendant
non retenue pour l’instant (risque accepté, T-16) ; piste d’amélioration si la supervision se perd trop souvent en production
Plus de votants dans le cluster : 5 nœuds, ou un arbitre Galera (garbd, il vote sans stocker les données)
il faut alors perdre 3 votants pour perdre le quorum
piste d’amélioration (idée d’Axel), même condition ; nombre impair obligatoire : avec 4 nœuds, en perdre 2 bloque encore les écritures
Incident : H-66. Procédure : MO-2 §7.4.
Utile aussi pour l’exercice d’incident de la S7 (7.14) : c’est un cas réel de diagnostic trompeur.
Étape 59 — Wazuh : le serveur de détection d’intrusion et ses premiers agents (phase 16, 02-03/11)
Contexte — la supervision (phases 14 et 15) répond à « est-ce que ça marche ? ». Elle voit une panne et une rafale de
mots de passe faux ; elle ne voit ni un fichier système modifié, ni un compte créé en douce, ni un balayage réseau.
Objectif — être prévenu d’une attaque, pas seulement d’une panne (demande d’Axel du 30/10, mission N4).
Choix fait le 02/11 après comparaison de Wazuh, Suricata et CrowdSec : Wazuh (serveur tout-en-un + agents sur les
machines) et Suricata (sonde réseau, paquet pfSense, étape 60) ; CrowdSec écarté (doublon de Wazuh). Le détail du
choix est dans le dossier de choix.
Deux regards complémentaires. Wazuh regarde dans les machines (fichiers, comptes, journaux, configuration) ;
Suricata regarde le réseau (les paquets qui traversent le pare-feu). Ni l’un ni l’autre ne suffit seul.
59.1 La machine virtuelle srv-wazuh (tâche 16.2)
Élément
Valeur
Pourquoi
VM
113SIO2527-srv-wazuh-Axel, pool SIO2527_Axel, 4 vCPU
le minimum officiel de Wazuh est 8 Gio pour 1 à 25 agents : essai assumé à 6 Gio, l’hyperviseur partagé de l’école étant à 81 % de sa RAM (dette T-17, §5.1) ; pas de ballon : un programme Java dont Proxmox reprend la mémoire plante (H-67)
Disque
64 Go sur le NAS (Syno)
Wazuh demande ≥ 20 Go libres dans /var/ossec (base de vulnérabilités ≈ 11 Go)
Système
Ubuntu Server 24.04.5, sans interface graphique
Debian n’est pas dans la liste des systèmes supportés par Wazuh ; installée depuis l’ISO 22.04.5 présente sur pve-01, puis montée en 24.04 par do-release-upgrade
Réseau
vmbr1, étiquette 30 ; IP fixe 10.0.30.16/24, passerelle et DNS 10.0.30.1
zone ADM : serveur d’infrastructure, même VLAN que la supervision
Compte
ipfixe (membre de sudo), mot de passe dans Bitwarden
convention du lab
Agent QEMU
actif, adresse vue par Proxmox
après activation de l’option dans Proxmox et un arrêt/démarrage (un redémarrage ne suffit pas, H-69)
Deux pièges de l’installeur Ubuntu, consignés en H-68 : le champ « Masque de sous-réseau » attend en réalité le
réseau (10.0.30.0/24), et le partitionnement LVM par défaut ne donne que la moitié du disque à la racine
(31 Go sur 64) : agrandie après coup (lvextend + resize2fs, racine à 61 Go, MO-18 §4.0).
Décision d’Axel (03/11) : le formateur n’est pas prévenu de l’ajout de 6 Gio sur pve-01 (la question posée
le 02/11 est retirée). La VM peut être éteinte en dehors des séances si l’hôte souffre.
59.2 L’intégration à l’environnement, avant d’installer quoi que ce soit (tâche 16.2 bis)
C’est la règle d’Axel pour toute nouvelle machine (02/11, modèle : étape 55.5, pas à pas dans le
MO-18) : si la VM casse pendant l’installation de Wazuh, on la
retrouve dans la supervision et dans la sauvegarde.
Point
Ce qui a été fait (03/11)
Preuve
(a) Termix par clé
clé Termix (identifiant ipfixe) et clé des scripts du bastion déposées ; hôte Termix créé et partagé au formateur ; mot de passe SSH interdit
sudo sshd -T → passwordauthentication no ; depuis srv-metriques : Permission denied (publickey)
(b) mesures et journaux
ajouter-machine.sh 10.0.30.16 depuis le bastion : node_exporter 9100, rsyslog vers srv-supervision:514
up{host="srv-wazuh", zone="ADM"} = 1 ; 39 lignes de journaux dans la base dans l’heure
(c) Prometheus et tableau
la machine apparaît dans le bloc Machines du tableau de production, sans réglage
—
(d) alertes
couverte par les règles par machine : « Machine injoignable » passe à 15 instances
capture 146
(e) sauvegarde
la tâche de nuit porte sur le pool : la VM y entre seule
nuit du 03 au 04/11 : À VÉRIFIER (PBS doit compter 14 VM)
(f) inscription
adressage du cerveau, registre des comptes, §2.5 ci-dessus, schéma (page 1 et page 7)
fait
Schéma mis à jour (schemas/Infrastructure-TP.drawio, page 1 : srv-wazuh dans la zone ADM, Suricata sur les sous-interfaces USERS et VISITEURS) :
59.3 L’installation tout-en-un (tâche 16.3)
Wazuh se compose de trois services : le manager (reçoit et analyse les événements des agents, règles de détection),
l’indexeur (OpenSearch, qui stocke et indexe les alertes : c’est lui qui pèse en mémoire) et le tableau de bord
(l’écran web, port 443). L’installeur officiel les pose tous les trois sur la même machine (« tout-en-un »).
Étape
Ce qui a été fait
Constat
Téléchargement
wazuh-install.sh de la version 4.14 (215 Ko) ; en-tête lu avant de lancer (c’est un script téléchargé qui tourne en root)
—
Lancement
sudo bash wazuh-install.sh -a
aucun blocage sur la mémoire : l’option « ignorer le contrôle matériel », prévue en cas de refus, n’a pas servi
Services
wazuh-manager, wazuh-indexer, wazuh-dashboard
tous trois actifs (systemctl status)
Mot de passe admin
généré par l’installeur, rangé dans Bitwarden (Wazuh - admin) ; l’archive des mots de passe internes (wazuh-install-files.tar) déplacée dans /root en 600
aucun secret dans un dossier lisible
Dépôt apt
désactivé (#deb …) après l’installation
recommandation officielle : une mise à jour non préparée casserait l’accord de version entre serveur et agents
Tas Java de l’indexeur
déjà réglé à 1 Gio par l’installeur (-Xms1024m -Xmx1024m dans /etc/wazuh-indexer/jvm.options)
gardé tel quel : c’est moins que les 1,5 Gio prévus au cadrage ; bootstrap.memory_lock : À VÉRIFIER
Mémoire juste après
2,2 Gio utilisés sur 5,8 ; java 1,24 Go ; swap 265 Mio
le swap est le signal à suivre pendant la semaine de mesure (59.7)
Tableau de bord
https://10.0.30.16 (certificat autosigné), compte admin
connexion réussie
Accès externe
ressource Pangolinwazuh.pangolin.<domaine> (cible https10.0.30.16:443, contrôle de santé TCP, état Sain, protégée par l’authentification de Pangolin) ; vérifié en navigation privée : page « Authentification requise »
même modèle que Grafana (étape 50.6) ; ajoutée à la dette T-12
Pourquoi le mot de passe d’inscription. Par défaut, n’importe quelle machine qui atteint le port 1515 peut
s’inscrire comme agent. Un faux agent pourrait polluer les alertes ou lire la configuration poussée par le serveur.
Le serveur exige désormais un mot de passe d’inscription : /var/ossec/etc/authd.pass (640 root:wazuh, saisi par
read -rsp, rangé dans Bitwarden) et <use_password>yes</use_password> dans ossec.conf (copie
ossec.conf.avant-authd gardée). Journal du manager : « Using password specified on file ». Premier essai : une
vérification grep -A3 trop courte avait laissé croire que l’option manquait (H-71).
59.4 Le pare-feu : un flux par zone, vers le seul serveur Wazuh (tâche 16.4)
Chaque agent parle au serveur sur deux ports TCP : 1514 (envoi continu des événements, chiffré) et 1515
(enrôlement : inscription et remise de la clé, une fois). Même modèle que les journaux (514) : une destination, deux
ports, une règle par zone, avant les rejets. En ADM, rien à faire (même VLAN). La sortie Internet d’ADM (règle 6,
any) suffit aux dépôts et au flux de vulnérabilités.
WEB subnets → SRV_WAZUH : PORTS_WAZUH, TCP, en tête de l’onglet
149
Règle BDD
BDD subnets → SRV_WAZUH : PORTS_WAZUH : seconde exception assumée à « la base n’initie rien » (même logique que les journaux)
150
Règle USERS
USERS subnets → SRV_WAZUH : PORTS_WAZUH : les postes gérés du domaine
151
Règle VISITEURS
10.0.50.200 seul (le poste de test), pas VISITEURS subnets
152
Moindre privilège, décision d’Axel (03/11) : les appareils des invités ne sont pas gérés et n’auront jamais
d’agent. Ouvrir 1515 à toute la zone permettrait à un invité d’inscrire un faux agent ou d’attaquer le serveur qui
surveille le lab. Erreur corrigée au passage : la première version de cette règle avait USERS subnets comme
source, copiée de l’onglet voisin ; depuis le poste visiteur, 1514 était refusé immédiatement (le rejet
journalisé, donc la règle au-dessus ne correspondait pas). Leçon de B-05, encore : une source qui n’est pas dans le
VLAN de l’onglet est une règle morte (H-70).
Tests : 1514 et 1515 ouverts depuis srv-web-01, srv-mysql-01, poste-visiteur et poste-win11 (nc -zv,
Test-NetConnection). Matrice de flux à jour.
La règle VISITEURS avant correction (source USERS subnets, H-70), puis corrigée (10.0.50.200) :
59.5 Les agents, déployés par script (tâche 16.5)
Trois scripts dans scripts/securite/, dans l’esprit d’ajouter-machine.sh (idempotents,
aucun secret dedans) :
Script
Où il tourne
Ce qu’il fait
ajouter-agent-wazuh.sh
le bastion, compte ipfixe
vérifie que l’adresse est dans une zone autorisée (en BDD : rappelle d’ouvrir puis refermer la règle Internet temporaire), lit le nom de la machine, demande le mot de passe d’inscription une seule fois pour toutes les machines passées en argument, le transmet par SSH dans un fichier temporaire 600 effacé aussitôt lu, puis lance l’installeur sur la cible
installer-wazuh-agent.sh
la machine Linux, en root
dépôt officiel Wazuh (clé GPG vérifiée par apt), agent dans la version du serveur (4.14.9-1 figée : un agent plus récent serait refusé), inscription par les variables WAZUH_MANAGER, WAZUH_AGENT_NAME, WAZUH_REGISTRATION_PASSWORD, dépôt désactivé ensuite, attente de l’état connected (jusqu’à 60 s)
installer-wazuh-agent.ps1
la machine Windows, PowerShell administrateur
télécharge le MSI 4.14.9-1, vérifie l’empreinte SHA-512 publiée par Wazuh (sinon : installation annulée), demande le mot de passe d’inscription (jamais affiché), msiexec /q, attend l’état connected
Les scripts ont été déposés sur les machines par l’agent QEMU (empreintes vérifiées à l’arrivée). Deux corrections au
premier essai, consignées en H-72 et H-73 : le script Linux n’attendait que 10 s et annonçait un échec alors que
l’agent était inscrit (il lit maintenant l’état officiel wazuh-agentd.state) ; sous Windows, le fichier .sha512
était reçu comme un binaire.
Les trois premières machines (une par type, avant d’étendre) :
Agent
Machine
Zone
Identifiant
État
Linux
srv-ha
WEB
001
Active
Windows Server Core
ad-core-01
ADM
002
Active
Windows 11
poste-win11
USERS
003
Active
(sudo /var/ossec/bin/agent_control -l sur srv-wazuh.) Le pas à pas pour une nouvelle machine est le point (b bis)
du MO-18 (§4.3 Linux, §5.5 Windows).
59.6 Les premiers tests de détection (tâche 16.10, avant l’envoi par mail)
Trois attaques simulées, lancées par l’agent QEMU de Proxmox, alertes lues dans /var/ossec/logs/alerts/alerts.json sur
srv-wazuh (heures en UTC, soit Paris − 1 h) :
Test
Action
Alerte Wazuh
Délai
A · fichier système modifié
une ligne de commentaire ajoutée à /etc/hosts.allow sur srv-ha (retirée ensuite), vérification d’intégrité relancée
règle 550 « Integrity checksum changed », niveau 7
3 s
B · compte créé en douce
net user testwazuh … /add puis /delete sur poste-win11
60109 « User account enabled or created » et 60111 « User account disabled or deleted », niveau 8 (plus 60110, 60170)
immédiat
C · force brute SSH
10 connexions SSH d’un compte inexistant vers srv-ha, depuis le bastion, aucun mot de passe envoyé
5710 × 10 (niveau 5), puis 5712 « sshd: brute force trying to get access to the system », niveau 10
2 s
Deux obstacles de test, sans rapport avec Wazuh : net user refusait le mot de passe de test tant que la question
« plus de 14 caractères ? » n’avait pas de réponse (H-74), et testmynids.org, le site de test habituel, a expiré (H-75).
Bruit constaté : ad-core-01 produit en continu des « Windows Logon Success / User Logoff » de niveau 3 (comptes
machine qui parlent à l’annuaire, le même bruit qu’en étape 56). Sous le seuil des mails prévu (niveau ≥ 10) : à
filtrer si l’écran devient illisible.
Validation — trois attaques simulées, trois détections en quelques secondes, la plus grave (force brute)
au niveau 10 ; 3 agents Active ; chaque zone n’atteint que SRV_WAZUH sur 1514 et 1515 ; le serveur refuse tout
agent sans mot de passe d’inscription. L’envoi par mail fait l’objet du 59.8.
59.7 La semaine de mesure (tâche 16.6, du 03/11 au 10/11)
Mesure
Départ (03/11)
Fin (10/11)
Mémoire utilisée de srv-wazuh (sur 5,8 Gio)
2,3 Gio
À COMPLÉTER
Swap utilisé
265 Mio juste après l’installation, 631 Mio en fin de journée
À COMPLÉTER
Place de /var/ossec
À COMPLÉTER
À COMPLÉTER
Charge de pve-01 (lecture seule)
81 % de RAM le 02/11
À COMPLÉTER
Décision à prendre le 10/11 : étendre les agents à tout le lab, ou repli (CrowdSec + Suricata, ou Wazuh sans
indexeur). Le swap qui monte dans la journée est le point d’attention.
Le bruit, filtré le 04/11. Une journée d’alertes (alerts.json du 04/11 : 14 067 alertes, 96 % de niveau 3)
montrait que presque tout venait de trois sources sans intérêt pour la sécurité, sur ad-core-01 et poste-win11 :
Source
Volume constaté
Pourquoi c’est normal
ouvertures/fermetures de session des comptes machine (AD-CORE-01$, POSTE-WIN11$, nom terminé par $), type 3 (réseau)
≈ 7 700 par jour
un poste du domaine parle sans cesse à son contrôleur (stratégies, Kerberos)
comptes sshd_<numéro> (créés, ouverts, fermés)
≈ 2 500 par jour et par machine, environ toutes les 100 s
OpenSSH sous Windows crée un compte virtuel à chaque connexion sur le port 22, même sans authentification ; origine probable : les contrôles de Termix (statut ou métriques, À VÉRIFIER)
ouverture de session du compte Système, type 5 (service)
≈ 450 par jour
un service Windows qui démarre
Quatre règles locales de niveau 0 (niveau 0 = Wazuh analyse l’événement mais ne crée pas d’alerte) ont été
ajoutées à la fin de /var/ossec/etc/rules/local_rules.xml, après copie du fichier (local_rules.xml.avant-bruit) ;
source : scripts/securite/bruit-windows-local_rules.xml.
Règle
Fait taire
Condition
100210
60106 (ouverture), 60137 (fermeture)
compte cible terminé par $
100211
67023, 67024 (comptes créés ou activés)
compte cible sshd_<numéro>
100212
67028 (privilèges spéciaux)
compte à l’origine sshd_<numéro>
100213
60106
type 5 et compte Système (ou SYSTEM)
Vérifié avec wazuh-analysisd -t (configuration valide) avant le redémarrage, puis mesuré sur 15 minutes avant et
15 minutes après le redémarrage (15:37 UTC) :
Règle
Avant
Après
60106 ouverture de session
48
10
60137 fermeture de session
58
9
67023 / 67024 compte sshd_
20 / 20
0 / 0
67028 privilèges spéciaux
20
9
Total
173
43 (− 75 %)
Ce qui reste après le filtre : uniquement des comptes humains (Administrateur sur ad-core-01, admin sur
poste-win11) et un ticket Kerberos. C’est voulu : une connexion d’administrateur doit rester visible. Les échecs
de connexion (règle 60122) ne sont touchés par aucune des quatre règles. Prouvé le 04/11 à 16:59 : connexion LDAP
sur AD-Core-01 avec un compte inexistant (test-echec-wazuh, pour ne verrouiller aucun vrai compte) → événement
Windows 4625 à 16:59:11 → alerte Wazuh 60122, niveau 5 à 16:59:12. Piège rencontré : H-80.
59.8 Prévenir par mail (tâche 16.10, 03/11)
Contexte — Wazuh détecte, mais il faut ouvrir son tableau pour le savoir. Objectif — qu’une intrusion grave
arrive par mail, par le même circuit que les pannes (point de contact, chemins critique et avertissement), sans
second canal ni nouveau mot de passe d’envoi.
Le choix. Grafana aurait pu lire l’indexeur de Wazuh, mais celui-ci n’écoute que sur la machine elle-même
(9200 fermé au réseau, réglage de l’installation tout-en-un) : l’ouvrir aurait demandé de refaire ses certificats.
Plus simple : Wazuh sait envoyer ses alertes en syslog, filtrées par niveau, et srv-wazuh envoie déjà son
journal à srv-supervision.
wazuh-analysisd ── alerte niveau ≥ 10, ou règle 60109 / 5902 (création de compte)
      │  wazuh-csyslogd (syslog_output)
      ▼
rsyslog de srv-wazuh, 127.0.0.1:514 (UDP, local seulement)
      │  envoi déjà en place de tout le journal (ajouter-machine.sh), TCP 514
      ▼
srv-supervision ──► base des journaux (Galera, conservée 6 mois)
      │
      ▼
règle Grafana « Intrusion détectée (Wazuh) », critique ──► circuit de mails existant
Réglage (sur srv-wazuh)
Valeur
Copie avant modification
/etc/rsyslog.d/10-wazuh-local.conf
module(load="imudp") + input(type="imudp" address="127.0.0.1" port="514") : rien d’ouvert au réseau
— (fichier nouveau)
ossec.conf, 1er bloc syslog_output
<level>10</level>, vers 127.0.0.1:514
ossec.conf.avant-syslog
ossec.conf, 2e bloc syslog_output
<rule_id>60109,5902</rule_id> : créations de comptes Windows et Linux (niveau 8), décision d’Axel
ossec.conf.avant-comptes
Les deux fichiers sont dans scripts/securite/ (10-wazuh-local.conf,
ossec-syslog-output.xml). Contrôles : rsyslogd -N1 → End of config validation run, wazuh-csyslogd -t → valide,
wazuh-control status → wazuh-csyslogd is running....
Dans la base, une alerte arrive ainsi : hote = srv-wazuh, programme = ossec, message
Alert Level: 10; Rule: 5712 - sshd: brute force…; Location: (srv-ha) …. La règle Grafana « Intrusion détectée
(Wazuh) » (dossier Lab BTS, groupe critiques, attente 1 min, absence de données = normal) compte ces messages sur
15 minutes, par agent (extrait de Location: (…)) et par règle (texte après Rule:), et alerte au-delà de 0.
Pourquoi 15 minutes et pas 5 (H-77) : quand deux intrusions arrivent l’une après
l’autre, la seconde attend l’envoi groupé suivant (5 minutes). Avec une fenêtre de 5 minutes, elle était déjà « résolue »
à ce moment-là : mail [RESOLVED] sans [FIRING]. La fenêtre doit être plus longue que l’envoi groupé.
Seuil retenu (décision d’Axel) : niveau 10 pour tout, plus les créations de comptes. Un fichier système
modifié (niveau 7) reste visible dans le tableau Wazuh seulement : une mise à jour en modifie beaucoup, un mail à chaque
fois noierait les vraies alertes.
Validation
Test (03/11)
Attendu
Résultat
force brute SSH vers srv-ha (10 essais, compte inexistant), 18:19:47
mail [FIRING] avec l’agent et la règle
[FIRING:1] à 18:21:16 (« srv-ha 5712 - sshd: brute force… »), 1 min 29 s (capture 167)
compte créé puis supprimé sur poste-win11 et srv-ha, 18:24-18:25
un mail pour chacun
poste-win11 à 18:26:16, mais srv-ha seulement [RESOLVED] (H-77)
même alerte après la fenêtre portée à 15 min
les créations de comptes dans un mail [FIRING]
[FIRING:3] à 18:33:15 : poste-win11 60109, srv-ha 5902 et 5712 (capture 168)
Dans le tableau de production (version 63, 03/11) : un bandeau « Alertes en cours (toutes règles) » tout en haut (panneau Alert list : alertes actives ou en attente des 12 règles, vide quand tout va bien) ; dans la section Journaux et sécurité, une case « Intrusions Wazuh (24 h) » (rouge dès 1) et un tableau « Dernières intrusions détectées par Wazuh » (heure, machine, niveau, règle), sur la même base des journaux. Vérifié par l’API puis à l’écran : 5 intrusions en 24 h, les 5 alertes du jour listées, niveau en orange (8) ou rouge (10) ; le bandeau montre « Intrusion détectée (Wazuh) » Firing, 2 instances (captures 169 et 170).
Étape 60 — Suricata sur pfSense : la sonde réseau des zones VISITEURS et USERS (phase 16, tâche 16.8, 03/11)
Contexte — Wazuh (étape 59) voit ce qui se passe dans les machines équipées d’un agent. Il ne voit ni les
appareils des invités (jamais d’agent), ni un balayage, ni un exploit qui passe sur le réseau. Objectif — une
sonde de détection d’intrusion réseau (IDS) sur le pare-feu, par lequel tout trafic inter-zones passe, en
commençant par les zones les moins fiables : VISITEURS puis USERS. Mode détection seule : on alerte, on ne bloque pas.
60.1 Installation et réglages communs
Configuration de pfSense sauvegardée avant (Diagnostics → Backup). Paquet Suricata installé par
System → Package Manager.
état vert, Pattern Match AUTO, Blocking Mode DISABLED
161
Pourquoi EVE JSON. C’est le format d’export de Suricata (un événement par ligne, en JSON), gardé sur pfSense pour
l’enquête. Il n’est pas celui envoyé à Wazuh : le journal de pfSense coupe ses messages à 480 octets, une alerte
JSON en fait plus de 1 000. Wazuh reçoit le format court (60.6).
Pourquoi 7 catégories et pas tout. Chaque catégorie coûte de la mémoire sur un pfSense de 2 Gio, et des
catégories hors sujet (SCADA, VoIP, jeux, P2P…) ne produiraient que du bruit. Les 7 retenues couvrent les balayages,
les exploits, les réponses typiques d’une machine prise en main, les logiciels malveillants et les attaques web.
60.3 Le premier test, depuis poste-visiteur
La règle visée (lue dans les règles installées) : GPL ATTACK_RESPONSE id check returned root (sid 2100498), qui se
déclenche sur tout paquet contenant uid=0(root), la réponse typique d’une machine prise en main. Le site de test
habituel, testmynids.org, a expiré (H-75) : la phrase est envoyée à un service d’écho, qui la renvoie.
(lancé par l’agent QEMU depuis poste-visiteur, 10.0.50.200, à 16:08:19). Deux secondes plus tard, dans
/var/log/suricata/suricata_vtnet1.50…/alerts.log : 3 alertes, 2019284 « ET ATTACK_RESPONSE Output of id command
from HTTP server » et 2100498 (deux fois : la commande, notée dans le journal système du poste, est partie vers
srv-supervision:514, et Suricata l’a reconnue dans ce flux aussi).
60.4 L’interface USERS, et la mémoire de pfSense
Interface USERS (vtnet1.40) créée par duplication de VISITEURS (mêmes réglages, mêmes 7 catégories ; capture 163).
Démarrage : 22996 rules successfully loaded, 4 rules failed (4 règles ja3, empreinte TLS non activée dans cette
version : sans effet), moteur démarré après ≈ 50 s de chargement (un premier test lancé avant n’avait rien donné,
H-76). Test depuis poste-win11 (PowerShell, même phrase) : 2 alertes en 2 s (2019284, 2100498).
Mémoire de pfSense (2 Gio), node_exporter de fw-01
avant Suricata
VISITEURS seule
VISITEURS + USERS
mémoire libre
1 477 Mo
827 Mo
674 Mo
processus suricata
—
396 Mo
396 + 368 Mo
swap utilisé
0
0
0
60.5 La décision : option A, et la suite
Chaque interface coûte ≈ 370 à 400 Mo : les trois autres zones (WEB, BDD, ADM) ne tiennent pas dans les 2 Gio de
pfSense. Décision d’Axel (03/11) : on s’arrête à VISITEURS + USERS (option A), les deux zones où arrivent des
appareils non maîtrisés.
Option
Principe
Coût
Décision
A
une instance Suricata par zone surveillée : VISITEURS et USERS
≈ 770 Mo, mémoire libre 674 Mo
retenue le 03/11
A étendue
une instance par zone, sur les 5
≈ 2 Gio : impossible sans RAM supplémentaire
B
une seule instance sur le trunk vtnet1 (le lien parent des 5 VLAN) : tout le trafic inter-zones y passe
une instance (≈ 400 Mo) pour 5 zones ; à vérifier : Suricata voit-il les étiquettes 802.1Q, et peut-on encore attribuer une alerte à une zone ?
à tester plus tard
Règle fixée par Axel : si la mémoire de pfSense manque, il peut lui ajouter un peu de RAM ; au-delà de 2 Gio de
plus, on passe à l’option B. Les zones WEB, BDD et ADM restent sans sonde réseau en attendant (dette T-18, §5.1),
mais leurs machines auront un agent Wazuh (16.7).
Validation — deux interfaces en détection (Blocking Mode DISABLED), règles ET Open à jour toutes les 12 h,
7 catégories, EVE JSON écrit ; une phrase de test depuis chaque zone produit une alerte en 2 s ; pfSense garde
674 Mo libres et 0 swap. Reste : l’option B si le périmètre doit s’étendre. Les alertes vont à Wazuh depuis le 03/11 (60.6).
Schéma (page 7, « Supervision, journaux et alertes », complétée par la détection d’intrusion telle que construite) :
60.6 Les alertes de Suricata dans Wazuh, et par mail (tâche 16.9, 03/11)
Contexte — Suricata détecte sur pfSense, Wazuh sur les machines : deux écrans, et seul Wazuh sait prévenir par mail.
Objectif — que les alertes réseau arrivent dans Wazuh, et les plus graves par mail, sans rien installer sur le
pare-feu (aucun agent Wazuh officiel pour pfSense ; un paquet FreeBSD non officiel est déconseillé par Netgate sur
l’équipement le plus critique).
Suricata (pfSense) ── « Send Alerts to System Log », format court, local1
      │  pfSense envoie tout son journal à srv-supervision (UDP 514, déjà en place)
      ▼
srv-supervision ──► base des journaux (programme = suricata, 6 mois)
      │  rsyslog renvoie SEULEMENT les lignes « suricata »
      ▼
srv-wazuh 10.0.30.16:514/udp (réception syslog, depuis 10.0.30.15 seul)
      │  décodeur local « suricata-fast » + règles 100200 (niveau 6) / 100201 (niveau 10)
      ▼
syslog_output niveau ≥ 10 ──► base des journaux ──► règle Grafana « Intrusion détectée (Wazuh) » ──► mail
Réglage
Où
Valeur
Copie avant modification
Send Alerts to System Log
Suricata, interfaces VISITEURS et USERS
, Log FacilityLOCAL1, Log PriorityNOTICE ; puis redémarrer chaque interface
suricata-fast : signature, classification, priorité, protocole, adresses et ports
local_decoder.xml.avant-suricata
Règles
srv-wazuh, etc/rules/local_rules.xml
100200 niveau 6 (priorité 3) ; 100201 niveau 10 (priorité 1 ou 2) → mail
local_rules.xml.avant-suricata
Fichiers dans scripts/securite/ : suricata-local_decoder.xml, suricata-local_rules.xml,
31-reception-pfsense-ajout-wazuh.conf. Aucune règle pfSense : srv-supervision et srv-wazuh sont dans la même zone.
La règle Grafana et le tableau de production affichent ces alertes avec la machine « fw-01 (Suricata) ».
Pourquoi le format court. Le journal de pfSense coupe les messages à 480 octets (avertissement sous l’option) :
une alerte JSON (EVE) arriverait tronquée. Le format court ([1:2100498:7] GPL ATTACK_RESPONSE … {TCP} source -> destination)
tient dans la limite. Wazuh ne le reconnaît pas tout seul (No decoder matched, règle générique 1002 niveau 2) : d’où
le décodeur local, testé avec wazuh-logtest avant tout redémarrage.
Validation
Test (03/11)
Attendu
Résultat
alerte dans le journal de pfSense, puis dans la base
programme = suricata
18:49:16, après redémarrage de Suricata (un 1er essai n’avait rien donné : option prise en compte au redémarrage seulement, H-78)
wazuh-logtest sur une ligne réelle
décodeur suricata-fast, règle 100201 niveau 10
tous les champs extraits
uid=0(root) envoyé depuis poste-visiteur à 18:51:44
alerte Wazuh, puis mail
100201 niveau 10 à 18:51:45 ; [FIRING:1] Intrusion détectée (Wazuh) … fw-01 (Suricata) 100201 à 18:54:16, 2 min 32 s (capture 171)
À surveiller pendant la semaine de mesure : la priorité 2 envoie un mail. Si certaines signatures de priorité 2
s’avèrent bruyantes, les passer en exception dans local_rules.xml plutôt que de remonter le seuil pour toutes.
Étape 61 — Les stratégies de groupe (GPO) : deux GPO ordinateur, posées et prouvées en PowerShell (tâche 6.20, 05/11)
Objectif : poser les premières stratégies de groupe du domaine sio.internal (des réglages écrits une fois sur
le contrôleur et appliqués automatiquement par les postes), et prouver leur effet sur poste-win11 en PowerShell, par
SSH. Choix d’Axel (05/11) : pas de console graphique, trop lourde à lancer sur l’hôte du lab (disques mécaniques) ;
le contrôleur est en Server Core et n’en a de toute façon pas. D’où deux GPO de la moitié ordinateur, dont l’effet se
lit dans le registre et le pare-feu du poste.
GPO
Liée à
Contenu
Pourquoi
GPO-Ordi-Banniere-Connexion
OU=Ordinateurs,OU=SIO
HKLM\SOFTWARE\Microsoft\Windows\CurrentVersion\Policies\System : LegalNoticeCaption = « Acces reserve - Lab SIO », LegalNoticeText = « Ce poste appartient au lab SIO. Acces reserve aux personnes autorisees. Les connexions sont journalisees et analysees. »
avertissement légal avant l’ouverture de session : l’utilisateur est informé, l’intrus n’a pas d’excuse
GPO-Ordi-Pare-feu-Ping
OU=Ordinateurs,OU=SIO (ordre 2)
règle de pare-feu « Lab - Ping entrant (ICMPv4 echo) » : entrant, ICMPv4 type 8, depuis 10.0.0.0/16 seulement, profils Domaine et Privé, autoriser
la réponse au ping venait d’une règle activée à la main (E-04) : un poste neuf ne l’aurait pas ; la règle de GPO est aussi plus stricte (lab seulement)
Les GPO par défaut (Default Domain Policy, Default Domain Controllers Policy) ne sont pas modifiées : une GPO
par sujet, qu’on peut suspendre sans toucher au domaine. AD-Core-01 n’est pas concerné (il est dans
OU=Domain Controllers).
Commandes (sur AD-Core-01, ssh sio.internal\[email protected]) — détail et explications dans
MO-20 §4 et §5 :
Sur poste-win11 (ssh sio.internal\[email protected]) : gpupdate /force, puis les vérifications
ci-dessous. Pour que le test du ping prouve bien la GPO, les trois règles locales qui acceptaient déjà le ping ont
été désactivées (pas supprimées) : FPS-ICMP4-ERQ-In (profils Privé et Public, activée à la main lors d’E-04),
FPS-ICMP4-ERQ-In-V2 (tous profils) et FPS-ICMP4-ERQ-In-NoScope (Domaine), ces deux dernières actives d’origine non
retrouvée (H-82).
Validation (05/11)
Test
Attendu
Résultat
Get-GPInheritance sur OU=Ordinateurs avant
GpoLinks vide, Default Domain Policy héritée
11:15
Get-GPRegistryValue sur la GPO 1
2 valeurs PolicyState : Set ; ComputerVersion 0 → 2
11:17
registre du poste avant / après gpupdate /force
vide, puis titre et texte de la bannière
~11:22
gpresult /r /scope computer
GPO-Ordi-Banniere-Connexion appliquée depuis AD-Core-01.sio.internal
11:23:46
Get-NetFirewallRule -PolicyStore RSOP sur le poste
la règle de la GPO, True Inbound Allow
~11:30
-PolicyStore ActiveStore, règles d’écho actives, après désactivation des 3 règles locales
une seule, Domain, Private, GroupPolicy
~11:35
ping -c3 10.0.40.10 depuis srv-docker
0 % de perte
11:36:40, 3/3
écran de connexion du poste (console Proxmox, après déconnexion, Ctrl+Alt+Suppr)
fenêtre « Acces reserve - Lab SIO » avant le mot de passe
~11:55 (capture 185)
contre-épreuve : règle de la GPO rétrécie à 10.0.40.0/24, règles locales d’écho désactivées, ping depuis srv-docker (10.0.30.12)
refusé
12:01:41, 100 % de perte ; remise à 10.0.0.0/16 → 3/3 à 12:02:23 (capture 186)
Autres captures : 174 (création de la GPO 1), 175 (réglage), 177 (lien), 180 (GPO 2 et sa règle), 182 (règles du
poste avant isolement).
Un effet constaté ne prouve pas qu’une GPO fonctionne. Le ping passait déjà avant la GPO : deux règles locales
oubliées l’autorisaient. Seul le test fait après les avoir désactivées, avec une seule règle active venue de
l’annuaire, prouve que la réponse au ping vient de la GPO.
Non vérifié le 05/11 : ce qui reste écrit sur le poste quand une GPO est retirée.
La contre-épreuve prouve le filtre, pas seulement l’ouverture. Même source, même poste : le ping passe avec
10.0.0.0/16, il est refusé avec 10.0.40.0/24. Seule la plage a changé, c’est donc la règle qui décide. Un premier
essai avait répondu 3/3 : les règles locales avaient été réactivées entre-temps (H-82) ; pktmon sur le poste a
confirmé que le ping arrivait bien de 10.0.30.12, sans traduction d’adresse.
État final (05/11, 12:06) : les trois règles locales d’écho sont désactivées, décision d’Axel : la GPO est la seule source de la réponse au ping, limitée au lab. Vérifié : une seule règle d’écho active (GroupPolicy, 10.0.0.0/16), ping depuis srv-docker 3/3 à 12:06:13 (capture 194). (Entre 11:38 et 12:06, les règles locales avaient été réactivées par Axel, qui avait lancé la commande de retour arrière donnée dans les consignes : voir H-82.)
Retour arrière : suspendre une GPO sans la perdre, Set-GPLink -Name <GPO> -Target "OU=Ordinateurs,OU=SIO,DC=sio,DC=internal" -LinkEnabled No ;
pour le ping, rétablir aussi les règles locales sur le poste : Enable-NetFirewallRule -Name FPS-ICMP4-ERQ-In, FPS-ICMP4-ERQ-In-V2, FPS-ICMP4-ERQ-In-NoScope.
Mode opératoire : MO-20 GPO. Incident : H-82. Points du 08/10 sur le
poste (SSH en compte du domaine, ping) : clos le 05/11, voir SUIVI-TP.md phase 6.
Étape 62 — HAProxy ne garde que les nœuds Galera synchronisés : la sonde du port 9200 (tâche 10.23, 05/11)
Le problème — srv-ha (10.0.10.5) envoie WordPress vers le cluster Galera (mysql-01 principal, mysql-02 et
mysql-03 en secours). Jusqu’ici, il contrôlait chaque nœud avec option mysql-check : une connexion à MariaDB, sans
requête. Un nœud qui répond mais qui n’est pas synchronisé (en rattrapage après une panne, ou coupé du cluster)
passait ce contrôle : HAProxy pouvait lui envoyer l’application (MO-3 §6.3 l’annonçait comme limite).
La solution retenue — sur chaque nœud, une petite sonde HTTP sur le port 9200 qui répond 200 si
wsrep_local_state = 4 (Synced), 503 sinon ; HAProxy l’interroge (option httpchk, check port 9200) et retire
le nœud dès qu’elle ne répond plus 200. Plutôt que le script clustercheck habituel (à télécharger, avec xinetd et
un compte MySQL à mot de passe), un script d’une dizaine de lignes écrit pour le lab et servi par systemd :
Élément
Où
Rôle
/usr/local/bin/galera-etat.sh
les 3 nœuds
lit wsrep_local_state avec le compte root par le socket local (authentification unix_socket : aucun compte ni mot de passe créé) et répond en HTTP
galera-etat.socket
les 3 nœuds
écoute 9200 ; IPAddressAllow=10.0.10.5 127.0.0.1, IPAddressDeny=any : seul srv-ha (et la machine elle-même) peut l’interroger
SRV_HA → GALERA_NODES : 9200 (TCP), avant le Reject — posée par Axel
bloc listen galera
srv-ha
option httpchk, http-check expect status 200, check port 9200 sur les 3 serveurs ; copie haproxy.cfg.avant-clustercheck
Fichiers et installation : scripts/galera/ (galera-etat.sh, galera-etat.socket, [email protected],
installer-galera-etat.sh, à lancer en root sur chaque nœud). Configuration HAProxy appliquée :
    option httpchk
    http-check send meth GET uri /
    http-check expect status 200
    server mysql-01 10.0.20.10:3306 check port 9200
    server mysql-02 10.0.20.11:3306 check port 9200 backup
    server mysql-03 10.0.20.12:3306 check port 9200 backup
Validée par haproxy -c -f /etc/haproxy/haproxy.cfg avant un systemctl reload haproxy (pas de restart : les
connexions en cours sont gardées). Retour arrière : cp -p /etc/haproxy/haproxy.cfg.avant-clustercheck /etc/haproxy/haproxy.cfg && systemctl reload haproxy.
Validation (05/11)
Test
Attendu
Résultat
sonde en local sur chaque nœud
HTTP/1.1 200 OK, Synced
12:58, les 3
srv-ha → 10.0.20.12:9200avant la règle pfSense
refusé
12:59 « Connexion refusée » (Reject de l’onglet WEB)
srv-mysql-01 (non autorisé) → 10.0.20.12:9200
aucune réponse
délai dépassé (IPAddressDeny)
srv-ha → les 3 nœuds après la règle
200 OK ×3
13:15:22
HAProxy après rechargement
3 serveurs UP, contrôle L7OK
13:15:46 ; WordPress 200 ×3 à 13:16:05
SET GLOBAL wsrep_desync=ON sur srv-mysql-03 (MariaDB répond toujours, SELECT 1 → 1)
Ce que la sonde change : l’ancien contrôle répondait à « MariaDB tourne-t-il ? », le nouveau à « ce nœud
a-t-il les mêmes données que les autres ? ». C’est la seconde question qui compte pour une application : un nœud
qui tourne mais qui est en retard est pire qu’un nœud éteint, car il répond avec des données périmées.
Pourquoi wsrep_desync pour le test : la commande fait sortir le nœud de l’état Synced (il passe
Donor/Desynced, état 2) sans l’arrêter ni toucher aux données. C’est exactement le cas que mysql-check ne
voyait pas : MariaDB répond, mais le nœud n’est plus synchronisé.
Compte devenu inutile, supprimé (13:20, décision d’Axel, 5.2 H-5) : 'haproxy_check'@'10.0.10.5' ; celui de
srv-supervision (@10.0.30.15) sert toujours. HAProxy vérifié après : 3 nœuds UP.
Non regardé : les alertes Grafana
n’ont pas été regardées pendant la désynchronisation (17 s).
Étape 63 — Export SQL nocturne des bases du cluster, et test de restauration (tâche 13.8, 05/11)
Pourquoi, alors que PBS sauvegarde déjà les VM chaque nuit ? Une sauvegarde de VM restaure une machine entière
à l’état d’une nuit. Pour récupérer une base (une table effacée par erreur, un WordPress cassé), il faudrait
restaurer tout un nœud du cluster. Un export SQL (fichier texte de commandes CREATE / INSERT) se restaure base par
base, sur n’importe quel serveur MariaDB, en une commande. Les deux se complètent.
Choix
Valeur
Pourquoi
Où
srv-mysql-03 (10.0.20.12)
nœud de secours : HAProxy ne lui envoie rien, l’export ne ralentit pas le site ; 89 Go libres
Quand
chaque nuit à 01:30 (timer systemd export-bases.timer, Persistent=true)
juste avant la sauvegarde PBS de 02:00 : l’export du jour part avec la VM, sans autre copie à organiser
Quoi
wp_lab (site), grafana (tableaux de bord) et, depuis le 05/11 au soir, glpi (étape 66)
les données qui ont de la valeur ; syslog exclue (760 Mio de journaux qui grossissent chaque jour, déjà conservés par PBS)
Format
un fichier <base>-<date>_<heure>.sql.gz par base, sansCREATE DATABASE ni USE
se restaure sous n’importe quel nom (indispensable pour tester sans écraser la vraie base)
une photo cohérente des tables InnoDB sans les bloquer
Rétention
7 jours (find -mtime +6 -delete)
comme PBS
Accès
dossier /var/backups/mariadb en 700, fichiers en 600 (root) ; compte root par le socket local
aucun mot de passe stocké nulle part
Fichiers : scripts/sauvegarde/ (export-bases.sh, export-bases.service, export-bases.timer,
installer-export-bases.sh). Installation : copier le dossier sur le nœud, puis bash installer-export-bases.sh en root.
Restaurer une base (exemple : WordPress, sur un nœud, en root) — Galera recopie sur les deux autres :
premier lancement à la main (systemctl start export-bases.service)
2 fichiers, service terminé sans erreur
wp_lab 24 Ko, grafana 352 Ko
restauration de wp_lab dans wp_lab_test, comptage table par table
12 tables identiques
14:02:07, 12 identiques, 0 différente
nettoyage
wp_lab_test absente des 3 nœuds
0 sur srv-mysql-01, -02, -03
exécution automatique de la nuit
fichiers datés du 06/11 vers 01:30
À COMPLÉTER le 06/11 (journalctl -u export-bases.service)
Une sauvegarde n’existe que si sa restauration a été essayée. Le comptage des lignes, table par table, compare
la copie restaurée à l’originale : c’est ce qui prouve que le fichier est complet, et pas seulement qu’il existe.
Étape 64 — Le site WordPress devient le site de GSB : partie publique et intranet INTRALAB (05/11)
Pourquoi — Le lab répond au cas d’étude GSB (Galaxy Swiss Bourdin) du cours : la table de correspondance GSB
fait jouer au site WordPress le rôle d’INTRALAB, l’intranet de GSB. Demande d’Axel (05/11) : une page publique
qui présente l’entreprise, et un intranet. Le contenu vient uniquement de la fiche GSB du formateur
(fiche-gsb.md) : aucune adresse, aucun téléphone, aucun nom inventé ; chaque page porte la mention « site de
démonstration, contexte pédagogique GSB du réseau CERTA ».
Partie
Pages
Accès
Site public
Accueil (page d’accueil du site), Le laboratoire, La visite médicale, Contact
tout le monde
Intranet INTRALAB
Intranet, Les services du siège (services et VLAN de GSB), L’informatique du siège (serveurs REZOLAB, LABANNU…)
comptes connectés : pages privées WordPress ; le rôle « abonné » (un salarié) reçoit le droit read_private_pages
Comment — sans rien télécharger ni installer : un script PHP qui appelle les fonctions internes de WordPress
(wp_insert_post, update_option…), rejouable sans doublon ; une petite extension « obligatoire » (must-use plugin)
wp-content/mu-plugins/gsb-intranet.php qui envoie une personne non connectée vers la page de connexion (au lieu d’une
erreur 404) et retire le préfixe « Privé : » des titres. Réglages : titre « GSB — Galaxy Swiss Bourdin », slogan
« Laboratoire pharmaceutique », page d’accueil statique ; pied de page du thème remplacé (ses liens d’exemple Blog,
Boutique, FAQ… menaient nulle part) ; l’article et la page d’exemple de WordPress mis à la corbeille (récupérables).
Fichiers : scripts/site-gsb/ (construire-site-gsb.php, gsb-intranet.php). Retour arrière : restaurer l’export SQL
de wp_lab de 14:01 (étape 63) et retirer l’extension.
Validation (05/11)
Test
Attendu
Résultat
page d’accueil, avant / après
site de démonstration WordPress → site de GSB
captures 196, 197, 198
/, sans connexion, 2 requêtes (les 2 serveurs web)
200
14:14:46
/intranet/, /intranet/services/, /intranet/informatique/, sans connexion, ×2
302 vers la page de connexion
(captures 199, 201)
rôle « abonné »
peut lire les pages privées
read_private_pages
ouverture de l’intranet avec un compte abonné
pages lisibles
À COMPLÉTER : aucun compte salarié créé (mot de passe à mettre dans Bitwarden par Axel)
Incident découvert en chemin (H-84) : l’extension n’arrivait pas sur srv-web-02. lsyncd était arrêté
depuis le 29/10 (cible injoignable au démarrage, puis abandon), alors que systemctl l’affichait « active ». Corrigé
(insist = true, redémarrage, recopie prouvée par un fichier témoin, capture 200). Rien ne le surveillait : voir H-84.
écrit lsyncd_processus <nombre> dans /var/lib/prometheus/node-exporter/lsyncd.prom : le collecteur textfile de node_exporter (actif par défaut sous Debian) le publie sur le port 9100 avec les autres mesures
règle Grafana « lsyncd arrêté (recopie vers srv-web-02) »
dossier Lab BTS, groupe avertissements (13ᵉ règle)
max(lsyncd_processus{host="srv-web-01"}) < 1 pendant 5 min ; mesure absente = alerte aussi (le script ou l’exporteur en panne ne passe pas inaperçu) ; gravité avertissement : le site reste en ligne, mais srv-web-02 n’est plus à jour
Pourquoi un script plutôt que l’état du service : systemctl affichait « active » pendant la panne (H-84) ; seul le
processus dit la vérité. Règle créée par l’API de Grafana (compte de service claude), modifiable dans l’interface.
Fichiers : scripts/supervision/lsyncd-etat.sh, .service, .timer.
Test (05/11)
Attendu
Résultat
mesure dans Prometheus
lsyncd_processus{host="srv-web-01"} = 1
14:26
systemctl stop lsyncd à 14:27:04
Pending puis Alerting 5 min plus tard, mail
Pending 14:28:20, Alerting 14:33:20, mail [FIRING:1] lsyncd arrêté… reçu dans les 2 boîtes
systemctl start lsyncd à 14:42:29
retour à Normal
14:44:20
64.2 Retouches demandées par Axel (05/11, après-midi)
bouton renommé ; texte de l’intranet : « réservé aux collaborateurs connectés »
bouton en bas à droite
retiré du corps de l’accueil, placé dans le pied de page (à droite) : présent sur toutes les pages
une ou deux images
deux illustrations dessinées pour le lab (SVG rendu en PNG, aucune image téléchargée, donc aucun droit d’auteur) : verrerie de laboratoire en tête de l’accueil, schéma « siège, régions, visiteurs » sur la page La visite médicale ; ajoutées à la médiathèque avec un texte alternatif
Script rejouable scripts/site-gsb/ajuster-site-gsb.php (avec les deux images). Fichiers envoyés sur srv-web-01 par
l’entrée standard de l’agent invité (qm guest exec --pass-stdin), empreintes SHA-256 identiques des deux côtés ; les
images de wp-content/uploads sont recopiées vers srv-web-02 par lsyncd.
64.3 Un site « un peu stylé » (demande d’Axel, 05/11)
Sans extension ni thème téléchargé : les styles globaux du thème Twenty Twenty-Five reçoivent les couleurs de GSB
(bleu nuit #0b3d5c, turquoise #127a7a, fond clair #eef6f7) et des boutons arrondis ; un modèle front-page
affiche l’accueil sans le titre « Accueil » et en pleine largeur ; l’accueil est refait en sections : bannière avec
l’illustration en fond (bloc Couverture), bande de chiffres clés (2009, 480, 60), trois cartes (sièges, visite
médicale, ambition), bloc « Vous êtes collaborateur de GSB ? » vers l’intranet. Contenu toujours tiré de la fiche GSB.
Script rejouable scripts/site-gsb/styliser-site-gsb.php.
Pas de compte collaborateur à ce jour : seul le compte administrateur ipfixe existe. Un compte de rôle
Abonné (par exemple collaborateur) est à créer par Axel dans l’administration de WordPress, mot de passe généré et
rangé dans Bitwarden, puis à inscrire au registre des comptes.
Piste : se connecter à l’intranet avec les comptes de l’AD sio.internal (extension LDAP de WordPress, à
télécharger : décision d’Axel).
Étape 65 — Deuxième copie hors site des sauvegardes : un datastore S3 sur le NAS d’Axel (tâche 13.6, 05/11)
Pourquoi — Toutes les sauvegardes du lab sont sur un seul serveur PBS, dans l’école. Si l’école perd ce serveur
(panne, sinistre, erreur), il ne reste rien. La règle 3-2-1 demande au moins une copie hors du site. Décision
d’Axel (05/11) : la mettre sur son NAS personnel (TrueNAS), avec au plus 200 Gio.
Choix de la technique (décisions d’Axel, 05/11) :
Option
Retenue ?
Pourquoi
Monter le disque du NAS sur le PBS (sshfs, NFS)
PBS range ses sauvegardes en milliers de petits fichiers : à travers Internet, lent et fragile ; il aurait fallu exposer SSH ou NFS du NAS
Un second PBS chez Axel
une VM de plus à maintenir
Datastore S3 de PBS (stable depuis PBS 4.2, avril 2026) vers un serveur S3 sur le NAS
pas de VM en plus ; n’importe quel PBS peut rattacher le bucket pour restaurer (--reuse-datastore)
le S3 est exposé sur Internet par le reverse proxy (Nginx Proxy Manager) du NAS, en HTTPS
Côté NAS (fait par Axel, guidé) : dataset PataCloud/pbs-lab (preset Apps, quota 200 Gio, captures 202-203) ;
application SeaweedFS 1.2.49 (train stable), données des volumes dans /mnt/PataCloud/pbs-lab, S3 sur le port
30304 (captures 204-205) ; bucket pbs-lab et utilisateur S3 pbs-lab-ecole (droits Read, Write, List, Tagging sur
ce seul bucket ; clés lisibles dans l’interface d’administration de SeaweedFS, non copiées dans Bitwarden : décision d’Axel du 06/11) : après sa création, le S3 refuse tout accès sans clé (AccessDenied) ; hôte HTTPS
seaweedfs.pbs.<domaine-perso> (certificat Let’s Encrypt, DNS sans proxy Cloudflare) → <adresse du NAS>:30304.
Côté lab (fait par Claude, par l’agent invité) :
Élément
Valeur
disque de cache
VM 137 : scsi2, 64 Gio sur local (ajouté par Axel), ext4 étiqueté s3-cache, monté sur /mnt/datastore/s3-cache (/etc/fstab par UUID, nofail) ; la documentation de PBS demande un cache local dédié de 64 à 128 Gio
endpoint S3
seaweedfs-maison (déclaré par Axel dans l’interface : il a saisi les clés) : path-style true, région us-east-1, port 443 ; s3 check → code 0
15:13:50 (erreur 500, H-85) puis 15:19:47 après correction
synchronisation d’essai : VM 105, dernière sauvegarde
TASK OK
630 Mio, 483 morceaux, 25 Mio/s
verify s3-maison (relecture et contrôle de chaque morceau)
0 erreur
15:21:36, 0 errors
côté NAS : collection pbs-lab de SeaweedFS
les données arrivées
500 objets, 630 Mio
1er envoi complet
TASK OK pour chaque VM
fait le 05/11 en journée, VM par VM (demande d’Axel) : 15:33 → 16:17, 14 × TASK OK, 0 erreur
relecture complète (verify s3-maison)
0 erreur
16:17 → 17:29 : 14 VM, ≈ 67 Gio relus depuis le NAS, 0 erreur (capture 222)
nettoyage et ramasse-miettes de la nuit, synchronisation de 04:00
TASK OK
À COMPLÉTER le 06/11
restauration d’une VM depuis s3-maison
VM qui démarre
À COMPLÉTER
Une copie hors site ne vaut que si elle est relisible : la vérification de PBS relit chaque morceau depuis le
S3 et contrôle son empreinte. C’est elle, et pas le simple « envoi réussi », qui prouve la copie.
65.1 Grafana surveille la copie chaque jour (demande d’Axel, 05/11)
L’exporteur PBS publiait déjà les mesures du nouveau datastore (pbs_used{datastore="s3-maison"},
pbs_snapshot_vm_last_timestamp{datastore="s3-maison"}) : rien à installer. Modifications par l’API (compte claude) :
Où
Quoi
tableau « Lab BTS — Production » (v64 → v67)
bloc Sauvegardes : 4ᵉ colonne par VM « Copie sur le NAS » (âge de la dernière copie : OK sous 30 h, absente si jamais copiée) ; jauge « Cache local du datastore S3 (64 Gio) »(d’abord présentée par erreur comme le quota du NAS, corrigée le 05/11 à 16:20 : voir ci-dessous) ; colonnes, jauge et courbe existantes filtrées sur datastore="sio2527-lab" (sans cela, la VM 105 apparaissait en double)
règle « Sauvegarde trop ancienne »
limitée au datastore du lab
règle « Copie hors site trop ancienne (NAS) » (avertissement)
âge d’une copie > 30 h pendant 10 min (sauvegarde vers 02:15, copie à 04:00 : 26 h serait trop juste) ; absence de mesure = alerte
règle « VM absente de la copie hors site (NAS) » (avertissement)
VM sauvegardée sur le lab sans copie sur le NAS, pendant 1 h ; en pause jusqu’au 1er envoi complet (13 VM absentes le 05/11, normal) : À COMPLÉTER la réactiver le 06/11
Pour un datastore S3, pbs_used et pbs_size mesurent le disque de cache local, pas le bucket : après la copie complète, la jauge affichait 5,1 Gio alors qu’environ 75 Gio étaient arrivés sur le NAS. La jauge montre donc le cache (64 Gio) ; la place réellement occupée sur le NAS (quota 200 Gio) se lit dans TrueNAS.
65.2 La place réelle sur le NAS, et l’accès vérifié toutes les 5 minutes (demandes d’Axel, 05/11)
PBS ne donne pas la place occupée dans un bucket (65.1). D’où un script sur srv-pbs, scripts/sauvegarde/s3-taille.py
(Python, bibliothèque standard seulement : il calcule lui-même la signature AWS SigV4), qui lit les clés là où PBS les
garde (/etc/proxmox-backup/s3.cfg, lisible par root : aucune copie, rien affiché) et écrit ses mesures pour
node_exporter (collecteur textfile) :
liste complète du bucket (API ListObjectsV2, 1 000 objets par page), somme des tailles
chaque heure (s3-taille.timer) ; 24 s pour 41 292 objets
pbs_s3_accessible, pbs_s3_acces_secondes
une requête signée qui demande 1 objet : prouve que tout le chemin répond (Internet, box, reverse proxy, SeaweedFS) et que les clés sont acceptées
toutes les 5 min (s3-acces.timer)
Grafana (tableau v68) : ligne « Copie hors site (NAS) » = courbe de la place occupée dans le bucket avec le quota de
200 Gio en pointillés, jauge « Copie NAS (quota 200 Gio) », voyant « NAS joignable » (OK / KO / inconnu) ; 16ᵉ règle
d’alerte « Copie hors site injoignable (NAS) » (avertissement, max(pbs_s3_accessible) < 1 pendant 15 min, absence de
mesure = alerte).
Relevé (05/11)
Valeur
après la copie complète des 14 VM (15:33 → 16:17, toutes TASK OK)
41 292 objets, 66,4 Gio dans le bucket (16:29)
accès signé
OK en 0,12 s (16:30)
alerte « injoignable » éprouvée
11/11 (test T30) : nom du S3 envoyé vers 127.0.0.1 dans /etc/hosts de srv-pbs (sans toucher au NAS) → alerte 17:52:39, mail 17:57:29 ; remise en état 18:36 → mail de résolution 18:57:29 (capture 270)
alertes « trop ancienne » et « VM absente » éprouvées
11/11 (test T30) : seuil abaissé à 1 h le temps du test → 14 VM en alerte 17:46:27, mail 17:50:24, résolution 18:50:24 ; sauvegarde à la main du modèle 9997 (absente du NAS) → alerte 18:35:56, mail 18:40:28 ; résolue par la vraie copie de la nuit : synchronisation terminée le 12/11 à 04:16:16 sans erreur (la VM 9997 est sur le NAS), mail de résolution 04:37:28 ; un rappel du mail d’alerte est parti à 03:07:28 pendant que l’alerte était active (capture 270)
Risques acceptés par Axel (05/11) : le S3 est joignable depuis tout Internet (pas de liste d’adresses
autorisées : il reste protégé par ses clés et par HTTPS) ; l’interface d’administration de SeaweedFS est aussi publiée
(gardée telle quelle : décision d’Axel du 06/11). Voir 5.3.
65.3 Restaurer une machine depuis la copie du NAS (06/11, clôt la tâche 13.6)
Pourquoi — Une copie qu’on n’a jamais restaurée n’est pas une sauvegarde. La relecture du 05/11 (capture 222)
prouve que les données du NAS sont intactes ; il restait à prouver qu’on sait en refaire une machine qui démarre.
Accès de Proxmox à la copie (laissé en place, décision d’Axel : la restauration est prête en cas de besoin) :
Élément
Valeur
stockage Proxmox
pbs-s3-axel (type PBS, créé par Axel dans l’interface : Datacenter → Storage → Add → Proxmox Backup Server) : serveur 10.1.0.197, datastore s3-maison, même compte, jeton et empreinte que pbs-lab-axel
droit sur PBS
backup-pve01@pbs et son jeton pve01 : DatastoreReader sur /datastore/s3-maison (lecture seule : restaurer, ni écrire ni supprimer)
Restauration (sur pve-01) : srv-web-02 (VM 130, sauvegarde du 06/11 02:38) dans une VM neuve 128, carte
réseau débranchée pour ne pas créer un doublon d’adresse avec la vraie machine :
Limite honnête : PBS garde une partie des morceaux récents dans son cache local (disque de 64 Gio) ; une
partie de la restauration a pu être servie par ce cache plutôt que par le NAS (débit de 261 Mo/s). La lecture
complète depuis le NAS est prouvée par la vérification du 05/11 (0 erreur). Le cas « PBS perdu » (nouveau PBS,
cache vide, --reuse-datastore) reste un exercice possible, non fait.
La règle Grafana « VM absente de la copie hors site (NAS) », mise en pause le 05/11 en attendant le premier envoi
complet, est réactivée (0 VM absente au moment de la réactivation, capture 228). La modification de la règle seule
par l’API avait été ignorée sans erreur : il a fallu passer par son groupe (H-87).
Étape 66 — GLPI sur les serveurs web, base dans le cluster Galera (phase 11, tâches 11.1 à 11.8, 05/11)
Pourquoi — La mission « Assistance » de GSB demande un outil de gestion de parc et de tickets. Avis du formateur
(29/10) : interface via HAProxy et les deux serveurs web, base sur le cluster Galera. Une seconde application
sur le même cluster prouve qu’il s’agit d’un service mutualisé. WordPress reste le site public de GSB (étape 64).
Décisions d’Axel (05/11) : GLPI sur srv-web-01/02 (aucune nouvelle VM : 11 Gio libres sur l’hyperviseur) ;
actif / secours ; fonctions : parc et tickets, alertes Grafana → tickets, inventaire automatique (à venir) ; version
11.0.12 (branche mûre, prérequis documentés) plutôt que 12.0.1 (sortie le 07/10, pas encore documentée).
Élément
Valeur
base
glpi (utf8mb4) dans Galera ; compte glpi@10.0.10.5 (les serveurs web passent par HAProxy) : tous droits sur glpi, SELECT sur mysql.time_zone_name ; mot de passe dans Bitwarden
fuseaux horaires
chargés une fois (mariadb-tzinfo-to-sql) sur srv-mysql-01 : recopiés par Galera sur les 3 nœuds (486), contrairement à ce que le plan supposait
créées par Axel (bin/console database:install, il a saisi le mot de passe) : 442 tables InnoDB, toutes avec clé primaire (exigence de Galera), identiques sur les 3 nœuds ; connexion sans TLS, comme WordPress (chemin interne, choix assumé) ; télémétrie refusée
glpi-cron.timer chaque minute, sur srv-web-01 seulement
HAProxy
certificat dédiéglpi.pem (auto-signé, choisi par SNI, celui de www intact) ; ACL hdr(host) glpi.sio.internalavant les règles WordPress ; backend glpi : web-01 + web-02 backup, contrôle GET /status.php avec X-Forwarded-Proto: https
srv-web-02 (secours)
même code et même configuration (/etc/glpi recopié par un tube sur pve-01, jamais affiché, empreintes identiques) ; /var/lib/glpi recopié par lsyncd (2ᵉ bloc, clé dédiée id_lsyncd_glpi confinée par rrsync -wo /var/lib/glpi, caches et verrous exclus)
DNS
zone sio.internal de l’AD : glpiet www → 10.0.10.5 (www manquait : depuis 6.6c, le poste ne résolvait plus le site GSB) ; Host Override pfSense glpi posé par Axel (capture 223) ; PC d’Axel : fichier hosts (choix d’Axel)
comptes par défaut
glpi, tech, normal, post-only : mots de passe changés par Axel (17:10-17:12, Bitwarden)
https://glpi.sio.internal depuis poste-win11 et depuis le PC d’Axel
page de connexion, puis tableau de bord (captures 216-218)
mots de passe des comptes par défaut
dates de changement relues dans glpi_users (capture 219)
srv-web-02 en secours, recopie lsyncd
fichier témoin recopié en 10 s ; backend glpi : web-01 UP, web-02 UP (backup) (capture 220)
bascule réelle : Apache arrêté sur srv-web-01 (17:36:22)
retiré par HAProxy en 7 s ; srv-web-02 sert GLPI ; Axel reste connecté, ticket n°2 et pièce jointe affichés (même sha1 sur les 2 serveurs) ; retour 17:37:32 (captures 225-226)
sonde et alerte
ligne « GLPI » du bloc Services, temps de réponse (51 ms), « Service injoignable » ; base dans l’export SQL (capture 224)
Incident pendant l’installation (H-86) : le site GLPI est devenu le site par défaut d’Apache ; WordPress,
qui ne déclarait pas www.sio.internal, n’était plus servi : administration de WordPress injoignable 18 min, site public
en 503 environ 43 s. Corrigé (ServerAlias www.sio.internal dans wordpress.conf). Capture 221.
Deux applications sur un même serveur web : chaque site Apache doit déclarer tous ses noms ; sinon, le
premier site (ordre alphabétique) répond pour les noms inconnus. Et un contrôle de santé doit se présenter comme une
vraie visite (ici, l’en-tête X-Forwarded-Proto: https).
Correction du 06/11 (H-89) : le contrôle de santé de HAProxy (/status.php, toutes les 2 s) ouvrait une session
PHP à chaque appel ; les fichiers n’étaient jamais effacés (Debian : gc_probability = 0) et lsyncd les recopiait
un par un (590 connexions SSH par heure). Ajouts : glpi-sessions-menage.timer sur les deux serveurs (sessions de plus
de 24 min, toutes les 15 min ; fichiers scripts/glpi/), délai lsyncd du bloc GLPI 5 → 30 s, panneaux de
connexions réussies sans la clé de recopie ; loginctl enable-linger root sur srv-web-02 (sinon le gestionnaire de
session de root redémarrait à chaque recopie : 164 lignes de journal par minute, ramenées à 4) (capture 235).
Étape 67 — LogAnalyzer : lire les journaux bruts, en direct (phase 17, 06/11)
Pourquoi — Les journaux de toutes les machines sont centralisés dans le cluster depuis l’étape 48, mais Grafana n’en
montre que ce que ses requêtes choisissent (connexions refusées, réussies, volume). Il manquait un écran pour tout voir,
brut et en direct, sans rien chercher : repérer ce qui choque, puis affiner ou ajouter une règle (filtre à la
source, règle Wazuh, alerte Grafana). Grafana reste l’écran central ; LogAnalyzer est la loupe (idée d’Axel, d’après
l’usage d’un collègue).
Choix (plan validé par Axel le 06/11)
Choix
Décision
Justification
Outil
LogAnalyzer 5.0.2 (28/09/2026)
fait pour rsyslog + MySQL/MariaDB ; repris par l’équipe rsyslog (GitHub rsyslog/loganalyzer), dernière version avec des correctifs de sécurité (injections SQL, XSS, sessions) ; l’ancien site Adiscon s’arrête à 4.1.13 (2022)
Où
srv-supervision (VM 140), aucune nouvelle machine
il a déjà l’accès au cluster (HAProxy local 127.0.0.1:3306) ; Apache + PHP y coûtent 113 Mio
Lecture
deux vues SQLla_journaux et la_journaux_auth au format attendu par LogAnalyzer (« MonitorWare »)
les tables, rsyslog, la purge et Grafana ne changent pas ; heure de Paris à l’affichage ; colonne Checksum calculée pour que LogAnalyzer n’écrive jamais
Compte SQL
loganalyzer@10.0.30.15 : SELECT sur les deux vues seulement
lecture seule ; les tables elles-mêmes sont refusées
Accès
HTTPS 8443 (certificat auto-signé), mot de passe Apache sur tout le site, pas de base d’utilisateurs LogAnalyzer
rien à écrire dans le cluster ; le port 80 reste fermé ; Grafana (3000) n’est pas touché
Réseau
aucune règle ajoutée
le PC d’administration arrive par l’onglet Tailscale (Pass any → any, comme pour Grafana) ; les autres zones n’ont aucune règle vers ADM:8443
67.1 Les vues et le compte (17.2)
Les colonnes facilite et gravite des tables sont déjà des nombres, comme l’attend LogAnalyzer. Les vues (sur un nœud,
recopiées par Galera) renomment les colonnes ; extrait :
CREATE OR REPLACE SQL SECURITY DEFINER VIEW syslog.la_journaux AS
SELECT id AS ID,
       CONVERT_TZ(recu_le, '+00:00', 'Europe/Paris') AS ReceivedAt,
       CONVERT_TZ(COALESCE(emis_le, recu_le), '+00:00', 'Europe/Paris') AS DeviceReportedTime,
       hote AS FromHost, facilite AS Facility, gravite AS Priority,
       programme AS SysLogTag, message AS Message,
       1 AS InfoUnitID, NULL AS ProcessID, NULL AS EventID, NULL AS EventLogType,
       NULL AS EventSource, NULL AS EventCategory, NULL AS EventUser, NULL AS SystemID,
       CRC32(message) AS Checksum
FROM syslog.journaux;
(la_journaux_auth : la même sur syslog.journaux_auth.) La liste des colonnes vient du code de LogAnalyzer
(src/include/constants_logstream.php, correspondance monitorware). EXPLAIN : les 50 derniers messages sont lus par
la clé primaire, sans parcourir la table (1,1 million de lignes).
Compte créé par Axel (mot de passe saisi par read -rsp, Bitwarden BTS-LAB - Galera - loganalyzer, registre D-14) :
GRANT SELECT ON syslog.la_journaux et … la_journaux_auth.
Validation — depuis srv-supervision : la vue se lit (heure de Paris) ; SELECT COUNT(*) FROM syslog.journaux
→ ERROR 1142 … SELECT command denied ; droits identiques sur les 3 nœuds (capture 229).
ports.conf réduit à Listen 8443 (original ports.conf.orig) ; site 000-default désactivé ; ServerTokens Prod
site
/etc/apache2/sites-available/loganalyzer.conf : DocumentRoot /var/www/loganalyzer, SSLEngine on, AuthType Basic sur tout le dossier, Options -Indexes, en-têtes nosniff, SAMEORIGIN, HSTS
certificat
auto-signé /etc/ssl/loganalyzer/ : CN=srv-supervision.sio.internal, SAN DNS + IP 10.0.30.15, jusqu’au 08/02/2029
mot de passe
créé par Axel : htpasswd -B /etc/apache2/loganalyzer.htpasswd ipfixe (bcrypt, 640 root:www-data, Bitwarden BTS-LAB - LogAnalyzer - accès web, registre W-03)
Validation — sans mot de passe 401 ; port 80 fermé ; avec le mot de passe, la page répond (capture 230).
67.3 Installer LogAnalyzer (17.4) et vérifier l’accès (17.5)
Archive loganalyzer-5.0.2.tar.gz de la release GitHub, téléchargée sur la VM dans un dossier à part
(/root/telechargements/) : 6 875 678 octets, SHA-256 identique à celle publiée
(77477c07…555c293).
Contenu de src/ (580 fichiers) copié dans /var/www/loganalyzer (root, 644/755) ; config.php vide, modifiable
par Apache le temps de l’installeur.
Installeur web, par Axel depuis son PC (https://10.0.30.15:8443/install.php, voir H-88) : 50 messages par page,
200 caractères par message, résolution DNS des IP désactivée (sinon une requête DNS par adresse lue), pas de
base d’utilisateurs ; source « Journaux » : MYSQL Native, MonitorWare, hôte 127.0.0.1 (pas localhost :
ce serait le socket d’un MariaDB local, absent), base syslog, table la_journaux, comptage des lignes désactivé.
Seconde source « Authentification » (la_journaux_auth) ajoutée dans config.php en recopiant la première, sans
afficher le mot de passe ; php -l sans erreur ; config.php en 640 root:www-data ; install.php supprimé.
Accès (17.5) — aucune règle à créer. Vérifié : depuis poste-win11 (USERS) et srv-web-01 (WEB), le port 8443 de
10.0.30.15 est bloqué (témoin : 3000 bloqué aussi) ; depuis le PC d’Axel par Tailscale, l’écran s’ouvre.
67.4 Premier usage : ce qui choque → une règle ajustée (17.6)
Constat — La première page n’affichait presque que Started galera-etat@… / galera-etat@… Deactivated successfully : la sonde d’état Galera (étape 62) crée un service systemd par contrôle de HAProxy, sur chacun des 3
nœuds. Mesure : 10 315 lignes sur 13 402 en une heure (77 %), plus de 250 000 par jour, sans aucune information.
Correction à la source — dans [email protected] (3 nœuds, copie .avant-0611, fichier des annexes à jour) :
LogLevelMax=notice
SyslogLevel=warning
LogLevelMax=notice coupe les messages « info » écrits par systemd lui-même sur ce service (documentation
systemd.exec : le réglage s’applique aussi aux messages du gestionnaire de services « in reference to this unit ») ;
SyslogLevel=warning classe les erreurs écrites par le script en avertissement : elles passent le filtre.
Validation (capture 232) — 60 → 0 ligne par minute et par nœud ; sonde 200 Synced ; HAProxy : 3 nœuds UP ; une
erreur simulée (systemd-run avec les mêmes réglages) reste dans le journal. Dans la base : 172 lignes de la sonde par
minute à 09:26, 0 à 09:30.
Recherche severity:warning (par Axel, capture 233) — fait ressortir d’un coup : l’erreur simulée (preuve que les
erreurs passent), trois échecs simultanés de la sonde à 05:50:46 (Failed with result 'exit-code', sans aucun
retrait de nœud par HAProxy : cause À VÉRIFIER), et des refus 401 sur PBS (les essais du stockage pbs-s3-axel ;
une page PBS restée ouverte, invalid ticket - expired). Le journal local de HAProxy montre aussi des salves DOWN/UP
vers 02:00, pendant les sauvegardes (gel des disques, MO-12 §13.2).
Les erreurs n’étaient pas perdues, elles étaient noyées : avant le réglage, les trois échecs de 05:50
étaient au milieu de 250 000 lignes de routine. Filtrer le bruit connu à la source rend visible ce qui compte ; on
ne filtre jamais un échec.
67.4 bis Le reste du bruit de routine (06/11, soir)
Constat — Axel, sur le panneau Grafana « Lignes de journaux reçues (dernière heure) » : srv-supervision 1 311,
srv-web-02 1 270, srv-wazuh 645, srv-web-01 453. Détail par machine et par programme (base syslog) : aucune
erreur, que de la routine.
Machine
Cause
Correction (copie avant)
Avant
Après
srv-web-02
recopie GLPI (lsyncd) : une connexion SSH toutes les 30 s, ≈ 10 lignes chacune
bloc GLPI de lsyncd.conf.lua : ControlMaster = "auto", ControlPath = "/root/.ssh/cm-lsyncd-glpi" (propre à ce bloc : la clé GLPI est confinée à /var/lib/glpi), ControlPersist = "10m" (.avant-controlpersist)
1 270
70
srv-web-01
glpi-cron et lsyncd-etat, chaque minute
fichier journal.conf dans glpi-cron.service.d/ et lsyncd-etat.service.d/ : LogLevelMax=notice, SyslogLevel=warning (fichier scripts/supervision/journal-routine.conf)
453
70
srv-wazuh
interface Wazuh : 488 lignes « info » par heure
logging.quiet: true dans opensearch_dashboards.yml (option vérifiée dans le code installé, 4.14.9) (.avant-quiet)
645
125
srv-supervision
les commandes de Claude par l’agent invité (qemu-ga)
— (passager)
1 311
55
Validation (capture 242) — mesure « après » sur 12 min sans redémarrage ; glpi-cron et lsyncd-etat toujours
success ; fichier témoin recopié sur srv-web-02, 0 connexion SSH de la recopie en 5 min ; interface Wazuh 200.
67.5 Supervision (17.7)
Élément
Valeur
module blackbox
http_401_insecure : 401 attendu (Apache répond et demande le mot de passe ; la supervision n’a pas besoin du mot de passe)
tableau de production v71 : nom affiché « LogAnalyzer » ; la ligne de disponibilité apparaît seule (label_values(probe_success, service)) ; règle « Service injoignable » (probe_success) la couvre d’office
Copies .avant-loganalyzer sur srv-metriques ; fichiers des annexes (scripts/supervision/blackbox.yml,
prometheus.yml) remis à jour depuis le serveur (domaine personnel masqué).
Procédure complète : MO-22. Incident : H-88 (lien de l’installeur
affiché en texte brut).
Étape 68 — Être prévenu quand HAProxy retire un serveur (point d’hygiène H-7, 06/11)
Pourquoi — Le 05/11 (H-86), srv-web-01 a été retiré par HAProxy pendant 18 min sans aucun mail : tant que l’autre
serveur répond, le site reste « disponible » et aucune sonde ne voit rien. Une panne d’un serveur passait inaperçue
jusqu’à la panne du second.
Élément
Valeur
mesure
haproxy-etat.py sur srv-ha (bibliothèque standard Python), toutes les 30 s (haproxy-etat.timer) : lit show stat sur le socket d’administration et écrit haproxy_serveur_up{backend, serveur, role} (1 en service, 0 retiré ou en maintenance) dans le dossier « textfile » de node_exporter ; plus haproxy_etat_mesure_ok
couverture
les 8 serveurs suivis : web_public (web-01, web-02), web_admin (web-01), glpi (web-01, web-02 secours), galera (mysql-01, mysql-02 et 03 secours)
règle Grafana (17ᵉ)
« Serveur retiré par HAProxy » : haproxy_serveur_up{host="srv-ha"} < 1 pendant 5 min, avertissement, une alerte par serveur
pourquoi 5 min
pendant les sauvegardes de 02:00, HAProxy retire brièvement des serveurs (gel des disques) : 78 s au plus la nuit du 06/11 ; 5 min ignore ces retraits et voit un vrai retrait comme celui de H-86
Validation (capture 236) — disable server glpi/web-02 (serveur de secours, sans trafic) : en attente à
10:10:20, alerte à 10:15:20 (mail), remis en service à 10:21:35, retour à la normale à 10:22:20. Un premier essai
n’avait rien déclenché : en maintenance, HAProxy vide le champ check_status, et le script, qui ignorait ces lignes,
faisait disparaître la série au lieu de la passer à 0 (une série absente ne déclenche pas d’alerte) ; corrigé.
Sonde Galera durcie le même jour (H-90, capture 238) : galera-etat.sh sort sans erreur si HAProxy a déjà
raccroché ; listen galera : timeout check 3s, default-server inter 2s fall 3 rise 2. Fichier des annexes à jour.
Même jour, demande d’Axel : le tableau de bord de Wazuh (https://10.0.30.16) entre dans la ligne des services :
job Prometheus sonde_wazuh (module http_2xx_insecure, service="wazuh", 200 après redirection vers la page de
connexion, 0,1 s), nom affiché « Wazuh » (tableau v73), couvert par « Service injoignable ». Copie .avant-wazuh.
Étape 69 — Inventaire automatique dans GLPI, une entité par zone (tâche 11.9, 06/11)
Pourquoi — GLPI doit tenir la fiche de chaque machine (matériel, système, logiciels, disques) sans saisie à la main.
L’agent officiel GLPI 1.21 envoie un inventaire à GLPI (https://glpi.sio.internal/, par HAProxy) ; GLPI range la
machine dans l’entité de sa zone (GSB > WEB, GSB > BDD, GSB > ADM, GSB > USERS, décision d’Axel) grâce à
l’étiquette (TAG) envoyée par l’agent et à une règle « Affectation d’un élément à une entité ».
Élément
Valeur
GLPI
inventaire natif activé (bin/console config:set enabled_inventory 1 --context=inventory) ; fuseau horaire par défaut Europe/Paris (il affichait l’UTC)
agent Linux
paquet glpi-agent_1.21-1_all.deb (GitHub, SHA-256 vérifiée ; Debian ne le fournit pas) ; /etc/glpi-agent/conf.d/lab.cfg : serveur, certificat du lab (glpi-lab.pem), tag = <ZONE> ; pas de service permanent : glpi-agent-inventaire.timer (démarrage + 15 min, puis vers 07:00) ; ~110 paquets Perl ajoutés
glpi-entite-zone.py <ZONE> depuis le bastion : crée au besoin GSB, GSB > <ZONE> et la règle « Inventaire - zone » (TAG = ZONE → entité) par l’API REST de GLPI
API
API legacy activée (https://glpi.sio.internal/api.php/v1), connexion par jeton ; client bastion-lab (jeton d’application) ; compte api-lab (Super-Admin : le profil Admin ne peut pas créer d’entité ; pas de mot de passe, jeton seulement) ; jetons dans Bitwarden et dans ~/.config/glpi/api.env (600) sur le bastion ; dans HAProxy, l’API n’est servie qu’au bastion et à srv-supervision (403 pour toute autre source, et toujours 403 sous le nom Pangolin)
pare-feu
nouvelle règle ADM « Agents et API GLPI vers SRV_HA » : ADM subnets → SRV_HA:443 (créée par Axel) ; WEB : même zone ; USERS : règle n°5 existante
scripts
scripts/glpi/ : ajouter-agent-glpi.sh (bastion, Linux), installer-agent-glpi.sh, installer-agent-glpi.ps1 (Windows), glpi-entite-zone.py, glpi-lab.pem ; copie sur le bastion : ~/supervision/glpi/
Validation (capture 237)
Test
Résultat
Linux, chemin complet depuis le bastion (lancé par Axel)
srv-metriques : entité GSB > ADM trouvée, paquet vérifié, New inventory … (tag=ADM), rangé dans GSB > ADM, 471 logiciels
Windows
poste-win11 : EMPREINTE CONFORME, New inventory … (tag=USERS), tâche « GLPI Agent » prête, rangé dans GSB > USERS
rangement automatique
srv-ha, srv-web-01, srv-web-02 (fiches supprimées puis réinventoriées) revenus d’eux-mêmes dans GSB > WEB
relance du script des entités
« existe » partout : rien n’est créé deux fois
API hors bastion
403 depuis srv-ha ; 403 sous le nom Pangolin
Pièges : le profil Admin ne crée pas d’entité ; une session d’API ne voit pas l’entité qu’elle vient de créer
(le script rouvre une session) ; après suppression d’une fiche, l’agent n’envoie qu’un inventaire partiel (sans
logiciels) : glpi-agent --force --full ; un inventaire complet de 1 700 paquets dépasse 30 s (H-92) ; GLPI publié par
Pangolin tombait dans le pool du site (H-91).
Suite le 06/11 : Axel a lancé ajouter-agent-glpi.sh depuis le bastion pour srv-docker, srv-pbs, srv-supervision et
srv-wazuh : les 4 dans GSB > ADM (488, 537, 525 et 871 logiciels) : 9 machines inventoriées.
Puis AD-Core-01 (installer-agent-glpi.ps1, GSB > ADM) et les 3 nœuds BDD : règle permanente BDD → SRV_HA:443
(« Agents GLPI vers SRV_HA », en tête de l’onglet BDD : 3ᵉ exception assumée à « la base n’initie rien », une
destination, un port, comme les journaux et Wazuh) et règle TEMPORAIRE (accès web) le temps de l’installation, créées
par Axel ; le script a créé lui-même l’entité GSB > BDD et sa règle. 13 machines inventoriées, 4 entités
(capture 237) ; hors inventaire : poste-visiteur (zone VISITEURS, exclue) et pfSense.
Étape 70 — Les alertes de la supervision deviennent des tickets GLPI (tâche 11.10, 06/11)
Pourquoi — Un mail se lit et s’oublie ; un ticket garde la trace de l’incident (début, durée, solution) et se
traite comme dans un vrai service d’assistance. Mais un ticket par alerte noierait GLPI : sur 8 jours (29/10 → 06/11),
62 alertes, dont 57 revenues à la normale en moins de 30 min et une seule restée active 2 h ou plus
(historique d’état des 17 règles, API de Grafana).
tout de suite (un événement de sécurité se regarde toujours, et ces alertes retombent seules en 15 min par construction : H-77)
Les 15 autres règles
seulement si l’alerte est encore active 2 h après son déclenchement ; revenue à la normale avant : pas de ticket, le mail suffit
Au retour à la normale
solution automatique sur le ticket (statut « Résolu ») avec la durée de l’incident ; un technicien peut le rouvrir
Montage — Grafana ne parle jamais à GLPI : il détecte et prévient ; un relais décide et crée le ticket.
srv-metriques ──journaux──► srv-supervision : rsyslog → base syslog ◄── Grafana (règle SQL chaque minute)
                                                                         │ alerte : point de contact mail-axel
                                                                         ├──► mail (Gmail)
                                                                         └──► webhook http://127.0.0.1:9095/ ──► relais (Python)
                                       relais ──HTTPS, API REST, compte api-alertes──► HAProxy (srv-ha) ──► GLPI (srv-web-01) ──► ticket
Élément
Valeur
relais
relais-alertes-glpi.py (bibliothèque standard Python) sur srv-supervision, service systemd relais-alertes-glpi sous le compte système glpi-relais (sans connexion), ProtectSystem=strict ; n’écoute qu’en local (127.0.0.1:9095)
réglages
/etc/glpi-relais/relais.conf : délai 120 min, liste des alertes immédiates, entité des tickets GSB ; état des alertes en cours : /var/lib/glpi-relais/etat.json (survit à un redémarrage)
doublons
l’empreinte Grafana de chaque alerte : une même alerte n’ouvre jamais deux tickets ; le contrôle du délai se fait toutes les 5 min
ticket
titre [Supervision] <règle> — <machine>, type Incident, urgence et impact hauts (critique) ou moyens (avertissement), contenu : résumé, description, heure de déclenchement, étiquettes
compte GLPI
api-alertes, profil Technicien (créer, suivre, résoudre des tickets ; rien d’autre), jeton seulement ; jeton d’application du client bastion-lab ; jetons dans /etc/glpi-relais/api.env (640 root:glpi-relais) et Bitwarden ; l’API n’accepte srv-supervision que parce que HAProxy l’autorise (étape 69)
Grafana
point de contact mail-axel : second canal webhook vers le relais, à côté du mail (aucune règle ni politique modifiée)
ticket 5 ouvert tout de suite, puis Résolu au retour à la normale
alerte qui dure (délai réglé à 1 min pour l’essai, puis remis à 120)
ticket 8 ouvert au contrôle suivant le délai, puis Résolu
alerte courte
aucun ticket (« revenue à la normale avant le délai »)
chemin réel : 6 connexions SSH refusées sur srv-metriques à 15:37:37
Grafana « Connexions refusées en rafale » → ticket 11 ouvert à 15:39:13 (entité GSB, Incident, priorité Haute, créé par api-alertes), Résolu à 15:44:13 ; mails reçus en parallèle
Rattachement à la machine (demande d’Axel, même jour) — Après création, le relais cherche la fiche « Ordinateur »
dont le nom est l’étiquette host de l’alerte (inventaire de l’étape 69) et y lie le ticket (POST /Item_Ticket) :
depuis la fiche de la machine, onglet Tickets, on voit son historique d’incidents. Machine non inventoriée : ticket
ouvert quand même, sans élément. Essai : ticket 14 lié à l’ordinateur srv-metriques, ticket 17 (machine
inconnue) sans lien, les deux Résolus (capture 241). Copie de l’ancienne version : relais-alertes-glpi.py.avant-rattachement.
Procédure complète et lecture du script bloc par bloc : MO-23.
Chaque maillon ne fait qu’une chose : la machine écrit son journal, Grafana détecte, le relais décide et crée le
ticket, GLPI le garde. Si le relais tombe, les mails continuent ; si GLPI tombe, la supervision continue.
Étape 71 — Veille de sécurité du 06/11 : faille APT corrigée, avis OpenSSH écarté
Pourquoi — La veille du matin (mail quotidien, reprise dans le journal de la séance S04) signale deux sujets. Chacun
est vérifié sur la source officielle avant d’agir, puis comparé aux versions réellement installées.
Sujet
Source officielle
Ce qui touche le lab
Action
APT (CVE-2026-109518, publiée le 04/11) : un attaquant placé entre la machine et le miroir peut faire installer un paquet non vérifié, exécuté en root
seulement les systèmes musl sans PAM (Alpine, embarqué) ; le lab est en glibc + PAM
aucune : non concerné
Validation (capture 243) — les 12 machines Linux relues après la mise à jour : Debian 13 en apt3.0.4,
srv-docker en 2.6.2, srv-wazuh en 2.8.4ubuntu0.1. Au passage, l’agent invité de srv-pbs était bloqué (même cas
que H-93) : relancé par Axel.
Une veille n’est utile que si elle se termine par une vérification : la source officielle (pas l’article), les
versions installées, puis la plus petite correction qui suffit.
Étape 72 — Mesure d’audience Matomo et site de GSB en ligne (phase 18, tâches 18.1 à 18.7, 10/11)
Pourquoi — Pour la compétence « développer la présence en ligne de l’organisation » (E5, C3), le site public de GSB est
mesuré par Matomo, sans demander le consentement des visiteurs (dispense de la CNIL), et mis en ligne pour
recevoir de vraies visites. GSB est une entreprise fictive : le site le dit sur chaque page. La justification
complète (base légale, données, durées, preuves) est dans Justification-RGPD-Matomo.md.
Élément
Choix
Pourquoi
Application
Matomo 5.14.2 (dernière stable ; la 6 n’existe qu’en préversion), archive vérifiée par empreinte SHA-256
logiciel libre, hébergé dans le lab : aucune donnée envoyée à un tiers
Montage
application séparée de WordPress sur srv-web-01 (actif) et srv-web-02 (secours, copie par lsyncd), base matomo dans Galera, stats.sio.internal
même schéma que GLPI (étape 66)
Suivi
le navigateur du visiteur charge /stats/matomo.js et envoie la visite à /stats/matomo.phpsur l’adresse du site ; HAProxy relaie ces deux fichiers seulement, tout autre /stats/… est refusé (404)
pas de nom public pour Matomo ; l’interface reste dans le lab
Conformité
règle CNIL de Matomo appliquée au site n° 2 (IP masquée, données gardées 180 jours, journal des visites et profils coupés), case d’opposition, page « Mentions légales et confidentialité »
capture 249
Site fictif
bandeau rouge sur toutes les pages, mentions légales (éditeur : « un étudiant en BTS SIO »), pas d’indexation, commentaires fermés
rien ne doit laisser croire à une vraie entreprise
72.1 Base, installation, secours (18.2 à 18.4)
Base et compte (Axel, read -rsp, Bitwarden, registre D-15) : base matomo, compte matomo@10.0.10.5 limité à cette base ; présents sur les 3 nœuds.
Installation (capture 244) : archive téléchargée, empreinte comparée (identique), /var/www/matomo, site Apache stats.sio.internal. L’installeur web est passé par Axel : vérification du système entièrement verte, MariaDB, 34 tables InnoDB avec clé primaire (condition de Galera) ; compte administrateur W-04.
Réglages posés ensuite (capture 246) : config.ini.php en 640, config/ et tmp/ refusés (403) ; rapports calculés chaque heure par matomo-archivage.timer sur srv-web-01 seulement (plus par les visites) ; extensions d’IA désactivées (elles peuvent envoyer des données à un service extérieur).
Nom et HAProxy (capture 245) : certificat dédié stats.pem, acl est_stats, backend matomo ; nom stats dans l’annuaire (Claude) et dans pfSense (Axel).
Secours (capture 247) : clé lsyncd dédiée et confinée (rrsync -wo /var/www/matomo), 3ᵉ bloc lsyncd (délai 30 s), srv-web-02 en backup dans HAProxy. Bascule réelle : Apache arrêté 9 s sur srv-web-01, Matomo, site et GLPI restent à 200, servis par srv-web-02.
72.2 Conformité et contenu (18.5, 18.6)
Écran Confidentialité → Conformité : règle CNIL appliquée par Axel (capture 249). IP masquée sur 2 octets (le minimum de la règle), données détaillées 180 jours : la page des mentions a été corrigée en conséquence.
Extension maison mu-plugins/gsb-lab.php (recopiée par lsyncd) : bandeau « site fictif », code de suivi pour les visiteurs non connectés seulement (ni l’intranet ni l’administration), commentaires fermés, case d’opposition (code court [gsb_opposition_matomo]).
Page n° 3 « Mentions légales et confidentialité » publiée (capture 248). Visite de test : adresse enregistrée masquée.
72.3 Mise en ligne par Pangolin (18.7)
WordPress à deux noms : son adresse était écrite en dur (https://www.sio.internal, 19 liens par page) : une simple redirection de nom par Pangolin aurait cassé la mise en forme. wp-config.php choisit désormais le nom demandé parmi une liste de deux (interne et public) ; les images écrites en dur dans le contenu sont réécrites à l’envoi. Ménage : 2 extensions et 3 thèmes inutilisés retirés ; WordPress 7.1.4 et thème à jour.
Apache : le nom public ajouté au site WordPress sur les deux serveurs. Sans cela, un nom inconnu tombait sur le premier site par ordre alphabétique, GLPI.
HAProxy, règles du nom public (copie haproxy.cfg.avant-site-public-1011) : refus (403) de /wp-admin, /wp-login.php, /xmlrpc.php, /wp-json, ?author=, ?rest_route=, /intranet, readme.html ; seules les méthodes GET et HEAD, plus le POST du suivi Matomo ; limite de débit par visiteur ; sous le nom interne, rien ne change pour le lab.
Ressource Pangolin « GSB » (Axel) : cible https://www.sio.internal:443, non protégée. Deux erreurs avant de fonctionner (H-95) : contrôle de santé réglé sur www.sio.internal/ et le port 80.
Agents Wazuh sur srv-web-01 et srv-web-02 (début de l’extension 16.7, capture 250) : le site étant public, la détection d’intrusion les couvre. Test : un compte créé sur un serveur web remonte en 2 secondes (règle 5902, niveau 8).
Validation — depuis Internet, par l’adresse publique : pages publiques et script de suivi à 200 ; administration, connexion, XML-RPC, API, liste des comptes, intranet à 403 ; POST à 405 ; 130 requêtes rapides : 100 passent, 30 refusées (429) ; liens et images de la page suivent le nom public ; certificat Let’s Encrypt valable jusqu’au 11/01/2027 ; visite de test envoyée depuis Internet et enregistrée.
72.4 Intégration à la supervision, aux sauvegardes et à la détection (18.9)
Besoin
Réglage
Preuve (capture 252)
Voir une panne du site public
sonde Prometheus sonde_site_public (toutes les 60 s, par Internet : Pangolin, tunnel, srv-ha, serveur web) et sonde_matomo (interface, via srv-ha) ; le tableau de production affiche 11 services (« Site public (Internet) » et « Matomo » ajoutés à l’état actuel et à l’historique, version 74)
11 services sondés, site public en 1,5 s
Être prévenu
la règle critique « Service injoignable » est générique sur probe_success : elle couvre les deux nouveaux services sans changement (pas de panne réelle provoquée pour ces deux-là : la règle a déjà été éprouvée, étape 54)
—
Sauvegarder Matomo
base matomo ajoutée à l’export SQL nocturne (export-bases.sh, srv-mysql-03, 01:30), lancé une fois à la main ; la VM est ensuite sauvegardée par PBS
export matomo : … (28K)
Savoir qui attaque
module Apache remoteip sur les deux serveurs web (RemoteIPHeader X-Forwarded-For, proxys de confiance 10.0.10.5 et 10.0.30.12) : le journal de WordPress montre l’adresse réelle du visiteur ; l’agent Wazuh lit wordpress-access.log et wordpress-error.log
adresse réelle dans le journal
Détecter les attaques web
règles standard de Wazuh sur le journal Apache : trois requêtes de test (XSS, injection SQL, fichier de sauvegarde) détectées en moins de 2 s, adresse de l’appelant comprise (niveaux 6 et 7 : visibles dans le tableau de Wazuh, pas de mail sous le seuil de 10)
31105, 31103, 31516
Journaux et vie privée — les journaux Apache gardent l’adresse IP complète (sécurité) : rotation 14 jours (logrotate),
et la page Mentions légales et confidentialité l’annonce (section « Journaux techniques de sécurité »). Ce traitement est
distinct de la mesure d’audience (Matomo, adresse masquée, dispense de consentement) : il relève de l’intérêt légitime de
sécuriser le site. Les alertes Wazuh conservent plus longtemps les attaques détectées : sa durée de conservation reste à
régler (extension 16.7).
Nom de l’éditeur retiré du site (11/11) — la phrase « hébergé dans le laboratoire SISR d’Axel GOUIRAND » des quatre pages a
été remplacée par « dans un laboratoire de formation BTS SIO SISR », les anciennes versions qui la contenaient supprimées ;
recherche faite dans toute la base : plus aucune occurrence. Aussi : pages d’auteur (/author/…) refusées par HAProxy (elles
affichaient le nom du compte d’administration), nom affiché du compte changé en « Rédaction GSB ».
Adresse réelle des visiteurs (11/11, tâche 18.11, H-96) — au départ, HAProxy ne voyait que l’adresse d’une machine du réseau
domestique d’Axel : Traefik (Pangolin) écrasait X-Forwarded-For et X-Real-IP. Correction : Nginx Proxy Manager, qui voit
la vraie adresse, la place dans un en-tête que Traefik ne touche pas (X-Client-Real-IP, imposé, donc infalsifiable) ; HAProxy
la reprend pour Matomo et compte la limite de débit par visiteur (100 requêtes / 10 s). Preuve (capture 251) : visite
depuis Internet enregistrée par Matomo en adresse masquée, pays reconnu.
Étape 73 — Portail GLPI pour les salariés de GSB : connexion par l’annuaire, catégories, ticket réel (phase 19, tâches 19.1 à 19.8, 11/11)
Objectif. Jusqu’ici, aucun salarié de GSB ne pouvait ouvrir un ticket dans GLPI : ils naissaient des alertes de supervision (étape 70) ou
d’une saisie par l’administrateur. Cette étape ouvre un portail simplifié (profil Self-Service de GLPI) où un salarié se connecte avec son
compte Windows (l’annuaire sio.internal), ouvre un ticket, le suit et valide la solution, sans rien voir d’autre.
Demande de la conversation du dossier (07/11) ; compétences E5 C2 et C5.
73.1 Décisions d’Axel (19.1, 11/11)
Question
Choix
Pourquoi
Comptes locaux ou annuaire ?
Annuaire (comptes du domaine)
un seul mot de passe pour le salarié, un compte désactivé dans l’AD ne peut plus entrer
Flux pfSense
règle étroite WEB → AD-Core-01
seule la destination et le port utiles sont ouverts
Accès depuis la zone VISITEURS
non (USERS et ADM seulement)
les visiteurs n’ont pas à ouvrir de tickets internes
Mails de suivi au salarié
non (tâche 19.7 écartée)
le suivi se lit dans le portail
73.2 Compte de liaison et LDAPS (19.2)
Compte de serviceCS_glpi_ldap, dans une nouvelle OU Comptes de service (sous OU=SIO) : créé désactivé, sans groupe ni droit particulier (un
« utilisateur du domaine » lit déjà l’annuaire), mot de passe sans expiration et non modifiable. Le mot de passe est saisi par Axel (Read-Host, rangé dans Bitwarden) : Claude ne l’a jamais vu. Registre : A-06.
Le LDAP en clair est refusé : le contrôleur (Windows Server 2025) exige la signature LDAP. Une connexion simple sur le port 389 répond
LDAP result 8 (« The server requires binds to turn on integrity checking »). Le plan initial (« 389 puis LDAPS plus tard, noté en dette ») était impossible : LDAPS (636) obligatoire (H-97).
Certificat LDAPS : le lab n’a pas d’autorité de certification. Un certificat auto-signé est créé sur AD-Core-01 (CN=AD-Core-01.sio.internal, alternatives de nom AD-Core-01.sio.internal et
sio.internal, RSA 2048, SHA-256, 5 ans, expire le 11/11/2031). Il doit être à la fois dans le magasin personnel de l’ordinateur et dans ses autorités racines : sans cette seconde copie, le contrôleur ne peut pas valider sa chaîne et répond « aucune information d’identification » (8009030e).
Côté clients : la partie publique du certificat est installée dans le magasin de confiance de Debian de srv-web-01 et srv-web-02 (update-ca-certificates) : PHP vérifie donc le certificat, sans désactiver le contrôle.
DNS : AD-Core-01.sio.internal → 10.0.30.10 ajouté dans pfSense (Services → DNS Resolver → Host Overrides), car le certificat est émis à ce nom et les serveurs web ne savaient pas le résoudre.
pfSense (règle créée par Axel, onglet WEB, avant le refus général) : TCP WEB subnets → 10.0.30.10 port 636, « GLPI : lecture de l’annuaire (LDAPS) » (Matrice de flux, ligne 3 quater).
PHP : l’extension php8.4-ldap manquait sur les deux serveurs web (GLPI l’affichait en bandeau orange) ; installée, Apache rechargé.
Test : TLS 1.3 (TLS_AES_256_GCM_SHA384), certificat vérifié depuis les deux serveurs web ; connexion du compte de liaison testée par Axel (code LDAP 0). Capture 253.
73.3 L’annuaire et les droits dans GLPI (19.3)
Réglage GLPI
Valeur
Annuaire
« Annuaire sio.internal », par défaut, actif
Serveur, port
ldaps://AD-Core-01.sio.internal, 636
BaseDN
OU=Utilisateurs,OU=SIO,DC=sio,DC=internal (les salariés seulement : le compte de liaison et Administrateur en sont hors)
Filtre de connexion
(&(objectClass=user)(objectCategory=person)(!(userAccountControl:1.2.840.113556.1.4.803:=2))) : des personnes, comptes désactivés exclus
identifiant samaccountname ( la valeur par défaut uid était restée devant), synchronisation objectguid
Test GLPI
5 étapes réussies, 6 entrées (capture 254)
Règles d’habilitation : la règle livrée par GLPI « Root » (tout compte d’annuaire → entité racine) est désactivée : elle aurait ouvert toute l’arborescence aux salariés. À sa place, la règle
« Salariés du domaine : Self-Service dans GSB > USERS » : critère Annuaire LDAP = Annuaire sio.internal ; actions entité GSB > USERS, profil Self-Service, récursif : non (captures 255 et 256).
Les 6 comptes (m.durand, t.bernard, s.lefevre, j.petit, c.moreau, a.gouirand) ont été importés ; la lecture de la base confirme pour chacun : Self-Service, GSB > USERS, non récursif (capture 261). Leurs mots de passe ont été réinitialisés par Axel (générés au hasard sur le contrôleur, rangés dans Bitwarden). Registre : A-07.
73.4 L’interface simplifiée (19.4)
6 catégories de ticket, créées par l’API (scripts/glpi/glpi-categories-tickets.py, compte api-lab, relançable sans risque) : Poste de travail ; Compte et mot de passe ; Réseau et accès Internet ; Messagerie ; Application métier (GSB) ; Autre demande. Entité racine, récursives, visibles dans l’interface simplifiée, pour un incident et une demande, jamais pour un problème ni un changement (capture 258).
4 tuiles de la page d’accueil livrées en anglais (Browse help articles, Create a ticket, See your tickets, Make a reservation) traduites en français par mise à jour de leur texte (capture 259).
Le salarié ne voit aucun menu d’administration (capture 257).
Administrateur (compte du domaine, hors de l’OU des salariés)
refusé : « Identifiant ou mot de passe incorrect » (capture 260)
Ticket 44 « utilisateur non reconnu », de bout en bout
12:50 ouvert par le salarié (capture 262) · 12:58 suivi public du technicien glpi (capture 263) · 13:04 solution posée (Résolu) · 13:05 acceptée par le salarié → Clos (capture 264)
Refus d’une solution (ticket 47, préparé par l’API, refus cliqué par a.gouirand)
13:13 : solution refusée, ticket rouvert en « En cours (attribué) », date de résolution effacée, commentaire du salarié ajouté en suivi (capture 265)
Aucun mail n’est parti (file de notifications vide), comme décidé.
73.6 Le guide du salarié (19.8)
Guide-salaries-ouvrir-un-ticket.md : une page, lisible sans connaissance informatique (connexion avec le compte Windows, catégories, suivi, réponse, validation).
Ce qui reste hors de cette étape : accès depuis la zone VISITEURS (refusé par choix, aucune règle ajoutée) ; certificat LDAPS à renouveler avant le 11/11/2031 (dette T-21).
12/11 : le portail est annoncé aux salariés à deux endroits. (1) La page d’accueil de l’intranet INTRALAB a une section
« Besoin d’aide ? L’assistance informatique » avec un bouton vers https://glpi.sio.internal/ (script
scripts/site-gsb/ajouter-lien-assistance.php, repris dans construire-site-gsb.php). (2) La charte informatique de GSB est publiée
dans la foire aux questions du portail (article n° 2, visible de toutes les entités), et la bannière de connexion des postes
(GPO GPO-Ordi-Banniere-Connexion) y renvoie. Au passage, construire-site-gsb.php portait encore le nom d’Axel (retiré du site en
ligne le 11/11) : corrigé.
Étape 74 — Un poste Windows prêt dès son arrivée dans le domaine : deux GPO, LAPS, SSH par clé (phase 21, 11/11)
Objectif. Jusqu’ici, chaque poste Windows recevait à la main ce que le MO-18 décrit : exporteur de mesures, envoi des
journaux, agents GLPI et Wazuh, règles de pare-feu. Désormais, le domaine le fait : un poste qui rejoint sio.internal
reçoit tout au démarrage suivant, sans geste sur le poste. Demande d’Axel (08/11).
74.1 Décisions d’Axel (21.1, 11/11)
Question
Choix
Pourquoi
Méthode
script de démarrage de GPO (compte SYSTEM), unique et relançable
l’« installation de logiciels » des GPO ne sait poser que des MSI sans paramètres (Fluent Bit est un .exe, Wazuh demande un mot de passe)
Source des installeurs
partage caché sur AD-Core-01, installeurs vérifiés d’avance
rien n’est téléchargé au démarrage ; un installeur modifié n’est pas exécuté
Secret d’inscription de Wazuh
fichier lisible seulement par les ordinateurs du domaine et les administrateurs
un salarié ne peut pas le lire ; limite : dette T-23
Sécurisation
pare-feu, LAPS, audit des connexions, SSH par clé (Defender renforcé écarté)
—
Ciblage
une OU de test d’abord, puis OU=Ordinateurs
aucune machine en service touchée pendant la mise au point
74.2 Le partage de déploiement (21.2)
C:\Deploiement sur AD-Core-01, partagé sous Deploiement$ : lecture pour les Ordinateurs du domaine, contrôle
total pour les Admins du domaine ; droits NTFS sans héritage (SYSTEM, Administrateurs, Admins du domaine, Ordinateurs
du domaine en lecture) : les utilisateurs n’y ont aucun accès. Installeurs, aux mêmes versions que poste-win11 :
Installeur
Version
Empreinte vérifiée
windows_exporter
0.31.9
SHA-256 de la publication GitHub
agent GLPI
1.21
SHA-256
Fluent Bit
5.1.3 (.exe : le .msi n’a pas d’empreinte publiée, H-36)
SHA-256
agent Wazuh
4.14.9
SHA-512 publiée par Wazuh
Plus : configuration de Fluent Bit, certificat public de GLPI, clé publiquetermix-lab, et le secret Wazuh déposé
par Axel (Read-Host, jamais vu par Claude). Scripts : scripts/gpo/preparer-partage-deploiement.ps1 et
creer-partage-deploiement.ps1.
74.3 La GPO « poste prêt » et son script (21.3)
GPO-Ordi-Poste-Pret : script de démarrage \\AD-Core-01.sio.internal\Deploiement$\preparer-poste.ps1
(scripts/gpo/preparer-poste.ps1) et réglage « toujours attendre le réseau au démarrage ». Le script attend le partage
(2 min au plus), déduit la zone de l’adresse IP, revérifie chaque empreinte, puis installe ce qui manque :
windows_exporter, Fluent Bit (et sa configuration), agent GLPI (TAG = zone, donc la bonne entité), agent Wazuh, et
la partie SSH (74.4). Journal : C:\ProgramData\Lab\preparer-poste.log ; le mot de passe Wazuh n’y est jamais écrit.
Test réel (VM 141 POSTE-TEST-GPO, Windows 11 Pro, temporaire, compte ordinateur pré-créé dans OU=Postes-test) :
jointe au domaine par Axel, puis au démarrage suivant, en 3 minutes et sans geste : les 4 agents installés, l’agent
Wazuh Active, l’ordinateur dans GLPI (GSB > USERS), ses journaux en base (capture 266). Au passage suivant :
« déjà présent » pour tout, rien n’est réinstallé.
74.4 La GPO de sécurisation et LAPS (21.4)
Schéma de l’AD étendu pour LAPS par Axel (Update-LapsADSchema, compte membre des « Administrateurs du schéma »,
définitif) : 7 attributs msLAPS-… ; puis Set-LapsADComputerSelfPermission sur OU=Ordinateurs.
sauvegarde dans l’AD (chiffrée), 16 caractères, complexité 4, 30 jours ; compte géré admin-laps créé par Windows (Windows 11 24H2 / Server 2025)
Pare-feu (règles dans la GPO)
9182 ← srv-metriques seul ; 22 et 3389 ← zone ADM seule
Bureau à distance
autorisé, avec authentification au niveau du réseau (NLA)
Audit avancé
validation des identifiants, ouverture de session (succès et échec), fermeture, verrouillage (échec), ouverture spéciale, gestion des comptes et des groupes
SSH par clé (dans le script de démarrage) : OpenSSH Server installé (22 min au premier passage : il vient de
Windows Update), clé publique termix-lab dans administrators_authorized_keys (droits stricts), mot de passe et
keyboard-interactive coupés, règle locale « SSH depuis partout » désactivée.
Preuves (capture 267, 268) : admin-laps créé, mot de passe changé et sauvegardé dans l’AD (événements 10020 et
10018, 1 269 octets chiffrés, non déchiffrés) ; règles du pare-feu reçues ; 7 sous-catégories d’audit appliquées ;
srv-metriques lit les mesures (200) ; le port 22 est refusé depuis USERS ; le serveur SSH n’annonce plus que
publickey ; connexion Termix par clé réussie. Bonus de l’audit : la création de admin-laps a levé l’alerte Wazuh
60154 « Administrators Group Changed » (niveau 12), preuve qu’un ajout au groupe Administrateurs est détecté.
Échéance du mot de passe LAPS vérifiée le 12/11 : le 11/12/2026, soit 30 jours, comme le veut la politique.
Une première lecture avait fait croire à 24 h : la date était affichée au format américain (mois en premier), voir H-101.
74.5 Côté serveurs : une commande (21.5) et le test complet (21.6)
La GPO ne peut pas modifier un serveur Linux : ajouter-poste-windows.sh (bastion, scripts/supervision/) vérifie
que srv-metriques lit les mesures, dépose le fichier de cible cibles/windows/<nom>.yml et attend que Prometheus
voie le poste « up ». Lancé par Axel : le poste est apparu dans Grafana (capture 269). Les règles d’alerte sont
génériques (« Machine injoignable » sur up{job=~"node|windows"}, disque, mémoire, processeur par machine) : rien
à ajouter.
Mise en service (11/11, décision d’Axel) : les deux GPO liées à OU=Ordinateurs (4 GPO sur cette OU avec la
bannière et le ping) ; poste-win11 les reçoit : admin-laps créé, pare-feu et audit appliqués, script de
démarrage à 17:25 (rien réinstallé, SSH par clé seulement) ; son hôte Termix est passé à la clé. La VM de test a été
supprimée proprement : cible Prometheus d’abord (sinon alerte « Machine injoignable »), agent Wazuh, ordinateur
GLPI, compte AD, puis la VM et ses disques.
Incidents : H-98 (barres obliques réduites par le terminal de Claude : chemin du script
faux) ; extension « Registre » de la première GPO mal tapée (…CF2B au lieu de …CFA2, H-99) ; redémarrage de
poste-win11 par Proxmox en délai dépassé, VM restée éteinte (H-100). Dette : T-23.
Étape 75 — La charte informatique de GSB : l’écrire, la faire connaître, contrôler son respect (preuve E5 C1, 12/11)
Objectif. Prouver la compétence « vérifier le respect des règles d’utilisation des ressources numériques » par une
démarche simple : écrire la règle, la faire connaître, contrôler qu’elle est respectée (demande de la
conversation du dossier, 11/11 ; fiche E5 RP11).
Temps
Ce qui a été fait
Preuve
1. Écrire
Charte-informatique-GSB.md, v1.0 validée par Axel le 12/11 : 8 règles, et pour chacune comment elle est appliquée dans le lab (comptes nominatifs, mots de passe du domaine, pas d’installation par l’utilisateur, protections imposées par GPO, sortie Internet limitée, détection d’intrusion, réseau invité cloisonné) ; ce qui est enregistré et combien de temps (journaux 6 mois, recommandation CNIL) ; comment le respect est vérifié
le document
2. Faire connaître
bannière de connexion des postes (GPO GPO-Ordi-Banniere-Connexion, titre « Accès réservé - GSB ») qui renvoie à la charte ; charte publiée dans la foire aux questions du portail GLPI (article n° 2, visible de toutes les entités) ; section « Besoin d’aide ? » avec un bouton vers le portail sur la page d’accueil de l’intranet INTRALAB (scripts/site-gsb/ajouter-lien-assistance.php)
captures 273, 275, 274
3. Contrôler
un logiciel interdit (Wireshark, capture du trafic réseau, choisi par Axel) installé sur poste-win11 (MSI officiel, empreinte SHA-256 vérifiée contre la liste de l’éditeur avant exécution) → inventaire GLPI forcé : l’écart apparaît (162 logiciels au lieu de 161) → ticket n° 95 rattaché à l’ordinateur, suivi citant la règle n° 3 → retrait à distance → nouvel inventaire : 161 logiciels, plus de Wireshark → ticket clos. 12:00 → 12:06
capture 276
Choix écarté en route : CCleaner (premier choix d’Axel). Son installeur officiel était bien signé par l’éditeur
(Gen Digital), mais son empreinte ne correspondait pas à celle du catalogue winget (l’adresse officielle sert toujours la
dernière version). Règle tenue : un fichier dont l’empreinte ne peut pas être vérifiée n’est pas exécuté ; il a été
supprimé et remplacé par Wireshark, dont l’éditeur publie les empreintes.
Liste des logiciels autorisés (tâche 24.4, validée par Axel le 12/11) : Liste-logiciels-autorises.md,
tirée de l’inventaire de référence de poste-win11 (161 logiciels) : 137 autorisés, 12 tolérés (applications grand public
de Windows), 12 non autorisés (jeux, Assistance rapide, Power Automate, Dev Home, et Kudu, un nettoyeur système installé
lors de la préparation du poste). Deuxième contrôle réel, sur décision d’Axel : Kudu signalé par le ticket n° 98, retiré à
distance, nouvel inventaire vérifié (160 logiciels, plus de Kudu), ticket clos ; 13:15 → 13:17 (capture 278). La charte publiée dans GLPI porte l’en-tête « service informatique de GSB » et la liste en annexe (vue d’un salarié de GSB > USERS : capture 277).
Limite, à dire à l’oral : Aujourd’hui, l’écart se repère en comparant les inventaires
(avant / après) ; GLPI ne lève pas d’alerte automatique sur un logiciel hors liste.
Étape 76 — Qualité de service : limiter le débit de la zone VISITEURS pour protéger le site (test T21, tâche 15.11, 12/11)
Objectif. Un invité qui télécharge beaucoup ne doit pas ralentir le travail des salariés. Ses paquets traversent le même
pare-feu (2 processeurs) que ceux des salariés vers le site de GSB. On le prouve par la mesure : à vide, sous charge sans
limite, puis sous la même charge avec un plafond de débit pour toute la zone VISITEURS (recette 7 du plan de tests R1, T21).
Prévu « après le BTS blanc » (décision du 05/11), avancé le 12/11 à la demande d’Axel.
76.1 — Méthode (validée par Axel)
Élément
Choix
Pourquoi
Générateur de charge
iperf3 3.18 sur poste-visiteur (dépôt officiel Debian, 137 Ko), 4 flux en parallèle pendant 40 s
outil standard de mesure de débit ; charge courte, car l’hyperviseur porte aussi les VM d’autres élèves
Serveur de test
pfSense lui-même : paquet officiel iperf (pfSense-pkg-iperf 3.0.6 et iperf3 3.21), installé par Axel ; serveur lancé à la main, arrêté après
un visiteur n’a le droit de joindre aucun serveur interne ; un serveur public aurait saturé la vraie connexion de l’école, et l’hyperviseur est partagé
Ouverture temporaire
règle « TEMPORAIRE test T21 iperf3 » en tête de l’onglet VISITEURS : 10.0.50.200 → This Firewall, TCP 5201 (capture 279)
le moins ouvert possible : un seul poste, un seul port, supprimée à la fin
Ce qu’on mesure
le site de GSB vu par un salarié : depuis poste-win11 (USERS), 15 essais de curl sur la page d’accueil et sur un fichier fixe (jquery.min.js, 87 553 octets) via HAProxy, plus un ping vers HAProxy ; script C:\ProgramData\Lab\mesure-site.ps1
c’est le service à protéger ; la médiane écarte un essai isolé
76.2 — Les limiteurs (posés par Axel, guidé)
Firewall → Traffic Shaper → Limiters → New Limiter, deux fois :
Champ
VISITEURS_ENVOI
VISITEURS_RECEPTION
Enable
Bandwidth
50 Mbit/s
50 Mbit/s
Mask
None : un plafond pour toute la zone, pas par appareil
None
File d’attente
Tail Drop, ordonnanceur par défaut (WF2Q+), autres champs vides
idem
Puis, dans Firewall → Rules → VISITEURS, sur la règle « Sortie Internet HTTP et HTTPS » (et le temps du test sur la règle
temporaire) : Extra Options → Display Advanced → In / Out pipe = VISITEURS_ENVOI / VISITEURS_RECEPTION. Sur une règle
d’interface, In est ce qui entre dans pfSense par la zone, donc ce que les visiteurs envoient ; Out, ce qu’ils reçoivent.
Vérification (console de pfSense) :
dnctl pipe show
00001: 50.000 Mbit/s et 00002: 50.000 Mbit/s.
pfctl -sr | grep vtnet1.50
la règle « Sortie Internet HTTP et HTTPS » se termine par dnpipe(1, 2). Capture 280.
76.3 — Résultats (capture 281, mesures de 13:59 à 14:19)
Mesure
Page d’accueil (médiane, pire)
Fichier fixe
Ping HAProxy (médiane, pire)
Débit de poste-visiteur
1. À vide
138 ms (153)
34 ms
0 ms (0)
—
2. Charge sans limiteur
344 ms (1 333)
69 ms
2 ms (27)
2,43 Gbit/s
3. Charge avec limiteur, sens envoi
136 ms (150)
42 ms
0 ms (0)
48,5 Mbit/s
3 R. Charge avec limiteur, sens réception (iperf3 -R)
137 ms (154)
37 ms
0 ms (0)
48,7 Mbit/s
Sans limite, un seul poste invité occupe 2,4 Gbit/s et le site des salariés devient 2,5 fois plus lent (jusqu’à 1,3 s).
Avec 50 Mbit/s par sens pour toute la zone, le même poste est plafonné et le site garde son temps de réponse à vide, dans les
deux sens. Le contrôle « la charge dégrade vraiment le site » a été fait avant de poser le limiteur : un limiteur qui n’a
rien à protéger ne prouverait rien.
76.4 — Remise en état, vérifiée à 14:21 : règle temporaire supprimée par Axel ; serveur iperf3 de pfSense arrêté ;
iperf3 depuis poste-visiteur → Connection refused (la règle 3 de refus vers pfSense répond à nouveau) ; Internet depuis la
zone : https://deb.debian.org/ → 200 en 0,06 s. Le paquet iperf reste installé sur pfSense pour refaire la mesure.
Limites, à dire à l’oral : la charge vise le pare-feu (le seul point qu’un invité peut joindre) ; de vrais invités
chargeraient la sortie Internet, qui porte le même limiteur. 50 Mbit/s est un choix de départ (l’ordre de grandeur d’un Wi-Fi
invité), à ajuster au nombre d’invités. Piste suivante : l’algorithme FQ-CoDel réduirait aussi la latence sous charge (non
testé, une seule variable changée à la fois). Incident de la séance : H-102 (port source rempli par erreur).
5. Dettes de configuration et points ouverts
Cette section ne recense que les écarts assumés encore en place : configurations temporaires,
dérogations à l’architecture, et corrections d’hygiène en attente.
Les incidents rencontrés et leur résolution sont consignés séparément dans
Troubleshooting.md — symptôme, cause réelle, correction et
enseignement, pour chacun des problèmes traversés depuis le début du TP.
5.1 Configurations temporaires à retirer
#
Écart
Pourquoi il est là
Quand le retirer
T-1
Règle allow all sur le WAN, créée par enableallowallwan
Seul moyen d’atteindre l’interface d’administration avant l’existence du VLAN ADM
Soldée le 25/09 — décochée (non supprimée : trace documentaire). L’onglet WAN ne comporte plus aucune règle entrante active. L’accès distant passe par Tailscale, le secours est la console Proxmox. Depuis le 15/10, une seule exception : la règle associée à la redirection PVE_HOST → SRV_PBS : 8007 (étape 44.3), limitée à l’hyperviseur.
T-2
Règle USERS → USERS address : PORTS_ADMIN_FW
Permet d’administrer pfSense depuis poste-win11 ; contredit la décision « administration depuis le VLAN 30 uniquement » (§2.6)
Soldée le 25/09 — décochée. L’administration se fait désormais par Tailscale ou depuis le bastion, conformément à la décision d’architecture.
T-3
Règle BDD → any : PORTS_WEB
Accès Internet le temps d’installer MySQL
Soldée le 25/09 — décochée après l’installation de MariaDB. Vérifié : curl vers Internet expire depuis srv-mysql.
T-4
ICMP autorisé entre tous les VLAN
Indispensable au diagnostic pendant la construction
Phase 8 — à restreindre à ADM subnets comme source
T-5
SSH activé sur pfSense, exposé côté WAN
Permet le rebond ProxyJump vers les VM depuis le poste de travail
Depuis le 25/09 (T-1 soldée), le WAN n’a plus de règle entrante, sauf la redirection 8007 réservée à l’hyperviseur (T-1) : SSH n’y est plus joignable. SSH reste activé et sert depuis le bastion (10.0.30.1, registre F-02). Reste à décider en phase 8 : le garder (bastion) ou le couper
T-7
bind-address = 0.0.0.0 sur les 3 nœuds Galera (étape 28.2)
La réplication exige d’écouter sur plusieurs ports — le verrou 1 posé à l’étape 24.5 ne peut pas être conservé
Assumée, non résoluble. Compensée par le verrou 2 (règle SRV_HA → GALERA_NODES : 3306, seule porte vers le VLAN 20) et le verrou 3 (GRANT restreint par adresse d’origine)
T-11
UseRootHint = True sur le serveur DNS d’AD-Core-01
Valeur par défaut, conservée délibérément : si le résolveur de pfSense tombe, la résolution des noms externes survit — y compris pendant le diagnostic de cette panne. La règle ADM n°6 rend ce repli réellement praticable
Assumée. Le pare-feu reste le point de passage unique ; seul le résolveur cesse de l’être, et uniquement en mode dégradé. La zone interne reste servie par le contrôleur, qui en est l’autorité. Réversible : Set-DnsServerForwarder -IPAddress 10.0.30.1 -UseRootHint $false
T-12
Interface d’administration de pfSense publiée par Pangolin (ressource d’essai) et nom alternatif pfsense.pangolin.<domaine> déclaré dans Admin Access(étape 41) ; le connecteur du tunnel hérite de tout ce que srv-docker atteint (étape 40), élargi seulement par la règle ADM 4 bis SRV_BASTION → SRV_HA : 8404(étape 42) ; ressources d’essai : Termix, pfSense, statistiques HAProxy, Portainer, Proxmox, Grafana (depuis le 23/10, étape 50.6), Wazuh (depuis le 03/11, phase 16) ; depuis le 28/10, le chemin /api/health de la ressource Grafana est public (règle « toujours autoriser » de Pangolin, pour la sonde de bout en bout, étape 52.3) : il dévoile que Grafana fonctionne et sa version
Essai de l’accès externe (phase 12, arrêtée le 05/11 : l’accès Termix du formateur suffit ; tunnel et ressources laissés tels quels) ; deux barrières : authentification de Pangolin puis mot de passe de pfSense. Depuis le 10/11, le tunnel sert aussi le site public de GSB (étape 72)
Avant tout accès externe réel — supprimer la ressource et le nom alternatif, et borner par des règles ADM ce que srv-docker peut joindre ; garder ou non la règle /api/health selon l’usage de la sonde
T-14
Exporteurs de supervision sans vérification de certificat(étape 52) : pbs-exporter (-pbs.insecure=true) et prometheus-pve-exporter (verify_ssl: false) acceptent les certificats autosignés de PBS et de pve-01 ; un compte de lecture metriques-axel@pve existe sur l’hyperviseur partagé de l’école
Certificats autosignés ; même réseau de confiance (PBS dans le VLAN 30) ; le compte Proxmox est en lecture seule (PVEAuditor), limité au pool SIO2527_Axel et à la VM 137
Déposer l’autorité de certification de PBS et de pve-01 sur srv-metriques, puis activer la vérification ; supprimer le compte Proxmox à la fin du lab
T-13
Mise à jour du 12/11 : en grande partie soldée — phase 13 terminée le 06/11 : copie hors site sur le NAS d’Axel chaque nuit (étape 65), export SQL nocturne des bases (étape 63), restauration depuis la copie prouvée (65.3), alertes de la copie éprouvées (test T30, 11-12/11). Restent assumés : sauvegardes non chiffrées, RAM de PBS (2 Gio), configuration de pfSense sans export hors de la VM, copie hors site non immuable (T-22). Texte d’origine :Sauvegarde encore incomplète(étapes 43, 44 et 49) : réglé : sauvegardes incrémentales sur PBS (15/10) ; disques des VM et sauvegardes sur deux supports distincts (VM sur Syno, datastore sur storage-images, 23/10) ; notifications par mail depuis PBS (23/10) ; anciens disques « Unused » supprimés (27/10). Restent : aucune deuxième copie (tout est dans l’école, pas de copie hors site) ; sauvegardes non chiffrées (choix assumé, elles contiennent les secrets du lab) ; pas d’export logique des bases ; RAM minimale de PBS (2 Gio) sous la recommandation ; configuration de pfSense : aucun export hors de la VM (décision du 17/10)
Chaîne PBS en place le 15/10, complétée le 27/10
Phase 13 : 2e copie (13.6), export des bases (13.8)
T-15
Clé SSH des scripts du bastion sans phrase de passe(30/10) : ~/.ssh/id_ed25519 du compte ipfixe de srv-docker ouvre poste-visiteur, qui n’accepte plus le mot de passe SSH
Choix d’Axel, assumé : le bastion est le point le plus protégé du lab et détient déjà le coffre Termix, qui ouvre toutes les machines ; une phrase de passe n’ajouterait qu’une protection marginale
Assumée — correction possible à tout moment : ssh-keygen -p -f ~/.ssh/id_ed25519
T-16
La supervision dépend du cluster qu’elle surveille(02/11, H-66) : la base de Grafana est dans Galera ; à la perte de 2 nœuds sur 3, Grafana ne calcule plus aucune alerte, seule « Supervision aveugle » prévient
Utiliser le cluster est une exigence du projet ; une perte de quorum est déjà une panne totale du site
Assumée (décision d’Axel) — la règle « Supervision aveugle » nomme les deux causes possibles ; piste d’amélioration (idée d’Axel, 02/11) : si, en production, on perd trop souvent l’accès à la supervision, envisager plus de nœuds dans le cluster (toujours en nombre impair : 5 nœuds, ou un arbitre Galeragarbd qui vote sans stocker de données ; un 4ᵉ nœud seul ne suffirait pas, 2 sur 4 n’est pas une majorité) ou un autre outil d’alerte hors du cluster (Alertmanager de Prometheus)
T-17
srv-wazuh sous le minimum officiel de mémoire(03/11, étape 59.1) : 6 Gio fixes, là où Wazuh demande 8 Gio pour 1 à 25 agents ; tas Java de l’indexeur à 1 Gio ; swap déjà utilisé (265 puis 631 Mio le premier jour)
Essai assumé, décision d’Axel (02/11) : l’hyperviseur partagé de l’école est à 81 % de sa RAM, 8 Gio est irréaliste ; une semaine de mesure (03 → 10/11) tranche
Assumée — bilan de la semaine de mesure (11/11) : mémoire 2,5 Gio en moyenne et 2,7 au plus sur 5,8 ; swap 1,0 Gio au plus mais quasi inactif (0,7 page/s) ; processeur 1,4 % en moyenne ; disque 29 Gio sur 61, stable (dont 14 Gio de base de vulnérabilités) → décision d’Axel : étendre les agents à toutes les machines (16.7). À recontrôler une semaine après l’extension (swap, disque)
T-18
Détection sans blocage, et 3 zones sans sonde réseau(03/11, étape 60.5) : Suricata est en mode détection seule (Block Offenders décoché) sur VISITEURS et USERS ; WEB, BDD et ADM n’ont pas de sonde réseau
Mode détection : le blocage automatique sur des cartes virtuelles n’est pas vérifié et un faux positif couperait un service ; 3 zones : chaque instance coûte ≈ 370 à 400 Mo sur un pfSense de 2 Gio (674 Mo libres avec deux instances)
Assumée (décision d’Axel, 03/11) — les machines des 3 zones auront un agent Wazuh (16.7) ; option B à tester plus tard : une seule instance sur le trunk vtnet1 pour les 5 zones ; un peu de RAM en plus sur pfSense est possible, au-delà de 2 Gio de plus on passe à B ; le blocage reste à décider après observation des faux positifs
T-8
Un seul contrôleur de domaine (AD-Core-01) : le second, AD-Core-02 (10.0.30.11, Windows Server 2025 Core), est reporté sans échéance
Ressources de l’hyperviseur partagé ; priorité donnée aux autres phases
Assumée — en cas de panne d’AD-Core-01 : plus d’ouverture de session de domaine ni de DNS interne ; la restauration se fait depuis PBS (sauvegarde nocturne). Résolution : créer AD-Core-02 (tâches 5.4 et 6.7 du suivi)
T-9
Points uniques de l’infrastructure : une seule VM pfSense (fw-01) et un seul hyperviseur (pve-01, celui de l’école)
Lab sur un seul hôte ; pas de second pare-feu (CARP)
Assumée — leur panne arrête tout le lab ; pfSense est sauvegardé par PBS chaque nuit
T-20
Adresse réelle des visiteurs perdue sur le site public(10/11, H-96)
Traefik (Pangolin) écrasait l’adresse d’origine du visiteur
Réglée le 11/11 : en-tête X-Client-Real-IP posé par Nginx Proxy Manager, lu par HAProxy et Matomo. Reste en place, devenu inutile : forwardedHeaders.trustedIPs dans la configuration de Traefik
T-21
Certificat LDAPS de AD-Core-01auto-signé(11/11, phase 19)
Pas d’autorité de certification dans le lab ; le contrôleur refuse le LDAP en clair (H-97)
GLPI vérifie un certificat auto-signé installé à la main sur srv-web-01 et srv-web-02. Expire le 11/11/2031 (rappel au tableau de bord). À remplacer par un certificat d’une autorité interne si le lab grandit ; en cas de renouvellement, le réinstaller sur les deux serveurs web (update-ca-certificates) et dans les autorités racines du contrôleur.
T-23
Secret d’inscription des agents Wazuh lisible par tout ordinateur du domaine(12/11, phase 21) : fichier secret\wazuh-inscription.txt du partage Deploiement$ d’AD-Core-01, lu par le script de démarrage de la GPO
Choix d’Axel (11/11) : sans lui, l’agent Wazuh ne peut pas s’installer seul
Assumée. Le fichier n’est lisible que par les ordinateurs du domaine et les administrateurs, pas par les utilisateurs ; limite : quelqu’un qui est administrateur d’un poste du domaine peut le récupérer, et inscrire une machine dans Wazuh. Parade si besoin : changer le mot de passe d’inscription (/var/ossec/etc/authd.pass et le fichier du partage)
T-22
Copie hors site en ligne, non immuable(11/11, phase 20 arrêtée)
Le NAS n’a pas la place de garder plus de sauvegardes ; PBS ne gère pas le verrouillage d’objets
Risque accepté par Axel : le lab applique la règle 3-2-1-0 (3 copies, 2 supports, 1 hors site, 0 erreur à la vérification), pas 3-2-1-1-0. Quiconque détient les clés S3 du lab pourrait effacer la copie du NAS. Étude du 11/11 : PBS ne gère pas le verrouillage d’objets S3 (déduplication : morceaux partagés, ramasse-miettes) ; des instantanés ZFS en lecture seule du dataset du NAS conviendraient, mais le NAS n’a pas la place de garder davantage de sauvegardes. À reprendre si la capacité du NAS augmente.
5.2 Corrections d’hygiène en attente
#
Constat
Impact
État
H-1
Pare-feu Proxmox actif (firewall=1) sur net0 et net1 de la VM 103
Deux pare-feux empilés : un blocage au niveau du bridge serait invisible dans les journaux pfSense
Constaté le 05/11 : ni net0 ni net1 ne portent firewall=1, et le pare-feu Proxmox de la VM est à No (captures 187, 188)
H-2
ISO pfSense-CE-2.7.0 toujours monté dans le lecteur CD/DVD de la VM 103
Risque de réinstallation accidentelle par-dessus la 2.9.0
Constaté le 05/11 : lecteur ide2 sur none,media=cdrom (capture 187)
H-3
Environnement de bureau installé sur srv-web
RAM et surface d’attaque inutiles sur un serveur. Manifestation concrète : avahi-daemon, installé avec le bureau, émettait du mDNS (UDP 5353 vers 224.0.0.251 et ff02::fb) que le block-all implicite rejetait en boucle — les journaux du pare-feu en étaient pollués.
Corrigé le 25/09 : sudo systemctl disable --now avahi-daemon.service avahi-daemon.socket. Le bureau reste en place — assumé, les VM suivantes en sont dépourvues.
H-4
Versions Debian hétérogènes : srv-web en 13, srv-docker en 12
Deux cycles de mises à jour et deux jeux de paquets à suivre
Assumé — voir étape 19D
H-5
Compte MariaDB 'haproxy_check'@'10.0.10.5' (sans mot de passe, sans droit) : ne servait plus depuis la sonde 9200 de srv-ha (étape 62)
Compte inutile, même sans droit
Supprimé le 05/11 à 13:20 (décision d’Axel) : DROP USER 'haproxy_check'@'10.0.10.5'; sur srv-mysql-01, recopié par Galera sur les 3 nœuds ; reste @10.0.30.15 (srv-supervision), qui sert toujours (capture 193)
H-6
lsyncd (recopie de wp-content vers srv-web-02) n’était surveillé par rien : arrêté du 29/10 au 05/11 sans alerte (H-84)
Le second serveur web peut servir un site différent sans que personne le sache
05/11 (décision d’Axel) : mesure lsyncd_processus (textfile de node_exporter, chaque minute) + 13ᵉ règle Grafana « lsyncd arrêté », testée par une panne réelle (alerte à 14:33:20, mail reçu, retour à la normale 14:44:20, capture 206) — voir étape 64
H-7
Un serveur web retiré par HAProxy (contrôle de santé en échec) ne déclenche aucune alerte tant que l’autre sert : srv-web-01 sorti 18 min le 05/11 sans mail (H-86)
Une panne d’un serveur passe inaperçue jusqu’à la panne du second
06/11 : mesure haproxy_serveur_up (script haproxy-etat.py sur srv-ha, toutes les 30 s) et règle Grafana « Serveur retiré par HAProxy » (5 min ; les retraits pendant les sauvegardes durent 78 s au plus), éprouvée par une panne provoquée — étape 68, capture 236
5.3 Décisions dérogatoires assumées
Rappel des deux écarts volontaires au canon, détaillés en §2.6 :
Sujet
Décision
Canon
Justification
Administration de pfSense
Depuis le VLAN 30 et une IP restreinte côté WAN
Zone d’administration uniquement, accès distant par VPN
Dérogation levée le 25/09. La règle WAN restreinte à POSTE_ADMIN n’avait en réalité jamais été créée, et la règle allow all est désormais décochée. L’accès distant se fait par tunnel Tailscale, sans aucun port ouvert : c’est le canon, pas un compromis.
Installation de MySQL
Ouverture Internet temporaire du VLAN BDD
Miroir ou proxy de dépôts interne (apt-cacher-ng)
Simplicité, et la règle désactivée documente la démarche
Portée du tailnet
Règle Pass any → any sur l’onglet Tailscale
Filtrage par ACL/tags côté Tailscale, ou restriction aux ports d’administration
Le tailnet ne compte que deux nœuds de confiance : ag-lenovo et fw-01. Voir T-6 ci-dessous.
S3 de la 2ᵉ copie (étape 65)
Exposé sur Internet sans liste d’adresses autorisées ; interface d’administration de SeaweedFS publiée
Liste d’adresses autorisées ; interface d’administration non publiée
Choix d’Axel (05/11) : « ça complique pour rien » — Le S3 exige ses clés (refus sans clé prouvé) et passe en HTTPS ; un vol des clés permettrait d’effacer la copie hors site, pas celle du lab. Interface d’administration : gardée publiée (décision d’Axel du 06/11), protégée par son propre mot de passe
5.4 T-6 — Le tailnet contourne la segmentation, et c’est assumé
Constat établi lors du test 7.3. Un Test-NetConnection 10.0.20.10 -Port 3306 lancé depuis
ag-lenovo répond True — alors que le même test depuis poste-win11 doit échouer.
   poste-win11 (10.0.40.100)          ag-lenovo (100.67.68.78)
          │                                    │
     interface USERS                    interface tailscale0
          ▼                                    ▼
   ┌──────────────────┐              ┌──────────────────────┐
   │ règles USERS 1→7 │              │ Pass  any → any      │
   │ règle 6 : Reject │              │                      │
   └──────────────────┘              └──────────────────────┘
           bloqué                              tout passe
Ce n’est pas un défaut de configuration, c’est la conséquence directe du principe n°1 :
les règles s’appliquent en entrée d’interface. Un paquet arrivant par tailscale0 ne
rencontre jamais les règles de l’onglet USERS.
Pourquoi la dérogation est défendable
Argument
Détail
Périmètre fermé et nominatif
Le tailnet ne compte que deux nœuds : ag-lenovo et fw-01. Aucun appareil ne rejoint un tailnet sans être explicitement autorisé dans la console d’administration.
Authentification par identité
L’appartenance repose sur un compte, pas sur une adresse IP ni une clé partagée. C’est un périmètre d’identité, pas de réseau.
Équivalent fonctionnel
Ce chemin joue le rôle d’un accès console hors-bande, comme la console Proxmox — lui aussi hors de portée du pare-feu.
Chiffrement de bout en bout
WireGuard, sans aucun port ouvert en entrée sur le WAN.
Ce qui conditionne la validité de cet argument
La sécurité de tout le lab repose désormais sur le compte Tailscale. Trois mesures
gratuites à mettre en place :
#
Mesure
Où
1
Double authentification sur l’identité Google du tailnet
compte Google
2
Device approval — tout nouvel appareil doit être validé manuellement
console Tailscale → Settings → Device management
3
Revue périodique de la liste des machines du tailnet
console Tailscale → Machines
Sans le point 2, quiconque obtiendrait l’identité Google pourrait inscrire une machine
dans le tailnet et hériter aussitôt d’un accès complet aux cinq VLAN (VISITEURS est annoncé depuis le 12/11). L’approbation manuelle
transforme un secret unique en double condition.
Restaure la segmentation mais interdit le diagnostic direct (mariadb -h, nc -zv) depuis le poste — trop contraignant pendant la construction
C
ACL / grants par tag côté Tailscale
La version canonique. À retenir comme piste d’amélioration : le filtrage remonterait dans le tailnet lui-même, avant même d’atteindre pfSense
Question probable en soutenance : « votre segmentation est-elle contournable ? »
La réponse est oui, par le tailnet, et c’est un choix documenté — périmètre de deux
appareils nominatifs, rôle d’accès d’administration hors-bande, avec l’option C identifiée
comme évolution.
6. Reste à faire
La liste complète, ses dépendances et son avancement sont tenus dans SUIVI-TP.md,
qui fait foi. Résumé au 12/11/2026 (190 tâches sur 214, 89 %) :
Acquis — phases 1 à 4 (socle pfSense, VLAN, pare-feu), 9 (accès distant Tailscale), 10 (haute disponibilité :
HAProxy, 2 serveurs web, cluster Galera), 11 (GLPI), 13 (sauvegarde, copie hors site, restauration prouvée),
17 (LogAnalyzer), 19 (portail GLPI des salariés). Arrêtées après décision : 12 (accès externe : l’accès Termix du
formateur suffit) et 20 (copie immuable : pas de place sur le NAS, dette T-22).
En cours
Phase 21 — GPO « poste Windows prêt à l’arrivée » : en service sur OU=Ordinateurs ; reste la documentation (21.7)
Phase 16 — détection d’intrusion : extension des agents Wazuh à toutes les machines (16.7, décidée le 11/11)
Phase 18 — Matomo et site public : les vraies visites (18.8, avec le temps)
Phase 14 — supervision : compte lecteur du formateur et export du tableau de bord, en fin de lab (14.11)
Phases 5 à 8 — reliquats : second contrôleur AD-Core-02 (dette T-8), relecture finale de la documentation (8.4)
À venir
Phase 22 — mise à jour de tout le lab (systèmes, pfSense, Windows, applications), puis non-régression
Phase 23 — revue des règles d’alerte (trop de mails), décisions règle par règle avec Axel
Après le BTS blanc : fermer le mot de passe SSH de srv-metriques, compte collaborateur de l’intranet
Points d’hygiène — tous soldés (§5.2), dont le pare-feu Proxmox sur net0/net1 et l’ISO 2.7.0 retiré
(constatés le 05/11).
Pistes d’évolution — si le temps le permet (à cadrer avec Axel, rien n’est décidé) (29/10/2026)
1. GLPI qui reçoit les alertes (phase 11) — réalisée le 06/11 (étape 70, MO-23), sans n8n : un petit relais sur srv-supervision reçoit les alertes de Grafana et crée ou résout les tickets par l’API de GLPI. Idée d’origine : idée d’Axel : installer GLPI sur srv-web-01/02, derrière HAProxy
comme WordPress, avec sa base glpi_lab dans Galera, et faire créer un ticket GLPI par chaque alerte Grafana,
puis le résoudre quand l’alerte retombe. Circuit envisagé : Grafana → webhook → n8n (conteneur sur le bastion)
→ API de GLPI ; l’identifiant unique de l’alerte évite les tickets en double. Inspiration : le projet
xavier-maugendre/n8n-zabbix-glpi-prometheus-agent-qdrant-offline (dossier centreon/), sans sa partie IA,
facultative selon son auteur. Points à trancher : VLAN, serveurs web (1 Gio aujourd’hui, à passer à 2 Gio) ou VM
dédiée, synchronisation du dossier files/ de GLPI entre les deux serveurs, connexion à l’Active Directory.
Préalable : terminer les alertes Grafana (14.8) avec une étiquette de gravité, qui servira à choisir ce qui part en ticket.
2. Haute disponibilité de l’accès distant (Termix et Pangolin) — une seconde VM bastion (srv-docker-02, VLAN 30) :
Élément
Comment
Pangolin
un second site (connecteur pangolin-site sur srv-docker-02) et une seconde cible par ressource, avec contrôle de santé ; bascule automatique entre sites à vérifier dans la version 1.24
Termix
la documentation officielle prévoit une base externe (DATABASE_DIALECT=mysql, DATABASE_URL=mysql://…) : les deux Termix partageraient une base termix dans Galera (via srv-ha:3306), avec les mêmes secrets fournis aux deux (JWT_SECRET, DATABASE_KEY, ENCRYPTION_KEY, INTERNAL_AUTH_TOKEN, GUACAMOLE_ENCRYPTION_KEY)
pfSense
ajouter l’adresse de la nouvelle VM à l’alias SRV_BASTION (toutes les règles du bastion la couvrent) ; nouvelle règle bastion → SRV_HA : 3306
À vérifier avant tout : le fonctionnement à plusieurs serveurs n’est pas documenté comme un mode supporté ;
Galera exige une clé primaire sur chaque table (Termix n’est annoncé que pour MySQL) ; la version de Termix en place ;
la migration depuis SQLite (non documentée). Une session SSH ouverte sur l’instance qui tombe est coupée (on se
reconnecte sur l’autre). Sécurité : le coffre de Termix (hôtes, identifiants, clés SSH privées) quitterait la VM
pour Galera : la base termix et ses sauvegardes deviendraient aussi sensibles que le volume termix-data.
Limites : ne protège ni de la panne de pve-01 ni de celle de pfSense (dette T-9), ni de celle du serveur
Pangolin (seul, chez Axel). Alternative plus simple : chronométrer une restauration de srv-docker depuis PBS et
documenter ce temps de rétablissement. Démarche proposée : un essai sur une VM jetable (Termix branché sur une base
termix_test) avant toute décision.
Sources : Termix sur GitHub ·
variables d’environnement de Termix.
Annexe — Convention de nommage des captures
Les captures d’écran sont stockées dans le sous-dossier captures/ et nommées :
NN-description-courte.png
où NN correspond au numéro de l’étape de la section 4 (00 pour les documents de cadrage).
Inventaire
Fichier
Étape
Contenu
00-schema-cible-v2.png
§1
Schéma cible au propre
00-schema-cible.jpg
§1
Schéma manuscrit d’origine
06-system-information.png
6
System Information après mise à jour 2.9.0
07-vlans-crees.png
7
Liste des 4 VLAN créés
08-dashboard.png
8
Tableau de bord après changement du mot de passe
09-proxmox-reseau.png
9A
Proxmox — Système > Réseau, bridge vmbr1
09-proxmox-materiel.png
9B
Proxmox — Matériel de la VM 103
10-assignments.png
10B
Interface Assignments
10-status-wan-lan.png
10C
Status > Interfaces — WAN et LAN
10-status-web-bdd.png
10C
Status > Interfaces — WEB et BDD
10-status-adm-users.png
10C
Status > Interfaces — ADM et USERS
10-status-services.png
10D
Status > Services — dhcpd actif
11-aliases-ip.png
11
Alias — onglet IP
11-aliases-ports.png
11
Alias — onglet Ports
12-regles-users.png
12
Règles de pare-feu — onglet USERS
13-regles-web.png
13
Règles de pare-feu — onglet WEB
14-regles-bdd.png
14
Règles de pare-feu — onglet BDD
15-regles-adm.png
15
Règles de pare-feu — onglet ADM
16-nat-outbound.png
16
NAT sortant en mode Automatic
17-proxmox-poste-win11.png
17A
Proxmox — matériel de la VM Windows 11 (tag 40)
17-poste-win11-reseau.png
17B
Windows 11 — configuration réseau validée
17-poste-win11-dns-avant.png
17B
Windows 11 — premier bail, DNS incorrects
18-regles-tailscale.png
21
Règle de l’onglet Tailscale — Pass any → any
20-bind-address-avant.png
24.5
MariaDB n’écoute que sur 127.0.0.1:3306
21-bind-address-procedure.png
24.5
La séquence complète : constat, sed, vérification
22-ad-gui-config-reseau.png
23
AD-GUI — IPv4 statique, DNS auxiliaire vide
23-windows-sshd-config.png
22
sshd_config sous Windows
24-test-3306-srv-web-vers-mysql.png
25.2
Test 7.2 — srv-web → srv-mysql:3306
25-wordpress-tableau-de-bord.png
25.6
WordPress installé et fonctionnel
26-tables-wp-lab.png
25.7
Les 12 tables wp_* créées à distance
27-journal-mdns-avahi.png
H-3
mDNS d’avahi rejeté par le block-all implicite
28-test-7-3-cloisonnement.png
25.8
Test 7.3 — journal du refus USERS → 3306
29-wan-avant-mdp-defaut.png
H-08
WAN allow allet mot de passe par défaut
30-wan-apres-zero-regle.png
T-1
WAN — règle décochée, zéro règle entrante
31-termix-timeout-mdp.png
H-10
Termix : timeout après changement de mot de passe
32-alias-phase-10.png
10.7
Les alias après la phase 10, dont SRV_HA et GALERA_NODES
33-proxmox-clone-vm.png
27
Proxmox — boîte de dialogue Clone
34-erreur-alias-type-host.png
H-13
Alias Host(s) refusant un /10 — mauvais type
35-login-protection-sshguard.png
H-13
Login Protection — seuil, durée, liste blanche
36-h12-sed-sans-effet.png
H-12
Le sed sans effet : pas d’adresse dans le fichier
37-h12-networkmanager.png
H-12
Diagnostic — Wired connection 1
38-h12-nmcli-corrige.png
H-12
Les 4 paramètres corrigés par nmcli
39-srv-web-02-grant-refuse.png
29
Le GRANT par origine refuse le clone
40-replication-comptes-et-site.png
28.7
Comptes répliqués + site servi par srv-web-02
41-haproxy-galera-down.png
30
HAProxy — nœuds Galera DOWN (L4CON in 0ms)
42-regle-web-srv-ha-galera.png
30
La règle SRV_HA → GALERA_NODES : 3306
43-haproxy-stats-tout-vert.png
30
HAProxy — les 5 serveurs sains
44-users-vers-srv-ha-refuse.png
31
ERR_CONNECTION_REFUSED avant la règle USERS
45-test-7-7-repartition.png
32
Test 7.7 — alternance web-01 / web-02
captures/_archive/ contient les pièces écartées lors du tri du 27/09 : doublons
exacts (une capture renommée à côté de son original), vues redondantes, et une capture
sans rapport avec le TP. Rien n’a été supprimé — le dossier peut être vidé après relecture.