


Preuve — première alerte de bout en bout (Grafana → mail), 29/10/2026
Document autonome. Copie des deux mails reçus lors du test de la règle d’alerte « Service injoignable » (tâche 14.8, étape 54 de Documentation-pfSense.md). Les adresses sont masquées. Source : la boîte de copie, relevée le 29/10/2026 ; la boîte de l’administrateur a reçu les mêmes.
Le test
| Ce qu’on a provoqué | arrêt du conteneur termix sur srv-docker pendant 5 minutes, relance automatique : sudo systemd-run --unit=test-alerte-termix /bin/sh -c 'docker stop termix; sleep 300; docker start termix' |
| Ce qui devait se passer | sonde sonde_termix en échec → règle « Service injoignable » En attente 2 min → Déclenchée → chemin severite = critique (attente 10 s) → mail ; puis retour à la normale → mail « résolu » |
| Résultat | les deux mails sont arrivés, aux deux destinataires du point de contact mail-axel |
Chronologie (heure de Paris)
| Heure | Événement | Source |
|---|---|---|
| ≈ 13:55 | arrêt du conteneur termix | commande de test |
| 13:56 | première mesure en échec (probe_success = 0) | Prometheus |
| 13:56:00 | règle Normal → Pending (panne vue, attente de 2 minutes) | historique d’état Grafana |
| 13:58:00 | règle Pending → Alerting (panne confirmée) | historique d’état Grafana |
| 13:58:11 | mail [FIRING:1] remis, 11 s plus tard (attente de groupe du chemin critique : 10 s) | en-tête du mail |
| ≈ 14:00 | relance automatique de termix ; première mesure revenue à 1 à 14:01 | commande de test, Prometheus |
| 14:01:00 | règle Alerting → Normal | historique d’état Grafana |
| 14:03:11 | mail [RESOLVED] remis (il attend la fin de l’intervalle de groupe de 5 min) | en-tête du mail |
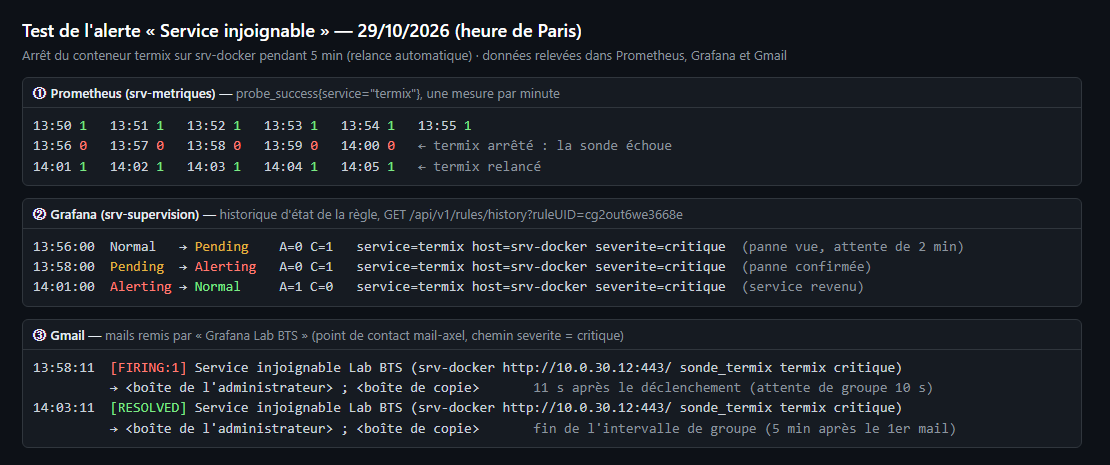
Le journal du test, en une image
Données relevées après le test : ① la sonde dans Prometheus (probe_success, une mesure par minute),
② l’historique d’état de la règle dans Grafana (API GET /api/v1/rules/history), ③ l’heure de remise des deux mails.
Les trois sources concordent : la sonde échoue de 13:56 à 14:00, la règle passe Pending à 13:56, Alerting à 13:58,
Normal à 14:01.
Mail 1 — la panne
Objet    : [FIRING:1] Service injoignable Lab BTS (srv-docker http://10.0.30.12:443/ sonde_termix termix critique)
De       : <compte d'envoi> (« Grafana Lab BTS »)
À        : <boîte de l'administrateur> ; <boîte de copie>
Reçu     : 29/10/2026 13:58:11

 Lab BTS › Service injoignable —  1 firing instances
Summary      : termix ne répond plus
Description  : La sonde de termix (machine srv-docker) échoue depuis plus de 2 minutes.
Values       : A=0 C=1
Labels       : alertname=Service injoignable · grafana_folder=Lab BTS · host=srv-docker
               instance=http://10.0.30.12:443/ · job=sonde_termix · service=termix · severite=critique
Observed 10s before this notification was delivered, at 2026-10-29 13:58:00 +0100 CET
Sent by Grafana v13.2.4
Mail 2 — le retour à la normale
Objet    : [RESOLVED] Service injoignable Lab BTS (srv-docker http://10.0.30.12:443/ sonde_termix termix critique)
Reçu     : 29/10/2026 14:03:11

 Lab BTS › Service injoignable —  1 resolved instances
Summary      : termix ne répond plus
Values       : A=1 C=0
Labels       : (identiques au mail 1)
Lecture
A=0 C=1: la requêteA(probe_success) vaut 0 (la sonde échoue), la conditionC(« A est inférieur à 1 ») est vraie → alerte. Au retour,A=1 C=0.- Les étiquettes du mail (
host,service,severite…) sont celles qui rempliront plus tard le ticket GLPI. - Point à corriger : les liens « View alert » et « Silence » pointent vers
http://localhost:3000, parce que l’adresse publique de Grafana (root_url) n’est pas déclarée. Ils ne s’ouvrent donc pas depuis la boîte mail. Corrigé le 29/10 à 14:44 :GF_SERVER_ROOT_URL=https://grafana.pangolin.<domaine>/dans/etc/default/grafana-server; le mail de test de 14:47 porte bien des lienshttps://grafana.pangolin.<domaine>/….
Test 2 — règle « Machine injoignable » (29/10/2026)
| Règle | up{job=~"node|windows"} inférieur à 1 pendant 2 min, severite = critique ; 13 machines surveillées (Linux, Windows, pfSense) |
| Ce qu’on a provoqué | arrêt de l’exporteur de mesures de srv-ha pendant 5 minutes (le répartiteur HAProxy continue, le site n’est pas coupé) : sudo systemd-run --unit=test-alerte-machine /bin/sh -c 'systemctl stop prometheus-node-exporter; sleep 300; systemctl start prometheus-node-exporter' |
| Résultat | mail [FIRING:1] à 15:19:11, mail [RESOLVED] à 15:24:12, aux deux destinataires |
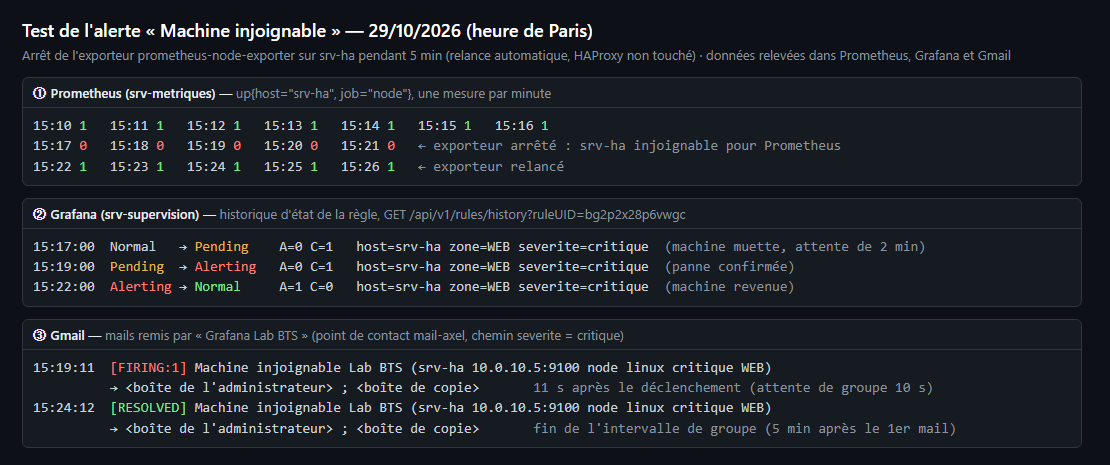
Message reçu : « srv-ha ne répond plus — L’exporteur de srv-ha (zone WEB) ne répond plus depuis plus de 2 minutes : machine
arrêtée, réseau coupé ou exporteur en panne. » Les liens du mail pointent vers https://grafana.pangolin.<domaine>/….
Ce test simule une machine injoignable du point de vue de la supervision (l’exporteur se tait). Une machine réellement arrêtée produit le même signal (
up = 0) : un arrêt réel de VM sera fait avec les tests de panne (14.9).
Test 3 — règle « Galera incomplet » et test de bascule 7.10 (29/10/2026)
| Règle | max(mysql_global_status_wsrep_cluster_size) inférieur à 3 pendant 2 min, severite = critique |
| Ce qu’on a provoqué | arrêt de MariaDB sur srv-mysql-01 seul pendant 5 minutes (un nœud à la fois : H-39) : sudo systemd-run --unit=test-galera /bin/sh -c 'systemctl stop mariadb; sleep 300; systemctl start mariadb' |
| Résultat de la règle | mail [FIRING:1] à 15:57:12 (« Galera : 2 nœud(s) sur 3 »), mail [RESOLVED] à 16:02:12 |
| Résultat du test 7.10 | la sonde du site est restée à 1 chaque minute pendant toute la panne : les deux autres nœuds ont servi le site |
| Retour du nœud | wsrep_cluster_size = 3, wsrep_local_state_comment = Synced (relevé sur srv-mysql-01 après le test) |
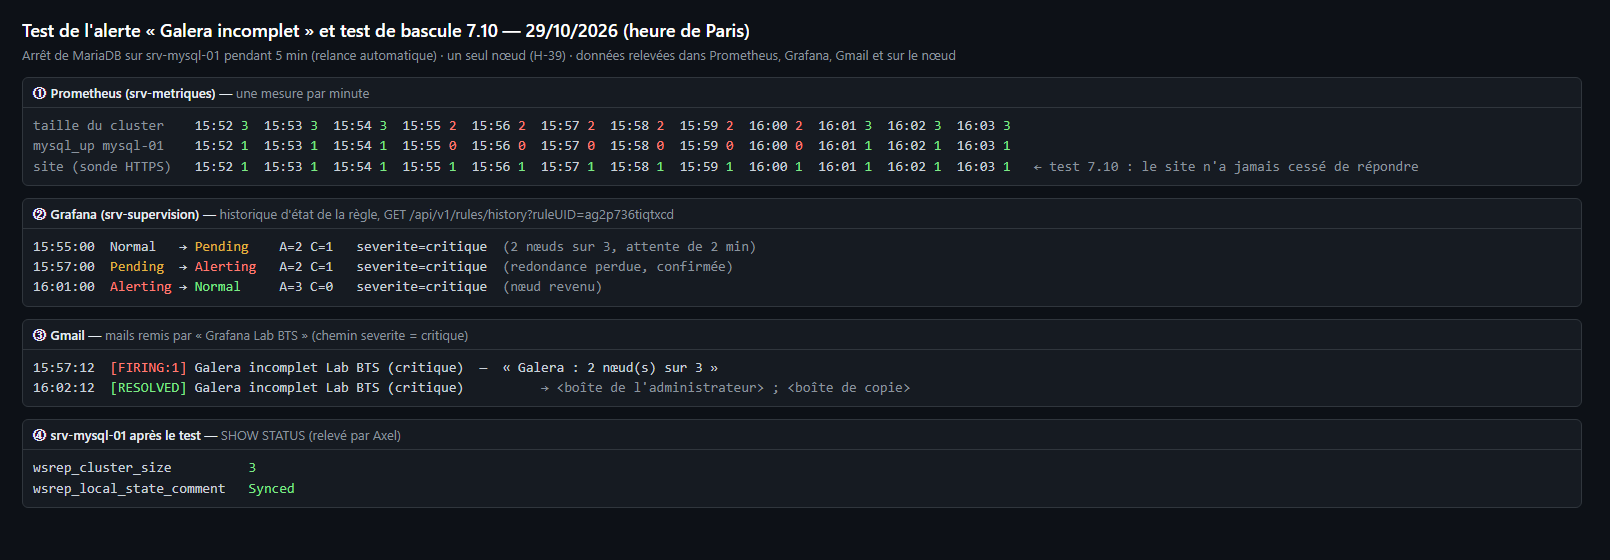
Détail à corriger : le mail [RESOLVED] reprend le résumé au présent (« ne voit plus que 3 nœud(s) sur 3 »), ce qui se lit mal. Formulation plus neutre à prévoir : « Galera : {{ valeur }} nœud(s) actifs sur 3 ».
Test 4 — règle « Sauvegarde trop ancienne » et regroupement des alertes (29/10/2026)
| Règle | (time() - pbs_snapshot_vm_last_timestamp) / 3600 (âge de la dernière sauvegarde de chaque VM, en heures) supérieur à 26 h pendant 10 min, severite = critique ; 12 VM surveillées |
| Ce qu’on a provoqué | aucune sauvegarde n’a été touchée : le seuil a été abaissé à 1 h de 16:07:38 à 16:18:32, si bien que les 12 VM sauvegardées la nuit précédente (≈ 14 h) le dépassaient |
| Résultat | un seul mail [FIRING:12] à 16:18:18 pour les 12 VM (regroupement), puis un seul mail [RESOLVED] à 16:23:19 |
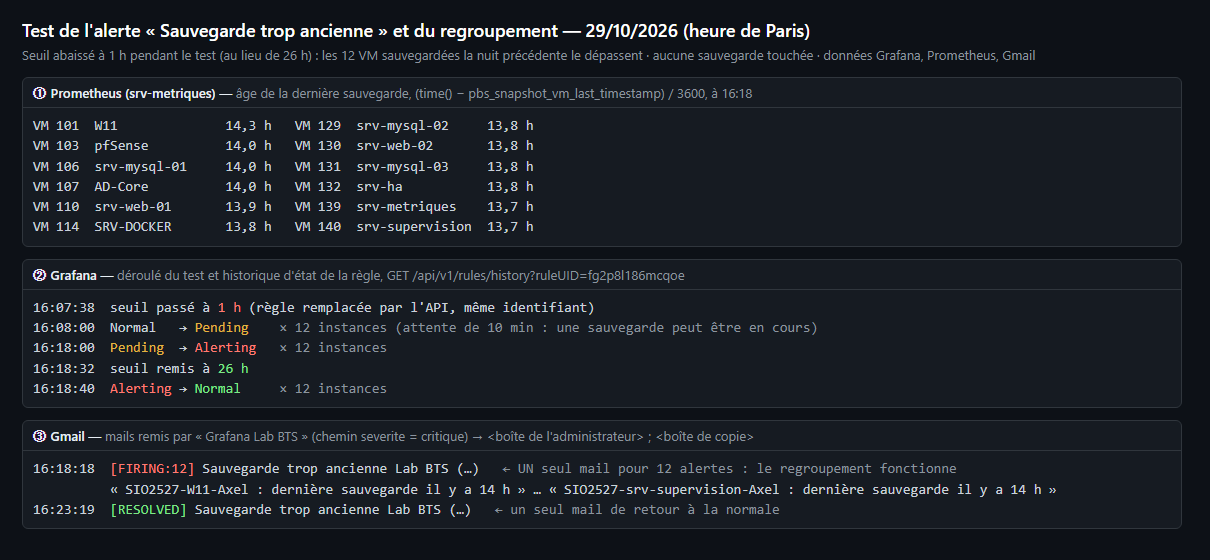
La description du mail de test indique « a plus de 1 h » : elle reprend le seuil en vigueur au moment de l’alerte. Avec le seuil normal, elle indique « a plus de 26 h ».
Test 5 — règle « Disque presque plein » (avertissement) (29/10/2026)
| Règle | remplissage des disques (Linux, pfSense, Windows C:) supérieur à 85 % pendant 15 min, severite = avertissement ; 13 disques |
| Ce qu’on a provoqué | rien n’a été rempli : seuil abaissé à 5 % le temps du test |
| 1er essai (16:42) | aucun mail : le seuil a été remis 1 s après le déclenchement, l’alerte a disparu avant la fin de l’attente de groupe (5 min) du chemin avertissement. Comportement voulu : un pic passager ne dérange personne |
| 2e essai (17:04) | Alerting à 17:20:20, un seul mail [FIRING:13] à 17:25:27, seuil remis à 17:42:44, [RESOLVED] à 17:55:26 (30 min après le 1er mail : intervalle de groupe) |
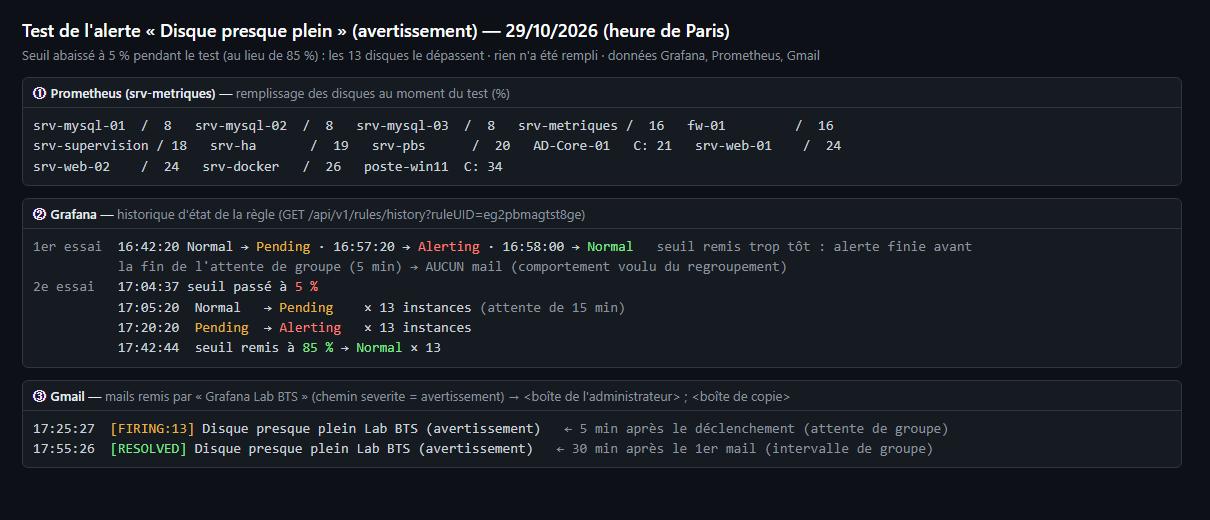
Le résumé affichait « disque /[no value] » : le modèle collait le point de montage (Linux) et la lettre de lecteur (Windows), dont l’un manque toujours. Corrigé à 17:42 (
{{ with $labels.mountpoint }}…{{ end }}) ; le mail [RESOLVED] garde l’ancien texte, figé au moment du déclenchement.
Tests 6 à 8 — mémoire, processeur, datastore (avertissements, 30/10/2026)
Même méthode que le test 5 : seuil abaissé, gardé 6 minutes après le déclenchement (pour que le mail parte, H-58), puis remis. Rien n’a été chargé ni rempli.
| Règle | Seuil normal · test | Alerting | [FIRING] | Seuil remis | [RESOLVED] |
|---|---|---|---|---|---|
| Mémoire saturée (13 machines) | 90 % · 5 % | 09:10:20 | [FIRING:13] 09:15:29 | 09:16:55 | 09:45:29 |
| Processeur saturé (13 machines) | 90 % · 0,1 % | 09:33:20 | [FIRING:13] 09:38:24 | 09:39:45 | 10:08:24 |
| Datastore PBS presque plein | 80 % · 5 % | 10:11:20 (après 30 min d’attente) | [FIRING:1] 10:16:21 | 10:17:46 | au plus tard 30 min après |
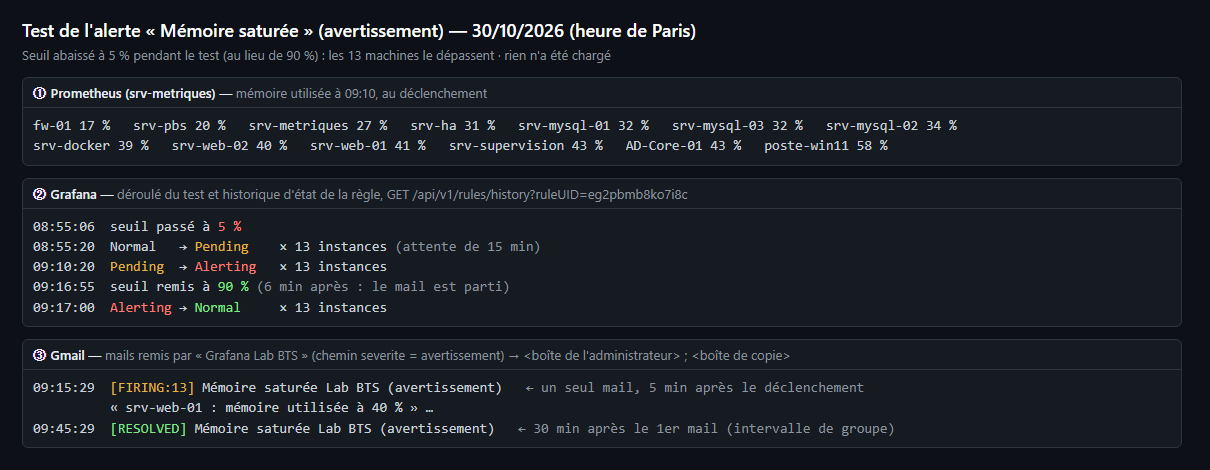
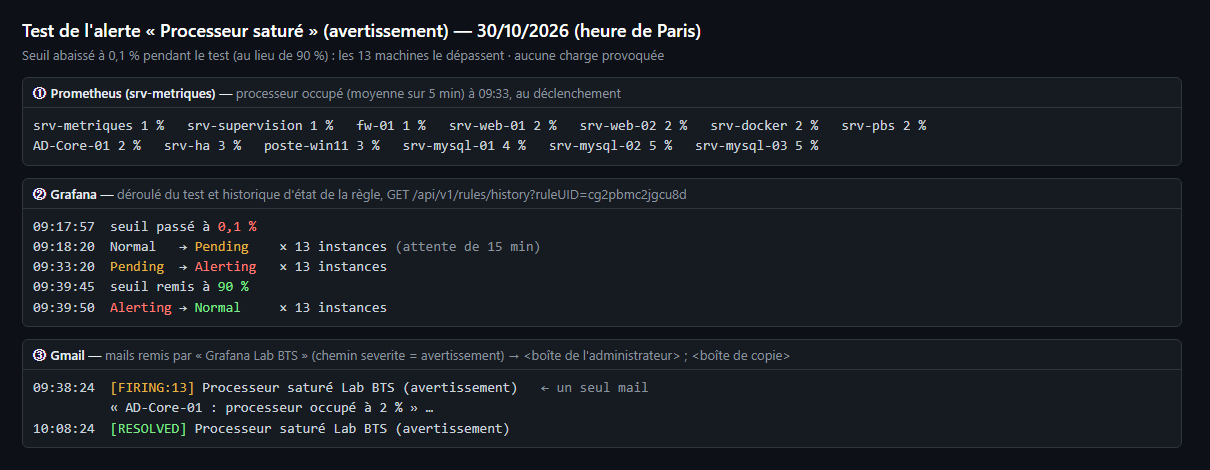
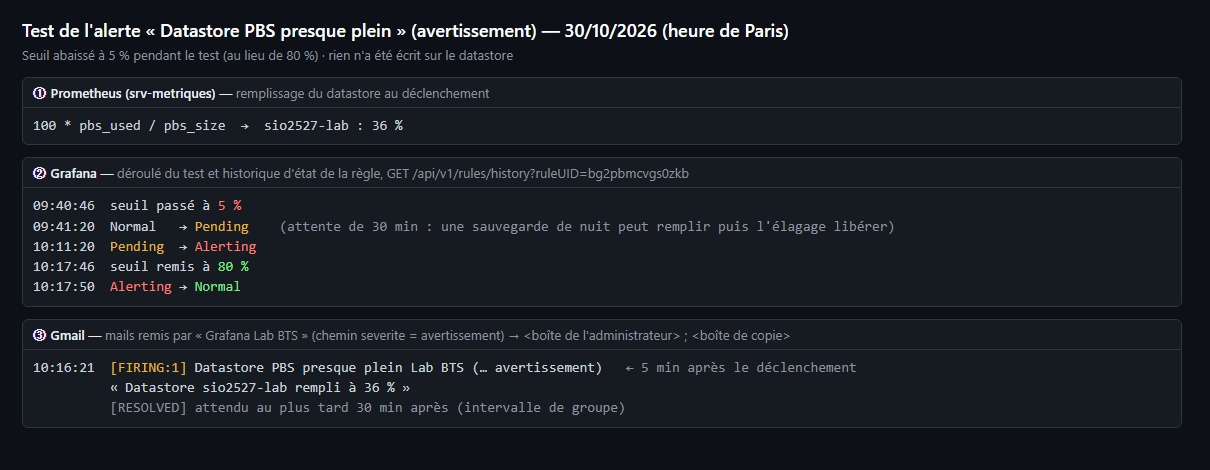
Effet de bord utile — après le test, l’historique de « Mémoire saturée » montre une instance réelle :
poste-win11passe en Pending à 09:30, 09:35 et 10:14 (mémoire utilisée jusqu’à 95 % entre 09:29 et 10:19), puis repasse à Normal avant les 15 minutes : aucun mail, ce qui est le but de l’attente. CauseÀ COMPLÉTER(piste : le ballooning, minimum 2 Gio réglé le 28/10, compté comme mémoire utilisée par Windows).
Tests 9 à 11 — pannes provoquées (tâche 14.9, 30/10/2026)
| Test | Panne provoquée | Résultat |
|---|---|---|
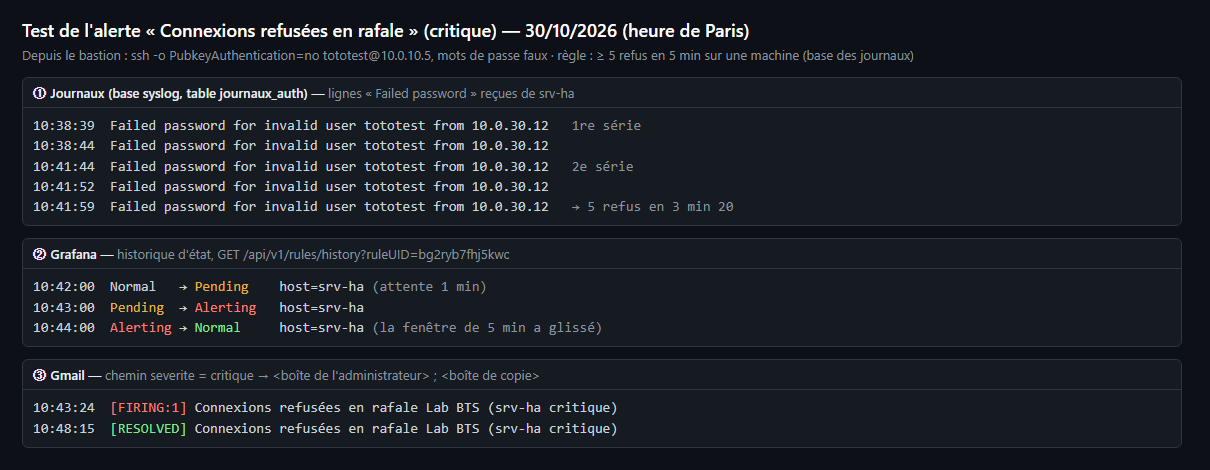
| 9 · Connexions refusées en rafale (nouvelle règle : ≥ 5 refus en 5 min sur une machine, base des journaux) | depuis le bastion, ssh -o PubkeyAuthentication=no [email protected], mots de passe faux : 5 « Failed password » de 10:38:39 à 10:41:59 | Alerting 10:43:00, [FIRING:1] 10:43:24, [RESOLVED] 10:48:15 |
| 10 · Vrai arrêt de VM | sur pve-01 : qm shutdown 130 && sleep 300 && qm start 130 (srv-web-02 éteinte de 10:40 à 10:48) | [FIRING:1] Machine injoignable (srv-web-02) 10:42:25, [RESOLVED] 10:52:15 ; le site reste servi par srv-web-01 (un seul échec de sonde à 10:49, au retour de srv-web-02, sans alerte) |
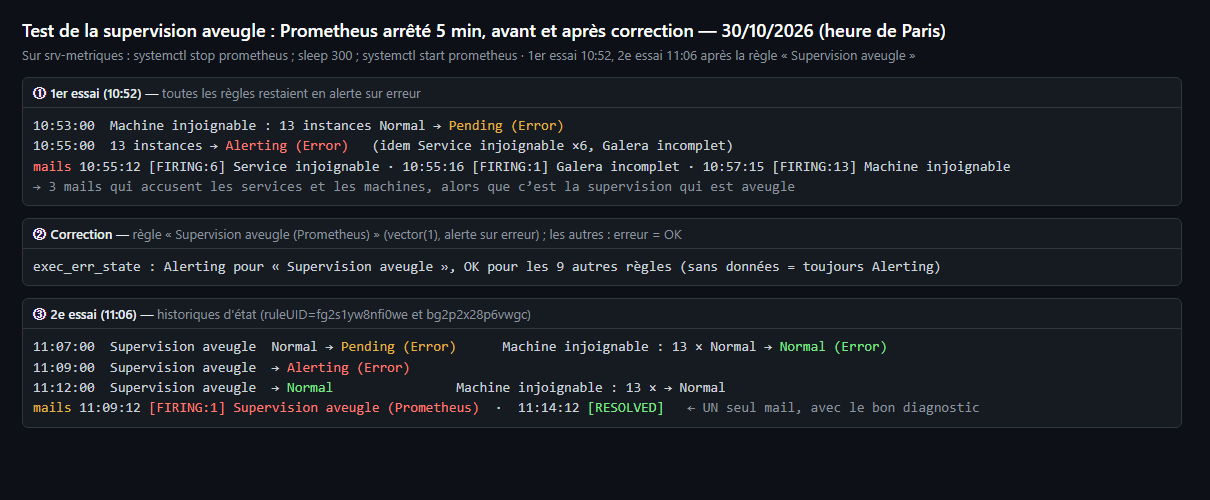
| 11 · La supervision tombe | sur srv-metriques : Prometheus arrêté 5 min | 1er essai : 3 mails trompeurs (Service ×6, Galera, Machine ×13) ; après correction : un seul mail [FIRING:1] Supervision aveugle (Prometheus) 11:09:12, [RESOLVED] 11:14:12 |
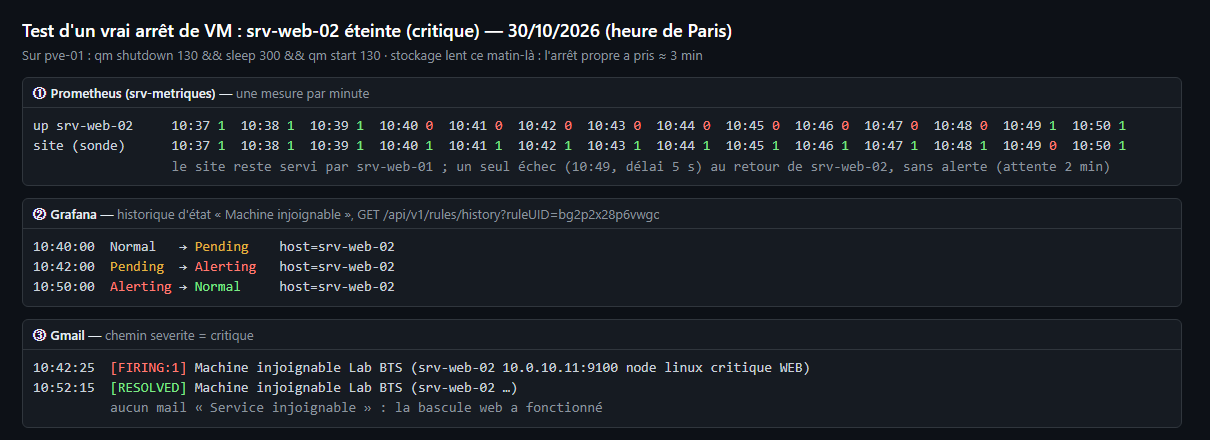
Ces tests se sont déroulés pendant une saturation du NAS de l’école (incident H-61) : l’arrêt propre de
srv-web-02a pris ≈ 3 min au lieu de quelques secondes. Les alertes ont fonctionné malgré tout.
Test 12 — règle « Site lent (temps de réponse) » (tâche 14.12, 30/10/2026)
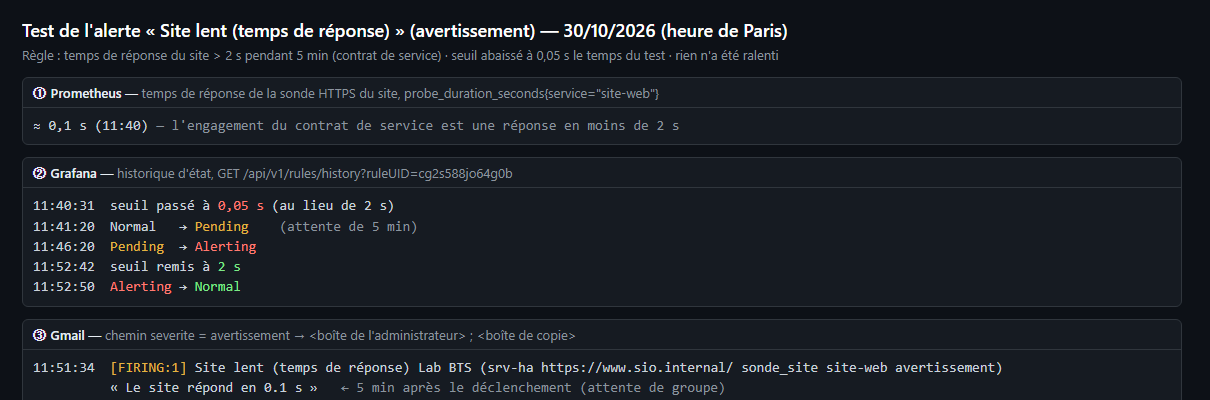
| Règle | probe_duration_seconds{service="site-web"} supérieur à 2 s pendant 5 min, severite = avertissement : l’engagement du contrat de service (réponse en moins de 2 s) |
| Ce qu’on a provoqué | rien n’a été ralenti : seuil abaissé à 0,05 s (le site répond en ≈ 0,1 s) de 11:40:31 à 11:52:42 |
| Résultat | Pending 11:41:20, Alerting 11:46:20, [FIRING:1] 11:51:34 (« Le site répond en 0.1 s »), retour à Normal 11:52:50 |
Test 7.13 — non-régression du cloisonnement (30/10/2026)
Depuis poste-win11 (zone USERS) : Test-NetConnection vers 10.0.20.10, 10.0.20.11 et 10.0.20.12, port 3306 →
TcpTestSucceeded : False sur les trois nœuds Galera. Le poste utilisateur ne joint toujours pas les bases.