


Journal de résolution d’incidents — Lab pfSense / Proxmox
Recueil des problèmes rencontrés pendant le TP, avec leur symptôme, leur cause réelle, leur résolution et l’enseignement à en tirer. La procédure nominale est dans Documentation-pfSense.md. Les schémas de l’infrastructure sont dans Architecture.md. Dernière mise à jour : 12/11/2026 (H-102 : port source rempli par erreur dans une règle ; H-101 : date au format invariant ; H-94 à H-100 : coupure de courant et Pangolin, contrôle de santé, vraie adresse des visiteurs, LDAP refusé et LDAPS, barres obliques des scripts, extension de GPO, redémarrage Proxmox resté éteint) ; 06/11/2026 (H-82 : règles locales d’écho et preuve d’une GPO ; H-83 : tester une sonde sans curl ; H-84 : lsyncd arrêté depuis le 29/10 ; H-85 : SeaweedFS sans volume libre ; H-86 : site par défaut d’Apache ; H-87 : règle Grafana restée en pause ; H-88 : lien de l’installeur de LogAnalyzer ; H-89 : sessions GLPI et recopie ; H-90 : échecs simultanés de la sonde Galera ; H-91 : GLPI par Pangolin ; H-92 : 504 sur l’inventaire ; H-93 : agent invité bloqué) ; 04/11/2026 (H-80 : filtre du bruit Windows dans Wazuh ; H-81 : tâche de Defender) ; 03/11/2026 (H-68 à H-79 : phase 16, Wazuh et Suricata)
Index
| # | Incident | Domaine |
|---|---|---|
| A-01 | Le WAN en /16 recouvre les VLAN prévus au schéma | Adressage |
| A-02 | Un masque /16 sur les VLAN les fusionnerait tous | Adressage |
| A-03 | Les trames VLAN partiraient sur le réseau de l’école | VLAN |
| A-04 | IPv4 address is being used by or overlaps with: LAN | Adressage |
| B-01 | X net introuvable dans les listes déroulantes | Pare-feu |
| B-02 | Un alias saisi en Network ne correspond à rien | Pare-feu |
| B-03 | Où saisir le port : source ou destination ? | Pare-feu |
| B-04 | Règle sans port destination : le bastion grand ouvert | Pare-feu |
| B-05 | Règle morte : la source n’appartient pas au VLAN de l’onglet | Pare-feu |
| B-06 | Reject limité à TCP au lieu de Any | Pare-feu |
| B-07 | Journalisation absente sur une règle Reject | Pare-feu |
| C-01 | Les clients reçoivent 8.8.8.8 au lieu de pfSense | DHCP / DNS |
| C-02 | pfSense utilise les DNS défaillants de l’établissement | DNS |
| C-03 | Deux serveurs DNS distribués : lenteur et risque AD | DNS |
| C-04 | Domaine de pfSense incohérent avec celui des clients | DNS |
| D-01 | ssh [email protected] sans réponse depuis le poste physique | Accès |
| D-02 | Permission denied (publickey) | SSH |
| D-03 | Clé publique collée sur plusieurs lignes | SSH |
| D-04 | Connection timed out après quelques échecs de mot de passe | SSH |
| D-05 | La passphrase de la clé privée n’est pas saisie | SSH |
| D-06 | no argument after keyword "user" | SSH |
| D-07 | L’IdentityFile du fichier config n’est pas utilisé | SSH |
| D-08 | Set-Service : Accès refusé | Windows |
| D-09 | La passerelle WAN existe déjà | pfSense |
| E-01 | La configuration automatique a échoué à l’installation Debian | Debian |
| E-02 | usermod : commande introuvable | Debian |
| E-03 | <utilisateur> n'est pas dans le fichier sudoers | Debian |
| E-04 | Ping vers le poste Windows : 100 % de perte | Réseau |
| F-01 | Impossible de trouver le paquet docker-compose-v2 | Docker |
| F-02 | docker-ce n'a pas de version susceptible d'être installée | Docker |
| F-03 | invalid containerPort: <port-interne> | Docker |
| G-01 | Tailscale : erreur 403 « session expired » à la connexion | Tailscale |
| G-02 | Tailscale connecté, mais rien ne répond dans le lab | Tailscale |
| G-03 | tailscale0 n’apparaît pas dans Interface Assignments | Tailscale |
| G-04 | Impossible de se connecter à Termix avec le compte créé | Conteneurs |
| G-05 | Termix : All configured authentication methods failed vers pfSense | Bastion |
| G-06 | Termix RDP : « le service guacd n’est pas disponible » | Bastion |
| G-07 | Termix RDP : SSL/TLS connection failed (self-signed certificate?) | Bastion |
| G-08 | Termix : « guacd n’est pas disponible » alors que tout est en ordre | Bastion |
| H-08 | Le mot de passe admin de pfSense était resté celui par défaut | pfSense |
| H-09 | Une règle documentée qui n’existait pas | Méthode |
| H-10 | Termix : « Connection timeout » vers pfSense après changement du mot de passe | Bastion |
| H-11 | Clonage : le machine-id n’avait pas été régénéré malgré la commande | Clonage |
| H-12 | Le sed sur /etc/network/interfaces n’a aucun effet sur srv-web | Debian |
| H-13 | Accès SSH à pfSense perdu de façon répétée — sshguard | pfSense |
| H-14 | lsyncd : option -s has been disabled on this server | Réplication |
| H-15 | Accès SSH perdu trois fois de suite, pour trois raisons différentes | Active Directory |
| H-16 | Installation RSAT figée : Name resolution failed alors que les serveurs DNS répondent | Active Directory |
| H-17 | Potential DNS Rebind attack detected en publiant pfSense par un nom de domaine | Accès externe |
| H-18 | Pangolin : no available server devant une cible qui répond 401 | Accès externe |
| H-19 | Après l’arrêt complet du lab, le cluster Galera ne redémarre pas seul | Haute disponibilité |
| H-20 | Restauration PBS : VM verrouillée après « restore image complete » | Sauvegarde |
| H-21 | La sauvegarde de la VM du serveur PBS échoue : http upgrade request timed out | Sauvegarde |
| H-22 | Un bloc collé deux fois dans nano : des jobs Prometheus en double | Supervision |
| H-23 | La sonde TCP du blackbox exporter échoue sur MariaDB alors que la bannière arrive | Supervision |
| H-24 | Un long fichier collé dans le terminal web arrive corrompu | Supervision |
| H-25 | apt installe une trentaine de paquets pour un simple exporteur | Supervision |
| H-26 | Le script de déploiement continue après un échec de connexion | Supervision |
| H-27 | IsInRole('Administrators') répond False à un administrateur | Supervision |
| H-28 | Un mot de passe s’affiche en clair dans le terminal | Sécurité |
| H-29 | pfSense refuse une réservation DHCP : must not be within the DHCP range | Supervision |
| H-30 | Une règle du pare-feu Windows créée deux fois | Supervision |
| H-31 | TLS/SSL error: self-signed certificate avec un compte MariaDB sans mot de passe | Journaux |
| H-32 | Impossible d'obtenir le verrou /var/lib/dpkg/lock-frontend pendant un déploiement | Supervision |
| H-33 | Le script annonce que le port 9100 n’écoute pas, alors que le service tourne | Supervision |
| H-34 | 35 000 lignes de journaux en quelques heures : le blackbox exporter trop bavard | Journaux |
| H-35 | Les horloges des zones WEB et BDD ne se sont jamais synchronisées | Journaux |
| H-36 | Pas d’empreinte publiée pour l’installeur .msi de Fluent Bit | Journaux |
| H-37 | NXLog Community Edition impossible à télécharger | Journaux |
| H-38 | haproxy : commande introuvable alors que le paquet est installé | Journaux |
| H-39 | Le cluster Galera entièrement arrêté pendant la migration des disques | Base de données |
| H-40 | node_exporter ne démarre pas au boot : bind: cannot assign requested address | Supervision |
| H-41 | Plusieurs « Move Storage » lancés en même temps échouent | Proxmox |
| H-42 | Le poste Windows ne démarre plus depuis l’interface : timeout waiting on systemd | Proxmox |
| H-43 | PBS, envoi par Gmail : wrong version number | Sauvegarde |
| H-44 | Des « Undelivered Mail Returned to Sender » de PBS, plusieurs jours après | Sauvegarde |
| H-45 | Grafana ne démarre pas sur la base Galera : could not read DB CA Cert path "" puis Error 1045 | Supervision |
| H-46 | Les journaux s’affichent avec 2 h d’avance dans Grafana | Journaux |
| H-47 | Sauvegarde des VM Windows : guest-fsfreeze-thaw failed - got timeout, agent figé | Sauvegarde |
| H-48 | pfSense : unable to freeze guest fs … Resource deadlock avoided | Sauvegarde |
| H-49 | Grafana affiche « 0 série retournée » alors que la requête est juste | Supervision |
| H-50 | Exporteur Proxmox : 500 Internal Server Error, 403 Forbidden: Permission check failed (/, Sys.Audit) | Supervision |
| H-51 | Les cases « par jour » de Grafana sont décalées d’un jour | Supervision |
| H-52 | Une courbe « Value » et des machines en double dans les panneaux | Supervision |
| H-53 | 26 000 puis 80 000 lignes de journaux par jour : les contrôles de santé et le bruit CARP | Journaux |
| H-54 | Le compte Windows illisible dans le détail des refus : l’espace insécable | Journaux |
| H-55 | Tout le tableau de bord affiche « No data » d’un coup | Supervision |
| H-56 | La recopie d’un disque se recopie dans elle-même (mnt/neuf/mnt/neuf/…) | Debian |
| H-57 | Le test d’alerte ne déclenche rien : docker: not found | Supervision |
| H-58 | Une alerte d’avertissement se déclenche, mais aucun mail n’arrive | Supervision |
| H-59 | « disque /[no value] » dans le mail d’alerte | Supervision |
| H-60 | Le poste d’administration perd par moments l’accès aux réseaux du lab | Tailscale |
| H-61 | Toutes les VM ralentissent en même temps : le NAS de l’école sature | Proxmox |
| H-62 | Prometheus tombe : trois mails accusent à tort les services et les machines | Supervision |
| H-63 | Le fichier de connexion de la purge créé sur le nœud Galera au lieu de srv-supervision | Journaux |
| H-64 | pve-01 refuse la clé SSH d’Axel : elle a disparu du fichier des clés autorisées | Proxmox |
| H-65 | Le formateur ouvre un hôte partagé dans Termix : « no password provided » | Termix |
| H-66 | Galera perd le quorum : une seule alerte, « Supervision aveugle (Prometheus) », qui accuse le mauvais coupable | Supervision |
| H-67 | Les courbes de mémoire de srv-mysql-01 et poste-win11 font des pics de 40 à 90 % : le ballooning de Proxmox | Proxmox |
| H-68 | Installeur Ubuntu : le « masque de sous-réseau » attend le réseau, et LVM ne prend que la moitié du disque | Ubuntu |
| H-69 | L’agent QEMU est installé, mais Proxmox n’affiche aucune adresse et le service reste inactif | Proxmox |
| H-70 | La règle VISITEURS « Agent Wazuh » ne laisse rien passer : sa source était USERS subnets | Pare-feu |
| H-71 | grep -A3 fait croire que <use_password> manque dans ossec.conf | Wazuh |
| H-72 | Le script d’installation de l’agent Wazuh annonce un échec alors que l’agent est inscrit | Wazuh |
| H-73 | PowerShell : l’empreinte .sha512 de l’agent Wazuh arrive en binaire, Trim impossible | Windows |
| H-74 | net user … /add ne rend pas la main : la question « plus de 14 caractères » | Windows |
| H-75 | Le site de test des IDS, testmynids.org, a expiré | Suricata |
| H-76 | Test Suricata sur USERS sans alerte : lancé avant la fin du chargement des règles | Suricata |
| H-77 | Une création de compte détectée par Wazuh n’envoie qu’un mail [RESOLVED], jamais [FIRING] | Supervision |
| H-78 | « Send Alerts to System Log » coché, mais aucune alerte Suricata n’arrive dans les journaux | Suricata |
| H-79 | Wazuh reçoit les alertes de Suricata mais n’en fait rien : « No decoder matched » | Wazuh |
| H-80 | Règle de silence Wazuh sans effet sur le compte Système : le « è » fait deux octets | Wazuh |
| H-81 | La tâche planifiée de Defender disparaît après ScanScheduleDay 8 | Windows |
| H-82 | Le ping du poste « marche » avant même la GPO : trois règles locales d’écho, dont une limitée aux profils Privé et Public | Windows · GPO |
| H-83 | Tester une sonde HTTP sans curl ni nc -U sur des serveurs minimaux | Galera · HAProxy |
| H-84 | lsyncd arrêté depuis une semaine, mais systemctl dit « active » | Web · lsyncd |
| H-85 | Datastore S3 refusé : « failed to upload in-use marker … 500 » (SeaweedFS sans volume libre) | PBS · S3 |
| H-86 | Le site GLPI devient le « site par défaut » d’Apache et fait tomber WordPress (503) | Web · Apache · HAProxy |
| H-87 | Grafana : une règle « réactivée » par l’API reste en pause | Grafana · API |
| H-88 | LogAnalyzer 5.0.2 : le lien vers l’installeur s’affiche en texte brut | LogAnalyzer · PHP |
| H-89 | GLPI : 590 connexions SSH par heure vers srv-web-02 et des dizaines de milliers de sessions jamais effacées | GLPI · PHP · lsyncd |
| H-90 | Sonde Galera : 3 échecs simultanés à 05:50 (« Relais brisé »), sans retrait de nœud | Galera · HAProxy · systemd |
| H-91 | GLPI publié par Pangolin : « L’action que vous avez réalisée n’est pas autorisée » à la connexion | GLPI · HAProxy · Pangolin |
| H-92 | Agent GLPI : 504 Gateway Time-out sur l’inventaire complet d’un serveur web | GLPI · HAProxy · PHP |
| H-93 | Agent invité de srv-mysql-01 bloqué après une requête trop longue lancée par lui | Proxmox · QEMU |
| H-94 | Pangolin : toutes les ressources en « 404 page not found » après une coupure de courant chez Axel (seule l’interface de Pangolin répond) | Pangolin · Traefik · systemd |
| H-95 | Ressource Pangolin « no available server » alors que la cible répond : contrôle de santé mal réglé | Pangolin |
| H-96 | Site public : la vraie adresse des visiteurs n’arrive pas (toujours l’adresse du TrueNAS) | Pangolin · Traefik · Nginx Proxy Manager · HAProxy |
| H-97 | GLPI et l’annuaire : le LDAP en clair est refusé (code 8), puis le LDAPS ne répond pas | Active Directory · LDAP · Schannel · certificat |
| H-98 | GPO : le script de démarrage ne se lance pas, chemin \AD-Core-01… au lieu de \\AD-Core-01… | GPO · scripts.ini · outil de Claude |
| H-99 | GPO : l’extension « Registre » déclarée avec un identifiant faux (…CF2B au lieu de …CFA2) | GPO · gPCMachineExtensionNames |
| H-100 | Redémarrage d’une VM Windows par Proxmox : « VM quit/powerdown failed », la VM reste éteinte | Proxmox · Windows Update · alerte |
| H-101 | Une date lue de travers : PowerShell écrit « 12/11/2026 » pour le 11 décembre | PowerShell · format de date |
| H-102 | Règle de test : un port source rempli par erreur (port = 5190), presque rien ne passe | pfSense · règles · Display Advanced |
A — Adressage et VLAN
A-01 · Le WAN en /16 recouvre les VLAN prévus au schéma
Symptôme — Aucun, à ce stade. Problème détecté à la conception.
Contexte — Le schéma initial prévoyait 10.1.10.0, 10.1.20.0, 10.1.30.0, 10.1.40.0.
L’interface WAN reçoit par DHCP 10.1.0.86 avec un masque /16.
Cause — 10.1.0.0/16 couvre 10.1.0.0 → 10.1.255.255, donc contient les quatre
sous-réseaux du schéma. pfSense se serait retrouvé avec deux routes concurrentes vers les mêmes
adresses : une par le WAN, une par le VLAN.
En pratique la règle du longest prefix match fait gagner le /24, donc le lab aurait fonctionné —
mais toute machine réelle de l’établissement située en 10.1.10.x, 10.1.20.x, 10.1.30.x ou
10.1.40.x serait devenue définitivement injoignable.
Résolution — Bascule du plan d’adressage sur 10.0.X.0/24, qui ne chevauche aucune plage de
l’établissement tout en conservant la logique de lecture du schéma (VLAN 20 → 10.0.20.0).
À retenir — Avant de choisir un plan d’adressage interne, regarder le masque du réseau amont. Un /16 côté WAN interdit tout /24 qui commencerait par les deux mêmes octets.
A-02 · Un masque /16 sur les VLAN les fusionnerait tous
Symptôme — pfSense refuse la configuration : « subnet overlaps with interface LAN ».
Cause — Un /16 ne prend en compte que les deux premiers octets :
10.0.10.0 /16  →  réseau 10.0.0.0
10.0.20.0 /16  →  réseau 10.0.0.0     ← identique
10.0.30.0 /16  →  réseau 10.0.0.0     ← identique
10.0.40.0 /16  →  réseau 10.0.0.0     ← identique
Les quatre VLAN désigneraient le même réseau.
Résolution — Masque /24 sur chaque VLAN : les trois premiers octets sont pris en compte, chaque réseau devient distinct, avec 254 adresses utilisables.
À retenir — Mettre un masque trop large par-dessus des VLAN annule l’intérêt du découpage : le but d’un VLAN est de séparer les domaines de diffusion.
A-03 · Les trames VLAN partiraient sur le réseau de l’école
Symptôme — Aucun. Détecté avant mise en service.
Contexte — Les VLAN 10/20/30/40 étaient créés dans pfSense sur vtnet1, mais la carte
réseau correspondante était raccordée à vmbr0, le bridge Proxmox relié à la carte physique.
Cause — Un bridge Linux transmet les trames taguées telles quelles. Les VLAN du lab seraient donc sortis sur le réseau physique de l’établissement.
Résolution — Création d’un bridge vmbr1 dédié :
| Paramètre | Valeur | Rôle |
|---|---|---|
| Ports/Interfaces de pont | vide | aucun lien vers la carte physique : le lab reste confiné |
| VLAN aware | coché | autorise le transport des trames 802.1Q |
| CIDR / Passerelle | vides | l’hyperviseur n’a pas d’adresse dans le lab |
Puis bascule de la carte net1 de la VM pfSense sur vmbr1, VLAN Tag laissé vide (mode trunk).
À retenir — Un VLAN n’existe pas « quelque part », il existe sur tout le chemin : posé par pfSense, transporté par le bridge, interprété comme réseau routé. Si un maillon manque, le symptôme ressemble à « le câble est débranché ».
Effet de bord bénéfique : l’hyperviseur n’ayant aucune patte dans
vmbr1, il ne peut pas joindre les VM du lab. Le seul équipement présent des deux côtés est pfSense — c’est la preuve que l’isolation fonctionne.
A-04 · IPv4 address is being used by or overlaps with: LAN
Symptôme — Impossible d’adresser la première interface VLAN.
Cause — L’interface LAN était en 10.0.0.1/16, soit 10.0.0.0 → 10.0.255.255 : elle
englobait les quatre futurs VLAN en 10.0.X.0/24.
Résolution — Interfaces → LAN → masque 24 au lieu de 16 → Save → Apply Changes.
À faire avant toute tentative d’adressage des VLAN.
À retenir — Manifestation concrète de A-02. Aucun risque de coupure ici : l’administration se faisait par le WAN, pas par le LAN.
B — Règles de pare-feu
B-01 · X net introuvable dans les listes déroulantes
Symptôme — Les tutoriels mentionnent USERS net, mais la liste ne propose que
USERS address et USERS subnets.
Cause — Changement de vocabulaire depuis pfSense 2.7.
| Ancien terme | pfSense 2.9 | Désigne |
|---|---|---|
X net | X subnets | tout le réseau, ex. 10.0.40.0/24 |
Single host or alias | Address or Alias | une IP unique ou un nom d’alias |
X address | X address (inchangé) | l’adresse de pfSense seule, ex. 10.0.40.1 |
Résolution — Employer la nouvelle terminologie. La plupart des tutoriels en ligne sont encore rédigés pour les versions antérieures.
À retenir — Le pluriel de « subnets » est justifié : si une interface porte plusieurs sous-réseaux (adresses virtuelles), l’entrée les couvre tous.
B-02 · Un alias saisi en Network ne correspond à rien
Symptôme — La règle est acceptée mais ne s’applique jamais ; ou pfSense refuse avec « Destination address is invalid ».
Cause — Confusion entre deux entrées de la liste :
| Entrée | Attend |
|---|---|
Network | un CIDR tapé à la main : 10.0.30.0 + masque 24 |
Address or Alias | une IP unique ou un nom d’alias — quel que soit le contenu de l’alias |
Résolution — Tous les alias (LAB_NETS, SRV_WEB, SRV_BASTION, DC_AD…) se saisissent via
Address or Alias, y compris LAB_NETS qui contient pourtant des réseaux.
À retenir — pfSense sait ce que contient un alias ; inutile de le lui redire par le type choisi dans la liste.
B-03 · Où saisir le port : source ou destination ?
Réponse — Toujours en destination. Le Source Port Range reste à any.
| Champ | Valeur |
|---|---|
| Source Port Range | any — sans exception |
| Destination Port Range → From → liste | (other) |
| Destination Port Range → From → Custom | le nom de l’alias, ex. PORTS_DNS_NTP |
| Destination Port Range → To | vide (ne sert qu’aux plages, ex. 8000 → 8100) |
Pourquoi — Le port destination identifie le service demandé (53 = DNS, 3306 = MySQL,
443 = HTTPS). Le port source est un numéro tiré au hasard par le système du client dans la
plage éphémère 49152-65535, différent à chaque connexion. Le filtrer reviendrait à écrire
« j’autorise le DNS, mais seulement si le client a tiré le 54321 ».
À retenir — pfSense affiche lui-même l’avertissement dès qu’on déplie Display Advanced : « this setting must remain at its default value, any ».
B-04 · Règle sans port destination : le bastion grand ouvert
Symptôme — La colonne Port affiche * sur la règle
USERS subnets → SRV_BASTION.
Cause — Le champ Destination Port Range avait été laissé vide. La règle autorisait donc tous les ports TCP vers le bastion, dont SSH 22 en direct — contournant le bastion lui-même.
Résolution — Renseigner PORTS_BASTION (443, 8443) dans Destination Port Range → From →
Custom.
À retenir — Une règle « bonne machine, port any » donne l’illusion d’être précise puisqu’elle nomme un seul hôte, alors qu’elle est grande ouverte. En audit, on lit toujours les colonnes Destination et Port ensemble.
B-05 · Règle morte : la source n’appartient pas au VLAN de l’onglet
Symptôme — Une règle s’affiche en vert, avec une coche, et ne se déclenche jamais.
Compteur States figé à 0/0 B.
Rencontré deux fois : onglet WEB (règle 5) et onglet BDD (règle 4), toutes deux avec
USERS subnets en source au lieu de WEB subnets / BDD subnets.
Cause — Les règles filtrent ce qui entre par l’interface. Sur l’onglet WEB, seuls arrivent
des paquets de 10.0.10.0/24. Une source USERS subnets (10.0.40.0/24) ne correspondra à aucun
paquet — jamais.
Conséquence qui aurait suivi — srv-web et srv-mysql sans accès Internet : apt update
en échec, sans aucun message côté pare-feu pour orienter le diagnostic.
Origine de l’erreur — Le bouton Copy recopie une règle d’un onglet à l’autre, mais ne met pas la source à jour.
Résolution — Corriger la source. Puis adopter le réflexe de contrôle ci-dessous.
À retenir — le réflexe de vérification : avant de valider un onglet, relire la colonne Source de haut en bas. Elle ne peut contenir que le réseau de l’onglet, ou un hôte de ce réseau. Sur une liste de 5 règles affichant
WEB, WEB, SRV_WEB, WEB, USERS, l’intrus saute aux yeux en deux secondes.Et pfSense n’avertit jamais : il accepte la règle sans broncher. C’est le type d’erreur le plus vicieux avec un pare-feu — pas de message, juste un comportement qui ne vient pas.
B-06 · Reject limité à TCP au lieu de Any
Symptôme — La colonne Protocol affiche IPv4 TCP sur une règle de blocage censée tout
refuser.
Cause — Le protocole était resté sur TCP au lieu de Any.
Conséquence — Un flux UDP interne échappait à la règle. Il finissait bloqué par le
block all implicite — donc le résultat était le même — mais sans être journalisé par la
règle, ce qui supprime la preuve exploitable en phase de tests.
Résolution — Protocol → Any.
B-07 · Journalisation absente sur une règle Reject
Symptôme — L’icône de journalisation (petite liste à cocher sous l’icône ) manque dans la
colonne Actions, contrairement aux règles Reject des autres onglets.
Cause — La case Log packets that are handled by this rule n’avait pas été cochée.
Résolution — Crayon → section Extra Options → cocher Log.
À retenir — Sans journalisation, un blocage ne se prouve pas. C’est particulièrement important sur le VLAN BDD : un flux sortant depuis la base serait le signe d’une exfiltration, et c’est le journal le plus pertinent à présenter.
C — DNS et DHCP
C-01 · Les clients reçoivent 8.8.8.8 au lieu de pfSense
Symptôme — Le poste Windows obtient bien une IP, une passerelle et un masque corrects, mais
Serveurs DNS IPv4 : 8.8.8.8 / 1.1.1.1. Aucune résolution de noms ne fonctionne.
Cause — Le champ DNS Servers du serveur DHCP avait été laissé vide. Dans ce cas, pfSense ne distribue pas sa propre adresse mais les serveurs configurés dans System → General Setup.
Pourquoi la résolution échoue — Les requêtes partent vers 8.8.8.8 en UDP 53, et aucune règle
de l’onglet USERS ne couvre ce flux :
| Règle | Correspond ? |
|---|---|
1 — → USERS address : PORTS_DNS_NTP | vise 10.0.40.1, pas 8.8.8.8 |
6 — Reject → LAB_NETS | 8.8.8.8 n’est pas interne |
7 — Pass → any : PORTS_WEB | ports 80/443, or le DNS est en UDP 53 |
block all implicite | c’est lui qui s’applique |
Le pare-feu fonctionnait donc exactement comme prévu.
Résolution — Services → DHCP Server → USERS → DNS Servers = 10.0.40.1, puis
ipconfig /release && ipconfig /renew côté client.
À retenir — le diagnostic universel : « l’adressage fonctionne mais pas les noms » désigne toujours le DNS, jamais le routage. Un
pingpar adresse IP qui passe et unpingpar nom qui échoue localisent la panne en deux commandes.
C-02 · pfSense utilise les DNS défaillants de l’établissement
Symptôme — Résolutions aléatoires ou lentes, pour pfSense et pour toutes les VM. Le tableau de bord affiche :
DNS server(s) :  127.0.0.1
                 ::1
                 10.1.0.150      ← DNS de l'école
                 10.2.0.150      ← DNS de l'école
                 8.8.8.8
                 1.1.1.1
Cause — L’option DNS Server Override, activée par défaut, laisse le bail DHCP du WAN injecter les serveurs de l’établissement dans la liste de pfSense.
Résolution — System → General Setup → DNS Server Settings :
| Champ | Valeur |
|---|---|
| DNS Servers | 1.1.1.1, 8.8.8.8 |
| DNS Server Override | décoché |
Et Services → DNS Resolver → Enable Forwarding Mode coché.
À retenir — En mode récursif (défaut),
unboundinterroge lui-même les serveurs racine puis les TLD : plus autonome et plus confidentiel, mais multipliant les échanges sortants, donc sensible à un réseau filtrant qu’on ne maîtrise pas. En mode Forwarding, une seule destination et un comportement prévisible — préférable dans ce contexte.Aucune règle de pare-feu n’est nécessaire pour que pfSense sorte en DNS : les règles d’interface filtrent ce qui traverse le pare-feu, pas ce qu’il génère lui-même.
C-03 · Deux serveurs DNS distribués : lenteur et risque AD
Symptôme — Le client reçoit 8.8.8.8 et 10.0.40.1. La résolution fonctionne, mais
chaque nouveau nom prend une à deux secondes.
Cause — Windows interroge les serveurs dans l’ordre. La requête part vers 8.8.8.8, que
le pare-feu jette en silence ; Windows attend le timeout puis bascule sur 10.0.40.1.
Risque plus grave, pour la phase 6 — Interrogé sur SRV-AD.sio.internal, un résolveur public
répond : il répond NXDOMAIN, « ce nom n’existe pas ». Windows prend cette réponse pour
définitive et ne réessaie pas ailleurs. Ouvertures de session, GPO et réplication deviennent
intermittentes selon le serveur interrogé.
Résolution — Un seul serveur DNS distribué : 10.0.40.1. Le secours ne disparaît pas, il
remonte d’un étage — c’est pfSense qui détient les deux résolveurs publics.
À retenir — La recommandation Microsoft est catégorique : une machine membre d’un domaine ne liste que des DNS internes. Un DNS public « au cas où » fait plus de mal que de bien.
C-04 · Domaine de pfSense incohérent avec celui des clients
Symptôme — nslookup affiche Serveur : UnKnown ; le nom d’hôte de pfSense est
SIO2527-pfSense-axel.home.arpa alors que les clients reçoivent le suffixe sio.internal.
Cause — home.arpa est le domaine proposé par défaut dans l’assistant de configuration
initiale et n’avait pas été modifié.
Résolution — System → General Setup → Domain → sio.internal → Save.
À retenir — Deux espaces de nommage dans un même lab sont une source de confusion, particulièrement quand l’Active Directory prendra le relais de la résolution. À corriger avant la création du domaine AD, pas après.
À noter : les mentions
Réponse ne faisant pas autoritédenslookupsont normales — pfSense n’est pas propriétaire degoogle.fr, il ne peut donc jamais répondre « faisant autorité » pour ce nom.
D — Accès, SSH et pfSense
D-01 · ssh [email protected] sans réponse depuis le poste physique
Symptôme — Aucune sortie, puis Connection timed out.
Cause — Le poste de travail physique se trouve sur le réseau de l’établissement
(10.70.0.18), pas dans le lab. 10.0.40.1 n’existe que côté lab :
Poste physique (10.70.0.18)  ── réseau école ──►  pfSense WAN  10.1.0.197
Poste physique (10.70.0.18)  ─────── X ─────────►  pfSense USERS 10.0.40.1
Le réseau de l’école n’a aucune route vers 10.0.40.0/24, et pfSense ne fait que du NAT
sortant — rien ne rentre.
Résolution — Depuis le poste physique, viser l’adresse WAN : ssh [email protected].
| Depuis | Adresse pfSense à utiliser |
|---|---|
Poste physique (10.70.0.18) | 10.1.0.197 — le WAN |
poste-win11 (10.0.40.100) | 10.0.40.1 — USERS |
srv-web (10.0.10.10) | 10.0.10.1 — WEB |
À retenir — Le NAT est unidirectionnel. On vise toujours l’adresse de pfSense sur le réseau d’où l’on vient ; depuis l’extérieur, c’est le WAN.
D-02 · Permission denied (publickey)
Symptôme — Connexion refusée immédiatement, sans demande de mot de passe.
Cause — System → Advanced → Admin Access → SSHd Key Only était sur Public Key Only,
et aucune clé publique n’était encore déposée pour le compte admin.
Résolution — deux voies :
| Voie | Action |
|---|---|
| Rapide | SSHd Key Only → Password or Public Key |
| Recommandée | déposer sa clé publique dans System → User Manager → admin → Authorized SSH Keys |
Diagnostic utile :
ssh -v [email protected]
| Ligne recherchée | Signification |
|---|---|
Server accepts key: ... | la clé publique est bien enregistrée côté serveur |
| absence de cette ligne | la clé n’est pas (ou mal) déposée |
D-03 · Clé publique collée sur plusieurs lignes
Symptôme — La clé apparaît sur trois lignes dans le champ Authorized SSH Keys, et l’authentification échoue malgré l’enregistrement.
Cause — Le copier-coller depuis la console PowerShell insère de vrais retours chariot aux endroits où le texte était coupé à l’écran.
Conséquence — pfSense enregistre trois clés invalides au lieu d’une valide.
Résolution — Copier sans passer par l’affichage :
Get-Content $env:USERPROFILE\.ssh\id_ed25519.pub | Set-Clipboard
Structure attendue — une seule ligne, trois blocs séparés par un espace :
ssh-ed25519   AAAAC3Nza...Fy3                <utilisateur>@<domaine>
└─ algorithme └─ clé base64, 68 caractères   └─ commentaire
À retenir —
| Set-Clipboardest à réutiliser pour tout copier-coller de valeur longue depuis un terminal Windows : clés, empreintes, jetons.
D-04 · Connection timed out après quelques échecs de mot de passe
Symptôme — Après deux ou trois mots de passe refusés, plus aucune réponse — ni en SSH, ni sur l’interface web.
Cause — sshguard (Login Protection) ajoute l’adresse source à une table de blocage pf.
Le blocage s’applique à tout le trafic venant de ce poste, pas seulement au SSH — d’où le
passage d’un refus explicite à un timeout silencieux.
Résolution — trois options :
| Option | Action |
|---|---|
| Attendre | environ 2 minutes ; chaque nouvelle série d’échecs rallonge la durée |
| Vider la table | console Proxmox → option 8 → pfctl -t sshguard -T flush |
| Réinitialiser le compte | console Proxmox → option 3) Reset admin account and password |
Prévention — System → Advanced → Admin Access → Login Protection → champ Pass List →
sélectionner l’alias POSTE_ADMIN (10.70.0.18).
À retenir — La console Proxmox reste toujours accessible : c’est l’accès hors-bande, il ne dépend d’aucune règle réseau. C’est le filet de sécurité de toute opération risquée sur le pare-feu.
Ajouter une adresse à la Pass List retire la protection anti-force-brute pour elle. Acceptable pour un poste d’administration identifié, à proscrire pour une plage entière.
D-05 · La passphrase de la clé privée n’est pas saisie
Symptôme — ssh -v montre Server accepts key, l’invite Enter passphrase apparaît, puis
la connexion échoue avec Permission denied (publickey).
Cause — La touche Entrée avait été pressée sans saisir la passphrase. SSH abandonne alors la clé et passe aux suivantes, qui n’existent pas.
Résolution — Saisir la passphrase (rien ne s’affiche pendant la frappe, c’est normal).
Pour ne plus la retaper — activer l’agent SSH de Windows, en console administrateur :
Set-Service ssh-agent -StartupType Automatic
Start-Service ssh-agent
puis en console normale :
ssh-add $env:USERPROFILE\.ssh\id_ed25519
ssh-add -l
À retenir — Faire le
ssh-adden session utilisateur normale : l’agent est lié à la session, une clé ajoutée depuis une console administrateur ne serait pas visible ensuite.Une passphrase oubliée est définitivement perdue. Il faut alors générer une nouvelle paire de clés.
D-06 · no argument after keyword "user"
Symptôme — Toute commande ssh échoue, y compris celles qui n’utilisent aucune entrée du
fichier de configuration :
C:\Users\...\.ssh/config line 8: no argument after keyword "user"
C:\Users\...\.ssh/config: terminating, 1 bad configuration options
Cause — Une ligne User sans valeur dans ~/.ssh/config.
Résolution — Compléter ou supprimer la ligne. Une entrée Host reste valide sans User :
SSH utilise alors le nom de session courant.
À retenir — La syntaxe est stricte : une seule erreur invalide tout le fichier, y compris les entrées correctes. En cas de doute, renommer le fichier débloque immédiatement :
Rename-Item $env:USERPROFILE\.ssh\config config.bak
D-07 · L’IdentityFile du fichier config n’est pas utilisé
Symptôme — Le bloc Host pfsense déclare IdentityFile ~/.ssh/id_lab_sio, mais SSH présente
une autre clé.
Cause — Le bloc Host s’applique au nom tapé en ligne de commande, pas à l’adresse
résolue derrière.
| Commande | Clé utilisée |
|---|---|
ssh [email protected] | ~/.ssh/id_ed25519 (clé par défaut) |
ssh pfsense | celle du bloc Host pfsense |
Résolution — Utiliser le nom déclaré (ssh pfsense), ou faire pointer l’IdentityFile sur la
clé réellement présente.
Exemple de configuration fonctionnelle :
Host pfsense
    HostName 10.1.0.197
    User admin
    IdentityFile ~/.ssh/id_ed25519

Host docker
    HostName 10.0.30.12
    User ipfixe
    ProxyJump pfsense
À retenir —
ProxyJumpouvre la connexion vers pfSense, y creuse un tunnel jusqu’à10.0.30.12:22et y connecte directement, sans afficher le menu pfSense. Une seule commande au lieu de deux.
D-08 · Set-Service : Accès refusé
Symptôme —
Set-Service : Le service «OpenSSH Authentication Agent (ssh-agent)» ne peut pas être configuré
en raison de l'erreur suivante: Accès refusé
Cause — Modifier un service Windows exige une élévation de privilèges.
Résolution — Win + X → Terminal (administrateur), puis relancer la commande.
Faire ensuite le ssh-add en console normale (voir D-05).
D-09 · La passerelle WAN existe déjà
Symptôme — Au passage du WAN de DHCP vers une IP fixe :
The gateway IP address "10.1.0.254" already exists.
Cause — pfSense crée automatiquement une passerelle lorsqu’une interface est en DHCP. Elle
survit au passage en statique. Le bouton + Add a new gateway tentait d’en créer une
seconde avec la même adresse.
Résolution — Ne rien créer : sélectionner la passerelle existante dans la liste déroulante IPv4 Upstream gateway.
Vérification après enregistrement — System → Routing → Gateways : la passerelle doit être Online et marquée Default.
À retenir — Les passerelles sont des objets indépendants des interfaces : elles vivent dans System → Routing → Gateways, et une interface ne fait que pointer vers l’une d’elles. Même logique que les alias : on définit une fois, on réutilise ensuite.
L’oubli classique du passage en IP fixe : en DHCP, la passerelle arrivait avec le bail. En statique, elle doit être explicitement désignée et cochée comme passerelle par défaut. Sans cela, pfSense a une adresse mais aucune route de sortie — les VLAN continuent de communiquer entre eux, le DNS local répond, mais rien ne sort.
E — Debian et systèmes invités
E-01 · La configuration automatique a échoué à l’installation Debian
Symptôme —
Le protocole DHCP n’est probablement pas utilisé sur le réseau. Il est également possible que le serveur DHCP soit lent ou que certains équipements réseau ne fonctionnent pas correctement.
Cause — Aucune. Le DHCP est volontairement désactivé sur les VLAN 10, 20 et 30 : seules les zones serveurs sont concernées, et leurs machines doivent avoir une IP fixe.
Le message est trompeur — il suggère un dysfonctionnement alors que tout se passe comme prévu.
Résolution — Continuer → Configurer le réseau vous-même, puis saisir les quatre paramètres :
| Écran | Exemple pour srv-web |
|---|---|
| Adresse IP | 10.0.10.10/24 (la notation CIDR évite l’écran du masque) |
| Passerelle | 10.0.10.1 |
| Serveurs de noms | 10.0.10.1 |
| Domaine | sio.internal |
À retenir — L’écran Serveurs de noms est celui qu’on bâcle, et aucun DHCP ne viendra rattraper l’oubli dans ces zones. Sans lui : adressage correct,
aptinopérant. C’est la version « sans filet » de l’incident C-01.
E-02 · usermod : commande introuvable
Symptôme —
ipfixe@SRV-WEB:~$ su
root@SRV-WEB:/home/ipfixe# usermod -aG sudo ipfixe
bash: usermod : commande introuvable
Cause — usermod se trouve dans /usr/sbin/, absent du PATH d’un utilisateur normal.
| Commande | Effet |
|---|---|
su | devient root en gardant l’environnement courant — donc sans /usr/sbin dans le PATH |
su - | devient root avec son environnement complet — PATH incluant /usr/sbin et /sbin |
Résolution — su - avec le tiret, ou chemin complet : /usr/sbin/usermod -aG sudo ipfixe
À retenir — l’indice visuel : l’invite
root@SRV-WEB:**/home/ipfixe**#montre qu’on est root mais toujours dans le dossier de l’utilisateur. Avecsu -, l’invite seraitroot@SRV-WEB:**~**#, soit/root. Prendre l’habitude de toujours tapersu -.
E-03 · <utilisateur> n'est pas dans le fichier sudoers
Symptôme — sudo refuse toute commande.
Cause — Quand un mot de passe root est renseigné pendant l’installation, Debian considère
que l’administration se fera avec su et n’ajoute pas le premier utilisateur au groupe sudo.
Résolution —
su -
usermod -aG sudo <utilisateur>
id <utilisateur>        # vérifier que « sudo » apparaît
exit
reboot
Le redémarrage est indispensable. Les groupes d’un utilisateur sont lus une seule fois, à l’ouverture de session. Fermer le terminal ne suffit pas :
/etc/groupest à jour, mais la session en cours ne l’a pas relu.Prévention pour les VM suivantes : laisser le mot de passe root vide à l’installation. Debian désactive alors le compte root et configure
sudoautomatiquement pour le premier utilisateur. C’est aussi la configuration la plus sûre — aucun compte root à forcer par SSH.
E-04 · Ping vers le poste Windows : 100 % de perte
Symptôme — Depuis srv-web (10.0.10.10) :
# ping -c3 10.0.20.1      → 0 % de perte
# ping -c3 10.0.40.100    → 100 % de perte
Ce n’est pas pfSense. La règle 2 de l’onglet WEB autorise WEB subnets → LAB_NETS en ICMP, et
10.0.40.0/24 est bien dans LAB_NETS. Le routage fonctionne — ping 10.0.40.1 répond.
Cause réelle — Le pare-feu de Windows. Windows Defender bloque par défaut les demandes d’écho ICMP entrantes provenant d’un autre sous-réseau, tant que la règle Partage de fichiers et d’imprimantes (demande d’écho — ICMPv4-Entrant) n’est pas activée.
Vérification — Le ping en sens inverse (depuis Windows vers 10.0.10.10) fonctionne : Linux
répond au ping par défaut. Un sens qui passe et pas l’autre = le problème est sur l’hôte, pas
sur le réseau.
Résolution — PowerShell en administrateur sur le poste Windows :
Enable-NetFirewallRule -Name FPS-ICMP4-ERQ-In
À retenir — Un pare-feu réseau n’est pas le seul filtre du chemin : chaque hôte possède le sien, et Windows est particulièrement restrictif en entrée. Avant d’incriminer pfSense, se demander « qui refuse — le routeur, ou la destination ? ». Les compteurs States et les journaux du pare-feu permettent de trancher en quelques secondes.
Suite (05/11) — La règle activée ici (
FPS-ICMP4-ERQ-In) ne couvrait que les profils Privé et Public : après la jonction au domaine, elle ne servait plus. Le ping du poste est désormais donné par une GPO (étape 61, H-82).
F — Docker
F-01 · Impossible de trouver le paquet docker-compose-v2
Symptôme — apt install docker.io docker-compose-v2 échoue.
Cause — srv-docker tourne sous Debian 12 « Bookworm », alors que srv-web est en
Debian 13. Le paquet docker-compose-v2 n’existe qu’à partir de Debian 13.
Détectable dans la sortie de apt update :
Atteint :2 http://deb.debian.org/debian bookworm InRelease
                                        ▲▲▲▲▲▲▲▲
Résolution — Deux voies :
| Voie | Commande | Résultat |
|---|---|---|
| Dépôt Debian | apt install docker.io docker-compose | Docker 20.10, Compose v1 — syntaxe docker-compose avec tiret |
| Dépôt officiel Docker | voir F-02 | Docker à jour, Compose v2 — syntaxe docker compose |
Le dépôt officiel a été retenu : la documentation de Termix suppose Compose v2.
À retenir —
aptannule tout quand un paquet est introuvable : rien n’est installé, la base reste propre. Pas besoin de nettoyer avant de réessayer.
F-02 · docker-ce n'a pas de version susceptible d'être installée
Symptôme —
Aucune version du paquet docker-ce n'est disponible, mais il existe dans la base de données.
E: Impossible de trouver le paquet containerd.io
Cause — Le fichier /etc/apt/sources.list.d/docker.list n’avait pas été créé : la commande
echo … | sudo tee … avait été collée en même temps qu’une autre et n’a pas été exécutée.
Diagnostic — La sortie de apt update ne mentionnait que les trois dépôts Debian, aucune
ligne download.docker.com.
ls -l /etc/apt/keyrings/docker.asc              # la clé était bien présente
cat /etc/apt/sources.list.d/docker.list         # « Aucun fichier ou dossier de ce type »
Résolution — procédure complète, une commande à la fois :
sudo apt install -y ca-certificates curl gnupg
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/debian/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc
echo "deb [arch=amd64 signed-by=/etc/apt/keyrings/docker.asc] https://download.docker.com/linux/debian bookworm stable" | sudo tee /etc/apt/sources.list.d/docker.list
(tee réaffiche la ligne écrite : si l’écran reste vide, la commande n’a pas fonctionné.)
sudo apt update
→ une quatrième ligne doit apparaître :
Réception de : 4 https://download.docker.com/linux/debian bookworm InRelease
sudo apt install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
sudo usermod -aG docker $USER
À retenir — deux réflexes :
① Après l’ajout d’un dépôt, contrôler la sortie de
apt update. Si la nouvelle source n’y figure pas, inutile de chercher ailleurs. Le message « il existe dans la base de données » signifie précisément : « je connais ce nom de paquet, mais aucune source ne me le fournit ».② Ne pas coller plusieurs commandes d’un coup dans un terminal : une ligne avale la suivante, un caractère est mal interprété. Pour les commandes qui écrivent des fichiers, une ligne à la fois, puis on vérifie.
F-03 · invalid containerPort: <port-interne>
Symptôme — docker compose up -d refuse de démarrer.
Cause — Un fichier docker-compose.yml copié depuis un modèle en conservant les
marqueurs à remplacer (<image-du-projet>, <port-interne>).
Résolution — Remplacer chaque <…> par une valeur réelle avant de lancer la pile.
À retenir — Un modèle avec marqueurs n’est pas un fichier prêt à l’emploi. Contrôler systématiquement qu’aucun
<ni>ne subsiste avant de lancer une commande.
G — Tailscale
G-01 · Erreur 403 « session expired » à la connexion
Symptôme — À la création d’un compte Tailscale, une page Error 403 — session expired, log in again.
Deux causes cumulées :
① Session résiduelle — le navigateur porte encore les cookies du tailnet précédent.
→ Fenêtre de navigation privée, ou vider les cookies de tailscale.com.
② Une même identité = un même tailnet — se reconnecter avec le même compte Google ne crée pas un nouveau réseau : il ramène sur celui qui existe déjà.
Résolution — Utiliser une identité différente : adresse scolaire, second compte Google, GitHub ou Microsoft.
À retenir — Pour un lab, l’adresse de l’établissement est le meilleur choix : le tailnet appartient au contexte du TP, pas à la vie privée. Il se supprime en fin d’année sans toucher au réseau personnel.
G-02 · Tailscale connecté, mais rien ne répond dans le lab
Symptôme — Le nœud pfSense apparaît dans la console, mais ping 100.84.62.27 et
https://100.84.62.27 échouent tous deux en timeout.
Diagnostic décisif — Sur le poste de travail :
PS> tailscale status
100.84.62.27  sio2527-pfsense-axel  freebsd  active; direct 10.1.0.197:41641, tx 572 rx 156
                                             ▲▲▲▲▲▲                          ▲▲▲▲▲▲▲▲▲▲▲▲
| Indice | Signification |
|---|---|
active | le tunnel WireGuard est établi |
direct 10.1.0.197:41641 | liaison pair-à-pair, sans relais |
tx 572 rx 156 | des octets circulent dans les deux sens |
Si le réseau était en cause, rx serait à 0. Le tunnel fonctionne — c’est donc pfSense qui
refuse le trafic.
Cause — Le paquet crée une interface tailscale0, et une interface sans règle de pare-feu
ne laisse rien passer (règle d’or n°3). C’est la situation exacte vécue avec les VLAN à la
phase 3.
Résolution — Le paquet place l’interface dans un groupe pf nommé Tailscale, ce qui fait
apparaître un onglet dédié dans Firewall → Rules — sans assignation nécessaire. L’onglet
affiche d’ailleurs le message : « No rules are configured for this interface. Add a pass rule to
allow traffic on this interface. »
Y ajouter : Pass · IPv4+IPv6 · protocole Any · source any · destination any.
À retenir —
tailscale statusest l’équivalent de la colonne States de pfSense : il distingue en une ligne « le paquet n’arrive pas » de « le paquet arrive et est refusé ». Les compteurstx/rxnon nuls écartent définitivement l’hypothèse réseau.
G-03 · tailscale0 n’apparaît pas dans Interface Assignments
Symptôme — La ligne Available network ports ne propose pas tailscale0, y compris après
redémarrage de pfSense.
Vérification — Dans le shell :
ifconfig tailscale0
tailscale0: flags=1008043<UP,BROADCAST,RUNNING,MULTICAST,LOWER_UP> mtu 1280
        inet 100.84.62.27 netmask 0xffffffff
        groups: tun Tailscale
L’interface existe bel et bien et fonctionne.
Cause — Ce n’est pas un défaut : l’assignation n’est pas nécessaire. Le paquet place
l’interface dans le groupe pf Tailscale (visible dans la ligne groups:), ce qui suffit à
pfSense pour créer l’onglet de règles correspondant.
Résolution — Aller directement dans Firewall → Rules → onglet Tailscale et y ajouter la règle de passage. Ne pas chercher à assigner l’interface.
À retenir — La ligne
groups:d’unifconfigindique comment pf peut référencer une interface. Un paquet pfSense qui crée son propre groupe gère lui-même l’intégration au pare-feu — inutile de passer par l’assignation manuelle.MTU 1280 : valeur normale pour WireGuard, qui réduit la taille utile des trames pour laisser la place à son encapsulation.
G-04 · Impossible de se connecter à Termix avec le compte créé
Symptôme — Le compte avait été créé et le tableau de bord s’affichait. Depuis un autre poste, la page de connexion refuse les identifiants.
Hypothèse principale — la disposition du clavier. Le compte avait été créé depuis
poste-win11, dont le clavier était en QWERTY (valeur par défaut de l’installation
Windows), alors que la frappe se faisait sur un clavier AZERTY physique :
   Frappe voulue      :  Motdepasse2026!
   Enregistré en QWERTY:  Motdepqsse2026!
                               ▲
                            a ↔ q
Le mot de passe stocké n’était donc pas celui que l’on croyait avoir saisi.
Résolution retenue — Réinitialisation complète, sans perte : le tableau de bord affichait
0 hôtes, 0 identifiants, 0 tunnels.
cd /opt/termix && docker compose down -v && docker compose up -d
Puis recréation du compte via l’onglet REGISTER, depuis le poste de travail habituel.
Retenir la différence entre
downetdown -v:
Commande Effet docker compose downarrête et supprime les conteneurs — les volumes survivent docker compose down -vsupprime aussi les volumes : bases de données, configuration, tout Ici c’était volontaire et sans conséquence. Sur une pile dont la base vit dans un volume, la même commande effacerait tout — comptes, connexions enregistrées, historique.
Prévention : corriger la disposition clavier des VM Windows dès l’installation (Paramètres → Heure et langue → Saisie → Clavier → Français AZERTY). Sinon le problème se reproduira à chaque mot de passe saisi dessus — y compris au moment de joindre le domaine AD.
G-05 · Termix : All configured authentication methods failed vers pfSense
Symptôme — Journal de connexion de Termix vers 10.0.30.1:22 :
Using password authentication
Authenticating as admin
Authentication failed: All configured authentication methods failed
Cause — pfSense est configuré en SSHd Key Only (System → Advanced → Admin Access) :
il refuse l’authentification par mot de passe. Termix en proposait un.
C’est le même incident que D-02, vu depuis l’autre extrémité : la clé du poste de travail avait été déposée, mais le bastion n’en avait aucune.
Résolution retenue — une clé dédiée au bastion, plutôt que de réautoriser les mots de passe :
# sur srv-docker
ssh-keygen -t ed25519 -C "termix-pfsense" -f ~/.ssh/termix_pfsense -N ""
cat ~/.ssh/termix_pfsense.pub     # → à AJOUTER sur une nouvelle ligne dans
                                  #   pfSense > User Manager > admin > Authorized SSH Keys
cat ~/.ssh/termix_pfsense         # → à importer comme identifiant « Clé SSH » dans Termix
Ne pas remplacer la clé existante dans pfSense : plusieurs clés sont autorisées, une par ligne. L’écraser ferait perdre l’accès depuis le poste de travail.
-N ""crée une clé sans passphrase — indispensable, Termix ne peut pas la saisir. Conséquence à assumer : quiconque accède à Termix obtient l’administration de pfSense. C’est inhérent au principe du bastion — c’est lui qui détient les accès, et c’est précisément pourquoi on le protège si soigneusement.
Alternative écartée : repasser
SSHd Key OnlysurPassword or Public Key. Deux clics, mais on réintroduit l’authentification par mot de passe sur le pare-feu.
Attention à sshguard pendant les tests : au-delà de ~3 échecs, pfSense bloque l’adresse de
srv-dockeret le symptôme change (timeout au lieu de refus). Ajouter le bastion à la Pass List de Login Protection évite le problème.
G-06 · Termix RDP : « le service guacd n’est pas disponible »
Symptôme —
Connexion à la session RDP...
Le service de bureau à distance (guacd) n'est pas disponible. Veuillez vous assurer
que guacd est en cours d'exécution, accessible et correctement configuré.
Le conteneur termix-guacd était pourtant bien Up (healthy).
Cause — Dans Termix → Paramètres administrateur, le champ URL GUACD valait
localhost:4822.
localhost désigne le conteneur Termix lui-même. Chaque conteneur possède son propre espace
réseau : depuis l’intérieur de termix, localhost ne mène nulle part ailleurs qu’à termix.
S’y ajoutait une cause indirecte : le service est nommé termix-guacd dans le fichier Compose,
alors que la valeur attendue par défaut est guacd. Renommer un service oblige à reporter ce
nom partout où il est référencé — ici, dans un champ de l’interface d’administration.
Résolution — Champ URL GUACD → termix-guacd:4822
Vérification de la résolution DNS entre conteneurs :
docker exec termix getent hosts termix-guacd
172.19.0.2      termix-guacd
Deux portées de nommage à ne pas confondre :
Notion Portée container_nameglobale à l’hôte — deux conteneurs ne peuvent pas la partager Nom du service Compose locale au réseau — sert d’alias DNS C’est la même logique que les VLAN : deux machines peuvent porter le même nom dans des réseaux différents. Le nommage dépend toujours d’une portée.
localhostn’est jamais une adresse universelle — c’est « moi-même », et ce « moi » change selon l’endroit d’où l’on parle. C’est le pendant exact du choix fait pour Portainer, lié volontairement à127.0.0.1pour rester invisible du réseau.Leçon générale : en renommant un composant pour résoudre un conflit, on casse une convention implicite attendue par l’application. Quand on s’écarte de la configuration documentée d’un projet, il faut vérifier ce qui en dépendait.
G-07 · Termix RDP : SSL/TLS connection failed (self-signed certificate?)
Symptôme — Après correction de G-06, l’erreur change :
SSL/TLS connection failed (untrusted/self-signed certificate?)
C’est un progrès : guacd est joignable et a bien atteint le serveur RDP. C’est la
négociation TLS qui échoue.
Cause — Windows génère un certificat auto-signé pour son service RDP à l’installation. Aucune autorité ne le valide.
| Client | Comportement |
|---|---|
| Client RDP Windows | affiche un avertissement, laisse accepter |
guacd | refuse — il n’a aucune interface pour demander |
Résolution — Dans les paramètres de l’hôte : activer « Ignorer le certificat du serveur »
(ou régler Security sur Any).
Ce que l’on accepte : renoncer à vérifier l’identité du serveur RDP. Sans conséquence sur un lab dont on connaît les adresses ; en production, cela ouvrirait la porte à une interception.
La correction propre, une fois l’Active Directory en place : un contrôleur de domaine peut émettre des certificats RDP valides pour toutes les machines du domaine, distribués par GPO. Le certificat cesse alors d’être auto-signé et
guacdl’accepte sans rien ignorer. Piste d’amélioration à mentionner en soutenance.
G-08 · Termix : « le service guacd n’est pas disponible » — alors que tout est en ordre
Symptôme — Le portail refuse toute connexion RDP et répète en boucle, toutes les 5 à 8 secondes :
Le service de bureau a distance (guacd) n'est pas disponible.
Veuillez vous assurer que guacd est en cours d'execution, accessible
et correctement configure dans les parametres administrateur.
Les sessions SSH, elles, fonctionnent.
Ce contraste est la première information utile. La pile Termix repose sur deux moteurs : le conteneur
termixsert l’interface web et porte le client SSH, le conteneurtermix-guacdassure le rendu RDP et VNC. SSH qui marche prouve quetermixest debout : la panne est forcément du côté du second, ou du lien entre les deux.
Le diagnostic, cause par cause
Cinq hypothèses, écartées dans l’ordre du plus probable au plus improbable.
① Le conteneur est-il arrêté ?
docker ps -a --filter name=termix
termix        Up 6 days (healthy)     0.0.0.0:443->8080/tcp
termix-guacd  Up 13 days (healthy)    4822/tcp
Les deux sont debout et sains. Écarté — mais la sortie livre un indice : termix a été
recréé il y a 6 jours, termix-guacd est resté en place depuis 13 jours. Une recréation
de conteneur est un événement, et les événements sont des suspects.
② Sont-ils encore sur le même réseau ?
Un conteneur ne résout le nom d’un autre que s’ils partagent un réseau Docker.
docker inspect -f '{{.Name}} -> {{range $k,$v := .NetworkSettings.Networks}}{{$k}} {{end}}' termix termix-guacd
/termix       -> termix_termix-net
/termix-guacd -> termix_termix-net
Écarté.
③ Le réglage du portail est-il correct ?
Paramètres administrateur → URL guacd affiche termix-guacd:4822. Écarté — c’est la
bonne valeur, et pas le localhost:4822 de l’incident G-06.
④ Une variable d’environnement écrase-t-elle ce réglage ?
La ligne d’aide sous le champ, qu’on ne lit jamais, précise :
« Les variables d’environnement
GUACD_URL,GUACD_HOSTetGUACD_PORTprévalent sur ce comportement. »
docker inspect -f '{{range .Config.Env}}{{println .}}{{end}}' termix | grep -i guacd
Aucune sortie. Écarté.
Le principe général vaut bien au-delà de Termix. Quand une application lit un réglage à plusieurs endroits — fichier, base de données, variable d’environnement — l’interface n’affiche presque jamais celui qui gagne. Elle montre ce qu’elle a en base. D’où une valeur parfaitement correcte à l’écran et un comportement qui l’ignore.
C’est le même raisonnement que pour
mysql.user: la source de vérité n’est pas forcément ce que l’interface montre.
⑤ Le lien réseau fonctionne-t-il réellement ?
Le nom, puis le port :
docker exec termix getent hosts termix-guacd
docker exec termix node -e "require('net').connect(4822,'termix-guacd',()=>{console.log('OK');process.exit()})"
172.19.0.2      termix-guacd
OK
Écarté. Le chemin est intégralement valide.
Tester le port depuis le conteneur lui-même, et non depuis l’hôte.
termix-guacdne publie pas son port : il n’est joignable que depuis le réseau Docker. Un test lancé sursrv-dockeréchouerait — et ferait conclure à tort à une panne.L’image
termixest une application Node :node -esert de testeur de port quand nincnitelnetne sont présents. Utiliser ce que le conteneur contient déjà plutôt que d’y installer un outil.
Ce que disaient les journaux
docker logs --tail 15 termix-guacd
Une session RDP complète et réussie — connexion, clavier, audio, déconnexion propre. Mais
guacd journalise sans horodatage : impossible de dater ces lignes.
Le fait décisif n’est pas ce que le journal contient, c’est ce qu’il ne contient pas. Pendant les tentatives répétées,
guacdn’a journalisé aucune nouvelle ligne. Si les connexions lui parvenaient, on les y verrait. Rien n’arrivait jusqu’à lui.
Cause — Tout le chemin était valide : même réseau, nom résolu, port ouvert, réglage correct,
aucune variable le contredisant. Seul termix affirmait l’indisponibilité. Son état interne
était faux — vraisemblablement une vérification échouée au démarrage, conservée ensuite.
Résolution
docker restart termix
On redémarre celui qui se trompe, pas celui qui est accusé.
guacdrépondait — ses journaux et le test de port le prouvent. C’étaittermixqui prétendait le contraire.Et le redémarrage ne coûte rien : les hôtes, les identifiants et la configuration vivent dans le volume
termix-data, pas dans le conteneur.
À retenir — pourquoi ne pas avoir redémarré d’emblée. Le redémarrage aurait probablement résolu le symptôme en trente secondes. Mais sans rien apprendre : ni la cause, ni ce qu’il faudrait regarder si cela recommençait.
Après ce diagnostic, quatre causes sont éliminées avec leur preuve. Si le message revient, le réseau, le nom, le port et le réglage ne sont plus à revérifier : il faudra aller directement aux journaux de démarrage de
termix. Un redémarrage qui marche sans qu’on sache pourquoi ne règle rien — il ajourne.
H-08 · Le mot de passe admin de pfSense était resté celui par défaut
Symptôme — Le 25/09, au moment d’attaquer le durcissement, le bandeau suivant apparaît en haut du webConfigurator :
WARNING: The password for this account is insecure.
Password is currently set to the default value (pfsense).
Or la tâche 2.1 du suivi était cochée depuis le 16/09, avec la mention « le bandeau a disparu du dashboard ».
Gravité — immédiate. À cet instant précis, la règle WAN allow all était encore active :
   WAN : Pass any → any        (aucune restriction)
              +
   admin / pfsense             (identifiants publics et universels)
              =
   toute machine du réseau de l'établissement pouvait
   prendre le contrôle total du pare-feu
Diagnostic — Plutôt que de supposer, comparaison des quatre sauvegardes XML conservées
dans Savegardes/ :
python -c "
import xml.etree.ElementTree as ET, sys
r = ET.parse(sys.argv[1]).getroot()
for u in r.findall('./system/user'):
    if u.findtext('name') == 'admin':
        print(u.findtext('bcrypt-hash')[:29])
" config-....xml
| Sauvegarde | Empreinte bcrypt du compte admin |
|---|---|
| 17/09 | $2y$10$Mw9nKaaqdlZZGPKi9M10xO... |
| 18/09 | identique |
| 20/09 | identique |
| 25/09 | identique |
Cause — Le mot de passe n’avait jamais été modifié. La validation du 16/09 reposait sur la disparition apparente du bandeau — or celui-ci ne s’affiche pas sur toutes les pages du webConfigurator. Changer d’écran suffit à le faire disparaître et à donner l’illusion que le problème est réglé.
Résolution — System → User Manager → admin → Edit, champs Password et Confirmation,
puis Save. Puis désactivation de la règle WAN allow all (dette T-1).
À retenir — une absence de symptôme n’est pas une preuve. C’est la leçon la plus coûteuse de ce TP. Le bandeau est un indicateur d’alerte, pas un indicateur d’état : son absence peut signifier « c’est corrigé » comme « tu n’es pas sur la bonne page ».
Validation fragile Validation fiable « le bandeau a disparu » System → User Manager, colonne Last Changed du compte « ça a l’air de marcher » une commande qui interroge l’état réel Corollaire : valider une tâche sur un symptôme absent, c’est la marquer sans l’avoir faite. Toujours chercher la source de vérité — comme
mysql.global_privplutôt que la vuemysql.user(étape 24.4), ouhostnameplutôt que l’invite du shell.
Les sauvegardes régulières ont servi à autre chose qu’à restaurer. Quatre XML horodatés ont permis de dater précisément le problème et de prouver que le mot de passe n’avait jamais changé. Une sauvegarde est aussi un journal de l’état du système dans le temps — raison supplémentaire d’en faire après chaque étape.
H-09 · Une règle documentée qui n’existait pas
Symptôme — La matrice de flux §4.5 décrivait une règle WAN n°2
POSTE_ADMIN → WAN address : 443, présentée comme « dérogation assumée ». L’onglet WAN de
pfSense n’en affichait qu’une seule : allow all.
Diagnostic — Extraction des règles WAN depuis les sauvegardes :
python -c "
import xml.etree.ElementTree as ET
r = ET.parse('config-....xml').getroot()
for rule in r.findall('./filter/rule'):
    if rule.findtext('interface') == 'wan':
        print(rule.findtext('type'), '|', rule.findtext('descr'))
"
Résultat, dans les quatre fichiers : une seule ligne, Allow all ipv4+ipv6 via pfSsh.php.
Cause — La règle avait été conçue et documentée, mais jamais créée. L’alias
POSTE_ADMIN existait bien, ce qui donnait l’illusion que la règle associée existait aussi.
Conséquence — Sans gravité : la règle allow all couvrait de toute façon le flux. Mais la documentation décrivait une posture de sécurité plus restrictive que la réalité.
À retenir : un document de conception et un document d’état ne sont pas la même chose. Une matrice de flux dit ce qui doit être ; seule une extraction de la configuration dit ce qui est. Vérifier périodiquement que les deux coïncident — c’est exactement ce que fait un audit de conformité.
Fin heureuse : la cible atteinte est meilleure que la dérogation prévue. Au lieu d’une règle WAN restreinte à une IP, il n’y a plus aucune règle entrante.
H-10 · Termix : « Connection timeout » vers pfSense après changement du mot de passe
Symptôme — Juste après le changement du mot de passe admin de pfSense (incident
H-08), l’hôte pfSense de Termix ne répond plus :
13:43:10  Using SSH key authentication
13:43:10  Starting SSH session
13:43:10  Authenticating as admin
13:43:45  Connection timeout
13:43:45  Connection rejected by server.
Fausse piste suivie — et pourquoi — Le délai de 35 secondes a été interprété comme un timeout TCP, donc comme un problème de filtrage :
« délai d’attente = le paquet n’arrive jamais = problème de règle »
Deux hypothèses ont été explorées et écartées :
| Hypothèse | Vérification | Résultat |
|---|---|---|
Blocage sshguard | pfctl -t sshguard -T show | table vide |
| Service SSH arrêté | menu console → « 14) Disable Secure Shell » | donc activé |
Cause réelle — Le champ PASSWORD (OPTIONAL) de l’hôte Termix contenait encore
l’ancien mot de passe. La négociation SSH restait bloquée sur cette méthode devenue
invalide jusqu’à expiration du délai côté client.
Résolution — Mettre à jour le mot de passe dans Termix, ou mieux : vider complètement le
champ et ne conserver que la clé SSH. pfSense n’accepte de toute façon pas l’authentification
par mot de passe pour admin en SSH (voir G-05).
La leçon — un « timeout » applicatif n’est pas un timeout réseau.
La règle « délai d’attente = paquet jeté » vaut pour un outil de couche transport (
nc,Test-NetConnection,ping). Elle ne vaut pas pour le journal d’un client applicatif : celui-ci écrit « Connection timeout » aussi bien parce que le TCP n’a jamais abouti que parce qu’une négociation a calé après la connexion.
Ce que dit le client Ce que ça peut être « Connection timeout » TCP jamais établi ou négociation bloquée nc -zv→timed outTCP jamais établi, sans ambiguïté Le bon réflexe : avant de suspecter le pare-feu sur la foi d’un journal applicatif, tester la couche transport séparément :
nc -zv 10.0.30.1 22Un
succeeded!aurait immédiatement désigné la couche authentification, et fait gagner le détour parsshguardet les règles de pare-feu.
Le déclencheur était pourtant visible : le champ
PASSWORD (OPTIONAL)affichait des points. Après tout changement d’identifiants, passer en revue les endroits où l’ancien secret est encore stocké — clients SSH, gestionnaires de mots de passe, scripts, configurations de supervision.
H-11 · Clonage : le machine-id n’avait pas été régénéré malgré la commande
Contexte — Régénération des identités sur srv-mysql-02, clone de srv-mysql-01
(tâche 10.3).
Commande lancée — celle que l’on trouve partout :
sudo rm -f /etc/machine-id && sudo systemd-machine-id-setup
Sortie — apparemment un succès, un nouvel identifiant s’affiche :
Initializing machine ID from D-Bus machine ID.
31d6ba1c091d4836ab39da9b17ebf6b9
Le symptôme est dans le message, pas dans une erreur. « from D-Bus machine ID » signifie que la commande n’a pas tiré un identifiant aléatoire : elle en a trouvé un ailleurs et l’a recopié.
Cause — systemd-machine-id-setup cherche une source dans cet ordre :
| # | Source | Message affiché |
|---|---|---|
| 1 | /etc/machine-id s’il est valide | (rien, il est conservé) |
| 2 | /var/lib/dbus/machine-id | from D-Bus machine ID le cas rencontré |
| 3 | UUID SMBIOS/DMI fourni par l’hyperviseur | from SMBIOS/DMI UUID |
| 4 | tirage aléatoire | from random generator |
L’ordre a été vérifié expérimentalement, sans lire le code source. Sur
srv-mysql-02, un seul fichier supprimé →from D-Bus machine ID. Sursrv-mysql-03, les deux supprimés →from SMBIOS/DMI UUID. Les deux machines ont donc révélé que D-Bus est consulté avant l’UUID de l’hyperviseur. Comparer deux exécutions qui ne diffèrent que par un paramètre, c’est une démarche expérimentale — et ça vaut mieux qu’une supposition.
Un seul des deux fichiers avait été supprimé. L’identifiant de srv-mysql-01 a donc été
recopié depuis le fichier D-Bus : les deux machines restaient jumelles.
Résolution — supprimer les deux fichiers, puis rétablir le lien attendu par Debian :
sudo rm -f /etc/machine-id /var/lib/dbus/machine-id
sudo systemd-machine-id-setup
sudo ln -sf /etc/machine-id /var/lib/dbus/machine-id
La sortie doit alors indiquer from SMBIOS/DMI UUID (sous Proxmox, le plus courant —
l’hyperviseur attribue un UUID unique à chaque VM, y compris aux clones) ou
from random generator. Les deux conviennent : ce qui compte est que le message ne soit
plus from D-Bus machine ID.
Vérification — comparer cat /etc/machine-id sur les deux machines : les valeurs doivent
différer.
À retenir — lire ce que la commande DIT avoir fait. « from D-Bus machine ID » et « from random generator » sont deux résultats radicalement différents, produits par la même commande, sans le moindre message d’erreur. Le code de retour était
0dans les deux cas.C’est le même piège que l’incident H-08 : un succès apparent n’est pas une vérification. Une commande qui réussit n’a pas forcément fait ce qu’on croit.
Conséquences si l’on n’avait rien vu. Deux machines partageant un
machine-id: journauxjournaldmélangés à la centralisation, identifiant client DHCP identique donc bail disputé, et plusieurs services qui s’en servent pour distinguer les hôtes. Le tout sans aucun message d’erreur, avec des symptômes intermittents — la pire catégorie de panne.
Liste complète des identités à régénérer après un clonage (étape 27 de la documentation) :
machine-idet son jumeau D-Bus · clés d’hôte SSH · nom de machine ·/etc/hosts· adresse IP · et pour un nœud de cluster, le répertoire de données.
H-12 · Le sed sur /etc/network/interfaces n’a aucun effet sur srv-web
Contexte — Clonage de srv-web-01 vers srv-web-02 (tâche 10.2). La même commande que
pour les nœuds Galera est lancée depuis la console Proxmox :
sudo sed -i 's/10\.0\.10\.10/10.0.10.11/' /etc/network/interfaces && cat /etc/network/interfaces
Symptôme — Aucune erreur, mais le fichier affiché ne contient aucune adresse :
source /etc/network/interfaces.d/*

# The loopback network interface
auto lo
iface lo inet loopback
Pas de strophe ens18. Le sed s’est exécuté avec succès sur un fichier qui ne contenait pas
ce qu’on cherchait à modifier.
Cause — srv-web-01 possède un environnement de bureau (dette H-3). L’installateur
Debian confie alors le réseau à NetworkManager, et non au système ifupdown classique.
   srv-mysql-01  (sans bureau)  →  /etc/network/interfaces  →  le sed fonctionne
   srv-web-01    (avec bureau)  →  NetworkManager           →  le sed n'a aucun effet
Diagnostic — une commande tranche :
ls -l /etc/network/interfaces.d/ ; nmcli -t -f NAME,DEVICE,STATE connection show
Résultat : répertoire vide, et une connexion nommée Wired connection 1.
Résolution — passer par nmcli :
sudo nmcli connection modify "Wired connection 1" ipv4.addresses 10.0.10.11/24
nmcli connection show "Wired connection 1" | grep -E "ipv4.method|ipv4.addresses|ipv4.gateway|ipv4.dns:"
Les quatre paramètres attendus : manual · 10.0.10.11/24 · 10.0.10.1 · 10.0.10.1.
nmcli connection modifyécrit dans la configuration persistante (/etc/NetworkManager/system-connections/). Le changement survit au redémarrage sans avoir besoin d’activer la connexion — pratique ici, la carte étant volontairement débranchée.
À retenir — identifier QUI gère le réseau avant de le modifier. Trois écoles cohabitent sous Debian, et éditer le fichier de la mauvaise ne produit aucune erreur, juste aucun effet :
Gestionnaire Configuration Outil ifupdown/etc/network/interfacesifup/ifdownNetworkManager /etc/NetworkManager/system-connections/nmclisystemd-networkd/etc/systemd/network/networkctlLe réflexe :
systemctl is-active NetworkManager systemd-networkd networking
Troisième manifestation concrète de la dette H-3. D’abord la RAM et la surface d’attaque, puis
avahiqui polluait les journaux du pare-feu, et maintenant un gestionnaire réseau différent des autres serveurs. Une décision d’installation continue de produire des conséquences deux semaines plus tard — c’est la définition même d’une dette technique.
H-13 · Accès SSH à pfSense perdu de façon répétée — sshguard
Symptôme — L’hôte pfSense de Termix cesse de répondre plusieurs fois par jour. À chaque
fois, l’attente avant échec semble plus longue que la précédente.
Cause — pfSense embarque une protection anti-force-brute, Login Protection (sshguard).
Au-delà d’un seuil d’échecs d’authentification, l’adresse source est ajoutée à une table de
blocage et tous ses paquets sont jetés — d’où un délai d’attente, et non un refus.
Les valeurs par défaut expliquent le ressenti. 35-login-protection-sshguard.png
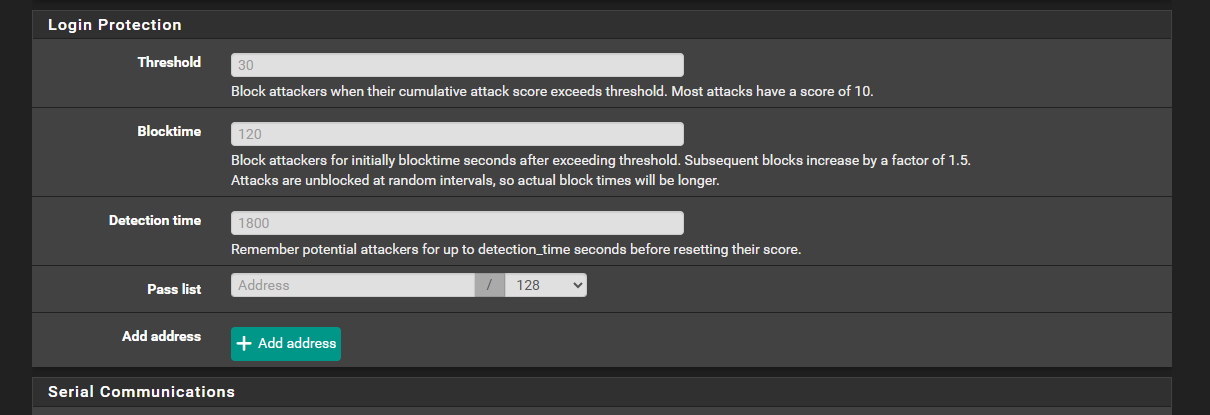
| Paramètre | Valeur | Lecture |
|---|---|---|
Threshold | 30 | un échec vaut 10 → trois échecs suffisent |
Blocktime | 120 s | « subsequent blocks increase by a factor of 1.5 » |
Detection time | 1800 s | le compteur ne se remet à zéro qu’après 30 minutes sans tentative |
   1er blocage :  120 s
   2e          :  180 s
   3e          :  270 s
   4e          :  405 s   ...
Ce n’était pas une panne intermittente, mais un mécanisme qui s’aggravait tout seul. Avec un client qui reconnecte automatiquement, le compteur ne redescend jamais.
Cause racine — le champ PASSWORD (OPTIONAL) de l’hôte Termix contenait encore un mot de
passe, alors que pfSense n’accepte pas l’authentification par mot de passe pour admin
(voir G-05). Chaque connexion produisait donc un échec, même quand la clé finissait par
réussir.
Résolution en deux temps :
- Supprimer la cause — vider complètement le champ mot de passe dans Termix, ne garder que la clé.
- Exempter les sources d’administration — System → Advanced → Admin Access → Login
Protection → Pass list :
Address / 10.0.30.1232 100.64.0.010
Déblocage immédiat, depuis Diagnostics → Command Prompt :
pfctl -t sshguard -T show
pfctl -t sshguard -T flush
Une liste blanche n’affaiblit un mécanisme que si elle est large. Ici elle vise deux sources déjà protégées autrement — le bastion, dans un VLAN d’administration, et le tailnet, fermé à deux appareils nominatifs. La protection reste entière pour le reste du monde. C’est de la défense en profondeur correctement dosée, pas un contournement.
Le champ Pass list n’accepte pas d’alias — contrairement aux règles de pare-feu. Les adresses s’y saisissent directement, avec leur masque. Un alias créé pour l’occasion serait inutilisable ici.
Incident annexe — type d’alias Host(s) refusant un /10
En créant l’alias prévu (avant de découvrir qu’il serait inutile), trois erreurs apparaissent :
Subnet is too large to expand into individual host IP addresses (100.64.0.0/10)
The maximum number of entries in an alias is 5000
100.64.0.0/10 is not a valid host address, FQDN or alias
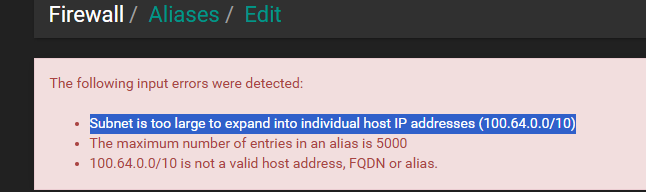
Cause — le type Host(s) développe les réseaux en adresses individuelles : un /10
représenterait plus de 4 millions d’entrées, pour une limite de 5000.
Résolution — utiliser le type Network(s), qui conserve les blocs CIDR tels quels.
Deux types, deux usages :
Host(s)pour une liste d’adresses individuelles,Network(s)pour des blocs. L’aliasLAB_NETSdu TP est enNetwork(s), ce qui lui permet de contenir cinq/24— même mécanisme.
H-14 · lsyncd : option -s has been disabled on this server
Symptôme — Au premier démarrage de lsyncd, la synchronisation initiale échoue :
Exec: /usr/bin/rsync [--delete] [--ignore-errors] [-lspztogD] [--rsh=ssh ...] ...
/usr/bin/rrsync error: option -s has been disabled on this server.
Error: Temporary or permanent failure on startup. Terminating since "insist" is not set.
Cause — lsyncd ajoute par défaut l’option -s (--protect-args), visible dans le
-lspztogD de la commande construite. Or rrsync la refuse délibérément.
   rsync NORMAL                        rsync avec -s (--protect-args)
   ────────────                        ──────────────────────────────
   les chemins sont dans la            les chemins sont transmis DANS
   ligne de commande                   le flux du protocole
            │                                     │
   rrsync les LIT et les filtre        rrsync ne les voit plus
            ▼                                     ▼
   confinement applicable              confinement CONTOURNABLE
--protect-args déplace les chemins hors de la ligne de commande pour les protéger de
l’interprétation par le shell distant. Utile en temps normal — mais cela rendrait rrsync
aveugle : il n’aurait plus rien à inspecter pour vérifier que le client reste dans le
répertoire autorisé.
Résolution — dans le bloc rsync de lsyncd.conf.lua :
protect_args = false,
La commande construite devient [-gztlpoD], sans le s, et la synchronisation aboutit
(Startup ... finished: 0).
Quand deux couches de sécurité se contredisent, celle qui protège doit gagner.
rrsyncpréfère échouer bruyamment plutôt que de laisser passer en se mettant en veilleuse. Un mécanisme de sécurité qui refuse d’être désactivé est exactement ce qu’on attend de lui.
Deux autres pièges du même chantier :
Piège Cause Clé SSH générée pour www-data— inutilisableson interpréteur est /usr/sbin/nologin; SSH refuse tout compte sans shell valide, même avec une commande forcéersyncabsent sur la machine ciblersyncfonctionne en paire : la commande locale lance unrsync --serverà distanceEt le service
lsyncdde Debian est un enrobage SysV :systemctl statusafficheactive (exited), ce qui signifie « le script de démarrage s’est terminé », pas « le démon tourne ». Vérifier le processus, pas le service :pgrep -a lsyncd.
H-15 · Accès SSH à poste-win11 perdu trois fois de suite, pour trois raisons différentes
Contexte — Bascule du DNS du VLAN 40 vers AD-Core-01, puis jonction de poste-win11 au
domaine. L’accès SSH au poste, par le bastion, a été perdu trois fois. Chaque perte avait
une cause distincte, et aucune n’était celle de la précédente.
C’est ce qui rend cet incident instructif : le même symptôme, trois causes. Diagnostiquer la troisième avec le raisonnement de la première fait perdre beaucoup de temps.
① La commande qui coupe sa propre session
Symptôme — Session SSH perdue instantanément au lancement de :
ipconfig /release; ipconfig /renew
Cause — /release libère l’adresse IP de la machine. Or c’est par cette adresse que la
session SSH était établie : la connexion meurt avant que /renew ne s’exécute.
Résolution — Reprise par la console de l’hyperviseur, accès hors-bande qui ne dépend d’aucune configuration réseau. Le client DHCP avait déjà réobtenu le bail de lui-même.
À retenir — Avant toute commande réseau sur une machine distante, se poser la question : « est-ce que j’administre cette machine par ce que je m’apprête à modifier ? »
ipconfig /release,Restart-NetAdapter, un changement d’adresse ou une règle de pare-feu coupent tous la session qui les exécute.La bonne commande dans ce cas : changer le résolveur sans toucher au bail.
Set-DnsClientServerAddress -InterfaceAlias "Ethernet" -ServerAddresses 10.0.30.10
Set-DnsClientServerAddress -InterfaceAlias "Ethernet" -ResetServerAddresses   # retour au DHCP
Et le corollaire : un accès hors-bande n’est pas un confort, c’est la condition pour oser administrer à distance. Sans la console de l’hyperviseur, il fallait se déplacer.
② Le profil réseau bascule en Public
Symptôme — L’adresse et le DNS sont corrects, sshd tourne, mais la connexion échoue.
Diagnostic
Get-Service sshd; Get-NetConnectionProfile
Status  Name  DisplayName
Running sshd  OpenSSH SSH Server          <- le service va bien

NetworkCategory          : Public         <- la cause
DomainAuthenticationKind : None
Cause — Windows identifie un réseau par une signature : adresse MAC de la passerelle,
suffixe DNS, configuration reçue. ipconfig /release efface cette configuration ; au
renouvellement, le service d’identification voit un réseau qu’il considère comme nouveau.
Et tout réseau nouveau est classé Public par défaut, donc soumis aux règles de pare-feu
les plus strictes.
Résolution
Set-NetConnectionProfile -InterfaceAlias Ethernet -NetworkCategory Private
À retenir — Un
/renewseul ne change pas le profil. C’est bien le/releasequi provoque la ré-identification. Le profil réseau est un effet de bord invisible des manipulations DHCP.
③ La règle de pare-feu n’était liée qu’à un seul profil
Symptôme — Après la jonction au domaine, SSH tombe une troisième fois. Termix affiche :
Authenticating as SIO\Administrateur
Délai de connexion dépassé                 <- 34 secondes plus tard
Le détail qui oriente le diagnostic — « Délai de connexion dépassé », pas « échec d’authentification ».
| Ce qu’on observe | Ce que ça signifie |
|---|---|
| Réponse immédiate de refus | Le serveur a répondu : c’est l’authentification qui a échoué |
| Délai puis abandon | Le paquet a été jeté sans réponse : c’est un pare-feu |
Diagnostic — Dans Pare-feu Windows Defender avec fonctions avancées de sécurité
(wf.msc), règles de trafic entrant :
| Règle | Activée | Profil | Action |
|---|---|---|---|
OpenSSH SSH Server (sshd) | Oui | Privé | Autoriser |
Cause — OpenSSH avait été installé alors que la machine était sur le profil Privé :
Windows a créé la règle pour ce profil-là uniquement. La jonction au domaine a fait
basculer la machine sur un troisième profil, DomainAuthenticated, que la règle ne
couvrait pas.
Résolution — Double-clic sur la règle → onglet Avancé → cocher Domaine. Effet immédiat, sans redémarrage.
Enabled         Profile Action
   True Domain, Private  Allow
À retenir — Une règle de pare-feu Windows liée à un seul profil est une bombe à retardement : elle fonctionne jusqu’au jour où la machine change de contexte réseau — jonction à un domaine, déplacement, renouvellement de bail. Sur une machine d’infrastructure à adresse fixe, cocher au minimum
DomaineetPrivédès l’installation du service.
Deux fausses pistes qu’il a fallu écarter
| Hypothèse | Pourquoi elle semblait tenir | Pourquoi elle était fausse |
|---|---|---|
| « C’est l’authentification qui bloque » | Le journal affichait Connecting, puis Starting SSH session, puis le délai | Le journal entrelaçait deux hôtes (10.0.40.100 et 10.0.10.5). Les lignes lues ne concernaient pas toutes la même connexion |
| « Le nom d’utilisateur n’est plus valable » | Plausible : sur une machine jointe au domaine, OpenSSH résout un nom nu comme un compte du domaine, et admin est un compte local | Vrai en soi, mais ce n’était pas la cause ici — le délai désignait le réseau, pas l’identité |
Le second point reste vrai et utile : après une jonction au domaine, pour ouvrir une session SSH avec un compte local, il faut l’écrire explicitement —
POSTE-WIN11\admin. Un nom nu est cherché dans l’annuaire.
H-16 · Installation des outils RSAT figée : le DNS répond, mais le poste échoue à résoudre
Symptôme — Add-WindowsCapability … Rsat.ActiveDirectory… reste sur Operation Running,
barre de progression immobile plus de 20 minutes. Le journal dism.log ne contient aucune
erreur : sa dernière ligne signale que le service de maintenance démarre.
Diagnostic
| Test | Résultat |
|---|---|
Test-NetConnection download.windowsupdate.com -Port 80 | Name resolution failed |
Resolve-DnsName download.windowsupdate.com -Server 10.0.30.10 | répond |
Resolve-DnsName download.windowsupdate.com -Server 10.0.40.1 | répond |
Clear-DnsClientCache, puis le premier test | TcpTestSucceeded : True |
Le contraste est ce qui désigne la cause. Interroger un serveur DNS directement contourne le résolveur du poste. Quand les serveurs répondent et que le test passant par le système échoue, c’est le cache DNS du poste qui ressert un échec mémorisé. Windows met en cache les échecs, pas seulement les succès.
Piège de lecture rencontré — Resolve-DnsName … | select -First 2 n’affichait que les
CNAME de la chaîne, donc une colonne IPAddress vide. Elle n’indique pas un échec. Pour voir
l’adresse : | ? IPAddress | select Name, IPAddress.
Résolution — Clear-DnsClientCache, puis relance de l’installation (Restart-Service wuauserv). Elle s’est terminée et la console s’ouvre.
Ce qui n’est pas établi : le vidage du cache a rétabli la résolution, mais rien ne prouve qu’il était la seule cause de la lenteur de l’installation. C’est la cause constatée, pas démontrée.
À retenir — Devant une résolution qui échoue sur un poste Windows alors que le serveur DNS répond, tester par le résolveur du système avant de chercher une panne côté serveur.
H-17 · Potential DNS Rebind attack detected en publiant pfSense par un nom de domaine
Symptôme — la ressource Pangolin vers https://10.0.30.1:443 est créée, le nom
pfsense.pangolin.<domaine> répond, mais la page affichée est un fond rouge :
Potential DNS Rebind attack detected, see https://en.wikipedia.org/wiki/DNS_rebinding
Try accessing the router by IP address instead of by hostname.
Ce que le message prouve — c’est pfSense lui-même qui répond : le certificat joker, l’entrée Nginx Proxy Manager, Pangolin, le tunnel et la cible ont donc tous fonctionné. Le refus est volontaire et ne vient d’aucun maillon de la chaîne.
Cause — pfSense n’accepte de servir son interface qu’aux noms qu’il connaît (son nom d’hôte, ses adresses). Un nom inconnu est traité comme une possible attaque par DNS rebinding : un site hostile pourrait faire pointer son propre nom vers l’adresse privée du pare-feu pour joindre son interface depuis le navigateur d’un administrateur.
Résolution — déclarer le nom comme légitime :
| Où | Valeur |
|---|---|
| System → Advanced → Admin Access | champ Alternate Hostnames |
| Valeur | pfsense.pangolin.<domaine> |
Puis Save. L’écran de connexion de pfSense s’affiche. Cet accès se fait par l’adresse IP habituelle de l’interface, pas par le nouveau nom, tant que le réglage n’est pas enregistré.
Ne pas cocher « Disable DNS Rebinding Checks » : cela supprime la protection pour tous les noms au lieu d’en déclarer un seul.
À retenir — Un message d’erreur émis par l’application visée est une bonne nouvelle quand on construit une chaîne de transport : tout ce qui est en amont fonctionne. Ici, il a même indiqué la parade, déclarer le nom, sans toucher au reste.
Ce qui n’est pas établi — seul l’écran de connexion a été vu. Le comportement de pfSense après la connexion (vérification de l’en-tête
Referer, que le nom alternatif devrait aussi couvrir) n’a pas été éprouvé.
H-18 · Pangolin : « no available server » devant une cible qui répond 401
Symptôme — la ressource vers la page de statistiques de HAProxy (http://10.0.10.5:8404) est créée, le
tunnel est établi, la règle de pare-feu est en place (curl depuis le bastion : HTTP/1.1 401). Mais la
page s’affiche : no available server, même après authentification. Dans la liste, la ressource est la
seule en « En mauvaise santé ».
Cause — Pangolin fait un contrôle de santé régulier sur chaque cible : il lui demande sa page
d’accueil et attend une réponse de succès. HAProxy exige un identifiant et répond 401 Unauthorized.
Pangolin juge donc la cible hors service, et le reverse proxy (Traefik) répond « no available server »
au lieu de lui transmettre la demande.
Résolution — retirer le contrôle de santé de cette cible : ressource → onglet HTTP → bouton de la colonne Vérification de l’état de santé. La page s’affiche ensuite (avec la demande d’identifiant de HAProxy).
À retenir — « no available server » ne veut pas dire que la cible est injoignable : il veut dire que le proxy la croit malade. Le
curldepuis la machine du tunnel a tranché : il a montré que la cible répondait. Un contrôle de santé qui reçoit un401peut le prendre pour une panne.
Non essayé : régler le contrôle de santé pour qu’il accepte
401(si l’interface le permet) au lieu de le retirer. Retirer le contrôle supprime aussi la détection d’une vraie panne de cette cible.
H-19 · Après l’arrêt complet du lab, le cluster Galera ne redémarre pas seul
Contexte — le 15/10, toutes les VM ont été éteintes (intervention du formateur sur un disque de l’hyperviseur,
puis déplacement des disques des VM vers storage-images).
Symptôme — au rallumage, les trois nœuds répondent au ping et en SSH, mais le port 3306 est fermé sur les
trois ; les serveurs web renvoient une erreur 500 (WordPress sans base).
Cause — un cluster Galera entièrement arrêté ne sait pas lequel de ses nœuds a les données les plus
récentes : aucun ne prend l’initiative de reformer le groupe. Sur les trois nœuds, /var/lib/mysql/grastate.dat
indiquait seqno: -1 et safe_to_bootstrap: 0.
Résolution — démarrage à froid (MO-2 §8.1) :
- sur un seul nœud (ici
srv-mysql-03) :safe_to_bootstrap: 1dansgrastate.dat, puisgalera_new_cluster; - démarrer MariaDB normalement sur les deux autres, l’un après l’autre (
systemctl start mariadb).
Vérification — sur chaque nœud : wsrep_cluster_size = 3, wsrep_cluster_status = Primary,
wsrep_local_state_comment = Synced, et le même wsrep_cluster_state_uuid partout. Les sites répondent 200.
Fausse alerte écartée — pendant qu’un nœud rejoint le groupe, il peut afficher brièvement
wsrep_cluster_size = 1. Ce n’est pas un cluster coupé en deux : il faut comparer lesuuidet attendre la fin de la synchronisation avant de conclure.
À retenir — avec
seqno: -1partout, rien n’indique quel nœud est le plus à jour. La position réelle peut être lue avecmysqld --wsrep-recoversur chaque nœud ; cela n’a pas été fait ici : à faire la prochaine fois avant de choisir le nœud d’amorçage.
H-20 · Restauration PBS : VM verrouillée après « restore image complete »
Symptôme — restauration d’une sauvegarde PBS vers une VM d’essai (139). Le journal affiche
restore image complete, puis plus rien pendant plusieurs minutes. La tâche est arrêtée. La VM reste avec un
cadenas (lock: create), une mémoire de 128 Mio (valeur par défaut) : sa configuration n’a jamais été écrite.
Cause — restore image complete ne marque pas la fin. Le programme de restauration attend que le stockage
ZFS ait réellement écrit les données sur les deux disques mécaniques du miroir (≈ 16 à 23 Mo/s observés avec
zpool iostat, pool partagé), puis il écrit la configuration de la VM. Arrêtée avant, la tâche laisse une VM
incomplète.
Résolution — supprimer la VM incomplète, puis relancer la restauration sans l’interrompre :
qm unlock 139
qm destroy 139 --purge --destroy-unreferenced-disks 1
pvesm free storage-images:vm-139-disk-0     # si le disque est resté
Le second essai se termine par rescan volumes... puis TASK OK (image : 100,75 s pour 32 Gio).
À retenir — une tâche silencieuse n’est pas une tâche bloquée. On attend
TASK OK; la durée réelle se lit dans Tasks (colonnes de début et de fin). Procédure : MO-12 §11.
H-21 · La sauvegarde de la VM du serveur PBS échoue : http upgrade request timed out
Symptôme — première nuit automatique vers PBS (16/10) : 11 VM sauvegardées sans erreur, mais la tâche se termine
par TASK ERROR: job errors. Pour la VM 137 (le serveur PBS lui-même), le journal indique :
INFO: issuing guest-agent 'fs-freeze' command
INFO: issuing guest-agent 'fs-thaw' command
ERROR: VM 137 qmp command 'backup' failed - backup connect failed: command error: http upgrade request timed out
Deux minutes s’écoulent entre le début de la sauvegarde de cette VM (02:34:07) et l’échec (02:36:11).
Cause (probable, non prouvée) — la tâche tente d’ouvrir une connexion vers le serveur PBS, qui est justement dans la machine qu’elle sauvegarde (gel du système de fichiers de la VM, au moment où le serveur doit répondre). La VM avait été laissée dans le pool sauvegardé, choix assumé le 15/10 sans avoir vu ce cas.
Résolution — retirer la VM 137 du pool SIO2527_Axel (Datacenter → Permissions → Pools → pool → Members →
VM → Remove), fait le 16/10. Confirmé le 17/10 par le journal de la nuit du 16 au 17 : 11 VM sauvegardées, TASK OK en 16 min 37 s, VM 137 absente.
Pourquoi ne pas simplement ignorer l’erreur — une tâche qui échoue chaque nuit ne signale plus rien : la première vraie panne passerait inaperçue. La sauvegarde de cette VM est de toute façon peu utile : son disque de données est exclu, et on réinstalle PBS en quelques minutes en rattachant le datastore (non testé).
À retenir — une VM qui héberge la sauvegarde ne se sauvegarde pas par ce même outil. Pour retrouver une VM exclue : Datacenter → Backup → « Show: Guests Without Backup Job » la liste, ce qui est ici voulu. Procédure : MO-12 §4.
H-22 · Un bloc collé deux fois dans nano : des jobs Prometheus en double
Symptôme — en ajoutant trois jobs de sondes à /etc/prometheus/prometheus.yml avec nano, les captures montrent les trois
jobs deux fois dans le fichier (sonde_https, sonde_dns_ad, sonde_dns_resolveur, puis de nouveau les mêmes).
Cause — le bloc a été collé deux fois dans le terminal web de Termix. Prometheus refuse deux jobs de même nom
(found multiple scrape configs with job name) : un rechargement sans contrôle aurait gardé l’ancienne configuration en silence.
Résolution — le fichier d’avant est restauré depuis la copie faite au préalable (prometheus.yml.avant-sondes), puis le bloc
est ajouté par une commande unique qui l’écrit directement et ne fait rien s’il est déjà présent :
grep -q "sonde_https" /etc/prometheus/prometheus.yml || sudo tee -a /etc/prometheus/prometheus.yml > /dev/null <<'EOF'
…le bloc…
EOF
Garde-fous, avant chaque rechargement : grep -c job_name compte les jobs (5 attendus, 8 révélerait un doublon) puis promtool check config.
À retenir — on copie le fichier avant de le modifier, on compte et on valide avant de recharger. Une écriture par commande (idempotente) évite les erreurs de collage que
nanolaisse passer.
H-23 · La sonde TCP du blackbox exporter échoue sur MariaDB alors que la bannière arrive
Symptôme — la sonde tcp_mariadb (connexion à 10.0.10.5:3306, avec attente du texte MariaDB) renvoie probe_success 0, alors qu’un
bash lit bien la bannière (11.8.6-MariaDB-0+deb13u1 from Debian) sur le même port.
Diagnostic — le mode debug=true du blackbox montre : connexion réussie, puis, cinq secondes plus tard seulement, « Regexp matched »
avec la bannière, puis i/o timeout. Le blackbox lit ligne par ligne ; la bannière de MariaDB ne se termine pas par un retour à la
ligne et le serveur, qui attend l’authentification, ne ferme pas la connexion : la lecture n’est livrée qu’à l’expiration du délai, et la
lecture suivante échoue.
Décision — la sonde est abandonnée, pas contournée :
- même corrigée, elle ouvrirait à chaque passage une connexion sans authentification : MariaDB compte ces connexions interrompues par
adresse (
max_connect_errors), au risque de bloquer l’adresse du répartiteur, donc WordPress ; - le service « base de données vu par l’application » est déjà couvert par la sonde du site web (la page de WordPress est lue dans la base) ;
- l’état réel du cluster sera mesuré par
mysqld_exporter(tâche 14.4), qui s’authentifie.
Le module et la règle de pare-feu associée (SRV_METRIQUES → SRV_HA : 3306) ont été retirés.
À retenir — une sonde de disponibilité ne doit pas laisser de trace côté serveur. Vérifier ce qu’une sonde provoque sur le service, pas seulement si elle répond, avant de la planifier toutes les 15 secondes. Les tests à la main (
curl,bash) ne reproduisent pas toujours le comportement d’un outil.
H-24 · Un long fichier collé dans le terminal web arrive corrompu
Symptôme — le 20/10, en collant d’un bloc un prometheus.yml complet (~70 lignes, par une commande tee) dans le terminal web de Termix,
le fichier obtenu est incomplet et mélangé : lignes coupées, morceaux décalés.
Cause — le terminal web transmet le collage par morceaux ; sur un long texte, une partie arrive abîmée. Les collages courts (une commande, quelques lignes) passent sans problème.
Résolution — restauration depuis la copie faite avant (prometheus.yml.avant-filesd), puis changement de méthode : le fichier est écrit sur le PC,
transféré par scp, puis installé avec les bons droits.
scp "…\annexes\scripts\supervision\prometheus.yml" ipfixe@10.0.30.14:/tmp/prometheus.yml
sudo cp /etc/prometheus/prometheus.yml /etc/prometheus/prometheus.yml.avant-xxx
sudo install -m 644 -o root -g root /tmp/prometheus.yml /etc/prometheus/prometheus.yml
grep -c job_name /etc/prometheus/prometheus.yml && promtool check config /etc/prometheus/prometheus.yml
À retenir — un fichier se transfère, il ne se colle pas. Le transfert donne en prime une copie de référence sur le PC, rangée avec la documentation.
H-25 · apt installe une trentaine de paquets pour un simple exporteur
Symptôme — apt install prometheus-node-exporter sur srv-metriques et srv-supervision annonce une trentaine de paquets, dont smartmontools,
ipmitool, openipmi, nvme-cli, jq, snmp, et active des services.
Cause — par défaut, apt installe aussi les paquets recommandés. Celui de l’exporteur, prometheus-node-exporter-collectors, tire tout un
outillage matériel inutile sur une VM.
Résolution — nettoyage des deux VM : sudo apt purge prometheus-node-exporter-collectors puis sudo apt autoremove --purge (23 paquets, 30,9 Mo libérés).
Les installations suivantes (script installer-node-exporter.sh) utilisent --no-install-recommends : un seul paquet installé sur chacune des 8 machines suivantes.
À retenir — sur un serveur, lire la liste « NOUVEAUX paquets » avant de valider.
--no-install-recommendsinstalle ce qu’on a demandé, et rien d’autre : moins de services, moins de surface d’attaque, moins de mises à jour.
H-26 · Le script de déploiement continue après un échec de connexion
Symptôme — bash ajouter-machine.sh 10.0.10.12 ipfixe (faute de frappe pour 10.0.30.12) affiche ssh: connect to host 10.0.10.12 port 22: Connection timed out,
puis continue et propose un nom vide : Nom de la machine [] :.
Cause — le nom est lu par LU=$(ssh … 'hostname -s' | tr …). Dans une suite de commandes reliées par |, bash ne retient que le code de retour de la
dernière (tr, qui réussit) : l’échec de ssh passe inaperçu malgré set -e.
Résolution — set -euo pipefail en tête du script : avec pipefail, un échec n’importe où dans la suite fait échouer l’ensemble, et le script s’arrête.
À retenir — dans un script bash,
set -ene suffit pas dès qu’il y a un|: toujoursset -euo pipefail. Une erreur de saisie est le meilleur test d’un script.
H-27 · IsInRole('Administrators') répond False à un administrateur
Symptôme — sur AD-Core-01, dans une session du compte Administrateur, le test
([Security.Principal.WindowsPrincipal][Security.Principal.WindowsIdentity]::GetCurrent()).IsInRole('Administrators') renvoie False.
Cause — le test cherche le groupe par son nom, et Windows est en français : le groupe s’appelle « Administrateurs ». Le résultat est un faux négatif.
Résolution — tester le rôle intégré, indépendant de la langue :
([Security.Principal.WindowsPrincipal][Security.Principal.WindowsIdentity]::GetCurrent()).IsInRole([Security.Principal.WindowsBuiltInRole]::Administrator)
Résultat : True.
À retenir — sous Windows, les noms des groupes intégrés dépendent de la langue ; leurs identifiants, non. Un test de droits doit viser l’identifiant.
H-28 · Un mot de passe s’affiche en clair dans le terminal
Symptôme — le 20/10, pendant le déploiement depuis le bastion, une ligne contenant un mot de passe en clair apparaît entre l’invite
[email protected]'s password: et l’invite [sudo] Mot de passe de ipfixe :. Elle reste visible dans l’historique du terminal.
Cause — le mot de passe sudo a été tapé avant que l’invite [sudo] ne s’affiche : à cet instant, le terminal affiche ce qu’on tape (l’écho n’est coupé
qu’une fois l’invite de mot de passe ouverte).
Résolution — attendre l’invite avant de taper. Le mot de passe exposé doit être changé (passwd sur chaque machine qui l’utilise) :
Décision d’Axel (23/10) : le mot de passe est conservé (laboratoire, risque assumé), alors qu’il a été affiché une seconde fois le 23/10 (tapé au lieu du nom de machine dans ajouter-machine.sh, qui recopiait la saisie invalide : corrigé, le script n’affiche plus la saisie). Il n’est reporté dans aucun document.
À retenir — un mot de passe tapé trop tôt est un mot de passe affiché. Un secret exposé, même un instant, se change. Les connexions par clé (déjà en place sur
srv-metriquesetsrv-supervision) suppriment la plupart des saisies.
H-29 · pfSense refuse une réservation DHCP : must not be within the DHCP range
Symptôme — en réservant 10.0.40.100 (adresse du poste à ce moment) pour poste-win11, pfSense répond :
The IP address must not be within the DHCP range for this interface.
Cause — avec le serveur DHCP ISC (celui de pfSense ici), une réservation doit être en dehors de la plage distribuée (.100 à .199), pour que la même
adresse ne puisse pas être donnée à deux machines.
Résolution — réservation sur 10.0.40.10, hors plage (même logique que les serveurs en .10) ; sur le poste, ipconfig /release puis ipconfig /renew :
nouvelle adresse obtenue. Plan d’adressage et schéma mis à jour.
À retenir — une machine supervisée doit avoir une adresse stable : réservation DHCP ou adresse fixe, hors de la plage dynamique. Le bandeau de pfSense signale aussi qu’ISC DHCP sera remplacé par Kea : à surveiller lors d’une mise à jour.
H-30 · Une règle du pare-feu Windows créée deux fois
Symptôme — sur poste-win11, la liste des règles du port 9182 montre deux règles windows_exporter - srv-metriques seul.
Cause — la commande de création a été envoyée deux fois (latence de la session à distance) : New-NetFirewallRule ne vérifie pas qu’une règle du même nom existe.
Résolution — sans gravité (règles identiques), mais nettoyée : Remove-NetFirewallRule -DisplayName '…' supprime toutes les règles de ce nom, puis
une seule est recréée. Le script installer-windows-exporter.ps1 ne crée la règle que si elle n’existe pas.
À retenir — une commande qui crée quelque chose doit pouvoir être relancée sans effet de bord : on teste l’existence avant de créer (idempotence).
H-31 · TLS/SSL error: self-signed certificate avec un compte MariaDB sans mot de passe
Symptôme — depuis srv-supervision, mariadb -h 10.0.20.10 -u haproxy_check -e "SELECT @@hostname" répond
ERROR 2026 (HY000): TLS/SSL error: self-signed certificate, sur les trois nœuds.
Cause — depuis la version 11.4, le client MariaDB vérifie par défaut le certificat du serveur. Les nœuds utilisent le certificat auto-signé généré par MariaDB. Avec un compte à mot de passe, le client sait valider ce certificat grâce au mot de passe ; le compte de sonde n’en a pas : rien ne permet la vérification, le client refuse. Bonne nouvelle au passage : l’erreur arrive après la connexion TCP, donc le réseau et la règle pfSense fonctionnent.
Résolution — pour le test du compte de sonde seulement : --skip-ssl-verify-server-cert (le compte n’a aucun droit et ne lit aucune donnée). Les comptes
rsyslog, grafana_lecture et grafana, qui ont un mot de passe, se connectent sans cette option : le certificat est vérifié. La sonde de HAProxy
(mysql-check) n’utilise pas TLS et n’est pas concernée.
À retenir — un refus TLS prouve que le réseau passe. Ne pas désactiver la vérification partout « pour que ça marche » : la réserver au seul cas où elle est impossible et sans enjeu.
H-32 · Impossible d'obtenir le verrou /var/lib/dpkg/lock-frontend pendant un déploiement
Symptôme — ajouter-machine.sh sur srv-metriques s’arrête : E: Impossible d'obtenir le verrou … Il est occupé par le processus 50354 (apt-get).
Cause — une autre installation tournait déjà : la recherche automatique de mises à jour de Debian. On ne peut pas faire deux installations à la fois.
Résolution — relance quelques minutes plus tard : réussite. Les installeurs utilisent désormais apt-get -o DPkg::Lock::Timeout=300 : ils attendent jusqu’à
5 minutes que le verrou se libère au lieu d’abandonner.
À retenir — ne jamais supprimer le fichier verrou (apt le rappelle) : attendre que l’autre installation finisse. Un script de déploiement doit prévoir cette attente.
H-33 · Le script annonce que le port 9100 n’écoute pas, alors que le service tourne
Symptôme — sur srv-mysql-01, ERREUR : le port 9100 n'ecoute pas sur 10.0.20.10. Juste après, systemctl is-active répond active et ss montre
l’écoute sur 10.0.20.10:9100.
Cause — le script vérifiait une seconde après avoir redémarré le service. Le nœud principal du cluster, chargé, a mis plus longtemps : son journal montre le démarrage à 11:35:44 (heure universelle) écrit seulement 6 secondes plus tard.
Résolution — la vérification attend jusqu’à 15 secondes ; le service n’est plus redémarré que si son réglage change (relancer le script ne coupe plus les mesures).
À retenir — un contrôle trop pressé crée de fausses pannes. Attendre un résultat par une boucle bornée, pas par un délai fixe.
H-34 · 35 000 lignes de journaux en quelques heures : le blackbox exporter trop bavard
Symptôme — dès la centralisation, srv-metriques a envoyé 35 709 lignes « info » contre 100 à 300 pour les autres machines. Programme :
prometheus-blackbox-exporter.
Cause — par défaut, le blackbox écrit cinq lignes par sonde réussie (adresse résolue, requête, réponse, temps, succès). Avec 4 sondes toutes les 15 secondes : environ 80 lignes par minute, plus de 100 000 par jour, pour dire que tout va bien — information déjà présente dans Prometheus.
Résolution — --log.level=warn ajouté à /etc/default/prometheus-blackbox-exporter, redémarrage : 21 cibles toujours up, 0 ligne la minute suivante. Les
36 063 lignes déjà reçues sont effacées depuis un nœud, avec le compte d’administration (les comptes de srv-supervision n’ont pas le droit de supprimer).
MO-13 corrigé.
À retenir — centraliser les journaux révèle aussitôt les programmes trop bavards. Les journaux gardent l’anormal ; le normal est dans les mesures.
H-35 · Les horloges des zones WEB et BDD ne se sont jamais synchronisées
Symptôme — systemd-timesyncd écrit environ 3 messages par minute sur srv-ha, srv-web-01/02 et les trois nœuds : Timed out waiting for reply from …:123 (3.debian.pool.ntp.org). timedatectl : System clock synchronized: no.
Cause — Debian demande l’heure à des serveurs d’Internet (UDP 123). La zone BDD n’a pas d’Internet, la zone WEB ne sort qu’en TCP 80/443 : la demande n’aboutit jamais. Le défaut existait depuis la création des machines ; il était invisible tant qu’on ne regardait pas les journaux de toutes les machines ensemble.
Résolution — demander l’heure à pfSense (la passerelle de chaque machine), déjà autorisé par la règle « DNS et NTP fournis par pfSense » :
sudo mkdir -p /etc/systemd/timesyncd.conf.d && printf '[Time]\nNTP=%s\n' "$(ip route | awk '/^default/ {print $3; exit}')" | sudo tee /etc/systemd/timesyncd.conf.d/pfsense.conf && sudo systemctl restart systemd-timesyncd
Résultat : Server: 10.0.20.1 (ou 10.0.10.1), System clock synchronized: yes sur les six machines ; plus aucun échec ensuite. Réglage ajouté à
installer-rsyslog-client.sh pour les futures machines.
À retenir — dans un réseau cloisonné, une seule source d’heure interne. Des horloges fausses rendent les journaux incomparables et gênent un cluster.
H-36 · Pas d’empreinte publiée pour l’installeur .msi de Fluent Bit
Symptôme — sur l’AD, le .msi se télécharge, mais fluent-bit-5.1.3-win64.msi.sha256 répond 404.
Cause — la page officielle publie les empreintes SHA-256 des .exe et .zip, pas des .msi.
Résolution — le .msi n’est pas installé (impossible de prouver qu’il est intact). L’installeur .exe est téléchargé et son empreinte comparée à celle de la
documentation officielle (5B293C3A…367D3E) : EMPREINTE CONFORME, puis installation silencieuse (/S).
À retenir — on n’installe pas un logiciel téléchargé sans pouvoir vérifier son empreinte auprès de la source officielle. Choisir le format vérifiable.
H-37 · NXLog Community Edition impossible à télécharger
Symptôme — le site de l’éditeur exige une connexion pour télécharger NXLog CE ; le compte créé n’est pas accepté.
Décision — ne pas dépendre de ce site : Fluent Bit (libre, CNCF, téléchargeable sans compte) le remplace. Il lit les journaux Windows et les envoie en syslog TCP,
sans aucun changement côté srv-supervision ni pfSense. Winlogbeat, autre option gratuite, a été écarté : il n’envoie pas en syslog.
À retenir — un outil dont l’accès dépend du bon vouloir d’un site commercial est un risque pour la maintenance ; à fonction égale, préférer celui qu’on peut toujours récupérer.
H-38 · haproxy : commande introuvable alors que le paquet est installé
Symptôme — sur srv-supervision, haproxy -v répond commande introuvable juste après l’installation.
Cause — Debian place haproxy dans /usr/sbin, qui n’est pas dans le chemin de recherche d’un utilisateur ordinaire (ipfixe).
Résolution — chemin complet : /usr/sbin/haproxy -v → HAProxy version 3.0.11 ; le service, lui, tournait (active). Même cas pour sudo /usr/sbin/haproxy -c -f ….
À retenir — « commande introuvable » ne veut pas dire « non installé » : vérifier avec
dpkg -lou le chemin complet.
H-39 · Le cluster Galera entièrement arrêté pendant la migration des disques
Symptôme — le 23/10 vers 17 h 20, le site web ne répond plus. Prometheus : sonde du site à 0, mysql_up à 0 sur les trois nœuds. Sur srv-mysql-01, MariaDB reste « activating » ; sur srv-mysql-02, il est en échec.
Contexte — déplacement des disques des VM vers le NAS (étape 49.2), méthode « VM arrêtée → Move Storage → démarrage ». srv-mysql-01 arrêté à 17:03 et pas redémarré ; srv-mysql-02 arrêté à 17:09 ; srv-mysql-03 arrêté à 17:18:45, 26 s après le démarrage de srv-mysql-02, qui n’avait pas fini de rejoindre le cluster.
Cause — trois arrêts propres successifs. À chaque départ, les nœuds restants continuent ; le dernier arrêté (srv-mysql-03) est le seul à posséder toutes les transactions, et son fichier grastate.dat porte safe_to_bootstrap: 1. Les deux autres, au démarrage, cherchent un cluster qui n’existe plus et refusent de démarrer seuls. Un cluster Galera entièrement arrêté ne redémarre jamais tout seul : c’est voulu, pour ne pas repartir d’une copie en retard.
Résolution — sans rien modifier d’abord, lire l’état des trois nœuds :
sudo cat /var/lib/mysql/grastate.dat      # seqno, safe_to_bootstrap
sudo galera_recovery                      # position réelle de chaque nœud (lecture seule)
Positions : srv-mysql-01 = 225840, srv-mysql-02 = 225989, srv-mysql-03 = 226332 (le plus avancé, et le seul safe_to_bootstrap: 1), même identifiant de cluster sur les trois. Puis :
sudo galera_new_cluster                   # sur srv-mysql-03 seulement : il repart seul (Primary, Synced, taille 1)
sudo systemctl start mariadb              # sur srv-mysql-02, attendre wsrep_cluster_size = 2 et Synced
sudo systemctl start mariadb              # puis sur srv-mysql-01 : taille 3, Synced
Vérification : SHOW STATUS LIKE 'wsrep_cluster_size' → 3, wsrep_local_state_comment → Synced, même identifiant de cluster qu’avant ; sonde du site revenue à 1.
À retenir — sur un cluster Galera, un seul nœud arrêté à la fois, et on attend
3/Syncedavant de toucher au suivant. En cas d’arrêt complet, on redémarre depuis le nœud le plus avancé (galera_recovery), jamais au hasard. Procédure complète : MO-2. Incident voisin : H-19.
H-40 · node_exporter ne démarre pas au boot : bind: cannot assign requested address
Symptôme — après un redémarrage de srv-pbs (23/10), sa cible node reste down. Journal du service :
listen tcp 10.0.30.13:9100: bind: cannot assign requested address
cinq fois en une seconde, puis systemd abandonne (start-limit-hit).
Cause — l’exporteur écoute sur l’adresse IP précise de la machine, et non sur toutes ses adresses (choix de sécurité de l’étape 47). Au démarrage, le service peut se lancer avant que le réseau ait posé cette adresse : il ne peut pas s’y attacher. Cinq échecs rapides, et systemd arrête de réessayer.
Résolution — un complément de service (drop-in) qui le fait attendre le réseau et espacer les essais :
sudo mkdir -p /etc/systemd/system/prometheus-node-exporter.service.d
printf '[Unit]\nWants=network-online.target\nAfter=network-online.target\n\n[Service]\nRestartSec=5\n' \
  | sudo tee /etc/systemd/system/prometheus-node-exporter.service.d/attendre-reseau.conf
sudo systemctl daemon-reload && sudo systemctl reset-failed prometheus-node-exporter && sudo systemctl restart prometheus-node-exporter
Ajouté à installer-node-exporter.sh (et pour mysqld_exporter en zone BDD), puis ajouter-machine.sh relancé sur les 10 machines Linux : 21 cibles up.
À retenir — un service qui écoute sur une adresse précise doit attendre
network-online.target. Le défaut n’apparaît qu’au redémarrage, jamais pendant l’installation.
H-41 · Plusieurs « Move Storage » lancés en même temps échouent
Symptôme — le 23/10, environ six déplacements de disques lancés en parallèle vers le NAS ; deux échouent :
storage-Syno' -locked command timed out - aborting   (VM 139)
qmp command 'query-block-jobs' failed - got timeout   (VM 140)
Cause — tous visent le même stockage réseau (NFS) : Proxmox pose un verrou par stockage, et les copies simultanées saturent le NAS ; les commandes n’obtiennent pas de réponse à temps.
Résolution — un déplacement à la fois, de préférence VM arrêtée (la copie est alors bien plus rapide), puis démarrage. Les disques partiels des échecs ont été retirés avec les autres disques « Unused » (étape 49.5). Le même phénomène est réapparu le 27/10 lors de la suppression des anciens disques : chaque suppression en erreur a réussi au deuxième essai, lancée seule.
À retenir — sur un stockage partagé, les opérations lourdes se font en série. Le parallélisme ne fait pas gagner de temps : il fait échouer.
H-42 · Le poste Windows ne démarre plus depuis l’interface : timeout waiting on systemd
Symptôme — le 22/10 entre 08:46 et 08:48, trois clics sur Start pour la VM 101 (poste-win11) : timeout waiting on systemd.
Contexte — l’émulation SSD venait d’être cochée sur son disque (étape 49.1).
Cause — non établie. Le diagnostic dans le Shell de pve-01 ne montre aucun processus de la VM resté accroché ; le message apparmor="DENIED" … swtpm du journal est bénin. Hypothèse : lenteur passagère de systemd sur l’hyperviseur partagé, le matin.
Résolution — démarrage depuis le Shell de l’hyperviseur, qui affiche le vrai message en cas d’erreur :
qm start 101
→ VM démarrée en 16 s (13:39).
À retenir — quand l’interface échoue sans explication, la commande équivalente dans le shell (
qm start,qm stop…) donne un message précis, ou réussit.
H-43 · PBS, envoi par Gmail : wrong version number
Symptôme — en testant la cible de notification SMTP de PBS (23/10) :
SSL routines:tls_validate_record_header:wrong version number
Cause — le port 587 attend une connexion en clair, puis chiffrée par la commande STARTTLS ; la cible était réglée en TLS direct, le mode du port 465. Les deux côtés ne parlent pas le même début de protocole.
Résolution — Configuration → Notifications → mail-assistant : smtp.gmail.com, port 587, mode STARTTLS → mail de test reçu.
À retenir — 587 = STARTTLS, 465 = TLS direct. Le message
wrong version numbersignale presque toujours ce décalage.
H-44 · Des « Undelivered Mail Returned to Sender » de PBS, plusieurs jours après
Symptôme — les 24, 25 et 26/10, la boîte de l’assistant reçoit des retours d’erreur envoyés par srv-pbs :
<adresse-de-destination>: connect to alt2.gmail-smtp-in.l.google.com[…]:25: Connection timed out
(le 26/10 : Network is unreachable). Le message renvoyé est un compte rendu de Garbage Collection du 19, du 20 puis du 21/10.
Contexte — jusqu’au 23/10, PBS envoyait ses notifications par sa voie par défaut : la cible intégrée mail-to-root (programme sendmail, donc le serveur de messagerie local postfix), qui livre directement au serveur du destinataire sur le port 25.
Cause — le port 25 sortant est bloqué (comme sur la plupart des réseaux). postfix garde chaque message en file d’attente, réessaie pendant 5 jours, puis renvoie l’erreur à l’expéditeur : d’où ces retours, chacun 5 jours après l’envoi.
Résolution — envoi par un relais SMTP authentifié (Gmail, port 587, étape 49.3) ; le matcher par défaut, qui alimentait mail-to-root, est désactivé (tiret dans la colonne Enable, mention « Built-In (modified) », capture 101). Rien d’autre à faire : les derniers messages en file s’épuisent (fin attendue après le 28/10).
Effet de bord — le mail du matin de l’assistant classait ces retours comme un échec de sauvegarde du homelab personnel : fausse alerte du 26/10, corrigée hors de ce projet.
À retenir — un serveur ne doit pas livrer ses mails lui-même sur le port 25 : on passe par un relais authentifié. Un retour d’erreur peut arriver plusieurs jours après la cause.
H-45 · Grafana ne démarre pas sur la base Galera : could not read DB CA Cert path "" puis Error 1045
Symptôme 1 — après avoir réglé la base de Grafana sur le cluster (variables GF_DATABASE_* dans /etc/default/grafana-server), le service échoue :
could not read DB CA Cert path ""
Cause 1 — avec GF_DATABASE_SSL_MODE=skip-verify (connexion chiffrée sans vérifier le certificat, que MariaDB fabrique lui-même), Grafana exige quand même un fichier d’autorités de certification.
Résolution 1 — GF_DATABASE_CA_CERT_PATH=/etc/ssl/certs/ca-certificates.crt (le magasin du système).
Symptôme 2 — Error 1045: Access denied for user 'grafana'@'10.0.30.15'.
Cause 2 — la valeur du mot de passe dans le fichier n’était pas la bonne (collage incomplet).
Résolution 2 — ressaisie sans affichage, et remplacement de toute la ligne :
read -rsp "Mot de passe du compte grafana : " MDP; echo
sudo sed -i "s|^GF_DATABASE_PASSWORD=.*|GF_DATABASE_PASSWORD=${MDP}|" /etc/default/grafana-server; unset MDP
sudo systemctl restart grafana-server && systemctl is-active grafana-server     # → active
À retenir —
sedsur^VARIABLE=.*remplace la ligne entière : pas de reste d’une ancienne valeur. Le mot de passe ne passe ni par l’écran ni par l’historique (read -rsp).
H-46 · Les journaux s’affichent avec 2 h d’avance dans Grafana
Symptôme — le 23/10 vers 19 h 20, le panneau « Dernières connexions » affiche des lignes datées de 20:59. Requête de contrôle dans Grafana :
SELECT NOW() AS heure_base, UTC_TIMESTAMP() AS heure_utc, MAX(recu_le) AS dernier_journal
FROM syslog.journaux_auth
→ heure_base 21:21, heure_utc 19:21 (la vraie heure), dernier_journal 21:21.
Cause — rsyslog écrivait l’heure locale de srv-supervision (Europe/Paris) dans des colonnes DATETIME, qui ne portent aucun fuseau. Grafana considère que les dates de la base sont en UTC et les convertit à l’heure du navigateur (UTC+2 en heure d’été) : +2 h.
Résolution —
- À la source : les nouvelles lignes en UTC. Copie de sécurité, puis ajout de
date.inUTC="on"aux 4 dates des deux modèles d’insertion (qui servent aussi pour pfSense) :sudo cp /etc/rsyslog.d/30-reception-galera.conf /etc/rsyslog.d/30-reception-galera.conf.avant-utc sudo sed -i 's/dateFormat="mysql")/dateFormat="mysql" date.inUTC="on")/' /etc/rsyslog.d/30-reception-galera.conf sudo grep -c 'date.inUTC="on"' /etc/rsyslog.d/30-reception-galera.conf # → 4 sudo rsyslogd -N1 && sudo systemctl restart rsyslog - Trouver la frontière entre anciennes et nouvelles lignes.
MAX(recu_le)ne convient plus : les anciennes lignes, en avance de 2 h, paraissent « dans le futur ». Toute ligne datée de plus de 30 min après l’heure UTC est une ancienne ; on relève le plus grand numéroidconcerné :SELECT MAX(id) FROM syslog.journaux WHERE recu_le > UTC_TIMESTAMP() + INTERVAL 30 MINUTE; -- 727698 SELECT MAX(id) FROM syslog.journaux_auth WHERE recu_le > UTC_TIMESTAMP() + INTERVAL 30 MINUTE; -- 197775 - Corriger les anciennes lignes sur un nœud (Galera recopie), après avoir vérifié
3/Synced, par paquets de 50 000 pour ne pas bloquer la réplication :for T in journaux:727698 journaux_auth:197775; do TABLE=${T%%:*}; FIN=${T##*:} for ((DEBUT=0; DEBUT<FIN; DEBUT+=50000)); do HAUT=$(( DEBUT+50000 < FIN ? DEBUT+50000 : FIN )) sudo mariadb -e "UPDATE syslog.$TABLE SET recu_le = recu_le - INTERVAL 2 HOUR WHERE id > $DEBUT AND id <= $HAUT" done done - Preuve :
SELECT COUNT(*) … WHERE recu_le > UTC_TIMESTAMP()→0dans les deux tables.
Limite — la colonne emis_le (heure donnée par la machine émettrice) des anciennes lignes n’est pas corrigée ; Grafana utilise recu_le.
À retenir — en supervision, on stocke en UTC et on laisse l’écran convertir. L’heure locale pose aussi un problème au changement d’heure d’automne : l’heure de 2 h à 3 h existe deux fois. Un script de correction de ce genre ne se lance qu’une fois : un second passage décalerait encore de 2 h.
H-47 · Sauvegarde des VM Windows : guest-fsfreeze-thaw failed - got timeout, agent figé
Symptôme — dans les journaux de la sauvegarde nocturne :
ERROR: VM 107 qga command 'guest-fsfreeze-thaw' failed - got timeout
pour AD-Core-01 les nuits du 22, 24, 25 et 26/10, et pour poste-win11 la nuit du 26/10. La sauvegarde réussit quand même. Le 24/10, l’arrêt de l’AD depuis Proxmox échoue : QEMU Guest Agent is not running - VM 107 qga command 'guest-ping' failed - got timeout, alors que le service QEMU-GA est « Running » dans Windows.
Contexte — avant une sauvegarde, Proxmox demande à l’agent invité de geler les écritures (sous Windows : un instantané VSS, qui met en pause les services comme la base de l’annuaire), lance la sauvegarde, puis demande le dégel. Agent 110.2.3 sur les deux VM (qm guest cmd <id> info) : version récente.
Constats — journal Application du poste, nuit du 26/10 : gel demandé à 02:00:01, instantané VSS lancé à 02:00:08, mesures du disque en échec jusqu’à 02:01:25, dégel reçu à 02:03:38 (3 min 30 de gel), puis une écriture de 4 Kio qui prend 36 s (événements ESENT 508 et 533). AD : gel à 02:07:22, dégel à 02:11:12. Grafana : toutes les VM Linux attendent leur disque (2 à 22 % d’iowait) pendant toute la durée de la sauvegarde, de 02:00 à 02:24, et pas avant (capture 100).
Cause — hypothèse étayée, non prouvée : la sauvegarde lit les disques sur le NAS pendant que Windows doit y écrire son instantané ; VSS met alors plusieurs minutes, et Proxmox cesse d’attendre le dégel. Il arrive que l’agent reste ensuite figé (24/10). Aucune autre sauvegarde ne tourne sur ce stockage à cette heure.
Résolution —
- agent figé (24/10) : dans la VM
Restart-Service QEMU-GA -Force, puis depuis l’hyperviseurqm guest cmd 107 ping(aucune sortie = l’agent répond), puis arrêt et démarrage depuis Proxmox ; - poste (27/10) : gel désactivé (Options → QEMU Guest Agent → Freeze/thaw guest filesystems on backup décoché) : un poste client n’a pas de base de données, une sauvegarde « cohérente après plantage » lui suffit ;
- AD : gel conservé, car c’est lui qui garantit une base d’annuaire propre dans la sauvegarde ; l’erreur ne fait pas échouer la sauvegarde. À surveiller.
À retenir — un service « Running » peut être figé : on le vérifie depuis l’hôte (
qm guest cmd <id> ping). Le gel VSS est lourd ; sur un stockage chargé, il dure des minutes.
H-48 · pfSense : unable to freeze guest fs … Resource deadlock avoided
Symptôme — journal de sauvegarde du 24/10 :
ERROR: unable to freeze guest fs - failed to freeze /: Resource deadlock avoided
Cause — l’agent invité de pfSense (système FreeBSD) ne sait pas geler le système de fichiers racine pendant qu’il est utilisé.
Résolution — VM 103 → Options → QEMU Guest Agent : Freeze/thaw guest filesystems on backup décoché. Journaux suivants : skipping guest-agent 'fs-freeze', disabled in VM options, plus d’erreur. La sauvegarde de pfSense est « cohérente après plantage », ce qui suffit pour un pare-feu (son historique de configuration complète, voir tâche 13.11).
À retenir — une option qui échoue à chaque fois sans rien apporter se désactive explicitement : l’erreur répétée masquerait une vraie panne.
H-49 · Grafana affiche « 0 série retournée » alors que la requête est juste
Symptôme — le 27/10, une requête SQL correcte (événements de l’AD regroupés par type) ne renvoie rien ; une requête de contrôle non plus.
Cause — la période choisie en haut à droite : l’éditeur était resté sur une plage fixe d’un exercice précédent. La macro $__timeFilter(recu_le) limite la requête à cette période.
Résolution — période « Depuis 24 heures » → 4 lignes (EventID 4624 : 8 192, 4634 : 7 932, 4672 : 6 479, 4648 : 1 236).
À retenir — devant « 0 série », on vérifie d’abord la période, ensuite la requête.
H-50 · Exporteur Proxmox : 500 Internal Server Error, 403 Forbidden: Permission check failed (/, Sys.Audit)
Symptôme — le 27/10, le service pve-exporter est active, mais curl "http://10.0.30.14:9221/pve?target=10.1.0.253&cluster=1&node=0"
renvoie une page 500 ; le journal (journalctl -u pve-exporter) montre proxmoxer.core.ResourceException: 403 Forbidden: Permission check failed (/, Sys.Audit), levée dans collector/cluster.py sur cluster.status.get().
Contexte — le compte metriques-axel@pve n’a que le rôle PVEAuditor sur /pool/SIO2527_Axel (hyperviseur partagé :
moindre privilège).
Cause — un 403 (et non un 401) prouve que le jeton est accepté : c’est un manque de droit. Cinq modules de
l’exporteur (status, node, cluster, qdevice, backup-info) lisent /cluster/status, l’état de tout
l’hyperviseur, qui exige Sys.Audit sur /. Un module en erreur fait échouer toute la page.
Résolution — plutôt que d’élargir les droits (on verrait alors les VM des autres élèves), couper ces modules :
--no-collector.status --no-collector.node --no-collector.cluster --no-collector.qdevice --no-collector.backup-info dans la
ligne ExecStart, puis daemon-reload et restart. Le module resources, qui ne lit que les VM autorisées, suffit
(mémoire, disques et processeur réglés et consommés). Code 200, 12 VM du pool visibles. La VM 137, hors du pool,
n’apparaissait pas : ajout du droit PVEAuditor sur /vms/137.
À retenir — 401 = « je ne te connais pas » (jeton faux) ; 403 = « je te connais, mais tu n’as pas le droit ». Face à un 403, on réduit ce qu’on demande avant d’élargir ce qu’on autorise.
H-51 · Les cases « par jour » de Grafana sont décalées d’un jour
Symptôme — le 27/10, dans le panneau de disponibilité jour par jour (Status history), la bulle de la case marquée
10/25 indique 2026-10-25 01:00:00 ; les pannes connues du 23/10 apparaissent sous la date du lendemain.
Cause — Prometheus calcule chaque point à minuit UTC et avg_over_time(probe_success[1d]) regarde les 24 h
précédentes : la case du 25/10 résume en réalité la journée du 24/10.
Résolution — avg_over_time(probe_success[1d] offset -1d) * 100 : le décalage négatif fait regarder les 24 h
suivantes, et chaque case correspond à sa propre journée (la dernière montre aujourd’hui). Même principe pour les
sauvegardes : max_over_time(pbs_snapshot_vm_last_timestamp[1d] offset -1d) >= bool time(). Vérifié sur srv-web-01 :
sauvegarde du 28/10 à 02:21 → case du 28/10.
À retenir — une fenêtre
[1d]regarde en arrière depuis l’instant du calcul ; pour un historique « par jour », on décale d’un jour en avant. Les journées sont découpées en UTC (à 1 h du matin, heure de Paris en hiver).
H-52 · Une courbe « Value » et des machines en double dans les panneaux
Symptôme — le 27/10, la légende du processeur montre une série nommée Value ; celle de la mémoire montre
srv-metriques deux fois.
Cause — des séries anciennes, enregistrées avant que les étiquettes soient complètes : localhost:9100 sans
étiquette host (Grafana l’appelle Value), et srv-metriques avant et après l’ajout de l’étiquette zone (deux
séries différentes pour Prometheus). Trouvées par count by (instance, job, zone) (count_over_time(…[30d])).
Résolution — filtre host!="" dans les requêtes, et regroupement max by (host) (…) : une seule série par machine.
À retenir — changer les étiquettes d’une cible crée une nouvelle série ; l’ancienne reste dans l’historique jusqu’à la fin de la rétention (30 jours).
H-53 · 26 000 puis 80 000 lignes de journaux par jour : les contrôles de santé et le bruit CARP
Symptôme — le 28/10, le bloc « volume de journaux » montre srv-supervision passé de ≈ 1 500 à ≈ 20 000 lignes par
jour à partir du 23/10, et fw-01 (pfSense) à ≈ 80 000 lignes par jour.
Diagnostic — regroupements SQL dans la base syslog :
| Machine | Programme | Lignes / 24 h | Détail |
|---|---|---|---|
srv-supervision | grafana | 25 824 | 17 227 : Request Completed method=GET path=/ status=302 remote_addr=10.0.30.12, toutes les 5 s ; 6 618 : Plugin Request Completed (niveau info) |
| pfSense | filterlog | 61 004 | 57 598 : protocole CARP vers 224.0.0.18, sur le WAN, bloqués par la règle par défaut (qui journalise) |
| pfSense | nginx | 17 211 | 10.0.30.12 "GET / HTTP/1.1" 200 … "Go-http-client" toutes les 5 s |
Cause — 10.0.30.12 est srv-docker, où tourne le connecteur Pangolin : ses contrôles de santé demandaient la
page d’accueil de Grafana et de pfSense toutes les 5 s (Grafana journalise les réponses qui ne sont pas des succès 2xx ;
nginx, le serveur web de l’interface de pfSense, journalise tout). Ils ont commencé quand les ressources ont été publiées
dans Pangolin, d’où le saut du 23/10. Les annonces CARP (haute disponibilité de pare-feux) viennent du réseau de
l’école : le lab n’utilise pas CARP.
Résolution —
| Correction | Effet mesuré |
|---|---|
Pangolin, ressource Grafana : contrôle de santé HTTP sur /api/health (réponse 200, non journalisée) | 0 ligne depuis 09:54 UTC |
GF_LOG_LEVEL=warn dans /etc/default/grafana-server, redémarrage | plus de lignes info depuis 10:01 UTC |
pfSense, onglet WAN, en tête : Block · protocole CARP · Log décoché · « Bruit CARP du réseau de l’école : bloqué sans journal » | 0 ligne CARP depuis 10:10 UTC |
| Pangolin, ressource pfSense : contrôle de santé en TCP (aucune page demandée) | 0 ligne nginx depuis 10:15 UTC |
À retenir — on ne coupe pas la journalisation du blocage par défaut (on deviendrait aveugle sur le WAN) : on fait taire le bruit identifié par une règle explicite. Et un contrôle de santé doit viser un point prévu pour ça (
/api/health) ou rester en TCP.
H-54 · Le compte Windows illisible dans le détail des refus : l’espace insécable
Symptôme — le 28/10, après le test du mauvais mot de passe sur poste-win11, la colonne Compte du détail contient
Compte pour lequel l'ouverture de session a échoué : … Nom du compte : admin, et la colonne Depuis contient
EventID.
Cause — Windows écrit « Nom du compte : » avec une espace insécable (octets C2 A0) avant les deux-points,
repérée par HEX(SUBSTRING(message, …)). Le découpage SUBSTRING_INDEX(…, 'Nom du compte : ', …), écrit avec une espace
ordinaire, ne trouvait jamais le séparateur et renvoyait tout le texte.
Résolution — lecture par expression régulière, indifférente au type d’espace :
REGEXP_REPLACE(REGEXP_SUBSTR(…, 'Nom du compte[^:]*:[^[:alnum:]]*[[:alnum:]._$-]+'), '^.*:[^[:alnum:]]*', ''), idem pour
Adresse du réseau source. Résultat : poste-win11 · admin · 127.0.0.1.
À retenir — un texte qui « ressemble » au motif peut contenir des caractères invisibles : on regarde ses octets.
H-55 · Tout le tableau de bord affiche « No data » d’un coup
Symptôme — le 28/10, les cases « maintenant » (état des services, machines en ligne, disques, noms des services) sont toutes à No data ; les courbes, elles, s’affichent et s’arrêtent à aujourd’hui.
Cause — un clic sur la loupe « − » (dézoomer) avait remplacé la période relative par une plage fixe
2026-09-13 … 2026-11-12, qui finit dans le futur. Les panneaux « maintenant » demandent la valeur à la fin de la
période : il n’y en a pas encore.
Résolution — période « Derniers 30 jours » (ou rouvrir le tableau, dont la période par défaut est désormais de 30 jours). Le verrouillage de la période a été écarté : il empêcherait de zoomer sur un incident.
À retenir — « tout est vide d’un coup » : regarder d’abord la période en haut à droite (voir aussi H-49).
H-56 · La recopie d’un disque se recopie dans elle-même (mnt/neuf/mnt/neuf/…)
Symptôme — 28/10, recopie du système de srv-docker vers un nouveau disque (étape 53.3). Le script tourne 25 minutes,
la VM ne s’éteint pas ; le journal se remplit de filename overflows max-path len by 2: mnt/neuf/mnt/neuf/mnt/neuf/…,
puis rsync error: some files/attrs were not transferred (code 23) et ECHEC ligne 7. Le disque système passe de
6,3 à 68,6 Gio utilisés.
Contexte — le nouveau disque avait été monté à la main sur /mnt/neuf ; la VM a redémarré ensuite (15:10)
avant le lancement du script.
Cause — un montage fait à la main ne survit pas à un redémarrage. /mnt/neuf n’était plus qu’un dossier vide
sur l’ancien disque : rsync -x (« reste sur le même système de fichiers ») l’a donc recopié avec le reste, puis la
copie dans la copie, jusqu’à des chemins trop longs. Le script ne vérifiait pas que la destination était bien montée.
Résolution — rien de cassé : le trap du script a relancé Docker et n’a pas éteint la VM.
findmnt /mnt/neuf (vide = rien de monté), puis sudo rm -rf --one-file-system /mnt/neuf → 6,3 Gio de nouveau ;
remontage par l’étiquette (mount LABEL=racine /mnt/neuf, le nom sdb pouvant changer) ; ajout au script de
mountpoint -q /mnt/neuf avant toute copie, et de --exclude=/mnt/neuf à rsync ; systemctl reset-failed migrer-disque puis relance : TERMINE OK en quelques minutes.
À retenir — avant de copier vers un disque, vérifier qu’il est monté (
findmnt,mountpoint -q) : sinon on copie dans un simple dossier du disque source. Un script qui s’arrête proprement sur erreur (set -e+trap) transforme ce genre d’erreur en simple contretemps.
H-57 · Le test d’alerte ne déclenche rien : docker: not found
Symptôme — 29/10, test de la règle « Service injoignable » : 10 minutes après la commande d’arrêt de Termix, aucun
mail ; dans Prometheus, la sonde Termix reste à 1 (réponse 200) chaque minute. Le journal de la tâche dit
/bin/sh: 1: docker: not found, puis status=127.
Contexte — plusieurs onglets Termix ouverts (srv-supervision, srv-docker).
Cause — la commande a été lancée sur srv-supervision (invite ipfixe@srv-supervision), où Docker n’est pas
installé, au lieu de srv-docker. Rien n’a été arrêté : la règle n’avait aucune panne à signaler.
Résolution — sudo systemctl reset-failed test-alerte-termix sur srv-supervision, puis la même commande sur
srv-docker : mail [FIRING] à 13:58:11, [RESOLVED] à 14:03:11.
À retenir — lire l’invite (
utilisateur@machine) avant de valider une commande, surtout avec plusieurs onglets ouverts. Et quand une alerte ne vient pas, vérifier d’abord que la panne a vraiment eu lieu (la mesure dans Prometheus) avant de soupçonner l’alerte.
H-58 · Une alerte d’avertissement se déclenche, mais aucun mail n’arrive
Symptôme — 29/10, test de la règle « Disque presque plein » (seuil abaissé à 5 %) : l’historique montre Pending à 16:42:20 puis Alerting à 16:57:20, mais aucun mail [FIRING] ni [RESOLVED].
Contexte — le script de test remettait le seuil normal (85 %) dès le passage en Alerting ; la règle est revenue à Normal à 16:58:00.
Cause — le chemin severite = avertissement attend 5 minutes (group wait) avant le premier mail, pour
regrouper les alertes. L’alerte a disparu avant la fin de cette attente : au moment d’envoyer, il n’y avait plus
rien d’actif, donc rien à signaler. C’est le comportement voulu du regroupement : un pic passager ne dérange
personne.
Résolution — garder le seuil de test au moins group wait + 1 min (6 min) après le déclenchement : mail [FIRING:13] à 17:25:27, [RESOLVED] à 17:55:26.
À retenir — une alerte plus courte que l’attente de groupe ne produit aucun mail. Pour une alerte critique (attente de 10 s), le cas est rare ; pour un avertissement (5 min), c’est un filtre anti-bruit. Un test d’alerte doit durer plus longtemps que cette attente.
H-59 · « disque /[no value] » dans le mail d’alerte
Symptôme — le résumé du mail « Disque presque plein » affiche srv-web-01 : disque /[no value] rempli à 24 %.
Cause — le modèle collait deux étiquettes, {{ $labels.mountpoint }}{{ $labels.volume }} : la première n’existe
que pour Linux et pfSense, la seconde que pour Windows. Une étiquette absente est écrite « [no value] ».
Résolution — n’afficher une étiquette que si elle existe :
{{ with $labels.mountpoint }}{{ . }}{{ end }}{{ with $labels.volume }}{{ . }}{{ end }} → disque / rempli à 24 %,
disque C: rempli à 21 %. Le mail [RESOLVED] d’une alerte déjà partie garde l’ancien texte, figé au déclenchement.
À retenir — dans un message d’alerte qui couvre des systèmes différents, entourer chaque étiquette facultative d’un
{{ with … }}.
H-60 · Le poste d’administration perd par moments l’accès aux réseaux du lab
Symptôme — 29/10, vers 15:40, entre 17:05 et 17:35, puis vers 18:54 : depuis le PC d’Axel, 10.0.30.14,
10.0.30.15 et même 10.0.30.1 ne répondent plus (WinError 10060, puis 10053 connexion abandonnée) ; la liste
tailscale status du PC ne montre plus pfSense. Pendant ce temps, Grafana répond normalement par Pangolin
(/api/health : database: ok) : le lab tourne.
Contexte — le PC passe d’un réseau à l’autre (adresse 10.2.0.115 à ce moment-là) ; l’accès aux VLAN du lab passe
par Tailscale et pfSense.
Cause — À COMPLÉTER : non diagnostiquée. Constaté seulement : la reconnexion de Tailscale sur le PC (par Axel)
rétablit l’accès.
Effets — le relevé de l’historique d’une règle a dû être différé ; un test (mémoire) n’a pas pu abaisser son seuil au lancement et ne s’est pas déroulé. Les scripts d’administration réessaient désormais 6 fois à 20 s d’intervalle.
À retenir — quand « tout le lab » semble tomber depuis un seul poste, tester le lab par un autre chemin (ici Pangolin) avant de conclure : c’était l’accès, pas le lab.
H-61 · Toutes les VM ralentissent en même temps : le NAS de l’école sature
Symptôme — 30/10, à partir de 09:30 : latence disque de toutes les VM du lab de ~1 ms à 300 ms - 2,5 s (tableau de
production, bloc « disques ») ; commandes SSH lentes ; l’arrêt propre de srv-web-02 prend ≈ 3 min. Sur pve-01,
le graphique IO Pressure Stall est à 30 - 60 % (Some) et presque autant en Full : l’hyperviseur passe un tiers
à plus de la moitié de son temps à attendre son stockage.
Contexte — tous les disques des VM sont des fichiers qcow2 sur le NAS de l’école (Syno, NFS, 10.1.0.252), partagé.
Diagnostic (lecture seule, sur pve-01) :
| Mesure | Résultat | Lecture |
|---|---|---|
| Écritures des VM du lab (compteurs Proxmox) | < 0,1 Mo/s chacune de 09:30 à 10:30 | le lab n’écrit presque rien |
Débit de toutes les VM de l’hyperviseur (deux relevés pvesh get /cluster/resources à 60 s) | ≈ 5 Mo/s écrits, 10 Mo/s lus au total | charge très faible |
nfsiostat 5 2 /mnt/pve/NAS-01 (écritures) | temps de réponse du NAS 152 ms (4,7 ms en moyenne depuis le montage), exécution 471 ms, file 318 ms | le NAS répond 30 fois plus lentement |
zpool iostat -l storage 5 2 (pool local) | 43 ms, très peu d’activité | le stockage local n’est pas en cause |
Deux pare-feux d’autres élèves avaient écrit ≈ 200 Gio depuis leur démarrage, mais n’écrivaient que 0,2 Mo/s au moment du diagnostic : hypothèse écartée.
Cause — le NAS de l’école répond lentement alors qu’on lui demande peu : il est occupé ailleurs (autres serveurs,
tâche interne). Cause exacte À COMPLÉTER : non visible depuis le lab, à signaler au formateur avec ces chiffres.
Résolution — aucune action possible dans le lab (le NAS n’est pas à nous). Les tests d’alertes du matin ont tourné pendant l’incident : les alertes ne changent rien au disque (seuls des seuils changent dans Grafana).
À retenir — quand toutes les VM ralentissent en même temps et qu’aucune n’écrit beaucoup, le goulot est sous les VM (stockage, hyperviseur) : mesurer le temps de réponse du stockage (
nfsiostat,zpool iostat -l) et la pression d’entrées-sorties de l’hôte (IO Pressure Stall), pas seulement le débit.
H-62 · Prometheus tombe : trois mails accusent à tort les services et les machines
Symptôme — 30/10, test de panne : Prometheus arrêté 5 min sur srv-metriques. Reçus : [FIRING:6] Service
injoignable (10:55:12), [FIRING:1] Galera incomplet (10:55:16), [FIRING:13] Machine injoignable (10:57:15).
Aucun service, aucune machine n’était en panne.
Cause — toutes les règles avaient l’état d’erreur = Alerting (« par prudence »). Quand Grafana ne peut plus interroger Prometheus, chaque règle passe en alerte, et chaque mail donne un faux diagnostic.
Résolution — une règle dédiée « Supervision aveugle (Prometheus) » (vector(1), état d’erreur = Alerting,
attente 2 min) ; état d’erreur = OK pour les 9 autres (l’absence de données reste une alerte). Deuxième essai à
11:06 : un seul mail, [FIRING:1] Supervision aveugle à 11:09:12, [RESOLVED] à 11:14:12 ; la règle « Machine
injoignable » est passée en Normal (Error), silencieuse.
À retenir — une panne de la supervision doit produire une alerte qui dit « je suis aveugle », pas une avalanche de fausses pannes. Séparer l’erreur (la source ne répond plus) de l’absence de données (la mesure a disparu).
H-63 · Le fichier de connexion de la purge créé sur le nœud Galera au lieu de srv-supervision
Symptôme — mise en place de la purge des journaux (étape 56) : la sortie collée après la création de
/etc/purge-journaux.cnf montre l’invite ipfixe@srv-mysql-01.
Contexte — plusieurs onglets Termix ouverts : srv-mysql-01 (pour créer le compte purge_journaux) et
srv-supervision (où tourne le script).
Cause — la commande a été lancée dans l’onglet du nœud Galera. Le fichier, qui contient le mot de passe du compte
de purge, se trouvait sur une machine qui n’en a pas besoin, et le script de srv-supervision n’avait pas de quoi se
connecter. Rechute de H-57.
Résolution — fichier supprimé sur srv-mysql-01, recréé sur srv-supervision (600 root), puis tests de l’étape 56.
À retenir — lire l’invite avant chaque commande, et plus encore avant d’écrire un secret : un fichier de mot de passe oublié sur la mauvaise machine est une fuite, même dans le lab.
H-64 · pve-01 refuse la clé SSH d’Axel : elle a disparu du fichier des clés autorisées
Symptôme — 01/11, pendant le partage Termix au formateur (étape 57) : la connexion par clé à root@pve-01
est refusée, alors qu’elle fonctionnait auparavant.
Contexte — pve-01 est l’hyperviseur partagé de l’école. Sur Proxmox, /etc/pve/priv/authorized_keys est
commun à tout le cluster de l’école.
Cause — la clé d’Axel n’est plus dans ce fichier : il a été réécrit le 15/10 à 11:05 (date du fichier), sans elle.
Qui ou quoi l’a réécrit : À COMPLÉTER (rien n’indique une action du lab).
Résolution — Axel a choisi de redéposer sa clé lui-même, après une copie du fichier
(/root/authorized_keys.avant-2026-11-01) ; connexion de nouveau acceptée.
À retenir — sur une machine partagée, un accès peut disparaître sans qu’on y touche. Avant de modifier un fichier commun, en garder une copie, et ne rien ajouter d’autre que sa propre clé.
H-65 · Le formateur ouvre un hôte partagé dans Termix : « no password provided »
Symptôme — 01/11 : les hôtes partagés apparaissent dans le compte Termix du formateur, mais leur ouverture échoue
avec no password provided.
Cause — ces hôtes avaient leur authentification saisie dans l’hôte lui-même. Un partage au niveau Connect ne transmet que les identifiants enregistrés (rubrique des identifiants de Termix) associés à l’hôte.
Résolution — hôtes passés sur des identifiants enregistrés ; le formateur ouvre les sessions, sans voir les secrets.
À retenir — un partage ne transmet que ce qui est prévu pour être partagé ; tester le partage depuis le compte qui le reçoit, pas depuis le sien.
H-66 · Galera perd le quorum : une seule alerte, « Supervision aveugle (Prometheus) », qui accuse le mauvais coupable
Symptôme — 02/11, test 7.11 (2 nœuds Galera sur 3 débranchés de 13:24:56 à 13:28:08) : le site répond 503, mais
la seule alerte reçue est [FIRING:1] Supervision aveugle (Prometheus) (13:27:12), dont le résumé dit « Prometheus
ne répond plus ». Prometheus fonctionnait. Ni « Galera incomplet », ni « Service injoignable ». L’API de Grafana
répond 401 pendant la panne.
Cause — la base de Grafana est dans le cluster Galera (étape 50). Sans quorum, Grafana ne peut plus lire sa
propre configuration (sources de données, jetons) : toutes les règles passent en erreur. Comme l’erreur est réglée
sur OK pour toutes les règles sauf « Supervision aveugle » (correction de H-62), seule celle-ci alerte. Son vrai
motif n’apparaît que dans le détail du mail : failed to build query 'A': Error 1047 (08S01): WSREP has not yet prepared node for application use.
Résolution — aucune modification pendant le test : le mail est bien parti, et tout est revenu seul au rebranchement. Ensuite (décision d’Axel) : la base reste dans Galera (exigence du projet), le risque est accepté (dette T-16), et la règle est renommée « Supervision aveugle (Grafana ne calcule plus les alertes) », avec une description qui cite les deux causes possibles et dit quoi vérifier pour chacune (étape 58.4).
À retenir — une supervision ne doit pas dépendre de ce qu’elle surveille. Si elle en dépend, il faut au moins que son alerte « je suis aveugle » dise pourquoi. Et lire le champ Error d’un mail d’alerte avant de conclure.
H-67 · Les courbes de mémoire de srv-mysql-01 et poste-win11 font des pics de 40 à 90 % : le ballooning de Proxmox
Symptôme — 02/11, tableau de production, panneau « Mémoire dans le temps » : srv-mysql-01 et poste-win11 font
des allers-retours rapides entre 40 et 90 % d’utilisation, en blocs de plusieurs dizaines de minutes (dans la nuit
vers 23:40 et 03:40, puis de 11:50 à 13:20). Les autres machines sont plates. Question : latence des disques, ou vraie
activité ?
Diagnostic (mesures Prometheus sur 6 h, et lecture seule sur pve-01) :
Mesure sur srv-mysql-01 | Ballon gonflé (120 min) | Normal (241 min) |
|---|---|---|
mémoire totale vue par la VM (MemTotal) | descend jusqu’à 0,93 Gio | 1,93 Gio |
mémoire prise par les programmes (AnonPages) | 0,54 Gio | 0,57 Gio |
| écritures disque | 0,01 Mo/s | 0,01 Mo/s |
| processeur (moyenne) | 1,8 % | 1,2 % |
| échange avec le swap (moyenne / pointe) | 3,2 / 171 pages/s | 0,03 / 1,8 pages/s |
| latence d’écriture (moyenne / pointe) | 18 / 941 ms | 2,7 / 72 ms |
Ce n’est pas une activité : les programmes et les écritures ne bougent pas. C’est la mémoire totale de la VM qui
rétrécit de moitié. Sur pve-01 : srv-mysql-01 a memory 2048, balloon 1024, poste-win11 memory 4096, balloon 2048, et l’hyperviseur partagé est à 50 Gio utilisés sur 62 (81 %). Les deux VM sont touchées en même temps :
sur les 120 minutes de ballon gonflé de srv-mysql-01, poste-win11 avait moins de 1 Gio libre pendant 91 minutes
(4 minutes seulement en dehors).
Cause — le ballooning : quand l’hôte dépasse environ 80 % de sa RAM, Proxmox « gonfle » un pilote dans chaque
VM qui a un minimum (balloon) inférieur à son maximum, pour reprendre de la mémoire et la donner à d’autres VM. Sous
Linux, la mémoire totale vue par la VM diminue ; sous Windows, la mémoire prise par le ballon apparaît comme
utilisée. Le pourcentage du tableau grimpe donc sans que rien ne travaille plus. La charge vient des autres VM
de l’hyperviseur de l’école, pas du lab.
Conséquence réelle — quand la VM est réduite à 0,93 Gio, srv-mysql-01 commence à utiliser son swap, et la latence
d’écriture monte (pointe à 941 ms). La latence des disques est donc une conséquence du ballon, pas sa cause.
Résolution — décision d’Axel, appliquée par lui le 02/11 dans Proxmox (Hardware → Memory) :
| VM | Avant (max / min) | Après (max / min) | Vérifié sur pve-01 |
|---|---|---|---|
srv-mysql-01, 02, 03 (106, 129, 131) | 2048 / 1024 Mio | 2048 / 2048 : plus de ballon automatique | ligne balloon retirée de la configuration (valeur par défaut = le maximum) ; cible et mémoire actuelle 2,0 Gio |
poste-win11 (101) | 4096 / 2048 Mio | 4096 / 3072 : Proxmox peut encore reprendre 1 Gio au plus | balloon: 3072 ; actuelle 3,99 Gio |
Appliqué à chaud, sans redémarrage (aucun changement en attente). Les nœuds de base ne seront plus réduits à 0,93 Gio
(donc plus de swap ni de latence qui en découle) ; en contrepartie, ces 3 Gio sont réservés sur un hôte partagé déjà à
81 %. À vérifier sur 24 h : courbes plates pour les nœuds Galera, creux limités à 1 Gio pour poste-win11.
Suite du 09/11 (poste-win11) — Axel signale le poste « qui prend toute sa mémoire ». Relevé : 546 Mio libres sur
4 Gio, mais les programmes n’en prennent que 1,6 Gio (le plus gros : Defender, 287 Mio) et la mémoire interne de
Windows 0,6 Gio ; le reste, 1 Gio, est le ballon (cible ramenée à 3 Gio par Proxmox), avec pve-01 à 85 %
(54,6 Gio sur 62,7). Le réglage du 02/11 a donc tenu (creux limité à 1 Gio) mais la courbe reste trompeuse. Décision
d’Axel : minimum porté à 4096 (balloon retiré de la configuration, plus de ballon automatique). Le changement
de configuration ne dégonfle pas un ballon déjà gonflé : cible remise à 4 Gio à chaud par qm monitor 101 →
balloon 4096 (Claude). Vérifié 20 s après : balloon: 4294967296, mémoire utilisée 2,3 Gio, libre 1,6 Gio. Les
4 Gio du poste sont désormais réservés sur l’hôte partagé.
À retenir — avant d’accuser une application d’un pic de mémoire, regarder si c’est le numérateur (ce qui est utilisé) ou le dénominateur (la mémoire totale) qui a bougé. Sur une VM, la mémoire totale n’est pas une constante.
H-68 · Installeur Ubuntu : le « masque de sous-réseau » attend le réseau, et LVM ne prend que la moitié du disque
Symptôme — 02/11, installation d’Ubuntu Server (future srv-wazuh) : le champ « Masque de sous-réseau » refuse
255.255.255.0 et 10.0.30.16/24 (« has host bits set »). Une fois installée, df -h / donne 31 Go à la racine
alors que le disque fait 64 Go.
Contexte — premier Ubuntu du lab (toutes les autres machines Linux sont des Debian, dont l’installeur demande bien un masque) ; partitionnement « guidé, LVM » par défaut.
Cause — deux habitudes de l’installeur Ubuntu (Subiquity) : (1) le champ libellé « masque » attend en réalité
l’adresse du réseau en notation CIDR (10.0.30.0/24), et l’adresse de la machine va dans le champ suivant ; (2)
l’option LVM crée le groupe de volumes sur tout le disque mais ne donne à la racine que la moitié de l’espace,
pour laisser de la place à d’autres volumes.
Résolution — (1) 10.0.30.0/24 dans « masque », 10.0.30.16 dans « adresse » ; (2) après installation, donner le
reste du groupe à la racine : sudo lvextend -l +100%FREE /dev/ubuntu-vg/ubuntu-lv && sudo resize2fs /dev/mapper/ubuntu--vg-ubuntu--lv → racine à 61 Go (03/11). Pas à pas : MO-18 §4.0.
À retenir — un libellé n’est pas une spécification : lire le message d’erreur (« host bits set » dit tout). Et vérifier
df -h /juste après toute installation, avant d’y poser un service qui a besoin de place.
H-69 · L’agent QEMU est installé, mais Proxmox n’affiche aucune adresse et le service reste inactif
Symptôme — 03/11, srv-wazuh : qemu-guest-agent installé par apt, mais systemctl status qemu-guest-agent
reste inactif (A dependency job for qemu-guest-agent.service failed), et Proxmox n’affiche pas l’adresse de la VM
dans Summary. Un reboot ne change rien.
Contexte — VM 113 créée par Axel ; l’option QEMU Guest Agent n’avait pas été cochée à la création.
Cause — l’agent dialogue avec l’hyperviseur par un périphérique virtuel (canal virtio-serial) que Proxmox n’ajoute à la VM que si l’option est cochée dans Options → QEMU Guest Agent. Sans ce périphérique, le service n’a rien à quoi se connecter. Et un redémarrage depuis l’intérieur de la VM ne recrée pas sa configuration matérielle : seul un arrêt puis un démarrage par Proxmox applique l’ajout du périphérique.
Résolution — option cochée dans Proxmox, puis Shutdown et Start (pas Reboot) : service actif, adresse vue par Proxmox. Prérequis 7 du MO-18 complété.
À retenir — tout changement de matériel virtuel (carte, canal, disque) demande un arrêt/démarrage par l’hyperviseur ; un reboot du système invité ne suffit pas. Même règle que la carte réseau d’une VM clonée (MO-1).
H-70 · La règle VISITEURS « Agent Wazuh » ne laisse rien passer : sa source était USERS subnets
Symptôme — 03/11, depuis poste-visiteur : nc -zv 10.0.30.16 1514 → Connection refused immédiat, alors que
la règle « Agent Wazuh du poste-visiteur » est en tête de l’onglet VISITEURS et que la même règle marche depuis
poste-win11.
Contexte — règle créée par duplication de celle de l’onglet USERS, pour aller vite.
Cause — la source dupliquée était restée USERS subnets. Un paquet venant de 10.0.50.200 n’appartient pas à
ce réseau : la règle ne correspond pas, le paquet descend jusqu’au rejet de la zone (RESEAUX_PRIVES), qui
répond immédiatement : d’où le refus instantané, et non une attente qui expire. C’est la règle morte de B-05,
sous une autre forme.
Résolution — source remplacée par 10.0.50.200 (le poste de test seul : les appareils des invités n’auront
jamais d’agent, décision d’Axel) ; nc -zv → open sur 1514 et 1515. Avant / après : captures 152a et 152.
À retenir — un refus immédiat veut dire « une règle de rejet a répondu », donc « aucune règle d’autorisation au-dessus n’a correspondu » : vérifier la source avant tout. Et après une duplication, relire chaque champ, pas seulement celui qu’on voulait changer.
H-71 · grep -A3 fait croire que <use_password> manque dans ossec.conf
Symptôme — 03/11, après avoir activé le mot de passe d’inscription des agents : sudo grep -A3 '<auth>' /var/ossec/etc/ossec.conf n’affiche pas la ligne use_password. Conclusion hâtive : l’option n’a pas été écrite.
Contexte — vérification d’une modification faite par sed dans un bloc XML de plusieurs lignes.
Cause — le bloc <auth> compte plus de trois lignes avant use_password (disabled, port, use_source_ip…) :
-A3 s’arrête trop tôt. L’option était bien à yes ; le journal du manager le confirmait déjà (« Using password
specified on file »).
Résolution — lire le bloc entier : sudo sed -n '/<auth>/,/<\/auth>/p' /var/ossec/etc/ossec.conf, ou chercher
directement la ligne : grep use_password. Aucune modification de la configuration.
À retenir — un outil de vérification tronqué produit un faux négatif aussi sûrement qu’une vraie panne. Quand on vérifie un bloc, on affiche le bloc, pas un nombre de lignes deviné.
H-72 · Le script d’installation de l’agent Wazuh annonce un échec alors que l’agent est inscrit
Symptôme — 03/11, premier lancement d’installer-wazuh-agent.sh sur srv-ha : « ATTENTION : agent pas connecté »,
code de retour 1. Pourtant, ossec.log contient « Valid key received » et, côté serveur, agent_control -l affiche
srv-ha … Active quelques secondes plus tard.
Contexte — première version du script, qui vérifiait la connexion 10 s après le démarrage du service.
Cause — l’enrôlement (port 1515), puis la première connexion (port 1514) et l’échange de clés prennent plus de 10 s. Le script regardait trop tôt, et regardait le mauvais indicateur (la présence du service, pas son état).
Résolution — le script lit maintenant l’état officiel de l’agent, /var/ossec/var/run/wazuh-agentd.state
(ligne status='connected'), en réessayant toutes les 2 s jusqu’à 60 s ; même logique dans le script Windows
(wazuh-agent.state). Relancé : OK : agent srv-ha connecte a 10.0.30.16.
À retenir — la même leçon que H-33 (port 9100) : « le service tourne » et « le service est prêt » sont deux états différents. Un script de vérification attend l’état que le logiciel publie lui-même, avec une limite de temps, plutôt qu’un délai fixe deviné.
H-73 · PowerShell : l’empreinte .sha512 de l’agent Wazuh arrive en binaire, Trim impossible
Symptôme — 03/11, installer-wazuh-agent.ps1 sur poste-win11 : [System.Byte] ne contient pas de méthode nommée « Trim » à la lecture du fichier d’empreinte, avant même la vérification du MSI.
Contexte — le script téléchargeait le fichier .sha512 avec Invoke-WebRequest et lisait directement sa propriété
.Content.
Cause — le serveur de Wazuh sert ce fichier avec un type de contenu binaire (pas text/…) : PowerShell range
alors .Content dans un tableau d’octets, pas dans une chaîne. Trim() n’existe pas sur un tableau d’octets.
Résolution — le script enregistre d’abord le fichier (-OutFile), puis le lit comme du texte avec
Get-Content -Raw, prend le premier mot (l’empreinte), compare à Get-FileHash -Algorithm SHA512 du MSI, et efface le
fichier. Relancé : EMPREINTE CONFORME, agent installé et connected.
À retenir — ne jamais supposer le type de ce qu’un serveur renvoie : écrire dans un fichier, puis le lire avec l’outil adapté au contenu. Et la vérification d’empreinte reste obligatoire avant d’exécuter un installeur téléchargé (même règle que H-36).
H-74 · net user … /add ne rend pas la main : la question « plus de 14 caractères »
Symptôme — 03/11, test B (compte créé en douce) sur poste-win11, lancé par l’agent QEMU : net user testwazuh <mot de passe> /add ne se termine pas ; aucun compte créé, aucune alerte.
Contexte — mot de passe de test généré aléatoirement, long.
Cause — quand le mot de passe dépasse 14 caractères, net user pose une question (compatibilité avec les anciens
Windows) et attend une réponse au clavier. Lancée sans terminal interactif, la commande reste suspendue.
Résolution — mot de passe de test de 14 caractères au plus (ou option /y qui répond d’avance). Le compte est
créé, puis supprimé aussitôt (net user testwazuh /delete) : les deux alertes attendues (60109, 60111) arrivent.
À retenir — une commande qui « ne fait rien » sans message a peut-être posé une question que personne ne voit. Pour un test automatisé, utiliser les options qui répondent d’avance, et relire la sortie de la commande, pas seulement son résultat attendu.
H-75 · Le site de test des IDS, testmynids.org, a expiré
Symptôme — 03/11, premier test de Suricata : curl http://testmynids.org/uid/index.html ne renvoie plus la phrase
uid=0(root) attendue mais une page « domaine à vendre ». Aucune alerte, alors que la règle 2100498 est bien chargée.
Contexte — ce site, cité par la documentation de Suricata et par de nombreux tutoriels, renvoyait une réponse contenant exactement ce que la règle cherche.
Cause — le nom de domaine a expiré et a été racheté : la page ne contient plus le motif. Le test ne prouvait donc rien, ni dans un sens ni dans l’autre.
Résolution — envoyer soi-même le motif à un service d’écho (qui renvoie ce qu’il reçoit) :
curl -s http://httpbin.org/anything --data "uid=0(root) gid=0(root) groups=0(root)" ; le motif passe dans le flux
(à l’aller et au retour) et Suricata le voit : 3 alertes en 2 s. Même test en PowerShell depuis poste-win11.
À retenir — avant de conclure « la sonde ne détecte pas », vérifier que le stimulus est bien arrivé (ici : lire la réponse HTTP). Une ressource externe citée dans une documentation n’est pas éternelle ; un test qu’on maîtrise de bout en bout vaut mieux.
H-76 · Test Suricata sur USERS sans alerte : lancé avant la fin du chargement des règles
Symptôme — 03/11, 16:15:36 : test lancé depuis poste-win11 juste après le démarrage de l’instance USERS, aucune
alerte. Le même test à 16:16:07 produit 2 alertes en 2 s.
Contexte — instance USERS créée par duplication, démarrée par l’interface pfSense (icône verte aussitôt).
Cause — le moteur charge 22 996 règles avant d’inspecter le moindre paquet : ≈ 50 s sur ce pfSense
(suricata.log : règles chargées à 16:15:26, Engine started. à 16:15:58). L’icône de l’interface passe au vert
avant la fin du chargement.
Résolution — attendre la ligne Engine started. dans Logs View → suricata.log avant de tester. Aucun réglage
changé. Les « 4 rules failed » du même journal sont des règles ja3 (empreinte TLS non activée dans cette version),
sans effet sur le reste.
À retenir — « démarré » (le processus existe) n’est pas « prêt » (il inspecte). Avant un test, lire le journal du service, pas l’icône. Même famille que H-33 et H-72.
H-77 · Une création de compte détectée par Wazuh n’envoie qu’un mail [RESOLVED], jamais [FIRING]
Symptôme — 03/11, test des créations de comptes (règles Wazuh 60109 sous Windows, 5902 sous Linux), comptes créés à
18:24-18:25 sur poste-win11 puis srv-ha : mail [FIRING:1, RESOLVED:1] à 18:26:16 pour poste-win11, mais pour
srv-ha seulement un [RESOLVED] à 18:31:16. La règle Grafana « Intrusion détectée (Wazuh) » était pourtant passée en
Alerting pour srv-ha à 18:27:00.
Cause — les deux alertes appartiennent au même groupe de notification. La première part aussitôt (attente de groupe
10 s) ; la suivante attend le prochain envoi groupé, 5 minutes plus tard (group interval du chemin critique). Or la
requête de la règle ne regardait que les 5 dernières minutes de journaux : à 18:31, l’événement de 18:25 en était sorti,
l’alerte était déjà « résolue » (absence de données = normal). Même famille que H-58 : une alerte plus courte que
l’attente de groupe ne produit pas de [FIRING].
Résolution — fenêtre de la requête portée à 15 minutes (plus longue que l’envoi groupé de 5 minutes) ; description
corrigée (« niveau 10 ou plus, ou création de compte »). Vérifié : [FIRING:3] à 18:33:15 avec poste-win11 (60109),
srv-ha (5902) et srv-ha (5712) (capture 168).
À retenir — pour une alerte bâtie sur des événements (et non sur un état qui dure), la fenêtre de la requête doit être plus longue que l’intervalle d’envoi groupé, sinon l’alerte peut se terminer avant que son mail ne parte.
H-78 · « Send Alerts to System Log » coché, mais aucune alerte Suricata n’arrive dans les journaux
Symptôme — 03/11, tâche 16.9 : option cochée et enregistrée sur VISITEURS ; un test à 18:43:54 produit bien l’alerte
dans alerts.log de Suricata, mais rien dans /var/log/system.log de pfSense ni dans la base des journaux.
Cause — les processus Suricata tournaient depuis 16:02 et 16:15 (ps -axo lstart,command) : l’option n’est
prise en compte qu’au redémarrage de l’interface. Rien à voir avec l’envoi distant : /var/etc/syslog.d/pfSense.conf
envoie déjà tout (*.* @10.0.30.15:514).
Résolution — redémarrage des deux interfaces (bouton ⟳), puis attente de Engine started (≈ 50 s, H-76 : le premier
test relancé 20 s après le redémarrage n’a encore rien donné). Test à 18:49:15 : ligne suricata dans le journal de
pfSense et dans la base.
À retenir — après un changement de réglage d’une interface Suricata : redémarrer, attendre
Engine started, puis tester. Vérifier l’heure de démarrage du processus avant de soupçonner autre chose.
H-79 · Wazuh reçoit les alertes de Suricata mais n’en fait rien : « No decoder matched »
Symptôme — wazuh-logtest sur une ligne réelle de pfSense
(suricata[18722]: [1:2100498:7] GPL ATTACK_RESPONSE id check returned root [Classification: …] [Priority: 2] {TCP} …) :
Phase 2 : No decoder matched ; Phase 3 : règle 1002, niveau 2, « Unknown problem somewhere in the system ».
Cause — Wazuh décode les alertes de Suricata au format JSON (EVE), pas au format court « fast ». Or le JSON ne peut pas passer par le journal de pfSense, qui coupe les messages à 480 octets.
Résolution — un décodeur local suricata-fast (expression PCRE2 qui extrait signature, classification, priorité,
protocole, adresses et ports) et deux règles locales (100200 niveau 6, 100201 niveau 10 pour les priorités 1 et 2),
ajoutés après copie des fichiers ; testés avec wazuh-logtest avant tout redémarrage : règle 100201, niveau 10,
tous les champs extraits.
À retenir —
wazuh-logtestmontre en trois phases ce que Wazuh fait d’une ligne (pré-décodage, décodeur, règle) : c’est l’outil pour écrire et valider un décodeur sans toucher au service.
H-80 · Règle de silence Wazuh sans effet sur le compte Système : le « è » fait deux octets
Symptôme — Après l’ajout des règles de niveau 0 (04/11), les ouvertures de session du compte Système (type 5)
continuaient d’arriver en règle 60106, alors que les règles des comptes machine et sshd_ marchaient.
Contexte — Filtre du bruit des alertes Windows (Documentation 59.7, MO-19 §11.2). Règle 100213 écrite avec
l’expression ^(Syst.me|SYSTEM)$, pour accepter le nom français et le nom anglais.
Cause — Le journal est en UTF-8 : le « è » y occupe deux octets, et l’expression de la règle les compte comme
deux caractères. . n’en prend qu’un, donc Syst.me ne correspond pas à Système (relu comme du Latin-1, le nom
apparaît d’ailleurs Système : on voit les deux octets).
Résolution — ^(Syst.{1,2}me|SYSTEM)$ (un ou deux octets), corrigé dans local_rules.xml et dans
scripts/securite/bruit-windows-local_rules.xml, wazuh-analysisd -t puis redémarrage ; plus aucune alerte
Système type 5 dans la mesure suivante.
À retenir — Dans une expression régulière, un caractère accentué n’est pas forcément « un caractère » : mesurer après coup (ou tester sur une vraie ligne avec
wazuh-logtest) avant de conclure qu’une règle marche.
H-81 · La tâche planifiée de Defender disparaît après ScanScheduleDay 8
Symptôme — Sur poste-win11 et AD-Core-01, après Set-MpPreference -ScanScheduleDay 8, la commande
Get-ScheduledTask -TaskName 'Windows Defender Scheduled Scan' répond « Aucun objet MSFT_ScheduledTask correspondant
n’a été trouvé ».
Contexte — Espacer l’analyse de Defender à une fois tous les 15 jours (Documentation 49.1, 04/11). Premier essai : changer le déclencheur de la tâche de Defender (toutes les 2 semaines), et régler Defender sur « jamais » pour qu’il ne lance plus sa propre analyse quotidienne.
Cause — Cette tâche appartient à Defender : il la crée et la supprime lui-même selon ScanScheduleDay. La
valeur 8 (« jamais ») la supprime, avec le déclencheur modifié. Defender ne connaît que « tous les jours » ou « un jour
de la semaine » : pas « toutes les deux semaines ».
Résolution — une tâche à nous, \Lab\Analyse rapide Defender (15 jours) : MpCmdRun.exe -Scan -ScanType 1,
déclencheur hebdomadaire avec -WeeksInterval 2, samedi 04:00, compte SYSTEM ; vérifiée sur les deux VM (prochaine
exécution 07/11 04:00) ; protection en temps réel toujours active.
À retenir — Ne pas modifier une tâche planifiée qu’un logiciel gère lui-même : il l’écrase ou la supprime. Régler le logiciel, ou créer sa propre tâche dans un dossier à soi (
\Lab\).
H-82 · Le ping du poste « marche » avant même la GPO : trois règles locales d’écho
Symptôme — Le 05/11, avant de tester la GPO GPO-Ordi-Pare-feu-Ping, la règle activée à la main lors d’E-04 est
désactivée sur poste-win11 (Disable-NetFirewallRule -Name FPS-ICMP4-ERQ-In). Le ping depuis srv-docker passe
quand même (11:32:23, 3/3). Le test semble prouver la GPO, mais rien ne le garantit.
Contexte — Tâche 6.20 (Documentation, étape 61). Le 08/10, le ping vers le poste échouait (il était alors en
10.0.40.100, adresse dynamique ; il est en 10.0.40.10 depuis la réservation DHCP du 21/10).
Diagnostic — Profil réseau du poste : Get-NetConnectionProfile → sio.internal, DomainAuthenticated.
Règles d’écho réellement actives (Get-NetFirewallRule -PolicyStore ActiveStore -Enabled True -Direction Inbound, filtrées
sur IcmpType 8) :
| Règle | Profil | Origine |
|---|---|---|
FPS-ICMP4-ERQ-In | Private, Public | activée à la main (E-04) — désactivée à ce moment-là |
FPS-ICMP4-ERQ-In-V2 | Any | locale, activée, origine non retrouvée |
FPS-ICMP4-ERQ-In-NoScope | Domain | locale, activée, origine non retrouvée |
Lab - Ping entrant (ICMPv4 echo) | Domain, Private | GroupPolicy (la GPO) |
Cause — (1) La règle d’E-04 ne couvrait pas le profil Domaine : dès la jonction du poste au domaine, elle ne jouait plus aucun rôle (même piège que H-15). C’est une explication probable, non prouvée, de l’échec du ping du 08/10. (2) Deux autres variantes de la même règle Windows étaient actives, dont une pour le profil Domaine : ce sont elles qui laissaient passer le ping ; qui les a activées, et quand, n’est écrit nulle part.
Résolution — Désactiver aussi les deux variantes (Disable-NetFirewallRule -Name FPS-ICMP4-ERQ-In-V2, FPS-ICMP4-ERQ-In-NoScope) : une seule règle d’écho reste active, celle de la GPO ; le ping depuis srv-docker
passe (11:36:40, 3/3), la preuve est cette fois valable (captures 182 à 184). Retour arrière : Enable-NetFirewallRule
sur les trois noms.
À retenir — Avant de déclarer qu’une GPO produit un effet, lister tous les réglages actifs qui pourraient produire le même (
-PolicyStore ActiveStorepour le pare-feu) et retirer les réglages locaux. Et une règle de pare-feu Windows se règle pour tous les profils où la machine peut se trouver, pas un seul.
Suite (05/11, 11:59) — Pendant la contre-épreuve (règle de la GPO rétrécie à 10.0.40.0/24), le ping depuis
10.0.30.12 passe encore. pktmon sur le poste montre la source réelle 10.0.30.12 (pas de traduction d’adresse) ; la liste
des règles actives montre les trois règles locales de nouveau actives. Journal Windows Firewall With Advanced
Security/Firewall, événement 2099 à 11:38:22 : modification par SIO\Administrateur, application WmiPrvSE.exe
(les commandes PowerShell du pare-feu) : Axel a confirmé avoir lancé la commande de retour arrière Enable-NetFirewallRule
dans sa session SSH, en la lisant comme une étape à faire. Règles désactivées de nouveau le temps du test : refus à 12:01:41,
contre-épreuve réussie. État final (décision d’Axel, 12:06) : règles locales désactivées, la GPO est la seule source.
À retenir — Une commande de retour arrière s’écrit à part et marquée « ne pas lancer » : dans une suite d’étapes, elle se lit comme une étape de plus. Et devant un test qui « réussit » contre toute attente, relire l’état réel (
ActiveStore) et le journal du pare-feu avant de conclure.
H-83 · Tester une sonde HTTP sans curl ni nc -U sur des serveurs minimaux
Symptôme — Installation de la sonde Galera (étape 62, 05/11) : installer-galera-etat.sh: ligne 8: curl : commande introuvable sur srv-mysql-03 ; puis, sur srv-ha, echo "show stat" | nc -U /run/haproxy/admin.sock répond
nc: invalid option -- 'U'.
Contexte — Les nœuds Galera et srv-ha sont des Debian minimales : curl n’y est pas installé, et le nc présent
(variante traditional) ne sait pas ouvrir un socket Unix.
Cause — Outils absents ou trop limités, pas une panne : le socket systemd de la sonde était déjà actif (le set -e
du script s’est arrêté sur la ligne de test, après l’activation).
Résolution — Sans rien installer :
- requête HTTP en bash pur :
exec 3<>/dev/tcp/127.0.0.1/9200; printf 'GET / HTTP/1.0\r\n\r\n' >&3; cat <&3; - socket d’administration de HAProxy en
python3(présent) :socket.AF_UNIX, envoyershow stat\n, lire la réponse (colonnes 2 = serveur, 18 = état, 37 = résultat du contrôle).
À retenir — Sur un serveur minimal, ne pas installer un outil juste pour un test :
bash(/dev/tcp) etpython3suffisent pour parler HTTP ou à un socket. Et dans un script d’installation, mettre le test après les actions, pour qu’un outil manquant n’empêche pas l’installation.
H-84 · lsyncd arrêté depuis une semaine, mais systemctl dit « active »
Symptôme — Le 05/11 à 14:12, l’extension wp-content/mu-plugins/gsb-intranet.php posée sur srv-web-01 n’arrive
pas sur srv-web-02 (« Aucun fichier ou dossier de ce nom »), alors que lsyncd doit recopier wp-content en 5 s.
systemctl status lsyncd : active (exited) since Thu 2026-10-29 10:59:48.
Contexte — Étape 64 (site de GSB). lsyncd recopie wp-content de srv-web-01 vers srv-web-02 (10.0.10.11)
par rsync sur SSH (clé confinée, étape 32).
Cause — Au démarrage du 29/10, lsyncd a tenté sa recopie initiale avant que le réseau soit prêt :
ssh: connect to host 10.0.10.11 port 22: Network is unreachable, puis Terminating since "insist" is not set : sans
l’option insist, il abandonne. Le service est lancé par un script de démarrage à l’ancienne (LSB, /etc/init.d) :
systemd ne suit pas le processus et affiche active (exited) même quand il n’existe plus. Rien ne surveillait lsyncd.
Résolution — Copie lsyncd.conf.lua.avant-insist, ajout de insist = true dans settings, systemctl restart lsyncd : recopie initiale terminée en 3 s (finished: 0) ; fichier témoin écrit sur srv-web-01, lu sur srv-web-02
10 s après, puis supprimé des deux (capture 200). Puis surveillance ajoutée (H-6, étape 64.1) : mesure du processus et
règle d’alerte Grafana, testée par un arrêt volontaire (mail reçu, capture 206).
À retenir — « active » ne veut pas dire « ça marche » : vérifier le processus (
pgrep -a lsyncd) et le résultat (un fichier témoin), pas seulement l’état du service. Et un démon qui dépend du réseau doit réessayer au démarrage (insist, ou une dépendance ànetwork-online.target).
H-85 · Datastore S3 refusé : « failed to upload in-use marker … 500 » (SeaweedFS sans volume libre)
Symptôme — Le 05/11 à 15:13:50, proxmox-backup-manager datastore create s3-maison … --backend type=s3,… s’arrête
à 99 % : TASK ERROR: failed to upload in-use marker for datastore: unexpected status code 500 Internal Server Error,
avec la réponse XML de SeaweedFS <Code>InternalError</Code> sur s3-maison/.in-use. Pourtant, s3 check venait de
réussir.
Contexte — Étape 65 : datastore S3 du PBS vers SeaweedFS sur le NAS d’Axel (quota 200 Gio, réglage Volume Size Limit laissé à 30 000 Mo).
Diagnostic — Pages d’état de SeaweedFS, lisibles sans mot de passe sur le réseau du NAS (master :30301/dir/status,
volume :30302/status) : "Max":6,"Free":0 ; la collection par défaut occupe les 6 volumes ; la collection
pbs-lab (chaque bucket a la sienne) a writables: null.
Cause — SeaweedFS calcule le nombre de volumes possibles d’après la place : 200 Gio ÷ 30 Go = 6. Au démarrage, il en
a créé 6, vides, pour sa collection par défaut. Le bucket n’avait plus aucun emplacement pour créer ses propres volumes :
toute écriture de données échouait (erreur 500). Le s3 check a réussi sans doute parce qu’il n’écrit pas de vraies
données (non vérifié).
Résolution — Dans TrueNAS, application SeaweedFS → Edit → Volume Size Limit : 1000 (Mo) (Axel) : "Max":197, "Free":191. Dossier de cache du premier essai supprimé, création relancée à 15:19:47 → TASK OK ; la collection
pbs-lab reçoit 7 volumes.
À retenir — Avec un petit disque, de gros volumes SeaweedFS laissent très peu d’emplacements, et chaque bucket en réclame. Régler la taille des volumes avant de créer des buckets (environ 1 Go pour quelques centaines de Go). Et lire les pages d’état du serveur avant d’accuser le client.
H-86 · Le site GLPI devient le « site par défaut » d’Apache et fait tomber WordPress
Symptôme — Le 05/11 à 17:17, https://www.sio.internal répond 503 503 503. Journal de HAProxy :
web_admin/web-01, web_public/web-01 DOWN Layer7 wrong status code: 400 à 17:00:39, puis web_public/web-02 DOWN … 400 à 17:17:36.
Contexte — Installation de GLPI sur les serveurs web (étape 66) : un second site Apache, glpi.conf
(ServerName glpi.sio.internal), à côté de wordpress.conf.
Cause — wordpress.conf déclarait ServerName srv-web.sio.internal et ServerAlias 10.0.10.10, pas
www.sio.internal. Seul, il servait tous les noms par défaut. apache2ctl -S après l’ajout : default server glpi.sio.internal (premier par ordre alphabétique). Les demandes pour www (dont le contrôle de santé de HAProxy)
arrivaient chez GLPI, qui répond 400 au HTTP simple depuis l’activation des cookies secure. srv-web-01 est tombé
à 17:00:39 (cookies secure), srv-web-02 à 17:17:36 (site GLPI activé) : plus aucun serveur, 503.
Résolution — Sur les deux serveurs, copie wordpress.conf.avant-glpi, ajout de ServerAlias www.sio.internal,
apache2ctl configtest, reload (17:18:06) : web-01 UP à 17:18:13, web-02 à 17:18:19, www et glpi 200.
Impact : administration de WordPress (épinglée sur web-01) injoignable 17:00:39 → 17:18:13 ; site public en 503
environ 43 s. Grafana : « Service injoignable » en attente à 17:18:00, revenue avant les 2 minutes : pas de mail. Les
18 minutes avec un seul serveur n’ont déclenché aucune alerte : point d’hygiène H-7.
À retenir — Sur un serveur qui héberge plusieurs sites, chaque site déclare tous les noms par lesquels on l’appelle ; vérifier
apache2ctl -S(« default server ») après tout ajout. Et tester l’application existante juste après chaque changement, pas seulement la nouvelle.
H-87 · Grafana : une règle « réactivée » par l’API reste en pause
Symptôme — Le 06/11 à 08:40, PUT /api/v1/provisioning/alert-rules/<uid> avec "isPaused": false répond
et renvoie la règle avec isPaused: false. Relue juste après : toujours en pause, champ updated inchangé
(05/11 15:27). Aucune erreur.
Contexte — Réactivation de la règle « VM absente de la copie hors site (NAS) » (étape 65.3), par le compte de
service claude (en-tête X-Disable-Provenance: true).
Cause — La modification de la règle seule n’a pas été enregistrée ; la cause exacte dans Grafana À VÉRIFIER.
La réponse de l’API reflétait la demande, pas l’état enregistré.
Résolution — Passer par le groupe de règles : GET puis PUT /api/v1/provisioning/folder/<dossier>/rule-groups/avertissements
avec isPaused: false sur la règle. Relu ensuite : isPaused: false, updated 06/11 08:40:54 (capture 228).
À retenir — Après une modification par l’API, relire l’objet : la réponse d’une écriture ne prouve pas qu’elle est enregistrée. La capture de preuve l’a montré (première version : « en pause »).
H-88 · LogAnalyzer 5.0.2 : le lien vers l’installeur s’affiche en texte brut
Symptôme — Le 06/11, première ouverture de https://10.0.30.15:8443/ : cadre rouge « Critical Error occured »,
Error, main configuration file is missing!<br><br><center><b>Click <a href="./install.php">here</a> to Install Adiscon LogAnalyzer!</b>… — les balises s’affichent, le lien n’est pas cliquable.
Contexte — Installation de LogAnalyzer 5.0.2 (étape 17.4), config.php encore vide.
Cause — La version 5.0.2 « durcit » l’affichage des messages d’erreur contre l’injection de code (notes de version : HTML output hardening sur les vues d’erreur). Le message d’origine contient lui-même du HTML, qui est donc échappé. Rien de cassé : seul l’affichage du lien est touché.
Résolution — Ouvrir directement https://10.0.30.15:8443/install.php.
À retenir — Après une mise à jour de sécurité, un message « bizarre » peut être l’effet d’une protection, pas une panne : lire ce que le message demande avant de chercher plus loin.
H-89 · GLPI : 590 connexions SSH par heure vers srv-web-02 et des sessions jamais effacées
Symptôme — Le 06/11, Axel voit dans Grafana « Réussies (24 h) » = 9 640, et dans « Dernières connexions
réussies » une connexion root depuis 10.0.10.10 vers srv-web-02 (« SSH, clé ») toutes les 6 s. Comptage par
heure : 5 et 1 le 05/11 à 14h et 15h, puis ~590 par heure depuis 17h.
Contexte — La veille vers 17h, la recopie lsyncd de /var/lib/glpi (clé id_lsyncd_glpi, délai 5 s) a été
ajoutée pour le secours de GLPI (étape 66).
Cause — Deux défauts qui s’additionnent :
- Le contrôle de santé de HAProxy (
GET /status.phptoutes les 2 s) ouvre une nouvelle session PHP à chaque appel : 33 fichierssess_…par minute dans/var/lib/glpi/_sessions.lsyncdrecopie chaque nouveau fichier : une connexion SSH toutes les 6 s. - Ces fichiers ne sont jamais effacés : Debian met
session.gc_probability = 0et confie le ménage à sa tâchesessionclean, qui ne connaît que le dossier par défaut de PHP, pas celui de GLPI. 34 367 fichiers sursrv-web-01et 62 040 sursrv-web-02en 16 h.
Résolution (décision d’Axel, capture 235) :
glpi-sessions-menage.timersur les deux serveurs (toutes les 15 min, sessions de plus de 24 min =gc_maxlifetime) : 34 367 → 797 et 62 040 → 796. Option-ignore_readdir_race: sursrv-web-02,lsyncdefface parfois le même fichier au même moment (le premier passage s’est terminé en erreur sans elle).lsyncd, bloc GLPI : délai 5 → 30 s : 10 → 2 connexions par minute. Contrepartie acceptée : en cas de bascule, jusqu’à 30 s de changements de GLPI peuvent manquer.- Grafana (v72) : les deux panneaux de connexions réussies excluent la clé de recopie : 9 640 → 54.
- Effet de bord du point 2, vu par Axel (« Lignes de journaux reçues » :
srv-web-02= 10 281 par heure) : avec une connexion toutes les 30 s au lieu de 6, le gestionnaire de session de root (user@0: D-Bus, PipeWire, GnuPG…) s’arrêtait 10 s après chaque déconnexion et redémarrait à la suivante : ~80 lignes par connexion, 20 → 164 lignes par minute. Correction :loginctl enable-linger rootsursrv-web-02(le gestionnaire reste lancé) : 164 → 4.
À retenir — Une sonde qui appelle une application toutes les 2 s n’est pas neutre : elle peut créer des sessions, des journaux, des recopies. Après l’ajout d’un contrôle de santé, regarder ce qu’il produit sur le serveur. Et sous Debian, un dossier de sessions PHP personnalisé a besoin de son propre ménage. Piste non suivie (
À VÉRIFIER) : faire en sorte que le contrôle de santé n’ouvre pas de session. Et un réglage qui réduit un bruit peut en créer un autre : mesurer après chaque changement, sur toutes les machines touchées.
H-90 · Sonde Galera : 3 échecs simultanés à 05:50, sans retrait de nœud
Symptôme — Le 06/11, la recherche severity:warning de LogAnalyzer (étape 67) montre, sur les 3 nœuds, à 05:50:46-47 :
galera-etat@…:9200-10.0.10.5:….service: Failed with result 'exit-code'. HAProxy n’a retiré aucun nœud.
Contexte — Sonde d’état Galera (étape 62) : un service systemd par contrôle de HAProxy (toutes les 2 s, fall 3).
Cause (vérifiée par une analyse en lecture seule des journaux des 3 nœuds et de srv-ha) :
- directe, certaine : le script sort en code 1 sur son
printffinal,printf: erreur d'écriture : Relais brisé (pipe): HAProxy avait déjà raccroché quand la réponse est partie ; - avant : pendant 7 à 12 s, aucune sonde n’a démarré sur les nœuds (dernières réussites 05:50:34 à 05:50:39) ;
HAProxy n’a fait qu’une tentative pendant ce trou et l’a abandonnée au bout de 2 s (pas de
timeout check) ; la connexion n’a été prise en charge qu’à 05:50:46, d’où l’écriture dans un socket fermé. La sonde suivante, 35 ms plus tard, a réussi : un seul échec par nœud,fall 3jamais atteint. Au même moment, des écritures versmysql-01ont duré 8 s et les journaux sont arrivés avec 7 s de retard ; - origine du blocage, probable, non prouvée : un ralentissement ponctuel des disques ou de l’hyperviseur partagé,
touchant les 3 VM de base en même temps. Écartés : rechargement de HAProxy, gel des disques par l’agent invité,
tâche planifiée, message de MariaDB, réseau. Journaux de
pve-01à 05:50:36-46À VÉRIFIER.
Fréquence — Cas isolé : depuis le 05/11 midi, seules la mise en place (05/11 vers 16 h) et les sauvegardes de 02:00 produisent d’autres échecs.
Résolution (appliquée le 06/11 à la demande d’Axel, capture 238) : trap '' PIPE et printf … 2>/dev/null || exit 0 dans galera-etat.sh des 3 nœuds (un client parti n’est pas une panne de la sonde ; ancienne version : code 141,
nouvelle : 0 ; 20 raccrochages par nœud : 0 échec) ; timeout check 3s et default-server inter 2s fall 3 rise 2 dans
listen galera (copies .avant-h90). Un nœud vraiment désynchronisé répond toujours 503 et sort. La règle « Serveur retiré par HAProxy » (étape 68) surveille désormais l’effet
réel (un retrait) plutôt que ces lignes.
À retenir — Une ligne « Failed » isolée n’est pas forcément une panne : chercher ce qu’il s’est passé avant (ici, un trou de 7 à 12 s) et ce qu’en a conclu le composant qui décide (HAProxy : rien).
H-91 · GLPI publié par Pangolin : « L’action que vous avez réalisée n’est pas autorisée » à la connexion
Symptôme — Le 06/11, GLPI publié par Axel dans Pangolin (glpi.pangolin.<domaine>) : la page de connexion
s’affiche, mais l’envoi du formulaire répond « L’action que vous avez réalisée n’est pas autorisée ».
Contexte — HAProxy choisit le pool GLPI d’après le nom glpi.sio.internal (étape 66).
Cause — Le nom Pangolin ne correspondait pas : la requête partait dans le pool du site (web_public, web-01 et
web-02 en alternance), où chaque Apache sert GLPI par défaut. Journaux Apache : page de connexion servie par les deux
serveurs à 11:05:10, puis POST /front/login.php sur srv-web-02 → 403 à 11:07:03. La session ouverte sur web-01
n’était pas (encore) sur web-02 (recopie toutes les 30 s) : GLPI a rejeté le jeton anti-falsification (CSRF).
Résolution — Dans frontend web_in de srv-ha (copie .avant-pangolin-glpi) : acl est_glpi_pangolin hdr_beg(host) -i glpi.pangolin. → use_backend glpi (même pool actif / secours) ; et http-request deny de l’API
sous ce nom : le tunnel Pangolin arrive depuis le bastion, l’une des deux adresses autorisées pour l’API. Connexion
réussie (Axel). Le domaine personnel n’est écrit nulle part (règle sur le début du nom).
À retenir — Une application à sessions derrière un répartiteur doit toujours arriver sur le même serveur : chaque nouveau nom publié doit être rattaché au bon pool. Et un nouveau chemin d’accès peut contourner un filtre par adresse source (ici, l’API) : le vérifier à chaque publication.
H-92 · Agent GLPI : 504 Gateway Time-out sur l’inventaire complet d’un serveur web
Symptôme — Le 06/11, glpi-agent --force --full sur srv-web-01 et srv-web-02 : [error] [http client] communication error: 504 Gateway Time-out. GLPI enregistre pourtant les 1 700 logiciels.
Cause — Le traitement d’un inventaire de 1 700 paquets dépasse 30 s : timeout server 30s (HAProxy, section
defaults) et max_execution_time = 30 (PHP).
Résolution — Pour GLPI seulement : timeout server 180s dans backend glpi (copie .avant-timeout-glpi) ;
php_admin_value max_execution_time 180 et memory_limit 256M dans glpi.conf des deux serveurs (copie
.avant-timeout). WordPress garde ses réglages. Nouvel inventaire complet : sans erreur.
À retenir — Les délais d’un répartiteur se règlent par application : une page web répond en moins d’une seconde, un inventaire ou un import peut durer une minute.
H-93 · Agent invité de srv-mysql-01 bloqué après une requête trop longue lancée par lui
Symptôme — Le 06/11 vers 11:14, qm guest exec 106 … (une requête SQL de lecture de l’inventaire GLPI) expire
(got timeout) ; ensuite, qm agent 106 ping → QEMU guest agent is not running. Le nœud lui-même va bien (synchronisé,
UP dans HAProxy, 935 Mio libres, journaux reçus).
Cause — L’agent invité (qemu-guest-agent) traite les commandes une par une ; une commande qui dure plus longtemps que
le délai côté Proxmox le laisse occupé, puis il ne répond plus. Cause exacte du blocage À VÉRIFIER.
Résolution — sudo systemctl restart qemu-guest-agent par Axel (Termix) : active, qm agent 106 ping répond.
Récidive le même jour sur srv-pbs (VM 137), pendant la mise à jour d’apt (étape 71) : même symptôme, même
résolution par Axel. À surveiller : si l’agent se bloque encore, relever sa version et son journal (journalctl -u qemu-guest-agent).
3ᵉ fois, le 10/11 sur srv-web-02 (VM 130), pendant le test de copie de Matomo (18.4) : la commande envoyée par
qm guest exec attendait dans l’agent (boucle de 50 s guettant l’arrivée d’un fichier) ; got timeout, puis
QEMU guest agent is not running. La machine elle-même allait bien (site, GLPI et Matomo à 200 en direct ; 998 Mio
disponibles, aucun OOM). Relance par Axel (sudo systemctl restart qemu-guest-agent → active). Cause commune aux
trois fois : une commande qui dure plus que le délai donné à l’agent. Règle adoptée : plus aucune attente dans
l’agent ; on attend côté Claude (relances courtes de quelques secondes), et le test refait ainsi a réussi.
À retenir — L’agent invité sert aussi à figer les disques pendant la sauvegarde de 02:00 : s’il ne répond plus, le relancer le jour même. Lancer les requêtes lourdes sur un nœud de secours (
srv-mysql-02/03), pas sur le nœud principal, et avec un délai raisonnable.
H-94 · Pangolin : toutes les ressources en « 404 page not found » après une coupure de courant
Symptôme — Le 09/11 au matin, toutes les adresses publiées par Pangolin (Termix, Wazuh, Grafana, GLPI, LogAnalyzer…)
affichent 404 page not found en texte brut ; seule l’interface de Pangolin s’affiche. Dans Pangolin, les ressources
sont pourtant toutes « Sain » (le tunnel vers le lab fonctionne) et les VM du lab tournent ; mails « souvent
indisponible » des sondes Pangolin et Termix.
Contexte — Pangolin tourne chez Axel (conteneur 106 de son Proxmox, installé par le script communautaire : services
pangolin, gerbil, traefik, sans Docker). Coupure de courant chez Axel dans la nuit du 08 au 09/11 : serveur
et box redémarrés en même temps.
Cause — 404 page not found en texte brut est la page de Traefik quand aucune route ne correspond. Journal
(journalctl -u traefik -b) : invalid middleware "badger@http" configuration: invalid middleware type or middleware does not exist pour chaque ressource. Badger est le module d’authentification de Pangolin, posé sur toutes les
routes des ressources (même « non protégées ») ; Traefik le télécharge au démarrage. Le conteneur a démarré avant
que la box rende Internet : téléchargement raté, Traefik écarte toutes les routes qui l’utilisent et ne réessaie
pas. La route de l’interface de Pangolin, écrite en dur sans ce module, est restée.
Résolution — systemctl restart traefik (Internet revenu) : plus de 404 (Termix 200, ressources protégées 401
= page de connexion), vérifié depuis Internet à 08:42. Prévention : réglage systemd
/etc/systemd/system/traefik.service.d/attendre-internet.conf : After=network-online.target et un ExecStartPre
qui attend que https://plugins.traefik.io réponde (essai toutes les 5 s, 15 min au plus) ; appliqué et vérifié
(Drop-In affiché, ExecStartPre … status=0/SUCCESS, service actif).
Bruit sans rapport, laissé en l’état — Le même journal montre des demandes de certificat refusées (403 … acme-challenge … 404, puis 429 rateLimited la nuit) : le port 80 de la box n’arrive pas à Traefik mais à un autre
proxy (openresty) qui redirige vers HTTPS. Sans effet : le certificat servi (*.pangolin.<domaine>, Let’s Encrypt)
est valable jusqu’au 11/01/2027. Son renouvellement est À VÉRIFIER d’ici fin décembre.
À retenir — Un
404brut devant toutes les ressources, avec des ressources « Sain », c’est Traefik sans ses routes, pas le lab. Un service qui télécharge quelque chose au démarrage doit attendre Internet, sinon la prochaine coupure de courant le recasse.
H-95 · Pangolin : « no available server » alors que la cible répond (contrôle de santé mal réglé)
Symptôme — Le 10/11, la ressource « GSB » (cible https://www.sio.internal:443) reste « En mauvaise santé » et le site
affiche no available server, alors que la ressource GLPI, réglée pareil, est « Sain ». curl depuis srv-docker et depuis
le conteneur du tunnel : le nom se résout en 10.0.10.5 et le port 443 est ouvert.
Cause — Dans la fenêtre du contrôle de santé (bouton de la colonne Vérification de l’état de santé, onglet
Connexion), l’hôte valait www.sio.internal/ (une barre oblique de trop : nom invalide) et le port 80 au lieu de
443. La stratégie TCP était la bonne. Même cas que H-18 : Pangolin croit la cible malade et ne lui envoie rien.
Résolution — hôte www.sio.internal, port 443, stratégie TCP (comme Wazuh et pfSense : cible en HTTPS à certificat
auto-signé) ; après enregistrement, la cible passe « Sain » et le site répond.
À retenir — « no available server » = le proxy croit la cible malade. Ouvrir la fenêtre du contrôle de santé et lire chaque onglet : une ressource copiée « comme l’autre » peut garder un hôte ou un port par défaut.
H-96 · Site public : la vraie adresse des visiteurs n’arrive pas dans le lab
Symptôme — Le 10/11, une visite de test envoyée depuis Internet est enregistrée par Matomo avec une adresse privée du réseau de la maison (tronquée) (pays inconnu) au lieu de l’adresse publique de l’appelant ; HAProxy ne voit jamais que l’adresse d’une machine du réseau de la maison d’Axel.
Diagnostic — Chemin : Internet, box, Nginx Proxy Manager (hôte *.pangolin.<domaine>, sur le serveur de fichiers
d’Axel), Traefik de Pangolin, tunnel, lab. On relève, sur HAProxy (capture temporaire, retirée aussitôt), les en-têtes
reçus, en envoyant exprès une fausse adresse (203.0.113.9) :
| Étape | Ce qu’on constate |
|---|---|
| Journal d’accès de Nginx Proxy Manager | [Client <vraie adresse>] : il voit la vraie adresse (celle de l’appelant, et celles des serveurs de Let’s Encrypt) |
X-Forwarded-For et X-Real-IP reçus par HAProxy | l’adresse du serveur de Nginx Proxy Manager, même avec la fausse valeur envoyée : un maillon les remplace |
Cause — Traefik remplace X-Forwarded-For et X-Real-IP par l’adresse de celui qui lui parle (Nginx Proxy Manager),
parce qu’il ne lui fait pas confiance. Le réglage forwardedHeaders.trustedIPs ajouté à son point d’entrée websecure
(copie traefik_config.yml.avant-xff-1011) n’a rien changé, sans qu’on en ait trouvé la raison (Traefik lit bien son
fichier, aucune erreur au démarrage). La piste « le réseau de l’application sur le serveur de fichiers masque l’adresse »,
écrite le 10/11 au soir, était fausse.
Résolution (11/11) — on contourne Traefik avec un en-tête qu’il ne touche pas :
- Nginx Proxy Manager, hôte
*.pangolin.<domaine>, onglet Advanced :more_set_input_headers "X-Client-Real-IP: $remote_addr";. Un premier essai avecproxy_set_headera échoué : nginx n’hérite pas desproxy_set_headerdu niveau « site » dès que la section interne d’un hôte en contient (celle de Nginx Proxy Manager en contient) ; la fausse adresse du test est passée telle quelle.more_set_input_headersmodifie la requête avant l’envoi et remplace toute valeur envoyée par le visiteur : il ne peut pas falsifier son adresse. - HAProxy (
srv-ha, copiehaproxy.cfg.avant-ip-reelle-1111) : pour le nom public,X-Forwarded-ForreprendX-Client-Real-IP, et la limite de débit compte par visiteur sur cet en-tête ; plafond remis de 400 à 100 requêtes par 10 s. Matomo lit déjàX-Forwarded-For(proxy_client_headers) et ignore l’adresse du bastion (proxy_ips = 10.0.30.12).
Vérification (capture 251) — avec la fausse adresse, HAProxy reçoit la vraie ; 130 requêtes d’un même visiteur :
100 passent, 30 sont refusées (429), un autre visiteur passe ; une visite depuis Internet est enregistrée par Matomo en
81.255.0.0, pays fr.
À retenir — Quand plusieurs proxys se suivent, on relève l’en-tête à chaque étape en envoyant une fausse valeur : celui qui la remplace est le coupable. Et la bonne parade n’est pas toujours de « faire confiance » à l’étape d’avant : un en-tête propre (nom que personne d’autre ne touche) est plus simple. Rappel nginx : un
proxy_set_headerau niveau du site est ignoré si la section interne en définit déjà un.
H-97 · L’annuaire refuse le LDAP en clair, puis le LDAPS ne répond pas (« 8009030e »)
Symptôme — Depuis srv-web-01, une connexion au compte de liaison CS_glpi_ldap sur le port 389 répond
LDAP result 8 : « The server requires binds to turn on integrity checking if SSL\TLS are not already active ».
Après l’ouverture du port 636, la connexion TLS est coupée (Connection reset by peer), et openssl s_client affiche
Cipher is (NONE). Sur le contrôleur, le journal Directory Service dit : « LDAP sur SSL ne sera pas disponible : le serveur
n’a pas pu obtenir de certificat » (erreur 8009030e, aucune information d’identification disponible).
Contexte — Phase 19 : GLPI doit lire l’annuaire sio.internal (AD-Core-01, Windows Server 2025) pour que les salariés
se connectent avec leur compte du domaine. Le plan initial était le LDAP simple en clair (389), à noter comme dette.
Cause (en deux temps) —
- Windows Server 2025 impose la signature LDAP : un bind simple en clair est refusé. Le plan « 389 puis LDAPS plus tard » ne pouvait pas marcher ; le LDAPS est obligatoire.
- Le contrôleur n’avait aucun certificat (pas d’autorité de certification dans le lab). J’ai créé un certificat auto-signé dans le magasin de l’ordinateur ; il n’a pas été pris en compte tant qu’il n’était pas aussi dans les autorités racines de confiance du contrôleur lui-même : un certificat auto-signé n’a pas d’autorité au-dessus de lui, et le contrôleur refuse un certificat dont il ne peut pas valider la chaîne.
Piège d’interprétation — un premier test d’openssl affichait « Verification: OK » alors que la connexion n’avait jamais abouti : la ligne Cipher is (NONE) dit la vérité. Pour un test TLS, lire le chiffrement négocié, pas le mot « Verification ».
Résolution —
- Certificat auto-signé (
CN=AD-Core-01.sio.internal, SANAD-Core-01.sio.internaletsio.internal, RSA 2048, 5 ans, clé dans le fournisseur standard de Windows) dansLocalMachine\My. - Le même certificat importé dans
LocalMachine\Rootdu contrôleur : le LDAPS répond aussitôt (TLS 1.3, sans redémarrage, sans demande de rechargement). - Sa partie publique installée dans
/usr/local/share/ca-certificates/des deux serveurs web, puisupdate-ca-certificates: PHP et GLPI vérifieront le certificat. - Règle pfSense WEB →
10.0.30.10en 636 (et non 389). - Test final :
TLS : TLSv1.3 | certificat vérifié,Code de résultat LDAP : 0(capture 253).
À retenir — (1) Un contrôleur de domaine récent refuse le LDAP en clair : prévoir LDAPS dès le départ. (2) Un certificat auto-signé pour le LDAPS doit être dans les autorités racines du contrôleur en plus du magasin personnel. (3) Il expire le 11/11/2031 : le remplacer par un certificat d’une autorité interne si le lab grandit.
H-98 · Le script de démarrage de la GPO ne se lance pas : une barre oblique a disparu
Symptôme — Le 11/11, la VM de test POSTE-TEST-GPO reçoit bien la GPO GPO-Ordi-Poste-Pret (gpresult), l’extension
Scripts est traitée sans erreur (événement 5016), mais après deux redémarrages aucun journal du script et aucun agent installé.
En testant le partage depuis le poste, PowerShell répond « Impossible de trouver le chemin d’accès C:\AD-Core-01.sio.internal\Deploiement$ ».
Contexte — Phase 21. Claude écrit les fichiers de la GPO (scripts.ini) en envoyant un script PowerShell au contrôleur par
l’agent invité de Proxmox, depuis son terminal (Git Bash sous Windows), le texte étant tapé dans un « here-document » du terminal.
Cause — Dans ce terminal, la suite \\ du texte envoyé a été réduite à une seule barre avant même d’atteindre le contrôleur.
Le chemin réseau \\AD-Core-01.sio.internal\Deploiement$\preparer-poste.ps1 est donc devenu \AD-Core-01… : pour Windows,
un chemin relatif au disque C: du poste, qui n’existe pas. Le même défaut avait déjà faussé, plus tôt, un test du SYSVOL et créé un
dossier parasite C:\sio.internal sur le contrôleur (supprimé). Vérification : od -c du fichier envoyé ne montrait qu’une barre.
Résolution — Le correctif est écrit dans un fichier (outil d’écriture de Claude, sans passer par le terminal), contrôlé octet par
octet (od -c : deux barres), puis envoyé : scripts.ini corrigé, version de la GPO augmentée (6, identique dans l’AD et le SYSVOL),
gpupdate /force et redémarrage du poste. Au démarrage suivant, les quatre agents s’installent en 3 minutes (capture 266).
À retenir — (1) Un script qui contient des chemins réseau
\\serveur\partagene s’écrit pas dans un here-document du terminal : on l’écrit dans un fichier et on vérifie ses octets avant de l’envoyer. (2) Un chemin UNC qui commence par une seule barre n’est pas une erreur de syntaxe pour Windows : c’est un chemin local, d’où un échec silencieux. (3) Avant d’accuser la GPO, tester l’accès au chemin depuis le poste, avec le compte SYSTEM : c’est ce compte qui exécute un script de démarrage.
H-99 · Une GPO déclare une extension avec un identifiant faux
Symptôme — Aucun. L’erreur a été trouvée par comparaison, le 11/11 : en créant la GPO GPO-Ordi-Securisation,
Windows a lui-même déclaré l’extension « Registre » sous {35378EAC-683F-11D2-A89A-00C04FBBCFA2}, alors que la GPO
GPO-Ordi-Poste-Pret, écrite à la main la veille, portait {35378EAC-683F-11D2-A89A-00C04FBBCF2B}.
Contexte — Phase 21. Pour déclarer un script de démarrage sans console graphique (Server Core), Claude a écrit
lui-même l’attribut gPCMachineExtensionNames de la GPO (liste des extensions côté client à appeler), en tapant les
identifiants de mémoire.
Cause — Un identifiant mal recopié. Pour Windows, une extension inconnue est simplement ignorée : le réglage de registre de la GPO (« toujours attendre le réseau au démarrage ») n’était sans doute pas appliqué. Le script a fonctionné quand même, grâce à sa propre boucle d’attente du partage.
Résolution — Identifiant corrigé (…CFA2), version de la GPO augmentée (7, identique dans l’AD et le SYSVOL).
À retenir — Ne jamais taper un identifiant d’extension de GPO de mémoire : le recopier d’une GPO créée par les outils de Windows (
Set-GPRegistryValue,New-NetFirewallRule -PolicyStore) ou de la documentation de Microsoft. Une erreur ne produit aucun message : seul le réglage manque.
H-100 · Proxmox n’arrive pas à redémarrer une VM Windows, qui reste éteinte
Symptôme — Le 11/11, qm reboot 101 --timeout 180 répond VM quit/powerdown failed. Dans la VM, shutdown /r
répond « un arrêt du système est déjà en cours » (code 1115). Quelques minutes plus tard, poste-win11 est éteinte
(status: stopped), et une alerte « Machine injoignable » part par mail.
Contexte — Phase 21 : redémarrage de poste-win11 pour appliquer le script de démarrage de la GPO ; aucune session
ouverte sur le poste.
Cause — Windows a pris l’ordre d’arrêt envoyé par Proxmox, mais l’arrêt a duré plus que le délai donné (des mises à
jour s’installaient sans doute à l’arrêt). Un qm reboot = un arrêt puis un démarrage : le délai étant dépassé,
Proxmox a abandonné et n’a jamais relancé la VM.
Résolution — qm start 101 ; le script de démarrage a ensuite tourné normalement (17:25).
À retenir — Après un redémarrage demandé à Proxmox, vérifier l’état de la VM (
qm status) : un délai dépassé peut la laisser éteinte. Pour une VM Windows, prévoir un délai long, ou laisser Windows redémarrer seul (shutdown /rdans la VM) et ne rien forcer tant qu’il installe des mises à jour.
H-101 · Une date lue de travers : l’échéance LAPS semblait être à 24 h
Symptôme — Le 11/11, après la mise en service de LAPS, l’échéance du mot de passe lue dans l’AD s’affiche
12/11/2026 16:56:00, alors que la politique dit 30 jours : on croit à une échéance à 24 h, notée À VÉRIFIER.
Cause — La date était juste, c’est sa lecture qui était fausse. Quand PowerShell insère une date dans un texte
entre guillemets ("expiration : $date"), il l’écrit au format invariant, à l’américaine : mois/jour/année, même sur un
Windows réglé en français (Get-Culture = fr-FR). 12/11/2026 voulait dire le 11 décembre. L’indice était sous les
yeux : dans la même sortie, l’heure courante s’affichait 11/12/2026 10:43, impossible en format français.
Résolution — Relecture au format sans ambiguïté : $date.ToString('yyyy-MM-dd HH:mm') → 2026-12-11 16:56, soit
29,3 jours restants : LAPS fonctionne comme réglé. Rien n’a été changé dans le lab.
À retenir — Pour relever une date dans un script ou une preuve, toujours l’écrire en
yyyy-MM-dd(norme ISO 8601). Et avant de conclure à une anomalie, relire la donnée brute autrement.
H-102 · Une règle de test ne laisse rien passer : un port source rempli par erreur
Symptôme — Le 12/11, pendant le test T21, la règle temporaire vers pfSense (TCP 5201) se lit dans pfctl -sr :
from 10.0.50.200 port = 5190 to (self) port = 5201 alors qu’elle devait autoriser tout port source.
Contexte — Axel venait d’ouvrir la règle pour y poser les limiteurs (Display Advanced). La page de règle de pfSense a
deux boutons « Display Advanced » : celui de la section Source affiche le Source Port Range ; celui de Extra Options
affiche les limiteurs (In / Out pipe).
Cause — Une valeur saisie dans Source Port Range en cherchant les options avancées. Or le port source d’un client est choisi au hasard à chaque connexion : une règle limitée à un port source ne laisse pratiquement rien passer.
Résolution — Source → Display Advanced → Source Port Range remis à any, Save, Apply ; contrôle :
pfctl -sr | grep 5201 → from 10.0.50.200 to (self) port = 5201 … dnpipe(1, 2). Détecté avant la mesure, par la relecture
de la règle appliquée.
À retenir — Après toute modification d’une règle, relire la règle appliquée (
pfctl -sr), pas seulement l’écran. Un port source n’a presque jamais de valeur fixe : on filtre sur le port de destination.
Annexe — Méthodes de diagnostic réutilisables
| Situation | Outil | Ce qu’il révèle |
|---|---|---|
| Une règle semble ignorée | colonne States de Firewall → Rules | 0/0 B alors que du trafic est généré = la règle ne correspond pas, ou une règle au-dessus l’intercepte |
| Un flux est refusé | Status → System Logs → Firewall | quelle règle a jeté le paquet, et pourquoi |
| L’IP marche, pas les noms | ping <IP> puis ping <nom> | isole le DNS du routage en deux commandes |
| Un service SSH refuse | ssh -v | quelle clé est présentée, et si le serveur l’accepte |
| Un paquet est introuvable | sortie de apt update | si le dépôt attendu est réellement interrogé |
| pfSense inaccessible | console Proxmox | accès hors-bande ; options 2 (IP), 15 (restaurer la config), 8 (shell) |
| Un ping échoue dans un seul sens | ping inverse | distingue un blocage réseau d’un pare-feu d’hôte |
| Tailscale ne joint rien | tailscale status | tx/rx non nuls = le tunnel marche, le blocage est ailleurs |
| Une interface système est invisible dans l’UI | ifconfig <nom> | confirme son existence, son état et ses groupes pf |
| Vérifier qu’une règle est bien fermée | le protocole que la règle vise — curl/nc -zv pour du TCP, ping pour de l’ICMP | un ping ne teste jamais une règle TCP : le protocole fait partie du critère de correspondance |
| Distinguer Block de Reject | la nature de l’échec | silence puis délai d’attente = Block (implicite) · erreur immédiate = Reject explicite |
| Le « timeout » vient-il du réseau ou de l’application ? | nc -zv <ip> <port> en parallèle du client applicatif | un client (Termix, navigateur…) journalise « Connection timeout » aussi bien pour un TCP jamais établi que pour une négociation bloquée après connexion. Seul un test sur la couche transport tranche. Voir H-10. |
| Un service a-t-il démarré au boot ? | uptime -s comparé au Active: since de systemctl status | même heure = démarrage automatique ; heure postérieure = lancé à la main |
| Un service est-il joignable depuis le réseau ? | sudo ss -tlnp | grep <port> | l’adresse d’écoute : 127.0.0.1 = local seulement, une IP de VLAN = joignable |
| D’où part réellement mon test ? | SourceAddress et InterfaceAlias de Test-NetConnection · sous Linux ip route get <dest> | une machine multi-domiciliée (2 cartes, VPN, tunnel) choisit sa route selon la destination — pas forcément celle qu’on imagine. Un test lancé depuis la mauvaise interface ne mesure pas ce que l’on croit. |