


Mode opératoire — Sauvegarder les machines virtuelles d’un lab sur Proxmox, et prouver qu’on sait les restaurer
Document autonome. Partie théorique, puis mise en œuvre telle qu’elle a été réalisée et vérifiée sur l’hyperviseur Proxmox de l’école (phase 13 du suivi). La méthode vaut pour toute infrastructure virtualisée sous Proxmox VE dont on dispose d’un stockage réseau. Le contexte de l’infrastructure est dans Documentation-pfSense.md (étape 43) ; l’accès externe au lab, traité à part, est dans MO-10-Pangolin.md.
Valeurs masquées. Aucun mot de passe ni identifiant n’apparaît ici.
Dernière mise à jour : 15/10/2026 — la première exécution automatique est contrôlée (§8)
Suite, depuis le 15/10 : la tâche planifiée envoie désormais ses sauvegardes à un Proxmox Backup Server (sauvegardes incrémentales, rétention faite par PBS) : voir MO-12-Proxmox-Backup-Server.md. Ce MO reste la référence pour les principes (mode
snapshot, sauvegarde par pool, test de restauration).
Sommaire
| § | Contenu |
|---|---|
| 1 | Le besoin et la situation de départ |
| 2 | Théorie : ce qu’est une sauvegarde de VM, et ce qu’elle n’est pas |
| 3 | État des lieux avant de construire |
| 4 | Première sauvegarde, à la main, d’une seule VM |
| 5 | Le test de restauration |
| 6 | Remettre le lab en état |
| 7 | La tâche planifiée |
| 8 | Vérifier la première exécution automatique |
| 9 | Pièges et checklist |
1 · Le besoin et la situation de départ
1.1 Pourquoi
| Constat | Source |
|---|---|
| L’annexe II.E de l’épreuve exige une solution de sauvegarde (obligatoire) ; un environnement non conforme peut coûter jusqu’à −15 points | cours du formateur |
| Il n’existait que des exports manuels de la configuration du pare-feu et des instantanés manuels | documentation d’architecture, §8.4 |
| Le cluster de bases de données n’est pas une sauvegarde : une erreur se réplique sur les trois nœuds en quelques millisecondes | idem |
| Objectif posé : une sauvegarde complète, automatique et testée, pour ne pas être surpris par une perte | demande du 14/10 |
1.2 La situation technique
| Élément | Valeur relevée |
|---|---|
| Hyperviseur | Proxmox VE 9.1.2, nœud pve-01, partagé avec d’autres élèves (plusieurs pools de ressources) |
| Les machines à protéger | les 11 VM du pool SIO2527_Axel |
| Un stockage réseau déjà déclaré | Syno, type NFS, point de montage /mnt/pve/NAS-01, partagé, actif, contenu « Backup » autorisé |
| Place | 766,33 Go utilisés sur 2,87 To (26,7 %), soit environ 2,1 To libres ; le NAS est partagé avec d’autres usages de l’école |
| Tâches de sauvegarde existantes | aucune (Datacenter → Backup est vide) |
2 · Théorie : ce qu’est une sauvegarde de VM, et ce qu’elle n’est pas
2.1 Le mécanisme : vzdump
Proxmox sauvegarde une VM avec l’outil vzdump : il lit les disques de la VM et écrit une archive (un fichier)
sur un stockage. Pour une VM, l’archive est au format vma, ici compressée en zstd (.vma.zst).
2.2 Les trois modes
| Mode | Principe | Coupure |
|---|---|---|
stop | éteint la VM, copie, rallume | oui, pendant toute la copie |
suspend | met la VM en pause pendant la copie | oui |
snapshot | fige un instant des disques et copie cet instant pendant que la VM continue de tourner | non, ou de l’ordre de la seconde |
C’est le mode retenu : le lab reste en service.
2.3 La cohérence : ce que « snapshot » garantit et ne garantit pas
Si la VM a l’agent invité (qemu-guest-agent) actif, Proxmox lui demande de geler brièvement le système de
fichiers (fs-freeze) avant l’instant, puis de le dégeler (fs-thaw). La sauvegarde est alors cohérente côté
fichiers. Sans agent, elle est dite « cohérente après plantage » : comme si la machine avait été coupée net.
Les bases de données redémarrent presque toujours seules après un arrêt brutal, mais ce n’est pas une garantie. Pour des bases importantes, un export logique (un fichier SQL produit par le serveur lui-même) est une protection complémentaire. Il n’est pas fait ici.
2.4 La rétention : combien de temps garder
On ne garde pas tout : l’espace est limité. La rétention règle ce qui est supprimé automatiquement.
| Réglage | Sens |
|---|---|
Keep Daily = 7 | garder la dernière sauvegarde de chacun des 7 derniers jours |
Keep Weekly = 4 | garder la dernière sauvegarde de chacune des 4 dernières semaines |
Une semaine permet de revenir sur une erreur récente, un mois sur une erreur découverte tard.
2.5 La règle 3-2-1, et pourquoi elle compte ici
Trois copies des données, sur deux supports différents, dont une hors site. Une sauvegarde qui partage son support avec la donnée ne protège pas contre la panne de ce support.
2.6 Une sauvegarde jamais restaurée n’est pas une sauvegarde
Seule une restauration réussie prouve que l’archive est exploitable. C’est pourquoi le §5 vient avant la tâche planifiée (§7).
3 · État des lieux avant de construire
Rien n’est créé dans cette partie : on lit.
| Où dans Proxmox | Ce que je vérifie | Constaté |
|---|---|---|
| Datacenter → Storage | Y a-t-il un stockage qui accepte les sauvegardes ? | Syno (NFS), contenu « Backup » inclus |
Datacenter → Storage → Syno → Summary | Place disponible | 26,7 % utilisés sur 2,87 To |
| Datacenter → Backup | Une tâche existe-t-elle déjà ? | liste vide |
Datacenter → Pools → SIO2527_Axel → Members | Quelles VM sont à moi ? | 11 VM en marche |
Hyperviseur partagé : ne sauvegarder que son pool. La liste des VM visibles contient celles des autres élèves. Une tâche réglée sur « All » les sauvegarderait toutes sur le NAS commun.
4 · Première sauvegarde, à la main, d’une seule VM
Avant d’automatiser, on mesure sur une machine : taille, durée, comportement.
4.1 Lancer
Choisir une VM simple et peu critique (ici srv-web-01, VM 110). Dans Proxmox : clic sur la VM → onglet Backup
→ Backup now.
| Champ | Valeur |
|---|---|
| Storage | Syno |
| Mode | Snapshot |
| Compression | ZSTD (fast and good) |
| Protected | décoché |
La commande réellement exécutée figure en première ligne du journal :
vzdump 110 --remove 0 --mode snapshot --notes-template '{{guestname}}' --node pve-01 --compress zstd --notification-mode notification-system --storage Syno
4.2 Lire le journal
| Ce que je cherche | Ce qui a été lu |
|---|---|
| Fin réussie | Backup job finished successfully, TASK OK |
| Gel du système de fichiers | issuing guest-agent 'fs-freeze' command puis fs-thaw : l’agent fonctionne |
| Taille et durée | 32 Go lus en 653 s (50,2 Mo/s), durée totale 10 min 58 s |
| Taille de l’archive | 3,58 Go (/mnt/pve/NAS-01/dump/vzdump-qemu-110-….vma.zst) |
| Données vides | backup is sparse: 23.20 GiB (72%) total zero data : c’est ce qui rend l’archive petite |
Validation : l’archive apparaît dans Stockage Syno → Backups.
non déposée : le journal de la tâche (fichier texte conservé par Axel).
4.3 Deux lignes d’avertissement à comprendre
WARN: 'root@pam' does not have a configured email address ...
ERROR: could not notify via target `mail-to-root` ...
La sauvegarde est réussie (TASK OK) : seul l’envoi du courriel de rapport échoue, faute d’adresse. Mais cela
veut dire qu’une sauvegarde qui échouerait ne préviendrait personne.
5 · Le test de restauration
On restaure l’archive en une nouvelle VM, sans toucher à la VM d’origine.
5.1 Lancer
Stockage Syno → Backups → clic sur l’archive → Restore.
| Champ | Valeur conseillée | Pourquoi |
|---|---|---|
| VM ID | un identifiant libre (Proxmox propose le prochain : 136 ici) | jamais l’identifiant de la VM d’origine : la restauration l’écraserait |
| Storage | un stockage de disques (ici storage-images) | ne pas encombrer le NAS de sauvegarde |
| Unique | à cocher | génère une nouvelle adresse MAC (voir le piège ci-dessous) |
| Start after restore | décoché | on débranche le réseau avant le premier démarrage |
5.2 Ce que montre le journal de restauration
| Mesure | Valeur |
|---|---|
| Durée | 200 s (3 min 20 s) pour 32 Go |
| Résultat | TASK OK |
| Nouveau disque | storage-images:vm-136-disk-0 |
| Données vides | 72,5 % |
La restauration est donc plus rapide que la sauvegarde (11 min).
5.3 Le piège : deux machines identiques
Avec les valeurs par défaut, la case Unique n’est pas cochée. La copie a alors la même adresse MAC et la même configuration réseau que la VM d’origine : démarrée sur le même réseau, elle provoquerait un conflit d’adresses (et, pour un contrôleur de domaine, des désordres plus graves). Parades, cumulables :
- cocher Unique à la restauration ;
- débrancher la carte réseau de la copie avant de la démarrer : Hardware → Network Device → Edit → Disconnect ;
- ou éteindre la VM d’origine pendant le test.
5.4 Vérifier que la copie est exploitable
Démarrer la copie, ouvrir sa Console, se connecter, puis vérifier ce qui prouve que la machine est
exploitable : son nom (hostname), que son service principal est actif, et que les données de l’application
sont présentes. Le contrôle exact dépend de la machine restaurée.
Résultat obtenu sur la VM d’essai : la copie démarre, avec son nom et ses données d’origine.
6 · Remettre le lab en état
À faire dans cet ordre :
- Arrêter la VM de test (136).
- Redémarrer la VM d’origine si elle a été éteinte pendant le test.
- Vérifier que le service répond : ici, la page de statistiques du répartiteur doit montrer le serveur web en vert.
- Supprimer la VM de test (clic droit → More → Remove, en laissant cochée la destruction de ses disques) : sinon ses 32 Go restent occupés.
Redémarrer la VM d’origine avant de supprimer la copie, au cas où l’on aurait encore besoin de cette dernière.
7 · La tâche planifiée
Datacenter → Backup → Add.
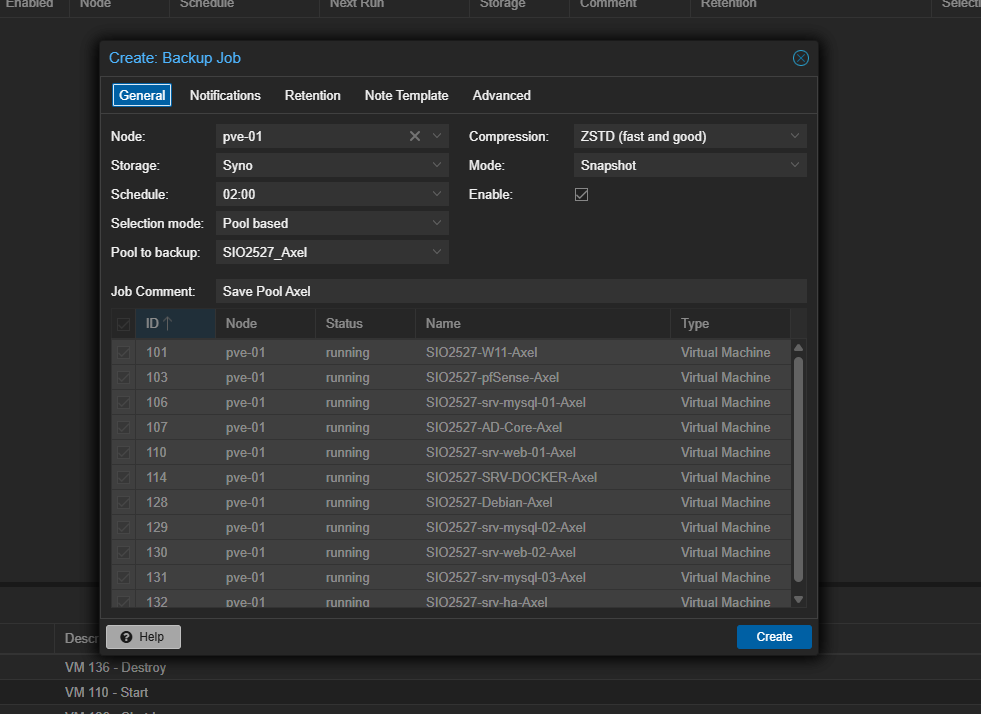
| Onglet | Champ | Valeur |
|---|---|---|
| General | Node | pve-01 |
| General | Storage | Syno |
| General | Schedule | 02:00 (chaque jour) |
| General | Selection mode | Pool based |
| General | Pool to backup | SIO2527_Axel |
| General | Job Comment | Save Pool Axel |
| General | Mode / Compression | Snapshot / ZSTD (fast and good) |
| General | Enable | coché |
La liste affichée par l’assistant doit montrer exactement les 11 VM du pool.
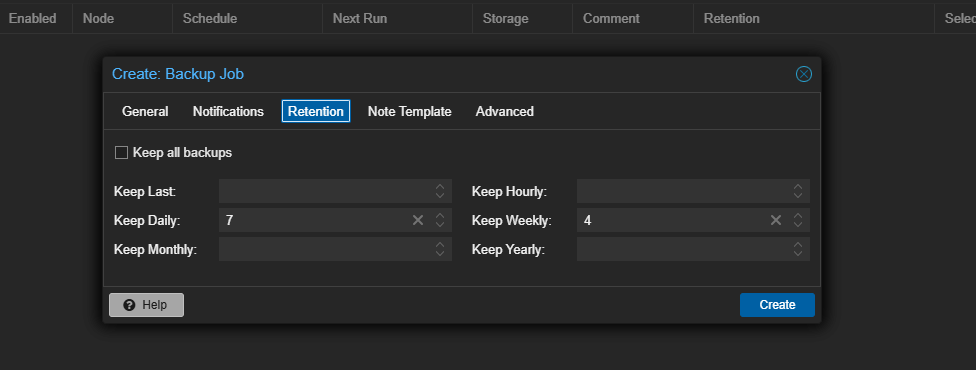
| Onglet | Champ | Valeur |
|---|---|---|
| Retention | « Keep all backups » | décoché |
| Retention | Keep Daily | 7 |
| Retention | Keep Weekly | 4 |
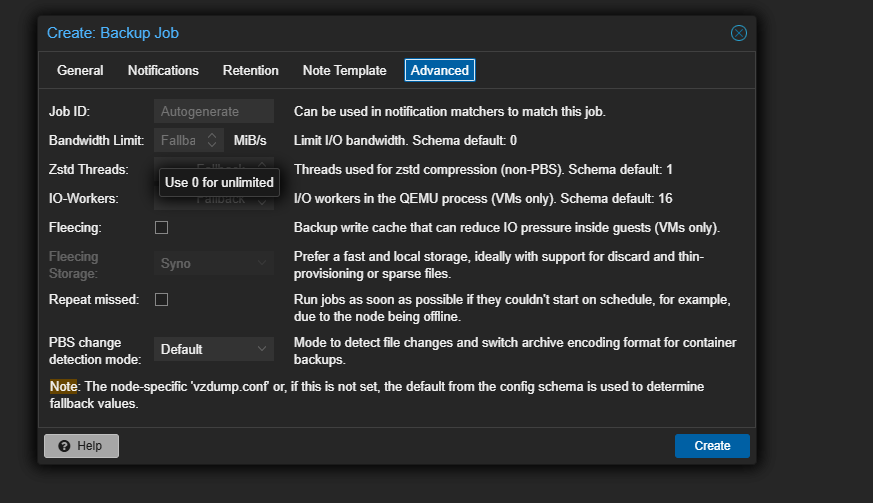
| Onglet | Champ | Valeur |
|---|---|---|
| Advanced | tous les champs | valeurs par défaut |
| Advanced | Repeat missed | coché (décision finale ; la capture 68 a été prise avant, case encore décochée) |
Pourquoi « Pool based » : la tâche ne sauvegarde que les VM du pool, et toute VM ajoutée ensuite est incluse sans modifier la tâche. Avec « All », les VM de tous les élèves partiraient sur le NAS commun.
« Repeat missed » relance la tâche dès que possible si l’hyperviseur était éteint à l’heure prévue. Décochée, la sauvegarde de cette nuit-là est perdue sans rattrapage. Cochée (choix retenu), elle peut démarrer en journée après un redémarrage.
Validation : une ligne apparaît dans Datacenter → Backup avec la colonne Next Run (le prochain 02:00), le
stockage Syno et la rétention.
Notifications : l’envoi de courriel échoue (§4.3). Ne pas renseigner d’adresse sur
root@pam: c’est le compte administrateur partagé de l’hyperviseur.
8 · Vérifier la première exécution automatique (15/10/2026)
La tâche s’est exécutée seule la nuit suivant sa création. Le journal de la tâche (Datacenter → Backup, ou le panneau Tasks, bouton de téléchargement du journal) donne tout ce qu’il faut contrôler.
8.1 Ce qui a été contrôlé
| Contrôle | Constaté |
|---|---|
| La tâche s’est lancée à l’heure | début 02:00:03 |
| Fin réussie | Backup job finished successfully, TASK OK, à 04:25:39 (soit 2 h 25 au total) |
| Les 11 VM du pool sont traitées | oui, une par une, dans l’ordre de leur numéro |
| Les réglages sont ceux voulus | le journal commence par vzdump --prune-backups 'keep-daily=7,keep-weekly=4' --mode snapshot --storage Syno --node pve-01 --pool SIO2527_Axel … |
| La rétention est appliquée | prune older backups with retention: keep-daily=7, keep-weekly=4, puis pruned 0 backup(s) : normal, c’est la première exécution |
| Aucune erreur bloquante | seulement les trois lignes détaillées au §8.3 |
8.2 Taille et durée de chaque VM
| VM | Disque lu | Archive | Durée |
|---|---|---|---|
| 101 poste Windows | 100 Go | 41,28 Go | 10 min 02 |
| 103 pare-feu | 32 Go | 1,77 Go | 7 min 41 |
| 106 base de données 1 | 100 Go | 994 Mo | 20 min 39 |
| 107 contrôleur de domaine | 64 Go | 13,90 Go | 40 min 16 |
| 110 serveur web 1 | 32 Go | 3,58 Go | 10 min 39 |
| 114 bastion | 150 Go | 5,46 Go | 28 min 48 |
| 128 Debian | 53 Go | 783 Mo | 1 min 36 |
| 129 base de données 2 | 100 Go | 1,01 Go | 1 min 16 |
| 130 serveur web 2 | 32 Go | 3,66 Go | 1 min 22 |
| 131 base de données 3 | 100 Go | 1,01 Go | 1 min 16 |
| 132 répartiteur | 32 Go | 1,47 Go | 22 min 01 |
| Total | ≈ 75 Go par nuit | 2 h 25 |
- L’estimation faite avant (≈ 40 Go par nuit) était trop basse : elle extrapolait une seule mesure, un petit serveur web. Le poste Windows et le contrôleur de domaine pèsent à eux deux plus de 55 Go.
- Avec la rétention (jusqu’à 11 versions conservées), l’ordre de grandeur monte à ≈ 0,8 To, pour environ 2,1 To libres au départ. Ce chiffre est une projection, à recontrôler après une semaine d’exécutions.
La durée dépend de l’endroit où se trouve le disque de la VM, pas de sa taille. Les VM dont le disque est sur le stockage local de l’hyperviseur sont sauvegardées en 1 à 2 minutes (plus d'1 Go/s). Celles dont le disque est sur le NAS prennent de 8 à 40 minutes (25 à 90 Mo/s) : la machine lit et écrit sur le même NAS.
8.3 Ce que le journal signale
| Ligne | Sens |
|---|---|
VM 101 : skipping guest-agent 'fs-freeze', agent configured but not running? | l’agent invité est configuré mais ne tourne pas dans Windows : le système de fichiers n’est pas gelé, la sauvegarde est « cohérente après plantage » |
VM 103 : ERROR: unable to freeze guest fs - failed to freeze /: Resource deadlock avoided | le gel du système de fichiers a échoué, la sauvegarde a continué (même niveau de cohérence) et s’est terminée |
WARN: 'root@pam' does not have a configured email address … puis could not notify via target mail-to-root | l’envoi du courriel de rapport échoue, comme à l’essai (§4.3) |
Aucune de ces lignes n’a empêché la tâche de se terminer (TASK OK) : une tâche peut se terminer avec succès alors
que le gel d’une VM a échoué ; c’est donc le journal, pas seulement le statut final, qu’il faut lire.
8.4 Reste à contrôler
| Contrôle | Où | État |
|---|---|---|
| Les 11 archives datées du 15/10 sont présentes | Stockage Syno → Backups | non vu dans ce relevé (le journal indique la taille de chaque archive) |
| La rétention supprime bien les anciennes | journal, après plus de 7 jours : pruned N backup(s) avec N supérieur à 0 | |
| L’espace consommé sur le NAS | Syno → Summary |
9 · Pièges et checklist
| Piège | Conséquence | Où |
|---|---|---|
| Restaurer sur l’identifiant de la VM d’origine | écrasement de la VM en service | §5.1 |
| Ne pas cocher « Unique » et démarrer en réseau | conflit d’adresses MAC et IP | §5.3 |
| Tâche réglée sur « All » sur un hyperviseur partagé | sauvegarde de toutes les VM de tous les élèves | §3, §7 |
| Supprimer la copie de test avant d’avoir redémarré l’originale | plus de repli | §6 |
| Notifications non configurées | un échec ne prévient personne | §4.3 |
 Un stockage de sauvegarde existe et a de la place
 Une sauvegarde manuelle d'UNE VM réussie, taille et durée relevées
 Une restauration réussie vers un NOUVEL identifiant, réseau débranché ou MAC unique
 La copie restaurée démarre et ses données applicatives sont présentes
 La copie de test supprimée, la VM d'origine redémarrée et vérifiée
 Tâche planifiée en mode « Pool based », sur le bon pool uniquement
 Rétention réglée, « Keep all backups » décoché
 La première exécution automatique contrôlée (§8)
La règle à retenir en une phrase
Une sauvegarde ne vaut que par la restauration qu’on a réussie : on mesure sur une machine, on restaure sous un autre identifiant en isolant le réseau, et seulement ensuite on automatise, sur son pool uniquement.