


Mode opératoire — Sauvegardes incrémentales avec Proxmox Backup Server (PBS)
Document autonome. Partie théorique, puis mise en œuvre telle qu’elle a été réalisée et vérifiée le 15/10/2026 sur l’hyperviseur Proxmox de l’école (phase 13 du suivi, tâche 13.9). La méthode vaut pour toute infrastructure Proxmox VE qui veut des sauvegardes incrémentales et dédupliquées. Il prend la suite de MO-11-Sauvegarde-Proxmox.md (sauvegarde
vzdumpvers un NAS), dont il reprend les principes (modesnapshot, sauvegarde par pool, test de restauration). Le contexte de l’infrastructure est dans Documentation-pfSense.md (étape 44) ; la règle de pare-feu est dans Matrice-de-flux.md (§4.5 et §5).Valeurs masquées. Aucun mot de passe ni secret de jeton n’apparaît ici.
Dernière mise à jour : 06/11/2026 — ajout du §13.4.7 (restaurer depuis la copie S3) ; 05/11/2026 — ajout du §13.4 (copie hors site sur un datastore S3) ; 27/10/2026 — ajout du §13.1 (notifications par mail), du §13.2 (gel des systèmes de fichiers) et du §13.3 (machines Windows)
Sommaire
| § | Contenu |
|---|---|
| 1 | Le besoin : pourquoi quitter les copies complètes |
| 2 | Théorie : blocs, déduplication, incrémental, rétention |
| 3 | L’architecture retenue |
| 4 | Créer la VM |
| 5 | Installer PBS |
| 6 | Préparer le système |
| 7 | Le datastore |
| 8 | Un compte et un jeton dédiés, avec le minimum de droits |
| 9 | Ouvrir le chemin dans pfSense |
| 10 | Déclarer PBS dans Proxmox, puis une première sauvegarde |
| 11 | Le test de restauration |
| 12 | La rétention côté PBS, et la tâche planifiée |
| 13 | Contrôler chaque matin ; être prévenu par mail ; le gel des systèmes de fichiers ; les machines Windows |
| 13.4 | Une copie hors site : un datastore S3 sur un autre site (règle 3-2-1) |
| 14 | Pièges et checklist |
1 · Le besoin : pourquoi quitter les copies complètes
La première solution (MO-11) envoie chaque nuit une archive complète de chaque VM sur le NAS de l’école. Mesures relevées :
| Constat | Valeur |
|---|---|
| Volume écrit chaque nuit | ≈ 75 Go pour 11 VM (2 h 25) |
| Croissance du NAS en une nuit | ≈ +85 Go |
| Deux archives successives d’une VM inchangée | identiques à l’octet : tout est recopié |
| Projection avec la rétention | ≈ 0,8 To |
Chaque nuit recopie donc ce qui n’a pas changé. Proxmox Backup Server ne stocke que ce qui est nouveau.
2 · Théorie : blocs, déduplication, incrémental, rétention
2.1 Les blocs et la déduplication
PBS découpe chaque disque en blocs (chunks) de 4 Mio et les range par leur empreinte (un calcul qui donne le même résultat pour un contenu identique). Un bloc déjà présent dans le stockage n’est jamais réécrit : la sauvegarde se contente d’y faire référence.
Conséquences :
- deux sauvegardes d’une même VM partagent tous leurs blocs inchangés ;
- deux VM clonées du même modèle partagent leurs blocs communs ;
- les zones vides d’un disque se résument à un seul bloc « zéro ».
Chaque sauvegarde reste complète : on peut restaurer n’importe laquelle sans « rejouer » les précédentes. Ce n’est pas un enchaînement de différences fragile, c’est un index qui pointe vers des blocs partagés.
2.2 L’incrémental rapide : la carte des blocs modifiés
Pendant que la VM tourne, Proxmox note les zones du disque modifiées depuis la dernière sauvegarde (dirty bitmap). La sauvegarde suivante ne lit que ces zones.
Cette carte est perdue quand la VM s’arrête (arrêt, redémarrage, migration). La sauvegarde suivante relit alors tout le disque : plus longue, mais elle n’écrit toujours que les blocs nouveaux.
2.3 Le vocabulaire de PBS
| Terme | Sens |
|---|---|
| Datastore | l’espace de stockage des sauvegardes, un répertoire sur un disque formaté |
| Groupe | toutes les sauvegardes d’une même machine (ex. vm/110) |
| Instantané (snapshot) | une sauvegarde datée dans un groupe |
| Prune | décide quels instantanés garder selon la rétention, et retire les autres de l’index |
| Garbage Collection (GC) | supprime réellement les blocs que plus aucun instantané n’utilise : c’est elle qui libère l’espace |
| Verify | relit les blocs et contrôle qu’ils ne sont pas abîmés |
Prune ne libère pas d’espace, la GC si. Et la GC ne supprime un bloc que s’il n’a pas servi depuis plus de 24 h 05 : l’espace occupé baisse donc avec un jour de décalage.
2.4 Les droits : qui envoie, qui supprime
Proxmox se connecte à PBS avec un jeton d’API (un identifiant + un secret). On lui donne le rôle
DatastoreBackup : il peut créer des sauvegardes et lire les siennes, mais pas en supprimer.
Conséquence voulue : si l’hyperviseur était compromis, l’attaquant ne pourrait pas effacer l’historique des sauvegardes. La rétention (la suppression des anciennes) est donc confiée à PBS lui-même (§12).
2.5 Le chiffrement côté client
PBS sait chiffrer les sauvegardes avant leur envoi, avec une clé gardée par le client. Non retenu ici (décision du 15/10) : sans la clé, aucune restauration n’est possible, et la perte de la clé rendrait toutes les sauvegardes inutilisables.
3 · L’architecture retenue
   Réseau de l'école (10.1.0.0/16)                        Lab (derrière pfSense)
  ┌────────────────────────────┐                   ┌──────────────────────────────────┐
  │ Hyperviseur pve-01         │   TCP 8007        │ pfSense                          │
  │ 10.1.0.253                 │ ────────────────► │ WAN 10.1.0.197                   │
  │ (lance les sauvegardes)    │  vers 10.1.0.197  │   redirection 8007 ──┐           │
  └────────────────────────────┘                   │                      ▼           │
                                                   │ VLAN 30 ADM   srv-pbs 10.0.30.13 │
                                                   │                PBS 4.2.8         │
                                                   └──────────────────┬───────────────┘
                                                                      │ disque de données
                                                                      ▼ 500 Go (ext4)
                                                              NAS de l'école « Syno »
| Point | Choix | Pourquoi |
|---|---|---|
| Où tourne PBS | une VM dans le VLAN 30 (ADM), adresse fixe 10.0.30.13 | zone d’administration ; adresse dans le bloc « serveurs à IP fixe » .10→.49 |
| Comment l’hyperviseur le joint | par l’adresse WAN de pfSense (10.1.0.197:8007), redirigée vers PBS | l’hyperviseur est côté WAN et ne connaît pas les réseaux du lab |
| Où sont les sauvegardes | un disque virtuel de 500 Go posé sur le NAS Syno, formaté en ext4 dans PBS | PBS exige un vrai système de fichiers ; le NAS est séparé des disques des VM |
| Où sont les disques des VM | sur storage-images (miroir ZFS de 2 × 6 To de l’hyperviseur) | la donnée et sa sauvegarde ne partagent plus de support |
4 · Créer la VM
Proxmox → Create VM, avec l’ISO proxmox-backup-server_4.2-1.iso (empreinte SHA-256 vérifiée contre celle
publiée par l’éditeur avant usage).
| Onglet | Champ | Valeur |
|---|---|---|
| General | Nom | SIO2527-srv-PBS-Axel (VM 137) ; hors du pool sauvegardé (voir l’encadré ci-dessous) |
| System | Machine / BIOS / SCSI | q35 / SeaBIOS / VirtIO SCSI single ; Qemu Agent coché |
| Disks | disque 1 (système) | 32 Gio sur storage-images |
| Disks | disque 2 (données) | 500 Gio sur Syno, « Backup » décoché |
| CPU | 1 socket × 4 cœurs, type host | |
| Memory | 6144 Mio, ballooning, minimum 2048 Mio | |
| Network | VirtIO, bridge du trunk, étiquette VLAN 30, pare-feu Proxmox décoché |
« Backup » décoché sur le disque de données. Sans cette case, une sauvegarde de la VM PBS recopierait le datastore dans lui-même.
La VM PBS ne doit pas être dans le pool que la tâche sauvegarde. Laissée dans le pool, elle a fait échouer la tâche de la première nuit :
backup connect failed: command error: http upgrade request timed out(cause probable : la tâche veut se connecter à un serveur PBS qui se trouve dans la machine qu’elle est en train de geler). Les 11 autres VM étaient sauvegardées, mais la tâche se terminait enTASK ERROR: une erreur permanente masque les vraies pannes. Parade retenue : retirer la VM du pool (Datacenter → Permissions → Pools → pool → Members → VM → Remove). La sauvegarde de la VM PBS elle-même est d’ailleurs peu utile : son disque de données est exclu, et on la réinstalle en quelques minutes en rattachant le datastore (non testé).
La documentation de PBS recommande 4 Gio de RAM + 1 Gio par To stocké : le minimum de 2 Gio est en dessous, choix assumé (hyperviseur partagé, RAM limitée).
5 · Installer PBS
Démarrer la VM sur l’ISO et suivre l’installateur graphique.
| Écran | Valeur | Attention |
|---|---|---|
| Disque cible | le disque de 32 Gio | pas celui de 500 Gio : il serait effacé et deviendrait le système |
Mot de passe root et e-mail | un mot de passe fort, conservé dans le gestionnaire de mots de passe | |
| Réseau | adresse 10.0.30.13/24, passerelle 10.0.30.1, DNS 10.0.30.1, nom srv-pbs | le VLAN 30 n’a pas de DHCP : tout se saisit |
Avant de valider l’adresse :
ping 10.0.30.13depuis une machine du lab ne doit pas répondre (adresse libre).
Après le redémarrage, retirer l’ISO du lecteur (Hardware → CD/DVD → Do not use any media).
Validation : la console affiche l’adresse https://10.0.30.13:8007/.
6 · Préparer le système
Connexion en SSH (le lab est joignable par Tailscale depuis le poste de travail).
6.1 Les dépôts de mises à jour
Sans abonnement, le dépôt « entreprise » configuré par défaut refuse l’accès. On le désactive et on active le dépôt communautaire :
| Fichier | Contenu |
|---|---|
/etc/apt/sources.list.d/pbs-enterprise.sources | ajouter la ligne Enabled: no |
/etc/apt/sources.list.d/pbs-no-subscription.sources (nouveau) | Types: deb · URIs: http://download.proxmox.com/debian/pbs · Suites: trixie · Components: pbs-no-subscription · Signed-By: /usr/share/keyrings/proxmox-archive-keyring.gpg |
apt update
apt full-upgrade
apt update se termine sans erreur 401. La mise à jour installe un nouveau noyau : un redémarrage est
nécessaire (fait au §6.2).
6.2 L’agent invité
apt install qemu-guest-agent
Le message static unit, not starting it est normal. Dans Proxmox : VM → Options → QEMU Guest Agent → Enabled,
puis Shutdown et Start de la VM (un simple redémarrage depuis l’intérieur ne suffit pas à brancher le canal).
systemctl status qemu-guest-agent → active (running) ; dans Proxmox, le résumé de la VM affiche son adresse IP.
6.3 Un compte d’administration et la fermeture de root en SSH
- Créer un compte nominatif, l’ajouter au groupe
sudo, y déposer sa clé publique SSH (méthode : MO-4). - Vérifier la connexion par clé avec ce compte, dans une nouvelle session (l’appartenance au groupe
sudon’est prise en compte qu’à la connexion suivante). - Seulement ensuite, interdire
rooten SSH :
echo "PermitRootLogin no" | sudo tee /etc/ssh/sshd_config.d/00-no-root.conf
sudo sshd -t && sudo systemctl reload ssh
sudo sshd -T | grep permitrootlogin      # attendu : permitrootlogin no
Pourquoi
00-dans le nom : pour une option donnée, SSH garde la première valeur lue ; les fichiers du dossier sont lus par ordre alphabétique.00-passe avant tout autre fichier qui dirait le contraire.
ssh [email protected] → Permission denied.
L’interface web, elle, reste accessible avec
root@pam: c’est l’accès d’administration de PBS.
7 · Le datastore
Interface web https://10.0.30.13:8007, compte root@pam.
Administration → Storage / Disks : le disque de 500 Go apparaît en unused.
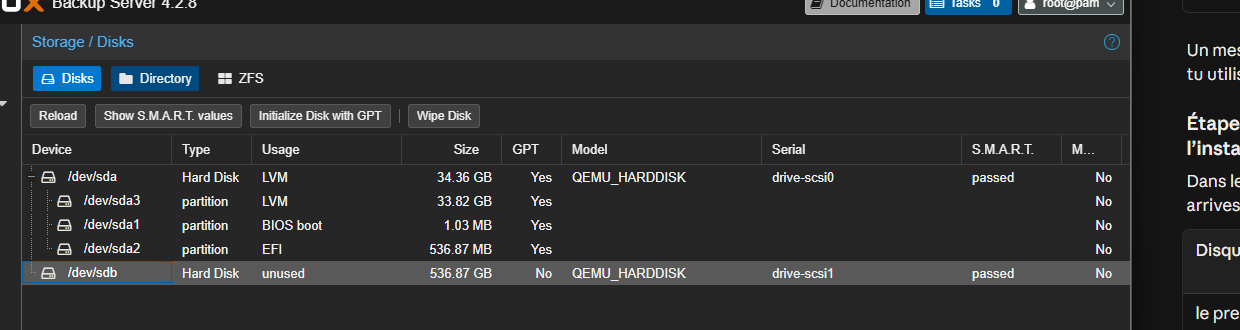
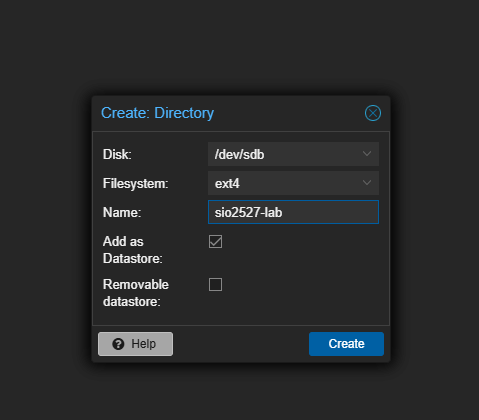
Storage / Disks → Directory → Create: Directory
| Champ | Valeur |
|---|---|
| Disk | /dev/sdb (le disque de 500 Go, unused) |
| Filesystem | ext4 |
| Name | sio2527-lab |
| Add as Datastore | coché |
| Removable datastore | décoché |
Validation : sio2527-lab apparaît dans le menu de gauche, sous Datastore, avec ≈ 500 Go disponibles.
8 · Un compte et un jeton dédiés, avec le minimum de droits
Configuration → Access Control.
| Étape | Où | Valeur |
|---|---|---|
| 1. L’utilisateur | User Management → Add | backup-pve01, realm pbs, activé, sans expiration |
| 2. Le jeton | API Token → Add | utilisateur backup-pve01@pbs, nom pve01, privilege separation coché |
| 3. Le secret | fenêtre affichée une seule fois | à copier immédiatement dans le gestionnaire de mots de passe |
| 4. Les droits | Datastore sio2527-lab → Permissions → Add | rôle DatastoreBackup, chemin /datastore/sio2527-lab, propagate, pour l’utilisateur ET pour le jeton |
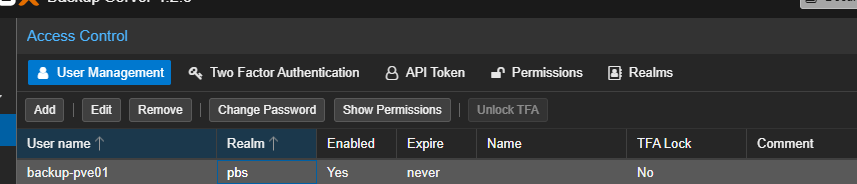
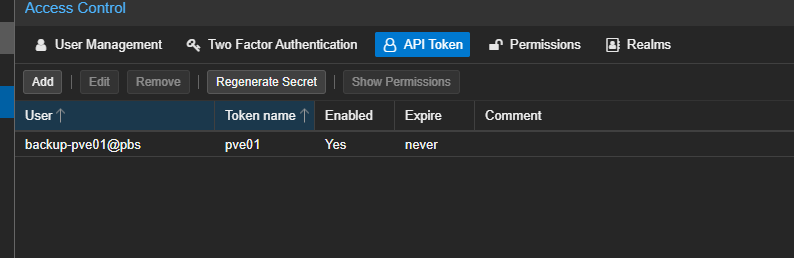
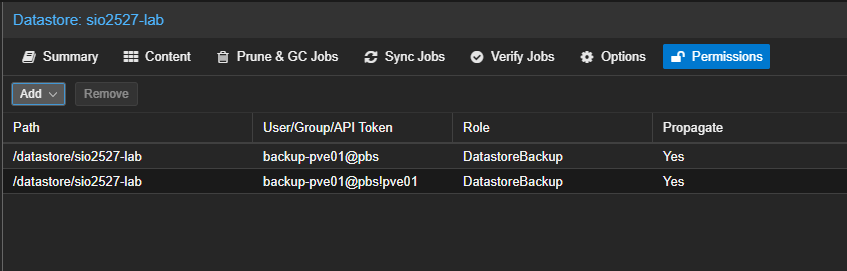
Les droits sur les deux. Avec la privilege separation, le jeton n’a que l’intersection de ses droits et de ceux de son utilisateur. Un droit posé sur un seul des deux donne un refus d’accès.
Le secret du jeton ne se réaffiche jamais. Perdu, il faut le régénérer (Regenerate Secret) et le ressaisir dans Proxmox.
L’empreinte du certificat : Dashboard → Show Fingerprint. PBS utilise un certificat auto-signé ; Proxmox vérifiera cette empreinte à chaque connexion. Elle n’est pas secrète, on la copie pour le §10.
9 · Ouvrir le chemin dans pfSense
L’hyperviseur (10.1.0.253) est côté WAN : il doit viser l’adresse WAN de pfSense, qui redirige vers PBS.
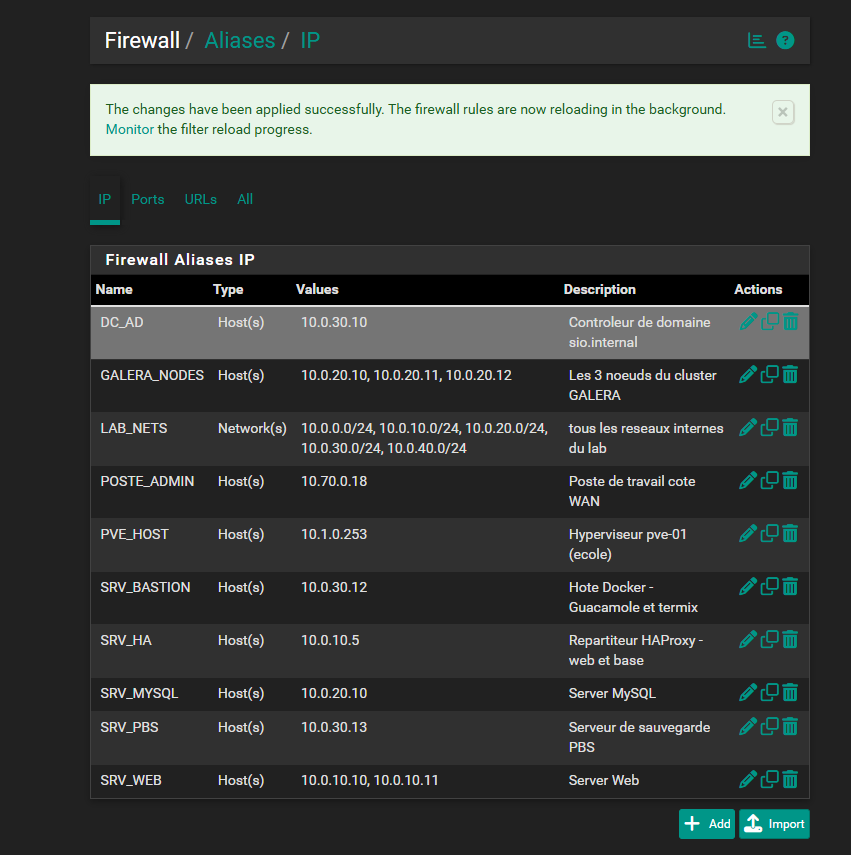
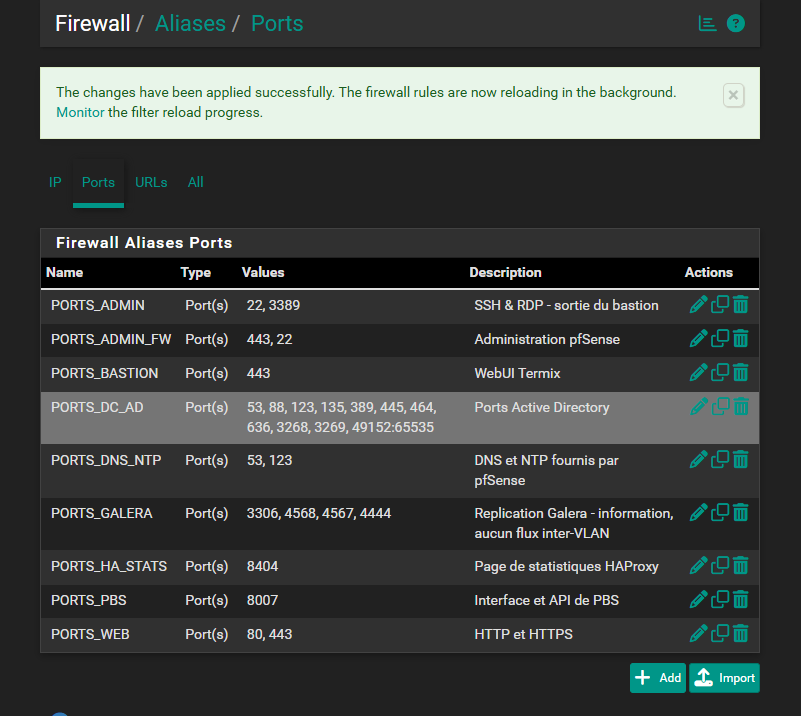
9.1 Trois alias (un alias = un usage)
| Où | Nom | Type | Valeur | Description |
|---|---|---|---|---|
| Firewall → Aliases → IP | PVE_HOST | Host(s) | 10.1.0.253 | Hyperviseur pve-01 (ecole) |
| Firewall → Aliases → IP | SRV_PBS | Host(s) | 10.0.30.13 | Serveur de sauvegarde PBS |
| Firewall → Aliases → Ports | PORTS_PBS | Port(s) | 8007 | Interface et API de PBS |
9.2 La redirection de port
Firewall → NAT → Port Forward → Add
| Champ | Valeur |
|---|---|
| Interface / Protocol | WAN / TCP |
| Source | PVE_HOST (Display Advanced pour faire apparaître le champ) |
| Destination / port | WAN address / PORTS_PBS |
| Redirect target IP / port | SRV_PBS / PORTS_PBS |
| Description | Sauvegardes PBS depuis pve-01 |
| Filter rule association | Add associated filter rule |
Save puis Apply Changes.
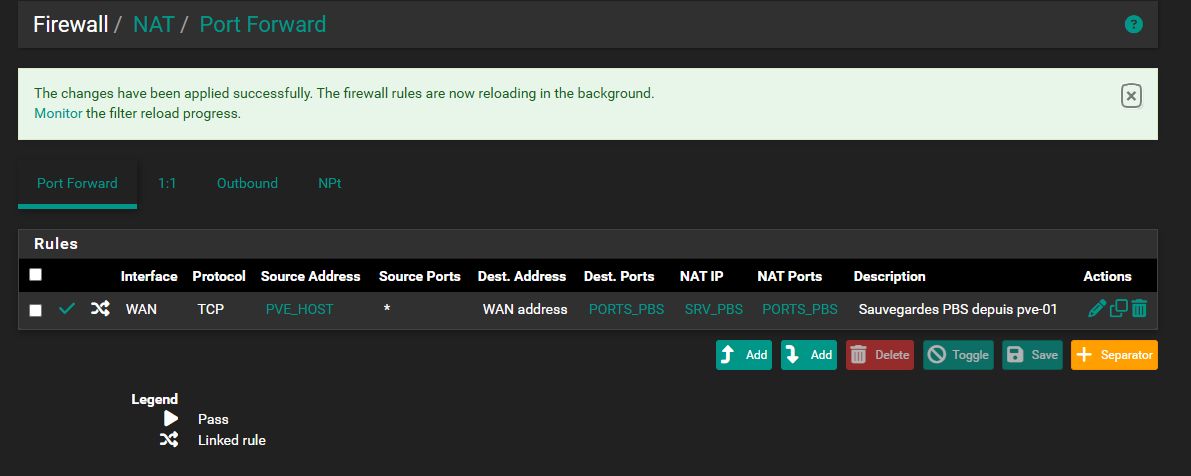
La source restreinte est l’essentiel. Sans elle, toute machine du réseau de l’école pourrait joindre l’interface de PBS. C’est la seule règle entrante du WAN : elle se justifie ligne par ligne.
Validation, depuis le shell de l’hyperviseur :
curl -k -s -o /dev/null -w "%{http_code}\n" https://10.1.0.197:8007/
Résultat obtenu : 200.
10 · Déclarer PBS dans Proxmox, puis une première sauvegarde
10.1 Le stockage
Proxmox → Datacenter → Storage → Add → Proxmox Backup Server
| Champ | Valeur |
|---|---|
| ID | pbs-lab-axel |
| Server | 10.1.0.197 (l’adresse WAN de pfSense, pas 10.0.30.13) |
| Username | backup-pve01@pbs!pve01 (l’utilisateur, !, le nom du jeton) |
| Password | le secret du jeton |
| Datastore | sio2527-lab |
| Nodes | pve-01 |
| Fingerprint | l’empreinte copiée au §8 |
| Encryption | Do not encrypt backups (§2.5) |
Validation : pbs-lab-axel apparaît dans l’arbre, statut actif, avec la place du datastore.
10.2 Première sauvegarde d’une VM, puis une seconde
VM → Backup → Backup now, stockage pbs-lab-axel, mode Snapshot. Puis, aussitôt après, une deuxième fois.
| Mesure (VM 110, disque de 32 Gio) | 1ʳᵉ sauvegarde | 2ᵉ sauvegarde |
|---|---|---|
| Carte des blocs modifiés | dirty-bitmap status: created new | dirty-bitmap status: OK (104.0 MiB of 32.0 GiB dirty) |
| Données lues | 32 Gio | 104 Mio |
| Réutilisé | 22,57 Gio (70 % : surtout des zones vides) | 31,91 Gio (99 %) |
| Durée | 1 min 33 s | 2 s |
| Résultat | TASK OK | TASK OK |
Pour comparaison, la même VM en archive complète vzdump vers le NAS : 10 min 58 s.
La ligne
skip unused drive … (not included into backup)concerne un ancien disque détaché : il n’est pas sauvegardé, c’est voulu.
11 · Le test de restauration
Stockage pbs-lab-axel → Backups → la sauvegarde → Restore.
| Champ | Valeur | Pourquoi |
|---|---|---|
| VM ID | un identifiant libre (139 ici) | jamais celui de la VM d’origine : elle serait écrasée |
| Storage | storage-images | |
| Unique | nouvelle adresse MAC | |
| Start after restore | décoché | débrancher la carte réseau avant le premier démarrage (MO-11 §5.3) |
| Mesure | Valeur |
|---|---|
| Sauvegarde restaurée | la deuxième (l’incrémentale de 2 s) : elle se restaure complète (§2.1) |
| Disque | 32 Gio, dont 69 % de zéros |
| Durée de l’image | 100,75 s (≈ 325 Mo/s) |
| Résultat | restore image complete, puis rescan volumes..., puis TASK OK |
Le piège : « restore image complete » n’est pas la fin. Après cette ligne, la tâche attend que le stockage ait réellement écrit les données sur les disques, puis écrit la configuration de la VM. Sur des disques mécaniques chargés, cela peut durer plusieurs minutes sans aucune ligne nouvelle. Ne pas cliquer sur « Stop » : la VM resterait verrouillée (
lock: create), incomplète, et serait à supprimer (§14). AttendreTASK OK.
Ensuite, comme au MO-11 §5.4 et §6 : démarrer la copie réseau débranché, vérifier qu’elle est exploitable, puis la supprimer (More → Remove, disques compris).
12 · La rétention côté PBS, et la tâche planifiée
12.1 La rétention (Prune)
Datastore sio2527-lab → Prune & GC Jobs → Prune Jobs → Add
| Champ | Valeur |
|---|---|
| Namespace / Max. Depth | Root / Full (tout le datastore) |
| Prune Schedule | 05:00 (après la fin des sauvegardes de la nuit) |
| Keep Daily | 7 |
| les autres Keep | vides |
| Enabled |
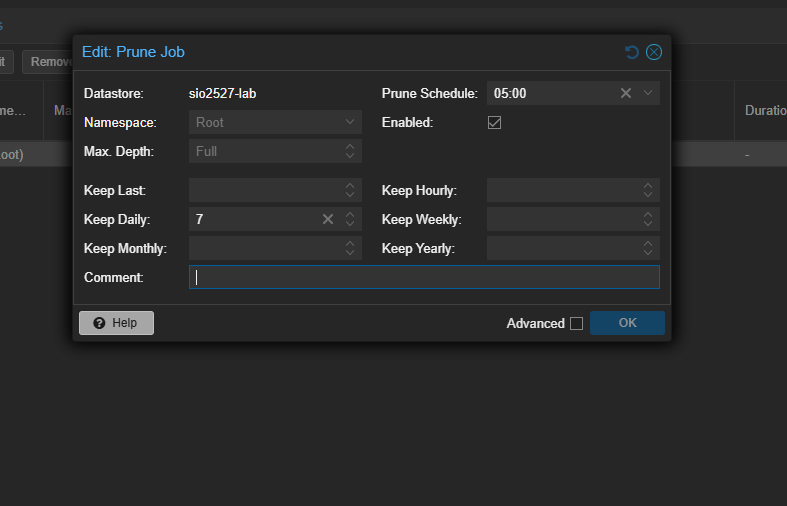
Résultat : 7 jours maximum, une sauvegarde par jour (la plus récente de chaque jour).
Prévisualiser sans rien supprimer : Content → le groupe d’une VM → icône ciseaux (Prune group). Saisir
Keep Daily = 7: la colonne de droite indique, pour chaque sauvegarde,keepouremove. Champs vides, tout s’affichekeep-all. Fermer la fenêtre par la croix : le bouton Prune supprime pour de vrai.
12.2 Garbage Collection et vérification
| Tâche | Où | Réglage |
|---|---|---|
| Garbage Collection | Prune & GC Jobs → Garbage Collect Jobs → Edit | 06:00 chaque jour (après le Prune de 05:00) |
| Verify | Verify Jobs → Add | samedi 10:00 ; Skip Verified = Yes ; Re-Verify After = 30 jours |
12.3 La tâche planifiée dans Proxmox
Datacenter → Backup → Add (ou Edit de la tâche existante) :
| Onglet | Champ | Valeur |
|---|---|---|
| General | Node / Storage | pve-01 / pbs-lab-axel |
| General | Schedule | 02:00 |
| General | Selection mode / Pool | Pool based / SIO2527_Axel |
| General | Mode | Snapshot |
| Retention | Keep all backups | coché |
| Advanced | Repeat missed | coché |
78-proxmox-tache-sauvegarde-pbs.png — la colonne Retention affiche keep-all=1.
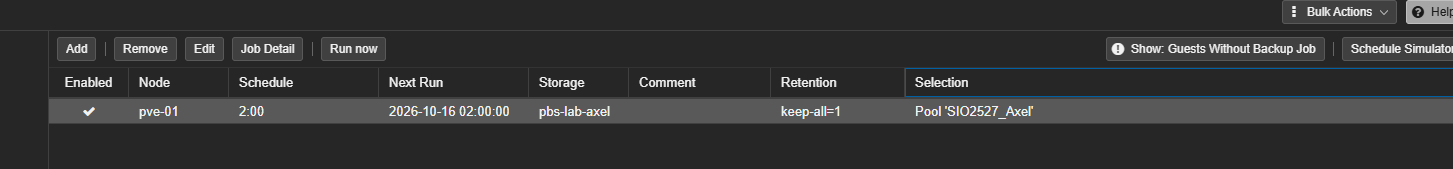
« Keep all backups » côté Proxmox. La rétention est faite par PBS (§12.1). Si Proxmox gardait sa propre rétention, il essaierait de supprimer d’anciennes sauvegardes avec un jeton qui n’en a pas le droit (§2.4) : la tâche se terminerait en erreur.
La chaîne d’une nuit :
| Heure | Où | Action |
|---|---|---|
| 02:00 | Proxmox | sauvegarde des VM du pool vers PBS |
| 05:00 | PBS | Prune : garder 7 jours |
| 06:00 | PBS | Garbage Collection : libérer l’espace |
| samedi 10:00 | PBS | Verify : contrôler les blocs |
13 · Contrôler chaque matin
| Contrôle | Où | Attendu |
|---|---|---|
| La tâche de la nuit | Proxmox, Tasks (journal de la tâche vzdump) | TASK OK, chaque VM du pool listée, durée |
| Les groupes | PBS, Datastore → Content | un groupe par VM, un instantané daté du jour |
| L’espace | PBS, Datastore → Summary | occupation, facteur de déduplication |
| Le Prune et la GC | PBS, Prune & GC Jobs | Last Status = OK |
La première nuit après la bascule est plus longue : chaque VM est lue en entier (aucune carte des blocs modifiés n’existe encore vers ce stockage). Relevé du 16/10 : 11 VM sauvegardées en 36 min (02:00 → 02:36), contre 2 h 25 en archives complètes ; la plus longue est le poste Windows (13 min, disque de 100 Gio). Les suivantes ne lisent que les changements, sauf pour les VM redémarrées entre-temps (§2.2) : la VM web, qui n’avait pas redémarré, n’a pris que 25 s (364 Mio lus).
Espace relevé après cette première nuit (Datastore → Summary) : 75,95 Go sur 500 (15 %), facteur de déduplication 11,75 pour 795 Gio de disques provisionnés. L’indication « Estimated Full » de PBS prolonge la croissance de la première copie complète : elle est trompeuse les premiers jours ; l’augmentation quotidienne réelle se lit après 2 ou 3 nuits.
Deuxième nuit (17/10) : 11 VM en 16 min 37 s, toutes incrémentales : ≈ 31 Gio modifiés au total, dont 23,2 Gio pour le poste Windows (les autres machines : moins de 0,6 Gio chacune, 5,1 Gio pour le contrôleur de domaine) ; le datastore a pris +29 Go. Un poste Windows peut donc à lui seul dominer la croissance : c’est la machine à surveiller. Premier Verify (samedi) réussi en 54 min 52 s.
Troisième nuit (18/10) : 11 min 16 s,
TASK OK, ≈ 17,9 Gio modifiés au total (poste Windows : 9,5 Gio après 23,2 la veille ; contrôleur de domaine : 5,7 Gio ; les 9 autres : moins de 0,9 Gio chacune). La durée et le volume baissent : la première nuit (copie complète) est passée.Une VM arrêtée est sauvegardée quand même (20/10) : le journal indique
status = stoppedpuisbackup mode: stop; Proxmox démarre une machine virtuelle temporaire pour lire le disque. La carte des blocs modifiés est recréée (created new), donc le disque est relu en entier (4 à 8 min pour 64 et 100 Gio), mais ce qui est envoyé reste minime : 0 Gio pour le contrôleur de domaine (arrêté depuis la veille) et 1,8 Gio pour le poste Windows. Une machine éteinte n’écrit plus : la croissance observée vient bien de l’intérieur des machines Windows. Les deux nouvelles VM de la supervision (139 et 140, dans le pool) ont été prises automatiquement : 32 Gio lus en moins d’une minute chacune, disques à 91-92 % vides.
13.1 Être prévenu par mail
Le besoin : ne pas avoir à ouvrir PBS chaque matin pour savoir si le nettoyage et la vérification ont tourné.
Où configurer : sur PBS, pas sur l’hyperviseur. Dans ce lab, l’hyperviseur est partagé avec d’autres élèves : on n’y dépose ni adresse mail ni webhook. Les sauvegardes elles-mêmes sont lancées par l’hyperviseur : PBS ne prévient pas pour elles (leur suivi passera par une alerte de supervision, « VM non sauvegardée depuis 26 h »).
Théorie en deux mots : PBS (depuis la version 3.2) sépare les cibles (targets : où envoyer) des règles de
tri (matchers : quoi envoyer, et vers quelle cible). Par défaut, la cible mail-to-root confie le message au
serveur de messagerie local, qui essaie de le livrer lui-même sur le port 25 : presque partout, ce port est bloqué
en sortie. On passe donc par un relais SMTP authentifié.
1. La cible. Configuration → Notifications → Notification Targets → Add → SMTP :
| Champ | Valeur |
|---|---|
| Endpoint Name | mail-assistant |
| Server | smtp.gmail.com |
| Encryption | STARTTLS |
| Port | 587 |
| Username | <adresse Gmail de l'expéditeur> |
| Password | <mot de passe d'application> (Google : Sécurité → Mots de passe des applications, un mot de passe dédié à ce serveur, rangé dans le gestionnaire de mots de passe) |
| From Address | la même adresse |
| Recipient(s) | <adresse de destination> |
| Comment | Notifications PBS lab BTS vers la boite de l'assistant |
Bouton Test → un mail « Test notification » arrive.
587 = STARTTLS, 465 = TLS direct. Le mélange donne
SSL routines:…:wrong version number(incident H-43).
2. La règle de tri. Notification Matchers → Add : nom vers-assistant, Match all, cible mail-assistant.
3. Couper l’ancienne voie. Dans Notification Matchers, double-clic sur default-matcher → décocher Enable → OK.
La colonne Enable affiche alors un tiret, et Origin « Built-In (modified) ». On ne supprime rien : on désactive.
Les messages envoyés avant ce réglage par l’ancienne voie restent en file d’attente sur PBS et reviennent en erreur (« Undelivered Mail Returned to Sender ») 5 jours plus tard, un par message : c’est normal et ça s’arrête seul (incident H-44).
Validation — le lendemain matin, dans la boîte de destination :
« Pruning datastore ‘sio2527-lab’ successful » (vers 05:00) et « Garbage Collect Datastore ‘sio2527-lab’ successful »
(vers 06:00, avec la ligne On-Disk usage : la place occupée) ; le samedi, « Verify Datastore … successful ». Les
messages de sécurité du système (par exemple un sudo refusé) arrivent aussi par cette voie.
13.2 Le gel des systèmes de fichiers
Avant de sauvegarder une VM allumée, Proxmox peut demander à son agent invité de geler les écritures, pour une copie aussi propre qu’après un arrêt (Options → QEMU Guest Agent → Freeze/thaw guest filesystems on backup). Sous Windows, ce gel passe par un instantané VSS, qui met en pause les services (base de l’annuaire…).
| Machine | Réglage conseillé | Pourquoi |
|---|---|---|
| Linux | gel activé | rapide (fs-freeze, fs-thaw en une seconde) |
| pfSense (FreeBSD) | gel désactivé | échoue à chaque fois : Resource deadlock avoided (H-48) |
| Poste Windows | gel désactivé | pas de base à protéger ; sur un stockage chargé, le gel dure des minutes (H-47) |
| Contrôleur de domaine | gel activé | il garantit une base d’annuaire propre ; surveiller guest-fsfreeze-thaw failed - got timeout (H-47) |
Un agent « Running » dans la VM peut être figé : on le vérifie depuis l’hyperviseur avec
qm guest cmd <id> ping(aucune sortie = il répond).
13.3 Les machines Windows : le poste à surveiller
Les VM Windows modifient chaque jour bien plus de blocs que les Linux. Relevés du lab (blocs de 4 Mio modifiés en 24 h) :
| Machine | Avant correction | Après (nuit du 26/10) |
|---|---|---|
| Poste Windows 11 | 9,5 à 11 Gio, 23,2 Gio le jour de la défragmentation | 8,1 Gio |
| Contrôleur de domaine | 5,1 à 5,9 Gio | 5,8 Gio |
| Chaque VM Linux | 0,2 à 0,9 Gio | idem |
Les réglages qui comptent (Hardware → disque) : SSD emulation (sinon Windows croit avoir un disque dur et le défragmente chaque semaine, ce qui « modifie » des dizaines de Gio) et Discard (l’espace libéré est rendu au stockage). Ils ne s’appliquent qu’après un arrêt puis un démarrage depuis Proxmox. Le reste (antivirus, journaux, et l’effet des blocs : une petite écriture salit un bloc entier de 4 Mio) est un fond normal, absorbé par la déduplication. Détail du diagnostic : Documentation-pfSense.md, étape 49.1.
Après tout redémarrage complet d’une VM (arrêt et démarrage de son processus), la carte des blocs modifiés est perdue : la sauvegarde suivante relit tout le disque (
dirty-bitmap status: created new), mais n’envoie presque rien de plus. Pour mesurer ce qu’une VM écrit, il faut une nuit sans redémarrage la veille.
13.4 Une copie hors site : un datastore S3 sur un autre site (règle 3-2-1)
Contexte — Tout est sauvegardé sur un PBS, dans le même bâtiment que les VM. Un sinistre, une erreur ou une panne du serveur, et il ne reste rien. La règle 3-2-1 demande 3 copies, sur 2 supports, dont 1 hors du site.
Objectif — Une seconde copie, chaque nuit, sur un stockage S3 situé ailleurs (ici, un NAS personnel qui fait tourner SeaweedFS), relisible et surveillée. Réalisé et vérifié le 05/11/2026 (Documentation, étape 65).
Le principe
Depuis PBS 4.2 (avril 2026), un datastore peut être rangé dans un stockage objet S3 (Amazon S3 ou tout serveur compatible : Ceph, SeaweedFS…). PBS garde un cache local et envoie les morceaux de sauvegarde comme objets. Une synchronisation locale recopie chaque nuit le datastore principal vers ce datastore S3.
| Pourquoi pas… | Raison |
|---|---|
| monter le disque distant (NFS, sshfs) comme datastore | des milliers de petits fichiers à travers Internet : lent, fragile, et il faut exposer NFS ou SSH |
| un second PBS sur l’autre site | une machine de plus à maintenir |
Principe à retenir — Un datastore S3 n’appartient à aucun serveur : si le PBS principal disparaît, n’importe quel PBS neuf peut rattacher le bucket et restaurer (
datastore create … --reuse-datastore true).
Prérequis côté stockage S3
| Élément | Valeur dans le lab | Remarque |
|---|---|---|
| un bucket | pbs-lab | créé à l’avance |
| un utilisateur S3 | pbs-lab-ecole, droits Read, Write, List (et Tagging) sur ce seul bucket | PBS doit lire, écrire, lister et supprimer ; clés dans Bitwarden |
| HTTPS avec un certificat reconnu | reverse proxy + Let’s Encrypt | PBS refuse le HTTP ; avec un certificat autosigné, renseigner son empreinte |
| place | quota de 200 Gio côté NAS | prévoir la taille d’une sauvegarde complète de chaque VM, plus la marge de conservation |
Créer l’utilisateur S3 avant d’exposer le service. SeaweedFS, tant qu’aucun utilisateur n’existe, accepte tout
le monde sans clé. Vérification : une requête anonyme doit répondre AccessDenied.
SeaweedFS : régler Volume Size Limit avant de créer des buckets. Avec 30 000 Mo sur 200 Gio, il n’avait que
6 emplacements de volume, tous pris : le datastore était refusé (failed to upload in-use marker … 500, H-85). Avec
1 000 Mo, 197 emplacements.
13.4.1 Un disque de cache dédié
La documentation de PBS demande un cache local sur un disque dédié, de 64 à 128 Gio. Dans Proxmox : VM du PBS → Hardware → Add → Hard Disk, 64 Gio, Backup décoché (un cache ne se sauvegarde pas). Puis, sur le PBS, en root :
lsblk -dno NAME,SIZE,TYPE
Le nouveau disque apparaît (ici sdc, 64G) sans partition. Vérifier deux fois le nom avant de formater.
mkfs.ext4 -L s3-cache /dev/sdc
mkdir -p /mnt/datastore/s3-cache
echo "UUID=$(blkid -s UUID -o value /dev/sdc) /mnt/datastore/s3-cache ext4 defaults,nofail 0 2" >> /etc/fstab
systemctl daemon-reload && mount /mnt/datastore/s3-cache && chown backup:backup /mnt/datastore/s3-cache
nofail : si ce disque manque un jour, PBS démarre quand même (le datastore S3 sera simplement indisponible).
13.4.2 Déclarer le S3 (interface web : les clés ne passent par personne)
Configuration → Remotes → onglet S3 Endpoints → Add :
| Champ | Valeur | Pourquoi |
|---|---|---|
| S3 Endpoint ID | seaweedfs-maison | un nom local |
| Endpoint | le nom du service S3 (sans https://) | |
| Port | vide (443) | |
| Region | us-east-1 | valeur standard, acceptée par SeaweedFS (Cloudflare R2 : auto) |
| Access / Secret Key | depuis Bitwarden | saisies par l’administrateur, jamais dans un document |
| Path Style | coché | le nom du service ne contient pas le bucket : adresses https://nom/pbs-lab/… |
| Fingerprint | vide | certificat reconnu |
Vérification, sur le PBS :
proxmox-backup-manager s3 check seaweedfs-maison pbs-lab
Aucune erreur, code de retour 0.
13.4.3 Le datastore S3
proxmox-backup-manager datastore create s3-maison /mnt/datastore/s3-cache/s3-maison --backend type=s3,client=seaweedfs-maison,bucket=pbs-lab
TASK OK. Le dossier de cache est un sous-dossier du disque (le disque lui-même contient lost+found).
13.4.4 Essayer sur une seule VM, puis vérifier
proxmox-backup-manager sync-job create s3-essai --store s3-maison --remote-store sio2527-lab --group-filter group:vm/105 --transfer-last 1
proxmox-backup-manager sync-job run s3-essai
proxmox-backup-manager verify s3-maison
Sans --remote, la synchronisation est locale (d’un datastore à l’autre du même PBS). transfer-last 1 : seule la
dernière sauvegarde de chaque VM part. Le 05/11 : 630 Mio en 483 morceaux à 25 Mio/s, puis 0 erreur à la
vérification, qui relit chaque morceau depuis le S3. Supprimer ensuite la tâche d’essai :
proxmox-backup-manager sync-job remove s3-essai.
13.4.5 L’automatisme de chaque nuit
proxmox-backup-manager sync-job create s3-nuit --store s3-maison --remote-store sio2527-lab --schedule '04:00' --transfer-last 1
proxmox-backup-manager prune-job create s3-garder-3 --store s3-maison --schedule '05:00' --keep-last 3
proxmox-backup-manager datastore update s3-maison --gc-schedule '05:30'
| Heure | Tâche | Pourquoi cette heure |
|---|---|---|
| 04:00 | synchronisation | après les sauvegardes de 02:00 |
| 05:00 | nettoyage : 3 sauvegardes par VM sur le S3 | tenir dans le quota (le lab en garde 7) |
| 05:30 | ramasse-miettes | supprime vraiment les morceaux qui ne servent plus |
13.4.6 Être prévenu si la copie ne se fait plus
L’exporteur PBS publie les mesures de tous les datastores, dont le nouveau. Dans Grafana :
(time() - pbs_snapshot_vm_last_timestamp{datastore="s3-maison"}) / 3600 donne l’âge de la dernière copie de chaque VM
(alerte au-delà de 30 h : sauvegarde vers 02:15, copie à 04:00). Penser à filtrer les panneaux et règles
existants sur le datastore principal (datastore="sio2527-lab"), sinon chaque VM apparaît en double.
Pour un datastore S3, pbs_used et pbs_size décrivent le disque de cache local, pas le bucket (constaté le 05/11 : 5,1 Gio affichés pour ≈ 75 Gio copiés). La place réelle se lit côté stockage S3.
Validation — s3 check sans erreur ; datastore créé ; synchronisation d’essai TASK OK ; verify 0 erreur ;
côté stockage, les objets arrivés dans le bucket ; le lendemain, toutes les VM présentes sur le datastore S3.
Une copie de chaque VM hors du site, relisible, renouvelée chaque nuit, et une alerte si elle vieillit.
13.4.7 Restaurer depuis la copie
Proxmox ne voit d’abord que le datastore principal. Pour restaurer depuis le S3 : sur PBS, donner au compte de Proxmox la lecture seule sur le datastore S3, puis déclarer un second stockage dans Proxmox.
proxmox-backup-manager acl update /datastore/s3-maison DatastoreReader --auth-id 'backup-pve01@pbs!pve01'
Proxmox → Datacenter → Storage → Add → Proxmox Backup Server : mêmes serveur, compte (jeton), mot de passe (secret
du jeton) et empreinte que le stockage principal, Datastore = s3-maison. Puis restaurer dans une VM neuve,
carte réseau débranchée :
qmrestore <stockage-s3>:backup/vm/<id>/<date> <nouvel-id> --storage storage-images --unique 1
qm set <nouvel-id> --net0 "<net0 d'origine>,link_down=1"
401 Unauthorized à l’ajout du stockage : le mot de passe n’est pas le secret du jeton (journal de PBS :
invalid credentials).
Validation — la VM démarre, son nom et ses services sont ceux de l’originale ; puis elle est supprimée.
Au lab : srv-web-02 restaurée en 125 s le 06/11 (Documentation, étape 65.3).
14 · Pièges et checklist
| Piège | Conséquence | Où |
|---|---|---|
| Installer PBS sur le disque de 500 Go | le futur datastore devient le système | §5 |
| Disque de données laissé avec « Backup » coché | la sauvegarde de PBS recopie le datastore | §4 |
| VM PBS laissée dans le pool sauvegardé | http upgrade request timed out : la tâche finit en erreur chaque nuit | §4 |
| Droits posés sur l’utilisateur seul (ou le jeton seul) | refus d’accès au datastore | §8 |
| Secret du jeton non copié | à régénérer | §8 |
Server = 10.0.30.13 dans Proxmox | injoignable : l’hyperviseur ne connaît pas le VLAN 30 | §10.1 |
| Redirection sans restriction de source | PBS exposé à tout le réseau de l’école | §9.2 |
| Rétention laissée côté Proxmox | erreur de suppression en fin de tâche | §12.3 |
| Cliquer « Stop » après « restore image complete » | VM verrouillée et incomplète | §11 |
| Cliquer « Prune » dans l’aperçu | suppression réelle | §12.1 |
| Cible SMTP en TLS sur le port 587 | wrong version number | §13.1, H-43 |
default-matcher laissé actif | retours « Undelivered » 5 jours après chaque message | §13.1, H-44 |
| Gel laissé sur pfSense ou sur un poste Windows | erreur chaque nuit, gel de plusieurs minutes | §13.2, H-47, H-48 |
| Disque d’une VM Windows présenté comme disque dur | défragmentation hebdomadaire : des dizaines de Gio « modifiés » | §13.3 |
| S3 exposé avant d’avoir créé un utilisateur (SeaweedFS) | stockage ouvert à tous, sans clé | §13.4 |
| Gros volumes SeaweedFS sur un petit disque | datastore refusé : failed to upload in-use marker … 500 | §13.4, H-85 |
| Cache du datastore S3 sur le disque système | disque système plein | §13.4.1 |
| Panneaux Grafana non filtrés par datastore | chaque VM apparaît en double | §13.4.6 |
Supprimer une VM restée verrouillée par une restauration interrompue (shell de l’hyperviseur, VM de test uniquement, en vérifiant l’identifiant deux fois) :
qm unlock 139
qm destroy 139 --purge --destroy-unreferenced-disks 1
pvesm list storage-images | grep vm-139      # s'il reste un disque :
pvesm free storage-images:vm-139-disk-0
 VM PBS : système sur 32 Gio, données 500 Gio « Backup » décoché, VLAN 30, IP fixe libre, hors du pool sauvegardé
 Dépôts corrigés, système à jour, redémarré ; agent invité actif
 Compte nominatif par clé SSH ; root interdit en SSH
 Datastore ext4 créé
 Utilisateur + jeton, rôle DatastoreBackup sur les deux ; secret conservé
 Alias + redirection WAN restreinte à l'hyperviseur ; curl → 200
 Stockage PBS ajouté dans Proxmox (adresse WAN de pfSense, empreinte)
 Deux sauvegardes d'une VM : la seconde est incrémentale
 Restauration sous un nouvel identifiant jusqu'à TASK OK, puis copie supprimée
 Prune (Keep Daily 7), GC, Verify planifiés dans PBS
 Copie hors site : disque de cache dédié, endpoint S3 (s3 check OK), datastore S3, essai + verify, sync 04:00, prune, GC, alerte Grafana
 Tâche planifiée vers PBS, « Keep all backups », Pool based, Repeat missed
 Première nuit contrôlée (§13)
 Cible SMTP 587/STARTTLS + matcher « tout » ; default-matcher désactivé ; mail de test reçu (§13.1)
 Gel : actif sur Linux et le contrôleur de domaine, désactivé sur pfSense et le poste (§13.2)
 VM Windows : SSD emulation + Discard, arrêt/démarrage depuis Proxmox (§13.3)
La règle à retenir en une phrase
PBS n’écrit que les blocs nouveaux, donc chaque nuit coûte peu ; Proxmox envoie avec un jeton qui ne peut pas supprimer, et c’est PBS qui fait le ménage : Prune pour décider, Garbage Collection pour libérer.