


Mode opératoire — Mettre en service Grafana avec sa base dans un cluster Galera, et exploiter les données
Document autonome. Partie théorique, puis mise en œuvre telle qu’elle a été réalisée et vérifiée du 23 au 27/10/2026 sur
srv-supervision(10.0.30.15, Debian 13) — phase 14 du suivi, tâche 14.7. La méthode vaut pour toute infrastructure qui a déjà des mesures (Prometheus) et des journaux en base (MariaDB/MySQL). Prérequis : MO-13-Prometheus.md (les mesures), MO-14-HAProxy-local-Galera.md (l’accès au cluster, la basegrafanaet ses comptes), MO-15-Rsyslog-Galera.md (les journaux). Contexte : Documentation-pfSense.md (étape 50).Valeurs masquées. Aucun mot de passe ici :
<mot-de-passe-grafana>est rangé dans le gestionnaire de mots de passe.Dernière mise à jour : 30/10/2026 — ajout du §11 (alertes par mail, testées) État au 12/11/2026 : 17 règles, toutes éprouvées (les 3 de la copie hors site par le test T30 des 11-12/11, étape 65). Politique : critique 10 s puis toutes les 5 min, rappel 1 h ; avertissement 5 min puis par paquets de 30 min, rappel 1 jour.
Sommaire
| § | Contenu |
|---|---|
| 1 | Le besoin, et pourquoi Grafana |
| 2 | Théorie : sources, requêtes, panneaux, période |
| 3 | L’architecture retenue |
| 4 | Installer depuis le dépôt officiel |
| 5 | Régler l’écoute et la base dans Galera |
| 6 | Première connexion et sources de données |
| 7 | Interroger les données : Explore |
| 8 | Construire des panneaux |
| 9 | Exploiter : trois analyses réelles |
| 10 | Le tableau de bord de production |
| 11 | Les alertes : être prévenu sans regarder l’écran |
| 12 | Pièges et checklist |
1 · Le besoin, et pourquoi Grafana
Le lab produit déjà deux sortes de données : des mesures (Prometheus : processeur, mémoire, disques, sondes) et des
journaux (rsyslog, dans la base syslog du cluster Galera). Il manque un écran qui les montre ensemble, lisible
par quelqu’un qui n’a pas construit le lab.
| Outil | Verdict |
|---|---|
| Interface web de Prometheus | mesures seulement, pas de journaux ; dans le paquet Debian, seule l’ancienne interface existe |
| Requêtes SQL à la main | précises, mais rien de visuel, rien de partageable |
| Grafana | lit les deux (Prometheus et MySQL/MariaDB) dans le même tableau de bord ; libre ; gère aussi les alertes (tâche 14.8) ; sa propre base peut être dans le cluster, ce que demandait le formateur |
2 · Théorie : sources, requêtes, panneaux, période
| Notion | Ce que c’est |
|---|---|
| Source de données | une connexion vers un endroit où lire (ici prometheus et mysql) |
| Requête | la question posée à la source : en PromQL pour Prometheus, en SQL pour la base |
| Panneau | une requête + une façon de l’afficher (case colorée, courbe, tableau, barres) |
| Tableau de bord | un ensemble de panneaux, enregistré dans la base de Grafana |
| Explore | un brouillon : on pose des questions sans rien enregistrer |
| Période | le sélecteur en haut à droite (« Depuis 24 heures ») : toutes les requêtes s’y limitent |
Deux idées de PromQL indispensables :
- beaucoup de mesures sont des compteurs qui ne font qu’augmenter (par exemple les secondes passées par le processeur dans
chaque mode) ;
rate(compteur[5m])donne leur vitesse moyenne sur 5 minutes ; avg by (host) (…)fait une moyenne par machine (les cœurs d’un processeur sont regroupés).
Une idée de SQL dans Grafana : la macro $__timeFilter(colonne) est remplacée par la période choisie en haut ; une
colonne nommée time est reconnue comme l’heure. Grafana suppose que les dates de la base sont en UTC.
Principe à retenir : on stocke en UTC, l’écran convertit à l’heure du lecteur.
3 · L’architecture retenue
   poste d'administration (Tailscale)
              │  http://10.0.30.15:3000
              ▼
   ┌───────────────────────── srv-supervision (10.0.30.15) ─────────────────────────┐
   │  Grafana  ── source « prometheus » ──────────────► 10.0.30.14:9090 (Prometheus) │
   │     │     ── source « mysql » (grafana_lecture) ─┐                              │
   │     └── sa propre base (compte grafana) ─────────┤                              │
   │                                         HAProxy local 127.0.0.1:3306           │
   └──────────────────────────────────────────────────┼─────────────────────────────┘
                                                      ▼
                                  cluster Galera : srv-mysql-01 / 02 / 03
                                  bases « grafana » (réglages, tableaux) et « syslog » (journaux)
| Choix | Pourquoi |
|---|---|
| Base de Grafana dans Galera | les tableaux de bord et les comptes survivent à la perte d’un nœud ; demande du formateur |
| Passage par le HAProxy local | si srv-mysql-01 tombe, la connexion bascule sur un autre nœud (MO-14) |
| Deux comptes distincts | grafana gère sa base ; grafana_lecture ne peut que lire les journaux : un tableau de bord ne pourra jamais effacer une ligne |
Écoute sur 10.0.30.15 seulement | jamais sur toutes les adresses de la machine |
4 · Installer depuis le dépôt officiel
Contexte : sur
srv-supervision, compte administrateur, accès Internet de la zone d’administration. Objectif : un paquet signé par l’éditeur, mis à jour paraptcomme le reste du système.
4.1 La clé de signature (elle permet à apt de vérifier que les paquets viennent bien de Grafana) :
sudo mkdir -p /etc/apt/keyrings && wget -q -O - https://apt.grafana.com/gpg.key | gpg --dearmor | sudo tee /etc/apt/keyrings/grafana.gpg >/dev/null && ls -l /etc/apt/keyrings/grafana.gpg
4.2 Le dépôt, limité à cette clé (signed-by : la clé ne vaut que pour ce dépôt) :
echo "deb [signed-by=/etc/apt/keyrings/grafana.gpg] https://apt.grafana.com stable main" | sudo tee /etc/apt/sources.list.d/grafana.list
4.3 L’installation, sans la démarrer (on la règle d’abord) :
sudo apt-get update && sudo apt-get install -y --no-install-recommends grafana
Validation — apt-get update lit apt.grafana.com sans erreur de signature ; le paquet grafana est installé (dpkg -l grafana → ii).
5 · Régler l’écoute et la base dans Galera
Contexte : la base
grafanaet le compte[email protected]existent déjà (MO-14 §5). Objectif : régler Grafana par des variables d’environnementGF_*, lues par le service, sans toucher au gros fichiergrafana.ini.
5.1 Sauvegarder l’original, puis ajouter les réglages :
sudo cp /etc/default/grafana-server /etc/default/grafana-server.orig && sudo tee -a /etc/default/grafana-server >/dev/null <<'EOF'

# --- Lab BTS : reglages de srv-supervision ---
GF_SERVER_HTTP_ADDR=10.0.30.15
GF_DATABASE_TYPE=mysql
GF_DATABASE_HOST=127.0.0.1:3306
GF_DATABASE_NAME=grafana
GF_DATABASE_USER=grafana
GF_DATABASE_PASSWORD=<mot-de-passe-grafana>
GF_DATABASE_SSL_MODE=skip-verify
GF_DATABASE_CA_CERT_PATH=/etc/ssl/certs/ca-certificates.crt
GF_ANALYTICS_REPORTING_ENABLED=false
GF_ANALYTICS_CHECK_FOR_UPDATES=false
GF_ANALYTICS_CHECK_FOR_PLUGIN_UPDATES=false
EOF
| Variable | Rôle |
|---|---|
GF_SERVER_HTTP_ADDR | l’adresse d’écoute (port par défaut : 3000) |
GF_DATABASE_* | la base de Grafana : MySQL par le HAProxy local |
SSL_MODE=skip-verify | connexion chiffrée, sans vérifier le certificat (MariaDB fabrique le sien, il n’y a pas d’autorité à vérifier) |
CA_CERT_PATH | obligatoire quand même en skip-verify, sinon could not read DB CA Cert path "" (H-45) : on donne le magasin du système |
GF_ANALYTICS_* | pas de statistiques envoyées à l’éditeur, pas de vérification de mises à jour par Grafana (c’est apt qui s’en charge) |
5.2 Placer le vrai mot de passe, sans qu’il s’affiche ni reste dans l’historique, puis protéger le fichier :
read -rsp "Mot de passe grafana : " P; echo; sudo sed -i "s|^GF_DATABASE_PASSWORD=.*|GF_DATABASE_PASSWORD=$P|" /etc/default/grafana-server; unset P; sudo chmod 600 /etc/default/grafana-server
sedsur^GF_DATABASE_PASSWORD=.*remplace la ligne entière : on peut relancer la commande sans laisser de reste d’une ancienne valeur (incident H-45,Error 1045).
5.3 Démarrer, et faire démarrer avec la machine :
sudo systemctl enable --now grafana-server && sleep 15 && systemctl is-active grafana-server && sudo ss -ltnp | grep 3000
active, puis une écoute sur 10.0.30.15:3000. Au premier démarrage, Grafana crée ses tables dans la base grafana.
5.4 Contrôle propre à Galera : chaque table doit avoir une clé primaire, sinon Galera la réplique mal. Sur un nœud :
sudo mariadb -e "SELECT COUNT(*) AS tables_sans_cle FROM information_schema.tables t WHERE t.table_schema='grafana' AND t.table_type='BASE TABLE' AND NOT EXISTS (SELECT 1 FROM information_schema.table_constraints c WHERE c.table_schema=t.table_schema AND c.table_name=t.table_name AND c.constraint_type='PRIMARY KEY')"
0 (relevé du lab : 113 tables, aucune sans clé primaire). À VÉRIFIER : la requête exacte utilisée le 23/10 n’a pas été conservée ; celle-ci fait le même contrôle.
6 · Première connexion et sources de données
6.1 Ouvrir http://10.0.30.15:3000, se connecter en admin / admin, changer le mot de passe (le ranger dans le gestionnaire).
6.2 Source Prometheus : Connexions → Sources de données → Ajouter → Prometheus :
| Champ | Valeur |
|---|---|
| Nom | prometheus |
| URL | http://10.0.30.14:9090 |
Enregistrer et tester → message de réussite.
6.3 Source MySQL (les journaux) : Ajouter → MySQL :
| Champ | Valeur |
|---|---|
| Nom | mysql |
| Hôte | 127.0.0.1:3306 (le HAProxy local) |
| Base | syslog |
| Utilisateur | grafana_lecture (lecture seule) |
| Mot de passe | <mot-de-passe-grafana_lecture> |
| TLS | Skip TLS Verify coché (même raison qu’en §5) |
Enregistrer et tester → réussite.
7 · Interroger les données : Explore
Menu Explore, choisir la source, passer l’éditeur en Code.
| Question | Source | Requête |
|---|---|---|
| Quelles machines répondent ? | prometheus | up |
| Mémoire disponible d’une machine | prometheus | node_memory_MemAvailable_bytes{host="srv-mysql-01"} |
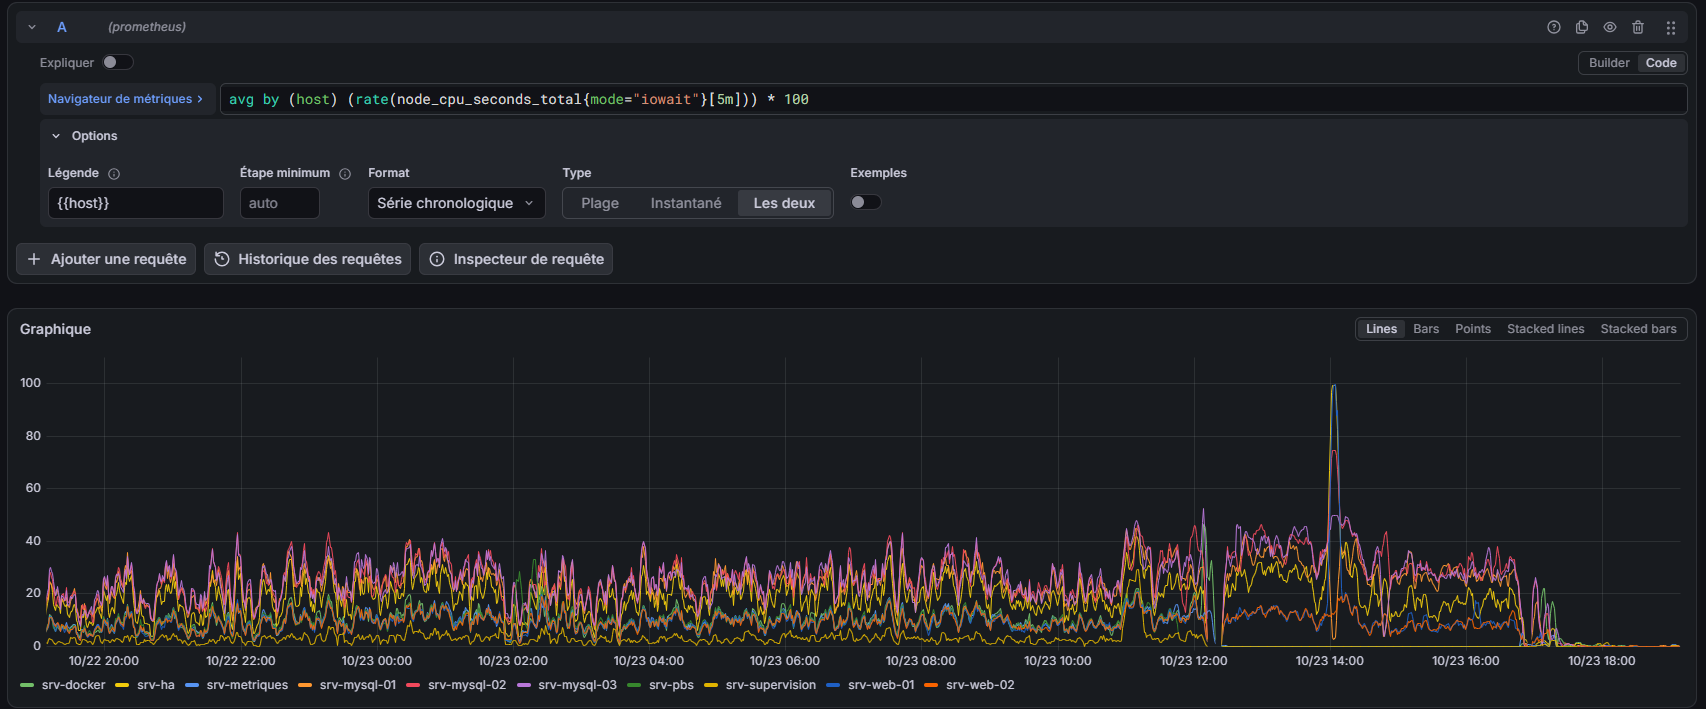
| Temps passé à attendre le disque | prometheus | avg by (host) (rate(node_cpu_seconds_total{mode="iowait"}[5m])) * 100 |
| Quelle heure a la base ? | mysql (Format Table) | SELECT NOW(), UTC_TIMESTAMP() |
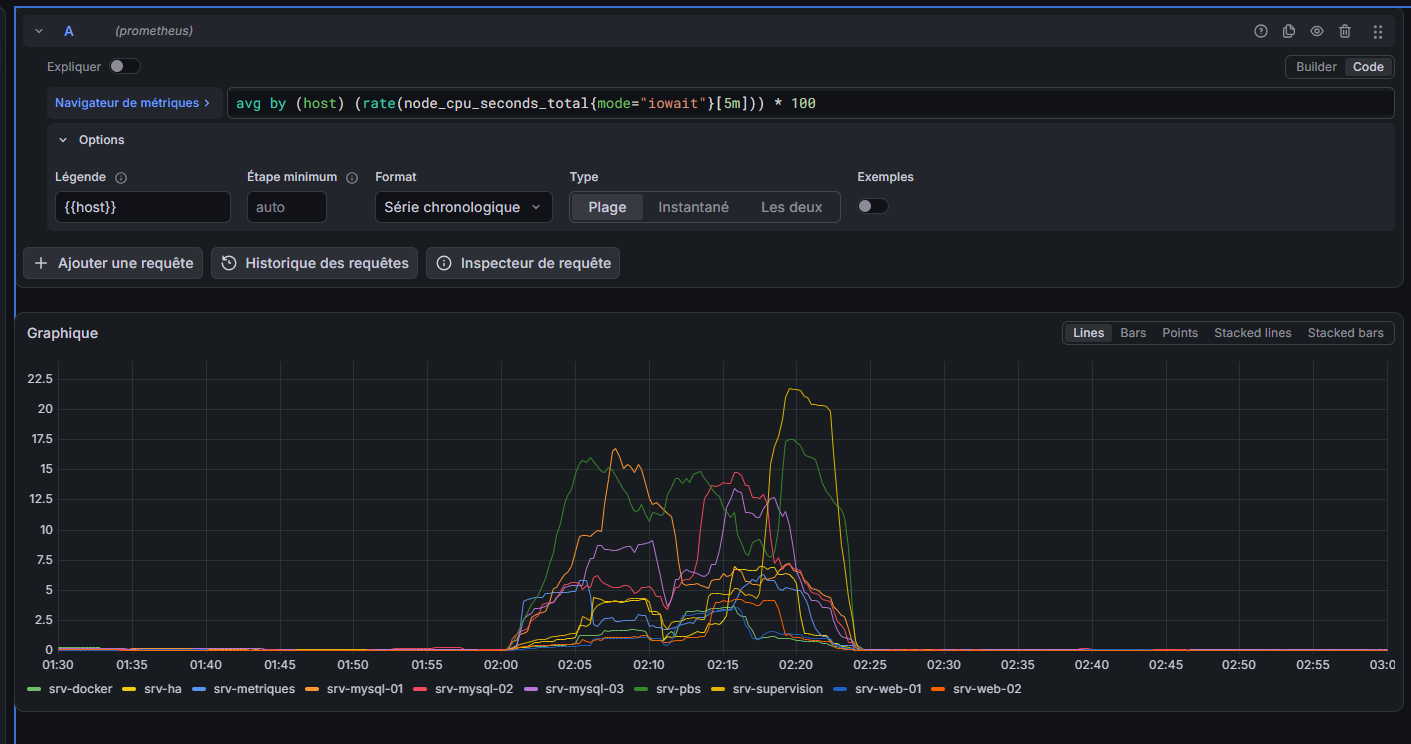
Pour une plage précise : clic sur le sélecteur de période (l’horloge) → partie gauche « Plage de temps absolue », champs De et À (par exemple
2026-10-26 01:30:00) → Appliquer la plage de temps.
Validation — up renvoie une série par cible, à 1.
8 · Construire des panneaux
Créer le tableau de bord : Tableaux de bord → Nouveau → Ajouter une visualisation, puis, pour chaque panneau, Ajouter un panneau. Les réglages se trouvent à droite ; la loupe des options permet de chercher un réglage par son nom. Penser à Enregistrer (bouton en haut).
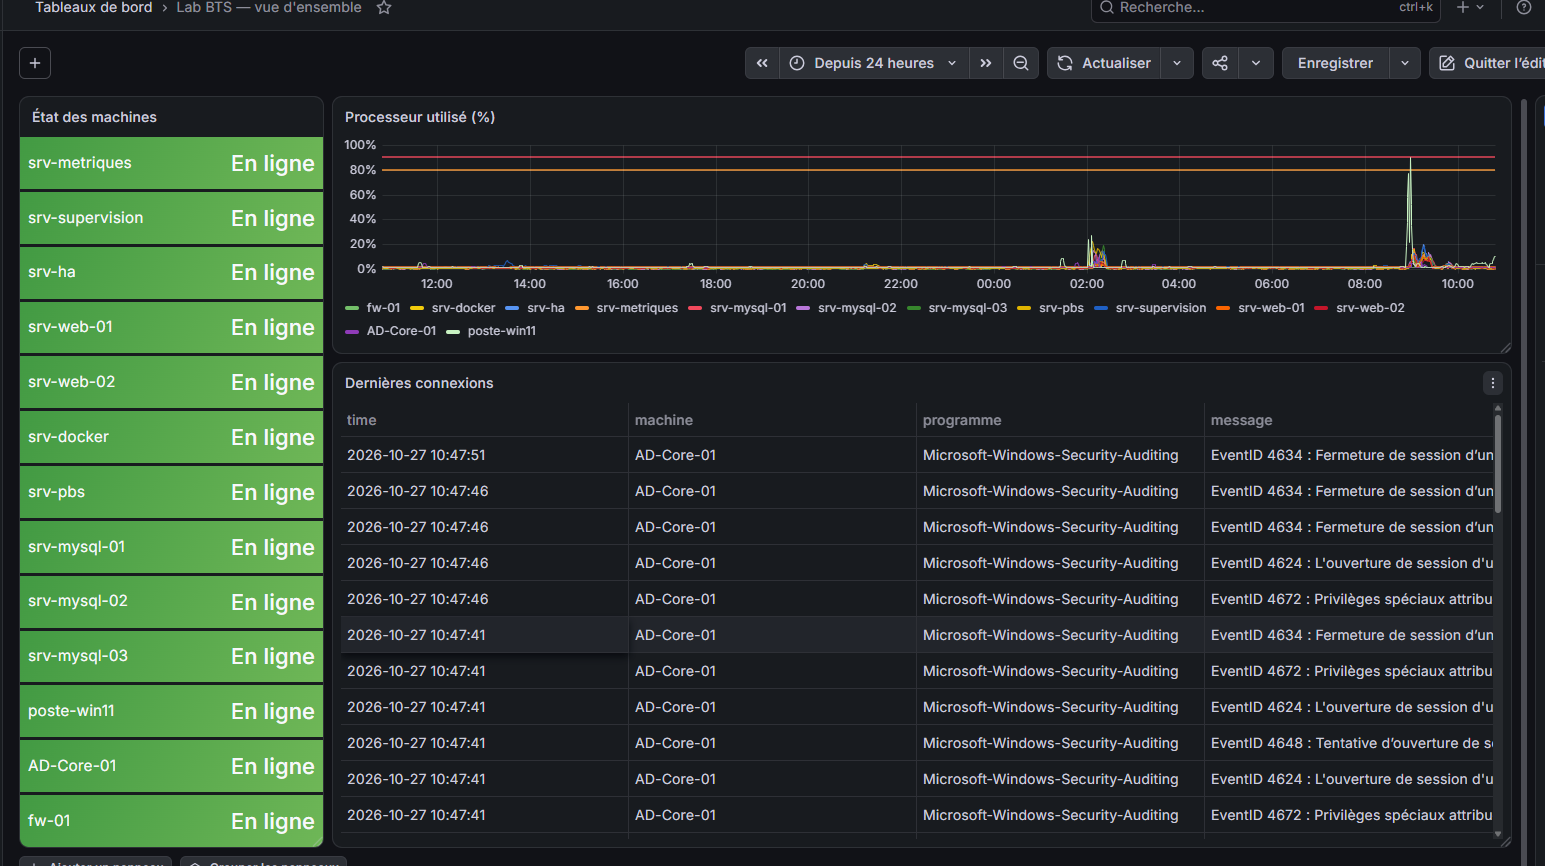
8.1 État des machines (cases vertes ou rouges) :
| Réglage | Valeur |
|---|---|
| Source, requête | prometheus, up{job=~"node|windows"} |
| Légende | {{host}} · Type de requête Instantané (la valeur actuelle, pas l’historique) |
| Visualisation | Stat |
| Correspondance de valeurs | 1 → « En ligne », vert · 0 → « Hors ligne », rouge |
| Mode de couleur | arrière-plan |
8.2 Processeur utilisé (%) (courbes) :
| Réglage | Valeur |
|---|---|
| Requête A (Linux) | 100 - (avg by (host) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) |
| Requête B (Windows) | 100 - (avg by (host) (rate(windows_cpu_time_total{mode="idle"}[5m])) * 100) |
| Légende | {{host}} · Type Plage |
| Visualisation | Série chronologique |
| Unité, Min, Max | Pourcentage (0-100), 0, 100 (échelle fixe : 30 % ressemble à 30 %) |
| Seuils | 80 orange, 90 rouge · Afficher les seuils : en lignes |
Un panneau peut mélanger plusieurs requêtes, même d’exporteurs différents, si elles mesurent la même chose dans la même unité.
8.3 Dernières connexions (tableau) :
SELECT recu_le AS time, hote AS machine, programme, message
FROM syslog.journaux_auth
WHERE $__timeFilter(recu_le)
AND message NOT LIKE '%Connection closed by 10.0.30.12%[preauth]%'
AND message NOT LIKE '%Connection closed by 172.19.0.3%[preauth]%'
ORDER BY recu_le DESC
LIMIT 50
Format Table, visualisation Tableau. Les deux NOT LIKE retirent les tests de disponibilité de l’outil
d’administration (connexion fermée avant authentification), et seulement eux : les vraies connexions, venues de la même
adresse, et les tentatives d’intrusion (« invalid user … [preauth] ») restent visibles.
Dans un filtre, on garde ce qui ne change pas (l’adresse,
[preauth]) et on remplace par%ce qui change (le port).
8.4 Événements d’une machine par type (barres) :
SELECT SUBSTRING_INDEX(message, ' :', 1) AS debut_message, COUNT(*) AS nombre
FROM syslog.journaux_auth
WHERE hote = 'AD-Core-01' AND $__timeFilter(recu_le)
GROUP BY debut_message
ORDER BY nombre DESC
SUBSTRING_INDEX(message, ' :', 1) garde le début du message (EventID 4624) pour pouvoir regrouper ; visualisation
Jauge à barres ou Graphique à barres.
Validation — chaque panneau affiche des données réelles ; l’heure des lignes correspond à l’heure du PC.
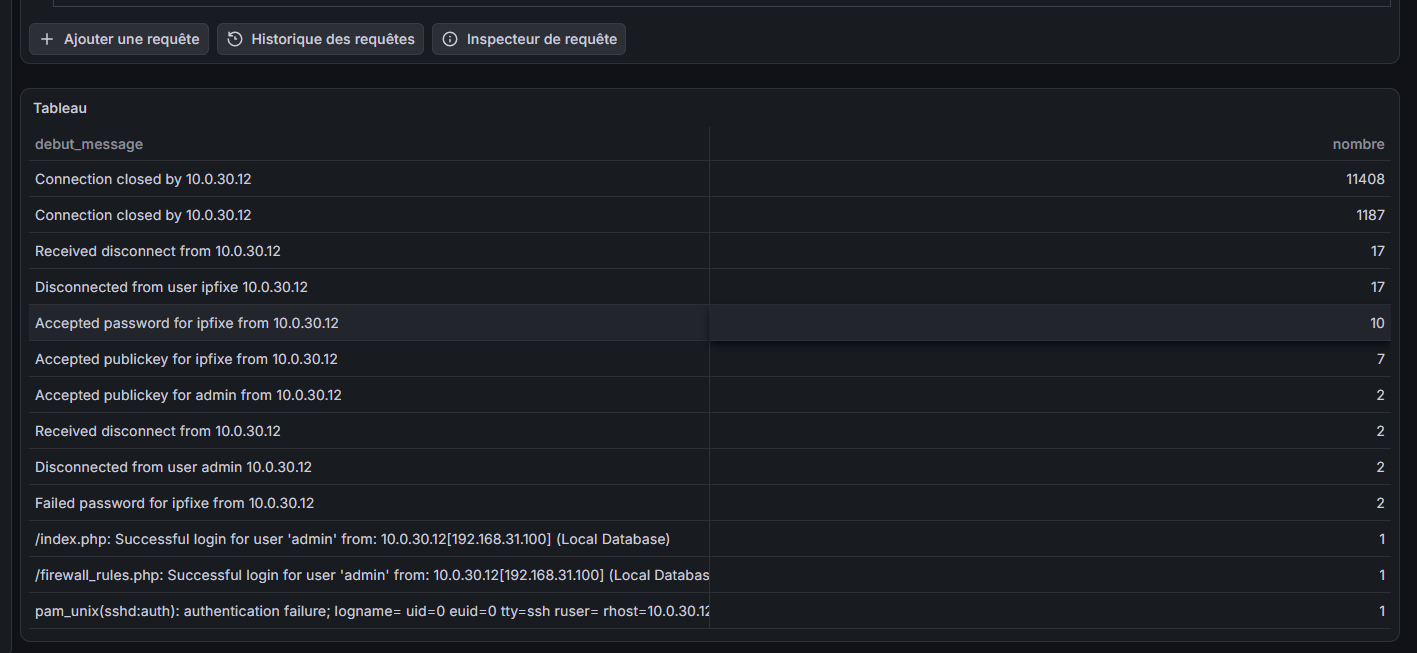
96-grafana-etat-des-machines.webp · 97-grafana-processeur.webp · 103-grafana-connexions-sans-termix.png ·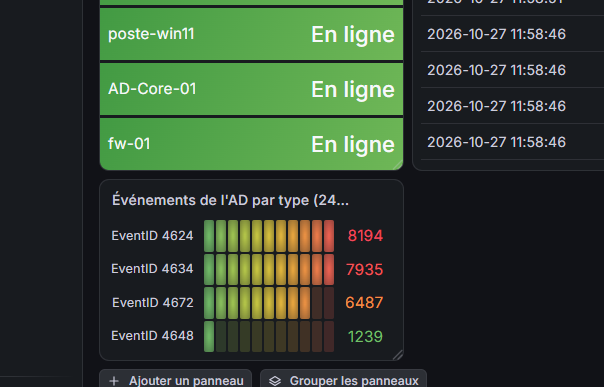
9 · Exploiter : trois analyses réelles
| Question | Ce qu’on a fait | Réponse |
|---|---|---|
| Les anciens disques freinaient-ils le lab ? | courbe d’iowait sur 24 h | 10 à 40 % avant la migration des disques, ≈ 0 après : preuve chiffrée |
| La sauvegarde de la nuit charge-t-elle le stockage ? | même requête, plage 01:30-03:00 | oui : 2 à 22 % pendant toute la sauvegarde, et pas avant |
| Qui se connecte depuis le bastion ? | GROUP BY sur le début des messages contenant 10.0.30.12 | ≈ 12 600 tests de disponibilité en 24 h, 17 vraies connexions, 2 mots de passe refusés |
Méthode : une question précise → une requête dans Explore → une lecture → si c’est utile en permanence, un panneau.
10 · Le tableau de bord de production
Contexte : le tableau d’exercice a servi à apprendre ; le tableau « Lab BTS — Production » sert à exploiter. Public : l’administrateur (décision d’Axel). Construit bloc par bloc, chaque bloc validé avant le suivant.
Objectif : répondre d’un coup d’œil à trois questions, une par section repliable : le lab rend-il son service ? · quelle machine souffre ? · qui essaie d’entrer ? Le contenu de chaque bloc est décrit à l’étape 52 de la documentation ; ici, les techniques pour le reproduire.
10.1 Les règles de conception
| Règle | Pourquoi |
|---|---|
| Une section = une question ; en haut l’état, dessous les tendances, en bas le détail | on lit de haut en bas, du « est-ce que ça va ? » au « pourquoi ? » |
| Vert / orange / rouge de même sens partout ; seuils d’usage courant, justifiés dans la description du panneau (le « i ») | un seuil sans justification ne se défend pas devant un jury |
Unité explicite sur chaque valeur (%, ms, Gio, j) | « 88 » ne veut rien dire, « 88 % » si |
| Période par défaut : 30 jours ; un panneau qui doit rester sur 30 jours a son propre Temps relatif | la disponibilité se juge sur 30 jours |
10.2 Une ligne par service : la répétition
Problème : un panneau « barre des jours » et un panneau « moyenne » côte à côte n’alignent jamais leurs lignes. Solution : une variable cachée et l’option Répéter.
- Paramètres du tableau → Variables :
service, type Requête,label_values(probe_success, service), multi-valeur + All, Masquer : Variable. - Dans chaque panneau de la ligne : requête filtrée par
{service=~"$service"}, puis Options de répétition → Répéter parservice, direction Verticale, même hauteur pour tous les panneaux de la ligne.
Même principe pour les sauvegardes, avec une variable vm de type query_result(group by (vm_name) (pbs_snapshot_vm_last_timestamp)) et l’expression régulière /vm_name="(?<value>SIO2527-(?<text>[^"]*)-Axel)"/
(valeur complète, texte court affiché par ${vm:text}).
10.3 Une case par jour, sans décalage
avg_over_time(probe_success{service=~"$service"}[1d] offset -1d) * 100
Visualisation Status history, Étape minimum 1d, Temps relatif 30d. Sans offset -1d, chaque case résume
la veille (H-51). Pour les sauvegardes : max_over_time(pbs_snapshot_vm_last_timestamp{…}[1d] offset -1d) >= bool time()
(1 si une sauvegarde a eu lieu dans la journée).
10.4 Renommer, relier, ne rien perdre
| Besoin | Requête |
|---|---|
Afficher « Proxmox Backup Server » au lieu de sauvegarde | label_replace(label_replace(X, "nom", "$1", "service", "(.*)"), "nom", "Proxmox Backup Server", "service", "sauvegarde"), légende {{nom}} |
| Relier la mémoire réglée dans Proxmox à la machine | max by (host) (pve_memory_size_bytes * on(id) group_left(host) label_replace(pve_guest_info, "host", "$1", "name", "SIO2527-(.*)-Axel")) (+ un label_replace par exception : W11 → poste-win11…) |
| Garder une machine tombée à l’écran, en rouge | (…) or on(host) (up{job=~"node|windows"} == 0) - 1, puis correspondance de valeur -1 → « INJOIGNABLE » |
| Une seule série par machine | max by (host) (…) et host!="" (H-52) |
| Fixer l’ordre des cases d’un Stat | transformations Joindre par champ (Time) puis Organiser les champs |
| Lire un compte dans un message Windows | REGEXP_SUBSTR / REGEXP_REPLACE (espace insécable, H-54) |
10.5 Mesures comparables entre Linux et Windows
| Mesure | Linux | Windows |
|---|---|---|
| Mémoire utilisée (sans le cache) | 1 - MemAvailable / MemTotal | 1 - windows_memory_available_bytes / windows_memory_physical_total_bytes |
| Disque système | node_filesystem_*{mountpoint="/"} | windows_logical_disk_*{volume="C:"} |
| Latence disque (ms) | (rate(read_time)+rate(write_time)) / (rate(reads)+rate(writes)) sur node_disk_* | rate(windows_logical_disk_read_write_latency_seconds_total) / (rate(reads)+rate(writes)) |
Latence ou iowait ? La latence dit « le stockage est-il lent ? » (ms par opération, Linux et Windows) ; l’iowait dit « la machine est-elle bloquée par lui ? » (% du temps processeur, Linux seulement, et faible sur une machine qui calcule beaucoup). Le tableau affiche la latence ; l’iowait reste interrogeable dans Explore.
Quand les valeurs s’étalent de 1 ms à 10 s, échelle logarithmique (Axe → Échelle → Logarithmique, base 10, minimum 0,1) : les seuils de 20 et 50 ms restent visibles malgré un pic à 8 s.
10.6 Modifier le tableau par l’API (option)
Un compte de service (Administration → Utilisateurs et accès → Comptes de service), rôle Editor, jeton à
durée limitée, permet de modifier le tableau par l’API (GET /api/dashboards/uid/<uid>, puis POST /api/dashboards/db
avec "overwrite": false pour refuser d’écraser une version enregistrée entre-temps). Grafana garde l’historique des
versions (Paramètres → Versions) : toute modification se compare et se restaure.
Validation : chaque bloc affiche des données réelles ; un test (mot de passe faux en SSH et sur Windows) apparaît en moins d’une minute ; la période par défaut est de 30 jours.
107 à 115 (grafana-prod-…)
11 · Les alertes : être prévenu sans regarder l’écran
Contexte — un tableau de bord ne sert que si quelqu’un le regarde. Les alertes renversent la logique : c’est Grafana qui prévient, par mail, quand une mesure franchit un seuil. Objectif — un mail pour chaque panne réelle, aucun pour un pic passager, et un rythme adapté à la gravité. Réalisé et testé le 29/10/2026 (tâche 14.8).
11.1 Les quatre pièces, et leur ordre
 règle d'alerte ──étiquette severite──► politique de notification ──► point de contact ──► mail
 (quoi surveiller,     (critique /         (quel chemin, quel          (où envoyer :
  quel seuil,           avertissement)      rythme d'envoi)              adresses)
  combien de temps)
| Pièce | Rôle | Dans le lab |
|---|---|---|
| Envoi SMTP | comment Grafana envoie un mail | compte Gmail d’envoi, smtp.gmail.com:587, STARTTLS obligatoire |
| Point de contact | où envoyer | mail-axel : boîte de l’administrateur + boîte de copie |
| Politique de notification | quelles alertes vont où, à quel rythme | politique par défaut → mail-axel ; deux chemins selon l’étiquette severite |
| Règle d’alerte | ce qui déclenche | 8 règles dans le dossier Lab BTS au 30/10 ; 17 au 12/11 (§11.5) |
Principe à retenir — la règle ne connaît pas le destinataire : elle porte une étiquette (
severite), et c’est la politique qui aiguille. Ajouter plus tard un ticket GLPI pour les alertes critiques = ajouter un point de contact au chemincritique, sans toucher à aucune règle.
11.2 L’envoi des mails (ligne de commande, sur srv-supervision)
Le mot de passe d’envoi est un mot de passe d’application Google (16 caractères, créé dans le compte de l’expéditeur : Sécurité → Validation en deux étapes → Mots de passe des applications), dédié à Grafana pour pouvoir le révoquer seul. Google l’affiche en 4 groupes : les espaces n’en font pas partie.
sudo cp -p /etc/default/grafana-server /etc/default/grafana-server.avant-smtp
read -rp "Adresse Gmail de l'expéditeur : " U; read -rsp "Mot de passe d'application : " P; echo
P=${P// /}; echo ${#P}
16.
printf 'GF_SMTP_ENABLED=true\nGF_SMTP_HOST=smtp.gmail.com:587\nGF_SMTP_USER=%s\nGF_SMTP_PASSWORD=%s\nGF_SMTP_FROM_ADDRESS=%s\nGF_SMTP_FROM_NAME=Grafana Lab BTS\nGF_SMTP_STARTTLS_POLICY=MandatoryStartTLS\n' "$U" "$P" "$U" | sudo tee -a /etc/default/grafana-server >/dev/null; unset U P
Les liens des mails (« View alert », « Silence ») utilisent l’adresse publique de Grafana ; sans elle, ils
pointent vers http://localhost:3000 et ne s’ouvrent pas depuis une boîte mail :
echo 'GF_SERVER_ROOT_URL=https://grafana.pangolin.<domaine>/' | sudo tee -a /etc/default/grafana-server
sudo systemctl restart grafana-server
Validation — sans jamais afficher le secret :
sudo awk -F= '/^GF_SMTP_PASSWORD=/{print length($2)}' /etc/default/grafana-server
systemctl status grafana-server --no-pager | head -n 3
sudo stat -c '%a %U:%G' /etc/default/grafana-server
16 · active (running) since l’heure de maintenant · 600 root:root.
Piège pratique — deux commandes collées sur la même ligne (
restart grafana-serversudo systemctl …) : le redémarrage n’a pas lieu, etis-activerépond quand mêmeactive(l’ancien processus). Vérifier l’heure danssystemctl status.
11.3 Point de contact et politique (interface)
- Alertes → Points de contact → + Créer : nom
mail-axel, intégration Email, adresses ; Tester → mail « [FIRING:1] TestAlert » reçu ; Enregistrer. - Alertes → Politiques de notification → Politique par défaut → Modifier : point de contact
mail-axel. - Ajouter un chemin (deux fois), avec Remplacer les horaires généraux activé :
| Chemin | Group wait | Group interval | Repeat interval | Pourquoi |
|---|---|---|---|---|
severite = critique | 10s | 5m | 1h | une panne doit arriver vite et se rappeler toutes les heures (escalade) |
severite = avertissement | 5m | 30m | 24h | on regroupe, rien ne presse, un rappel par jour |
| Délai | Ce qu’il fait |
|---|---|
| Group wait | attente avant le premier mail d’un groupe : plusieurs alertes simultanées → un mail |
| Group interval | attente avant un mail sur un changement du groupe (nouvelle alerte, ou retour à la normale) |
| Repeat interval | rappel tant que l’alerte dure |
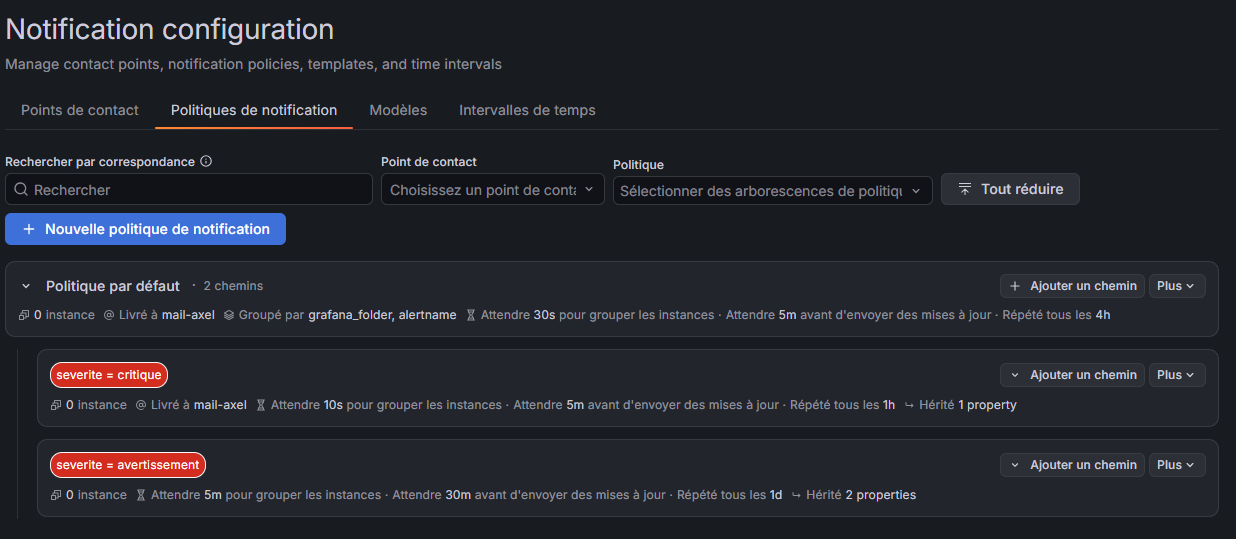
La politique par défaut et ses deux chemins : critique (10 s, rappel toutes les heures) et avertissement (5 min, rappel par jour, le point de contact est hérité).
11.4 Une règle d’alerte (interface), section par section
Exemple : « Service injoignable », construite à la main.
| Section | Valeur | Pourquoi |
|---|---|---|
| 2. Requête | probe_success, condition IS BELOW 1 | une seule règle surveille les 6 services : Grafana crée une instance par série |
| 3. Dossier, étiquettes | Lab BTS ; severite = critique | l’étiquette choisit le chemin |
| 4. Évaluation | groupe critiques (1m) ; période en attente 2m | une coupure de 10 s ne réveille personne |
| 4. Absence de données / erreur | Alerting / Alerting | si Prometheus tombe, on est prévenu au lieu de croire que tout va bien |
| 5. Notifications | Options avancées activées → Politique par défaut | sans elles, la règle envoie directement au point de contact et ignore les chemins |
| 6. Message | Summary {{ $labels.service }} ne répond plus ; description | {{ $labels.… }} est remplacé par la valeur de l’étiquette dans le mail |
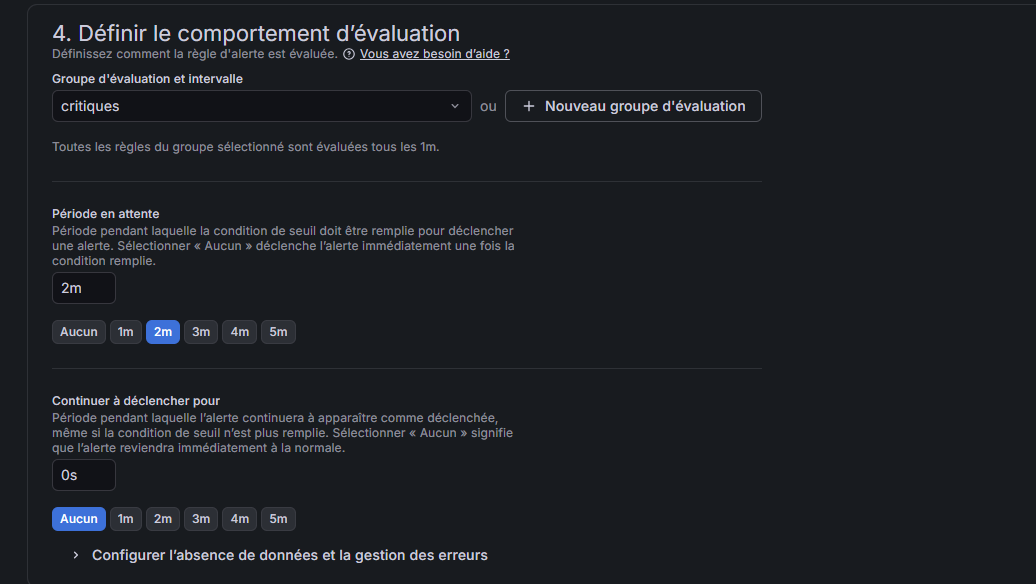
Section 4 : groupe critiques évalué chaque minute, période en attente de 2 minutes.
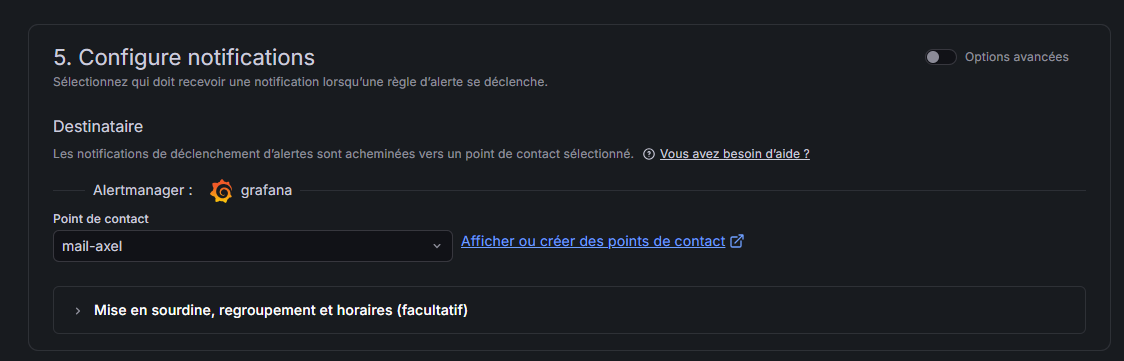
Le piège de la section 5 : sans « Options avancées », la règle envoie directement au point de contact choisi et ignore les chemins severite.
Validation — Aperçu de l’acheminement → Afficher la route : Politique par défaut → severite = critique.
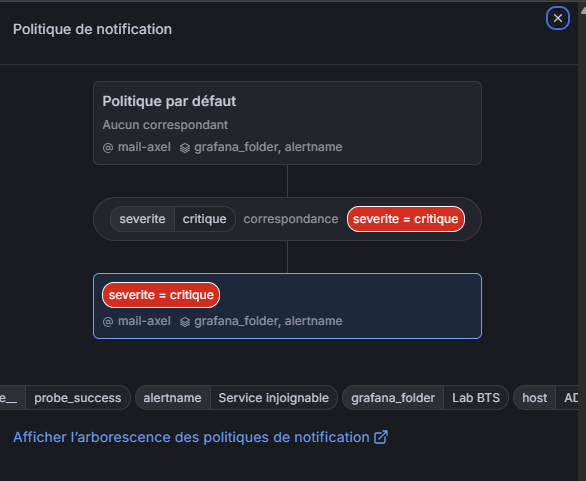
La route d’une instance : la politique par défaut, l’étiquette severite = critique qui correspond, puis le chemin critique vers le point de contact.
Une étiquette absente s’affiche « [no value] ». Pour un texte qui mélange Linux (
mountpoint) et Windows (volume) :{{ with $labels.mountpoint }}{{ . }}{{ end }}{{ with $labels.volume }}{{ . }}{{ end }}.
11.5 Les règles du lab (11 au 30/10, 17 au 12/11, toutes éprouvées par une panne réelle ou provoquée)
| Règle | Requête (Prometheus) | Seuil | Attente | Gravité |
|---|---|---|---|---|
| Service injoignable | probe_success | < 1 | 2m | critique |
| Machine injoignable | up{job=~"node|windows"} | < 1 | 2m | critique |
| Galera incomplet | max(mysql_global_status_wsrep_cluster_size) | < 3 | 2m | critique |
| Sauvegarde trop ancienne | (time() - pbs_snapshot_vm_last_timestamp) / 3600 | > 26 h | 10m | critique |
| Disque presque plein | remplissage Linux, pfSense, Windows C: | > 85 % | 15m | avertissement |
| Mémoire saturée | mémoire utilisée Linux, pfSense, Windows | > 90 % | 15m | avertissement |
| Processeur saturé | 100 * (1 - avg by(host) (rate(…idle[5m]))) | > 90 % | 15m | avertissement |
| Datastore PBS presque plein | 100 * pbs_used / pbs_size | > 80 % | 30m | avertissement |
| Connexions refusées en rafale | SQL sur journaux_auth : « Failed password » et 4625 des 5 dernières minutes, par machine | ≥ 5 | 1m | critique |
| Supervision aveugle (Grafana ne calcule plus les alertes) (ex-« (Prometheus) », renommée le 02/11 : H-66) | vector(1) : répond toujours 1 tant que Prometheus répond | (erreur) | 2m | critique |
| Site lent (contrat de service) | probe_duration_seconds{service="site-web"} | > 2 s | 5m | avertissement |
| lsyncd arrêté (recopie vers srv-web-02) (05/11) | lsyncd_processus (textfile de node_exporter) | < 1 | 5m | avertissement |
| Copie hors site trop ancienne (NAS) (05/11) | (time() - pbs_snapshot_vm_last_timestamp{datastore="s3-maison"}) / 3600 | > 30 h | 10m | avertissement |
| VM absente de la copie hors site (NAS) (05/11) | VM sauvegardée dans sio2527-lab sans copie dans s3-maison | ≥ 1 | 1h | avertissement |
| Copie hors site injoignable (NAS) (05/11) | max(pbs_s3_accessible{datastore="s3-maison"}) (sonde signée toutes les 5 min) | < 1 | 15m | avertissement |
| Intrusion détectée (Wazuh) (03/11) | SQL sur la base des journaux : alertes Wazuh de niveau ≥ 10 et créations de comptes (fenêtre de 15 min) | ≥ 1 | 1m | critique |
| Serveur retiré par HAProxy (06/11) | haproxy_serveur_up{host="srv-ha"} | < 1 | 5m | avertissement |
Erreur ou absence de données ? Absence de données : Prometheus répond, mais la mesure a disparu → alerte (vrai signal). Erreur : Prometheus ne répond plus → une seule règle alerte (« Supervision aveugle », état d’erreur = Alerting), toutes les autres ont l’état d’erreur = OK. Sinon, chaque règle envoie son mail et accuse à tort les services (H-62). Pour une requête SQL qui ne renvoie aucune ligne quand tout va bien (refus de connexion), l’absence de données = OK.
Option : créer les règles par l’API (
POST /api/ruler/grafana/api/v1/rules/<uid-du-dossier>, compte de service Editor). Ce point d’accès remplace tout le groupe : relire le groupe, y ajouter la règle, renvoyer l’ensemble (en gardant l’uiddes règles existantes), après en avoir gardé une copie.
11.6 Tester sans casser
| Règle | Test | Ce qui est coupé |
|---|---|---|
| Service injoignable | docker stop termix, relance automatique au bout de 5 min | Termix 5 min |
| Machine injoignable | systemctl stop prometheus-node-exporter sur srv-ha, 5 min | rien (seule la mesure se tait) |
| Galera incomplet | systemctl stop mariadb sur un nœud, 5 min (= test de bascule 7.10) | rien (le site continue) |
| Machine injoignable (vrai arrêt) | qm shutdown <vmid> && sleep 300 && qm start <vmid> sur l’hyperviseur, sur un serveur web | rien (l’autre serveur web sert le site) |
| Connexions refusées en rafale | depuis le bastion : ssh -o PubkeyAuthentication=no tototest@<ip>, mots de passe faux (≥ 5) | rien |
| Supervision aveugle | systemctl stop prometheus 5 min sur srv-metriques | les mesures pendant 5 min |
| Seuils (sauvegarde, disque, mémoire, processeur, datastore) | abaisser le seuil le temps du test, puis le remettre | rien |
Lancer la panne par une tâche détachée qui se répare seule, et vérifier l’invite avant de valider :
sudo systemd-run --unit=test-alerte-termix /bin/sh -c 'docker stop termix; sleep 300; docker start termix'
Ne pas remettre le seuil avant que le mail soit parti. Sur le chemin
avertissement, si l’alerte disparaît avant la fin de l’attente de groupe (5 min), aucun mail ne part : c’est voulu (un pic passager ne dérange personne), mais le test ne prouve alors rien. Garder le seuil abaissé au moins group wait + 1 min.
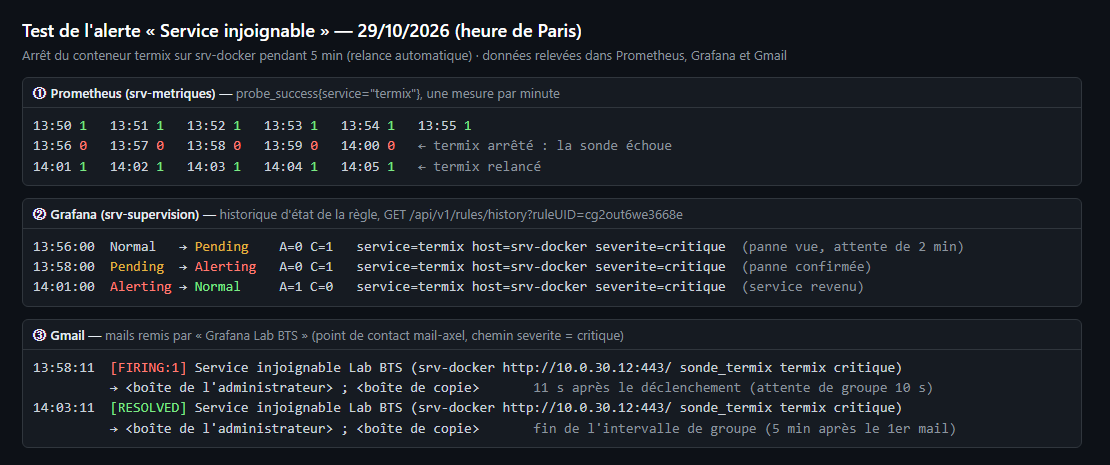
Validation — pour chaque test : l’historique d’état de la règle (Normal → Pending → Alerting → Normal), le mail [FIRING] puis [RESOLVED], et la mesure dans Prometheus concordent. Preuves : captures 118 à 129 et Preuve-alerte-termix-2026-10-29.md.
12 · Pièges et checklist
| Piège | Symptôme | Où c’est documenté |
|---|---|---|
skip-verify sans fichier d’autorités | could not read DB CA Cert path "" | H-45 |
| Mot de passe mal collé | Error 1045 Access denied | H-45 |
| Journaux enregistrés en heure locale | lignes affichées avec 2 h d’avance | H-46 |
| Période oubliée sur une ancienne plage | « 0 série retournée » | H-49 |
| Numéro de port recopié dans un filtre | seule une ligne est exclue | §8.3 : remplacer ce qui change par % |
| Filtrer toute l’adresse du bastion | les vraies connexions d’administration disparaissent | §8.3 |
| Max laissé vide sur un pourcentage | l’axe monte à 110 % | §8.2 |
Fenêtre [1d] sans offset -1d | les cases « par jour » sont décalées d’un jour | H-51 |
| Séries anciennes sans étiquette | une courbe « Value », des machines en double | H-52 |
| Contrôle de santé sur la page d’accueil | des milliers de lignes de journaux par jour | H-53 |
| Découpage SQL avec une espace ordinaire | le compte Windows illisible | H-54 |
| Loupe « − » : période fixe qui finit dans le futur | tout le tableau à « No data » | H-55 |
| Commande de test lancée sur la mauvaise machine | docker: not found, aucune alerte | H-57 |
| Seuil de test remis avant l’envoi | alerte déclenchée, aucun mail | H-58 |
| Étiquette absente dans un modèle de message | « disque /[no value] » | H-59 |
| Règle envoyée directement au point de contact | les chemins severite ne servent pas | §11.4 : activer Options avancées |
| Toutes les règles alertent sur erreur | Prometheus tombe : 3 mails qui accusent les services | H-62 |
 Dépôt apt.grafana.com signé (signed-by), paquet installé sans --install-recommends
 /etc/default/grafana-server : .orig gardé, variables GF_*, mot de passe par read -rsp, chmod 600
 CA_CERT_PATH renseigné malgré skip-verify
 Service active, écoute sur 10.0.30.15:3000
 Base grafana : 0 table sans clé primaire
 Mot de passe admin changé
 Sources prometheus et mysql (grafana_lecture) testées
 Journaux en UTC (rsyslog date.inUTC="on")
 Panneaux enregistrés ; heure affichée = heure du PC
 Tableau de production : période par défaut 30 jours, seuils justifiés dans chaque description
 Lignes répétées : variable cachée, même hauteur pour tous les panneaux de la ligne
 Historique « par jour » : offset -1d vérifié sur un jour connu
 Test de bout en bout : un mot de passe faux (SSH et Windows) apparaît en moins d'une minute
 GF_LOG_LEVEL=warn
 Envoi SMTP : mot de passe d'application de 16 caractères, STARTTLS obligatoire, fichier en 600 root:root
 GF_SERVER_ROOT_URL = adresse publique : les liens des mails s'ouvrent
 Point de contact testé (TestAlert reçu) ; politique par défaut et chemins critique / avertissement
 Chaque règle : étiquette severite, Options avancées (politique), absence de données = Alerting
 Chaque règle testée : [FIRING] puis [RESOLVED] reçus, historique d'état relevé
La règle à retenir en une phrase : Grafana ne stocke pas les données, il les interroge : une source par endroit, une requête par question, des dates en UTC, et sa propre base dans le cluster pour survivre à la perte d’un nœud.