Mode opératoire — HAProxy : répartir le web, basculer la base
Document autonome. Partie 1 théorique, partie 2 pas-à-pas appliqué à l’infrastructure
sio.internal.
Prérequis : un cluster de base — voir MO-2-Cluster-Galera.mdDernière mise à jour : 27/09/2026
État au 12/11/2026 : srv-ha publie aussi GLPI (05/11), Matomo (stats.sio.internal, 10/11), l’API de GLPI (filtrée) et le nom public du site par Pangolin (règles du nom public, 10-11/11) ; il ne garde que les nœuds Galera synchronisés (sonde 9200, 05/11). La configuration à jour est décrite dans la documentation (étapes 62, 66, 72).
1 · Théorie — un répartiteur est une machine sur le chemin
   SANS répartiteur                    AVEC répartiteur
   ────────────────                    ────────────────
   client ──► serveur                  client ──► srv-ha ──► serveur A
                                                        └──► serveur B
   le client connaît le serveur        le client ne connaît QUE le répartiteur
Contrairement à un mécanisme de cluster — qui vit à l’intérieur des serveurs — un répartiteur
intercepte le trafic. Il lui faut donc exister quelque part : sa propre machine, ou un service
sur un équipement existant.
1.1 Où le placer — trois options
Option
Avantage
Inconvénient
Paquet sur le pare-feu
zéro machine de plus
routeur + pare-feu + répartiteur = un seul point de panne, rôles mélangés
VM dédiée dans le VLAN des serveurs
tier séparé, flux client filtrable
le répartiteur partage le segment de ce qu’il dessert
VM dédiée dans une DMZ
le plus canonique
un VLAN, une interface et un jeu de règles de plus
Choix retenu ici : VM dédiée srv-ha en 10.0.10.5, dans le VLAN 10 avec les serveurs web.
1.2 L’effet contre-intuitif — le répartiteur restreint les autorisations
   AVANT                                 APRÈS
   ─────                                 ─────
   USERS   → SRV_WEB    : 80/443         USERS  → SRV_HA       : 80/443
   SRV_WEB → base       : 3306           SRV_HA → GALERA_NODES : 3306
              ▲                                     ▲
   les serveurs web joignent la base     ils ne la joignent PLUS DU TOUT
   les clients joignent 2 serveurs       ils n'en joignent qu'UN
On ajoute quatre machines, et le nombre de machines autorisées à parler à la base reste à une
seule — alors qu’elles sont désormais deux à en avoir besoin fonctionnellement.
Une couche supplémentaire a restreint les autorisations au lieu de les élargir. C’est
l’argument le plus fort de cette architecture, et il surprend toujours : on associe
spontanément « plus de machines » à « plus de surface d’attaque ».
1.3 Convention d’adressage
   .1          la passerelle
   .2 à .9     points d'entrée et infrastructure   ← le répartiteur prend le .5
   .10 et +    serveurs applicatifs
Le rôle se lit dans l’adresse, et la numérotation des serveurs reste consécutive.
2 · Répartir ≠ basculer
C’est le point que la plupart des tutoriels passent sous silence.
Une requête HTTP est sans état : chaque serveur peut y répondre indépendamment, puisque tout
l’état vit ailleurs (base de données, fichiers partagés). Deux serveurs web sont donc
interchangeables, et on peut alterner à chaque connexion.
2.2 Pourquoi le SQL ne se répartit pas
Un cluster à réplication synchrone certifie chaque transaction auprès des autres nœuds. Deux
écritures concurrentes sur la même ligne, depuis deux nœuds différents, produisent un conflit
de certification — et l’application reçoit une erreur de verrou qu’elle ne sait pas traiter.
La configuration canonique déclare donc les nœuds 2 et 3 en backup :
    server mysql-01 10.0.20.10:3306 check
    server mysql-02 10.0.20.11:3306 check backup    ← n'entrent en jeu
    server mysql-03 10.0.20.12:3306 check backup       que si mysql-01 tombe
Le mot-clé backup signifie : « ne m’envoie du trafic que si plus aucun serveur actif
ne répond ». Avec un seul serveur actif, 100 % du trafic va sur le nœud 1 — et bascule
automatiquement s’il tombe.
On appelle HAProxy un « répartiteur de charge », mais devant un cluster synchrone il fait de la
haute disponibilité par basculement. Ce n’est pas la même chose, et savoir l’expliquer
distingue un TP compris d’un TP recopié.
Le répartiteur déchiffre en entrée et parle en clair aux serveurs derrière. Avantages :
Un seul certificat à gérer
au lieu d’un par serveur web
Charge de chiffrement centralisée
les serveurs applicatifs n’en portent pas le coût
Protocole modernisé gratuitement
HTTP/2 côté client, HTTP/1.1 côté serveurs
3.2 Le piège de la boucle de redirection
   Navigateur ──HTTPS──► HAProxy ──HTTP──► serveur web
                                              │
                          « je reçois du HTTP, mais mon URL
                            canonique est en HTTPS »
                                              │
                                    redirige vers HTTPS
                                              │
                          HAProxy déchiffre, renvoie en HTTP
                                              │
                                        ↻ BOUCLE INFINIE
Symptôme : ERR_TOO_MANY_REDIRECTS. Rien n’est cassé nulle part — c’est ce qui rend la panne
déroutante.
La solution en deux moitiés, indissociables :
Côté
Action
HAProxy
http-request set-header X-Forwarded-Proto https if { ssl_fc }
Application
lire cet en-tête et positionner $_SERVER['HTTPS'] = 'on'
Le subjectAltName n’est pas optionnel. Depuis 2017, les navigateurs ignorent
totalement le champ CN pour vérifier le nom d’hôte : ils ne lisent que le SAN. Un
certificat sans SAN produit ERR_CERT_COMMON_NAME_INVALID — bien plus alarmant qu’un simple
avertissement d’auto-signature.
Option
Rôle
-x509
produit un certificat directement, sans demande à signer
-nodes
no DES — la clé privée n’est pas chiffrée par mot de passe
-addext subjectAltName
les noms réellement vérifiés par les clients
-nodes est un choix assumé : une clé protégée exigerait une saisie à chaque
démarrage du service. Impossible sur un démon qui doit remonter seul après un redémarrage.
La protection repose donc sur les droits du fichier — chmod 600, propriétaire root.
HAProxy attend un fichier unique contenant le certificat puis la clé :
4 · Sessions, fichiers, et l’épinglage de l’administration
4.1 Le problème des fichiers téléversés
Répartir sur deux serveurs web fait apparaître un problème que le mono-serveur masquait :
   Téléversement d'une image  →  atterrit sur UN nœud
                                        │
                     l'autre nœud ne l'a pas
                                        │
              l'image s'affiche UNE FOIS SUR DEUX
Le symptôme le plus déroutant pour un utilisateur : « l’image apparaît puis disparaît ».
4.2 Trois réponses possibles
Solution
Principe
Limite
Partage NFS
un serveur de fichiers, monté par les deux
un point de panne supplémentaire
Synchronisation lsyncd
un nœud maître pousse vers l’autre
unidirectionnelle par nature
Objet distant (S3)
les médias sortent du serveur
hors périmètre d’un lab
4.3 Le motif retenu : épinglage + synchronisation à sens unique
lsyncd est unidirectionnel ; synchroniser dans les deux sens crée des boucles et des conflits.
La parade est d’imposer qu’un seul nœud écrive :
   HAProxy
     │
     ├─ /wp-admin , /wp-login.php ──────► web-01 SEULEMENT
     │                                        │
     │                                   lsyncd (sens unique)
     │                                        ▼
     └─ tout le reste (roundrobin) ─────► web-01 + web-02
Toute l’administration — téléversements, extensions, thèmes — atterrit sur le nœud 1. lsyncd
pousse vers le nœud 2 dans un seul sens.
Trois problèmes résolus d’un coup : plus de conflit de synchronisation, plus de session
d’administration qui saute d’un nœud à l’autre, et un seul écrivain sur les fichiers — la
même logique que le « un seul écrivain » de Galera. Les deux décisions se tiennent.
Le prix à payer : le backend d’administration n’a qu’un seul serveur. Si web-01
tombe, le site public continue mais /wp-admin répond 503. Arbitrage défendable — les
visiteurs ne subissent rien — mais à énoncer.
4.4 Et les sessions ?
Les cookies d’authentification sont signés par des clés propres à l’installation (les salts
dans WordPress). Si les deux serveurs ont les mêmes clés, un cookie émis par l’un est valide
sur l’autre — aucune persistance de session n’est nécessaire.
C’est un argument de plus pour cloner plutôt que réinstaller : l’identité des clés est
garantie par construction.
5 · Pas à pas — la machine et le certificat
5.1 La VM
Paramètre
Valeur
Nom
SIO2527-srv-ha-Axel
Système
Debian 13, sans environnement de bureau
Disque / CPU / RAM
20 Go · 2 cœurs · 2048 Mo
Réseau
vmbr1 + VLAN Tag 10 · VirtIO · Firewall
Adressage
10.0.10.5/24 · passerelle et DNS 10.0.10.1
Agent
Qemu Agent
20 Go et 2 Go de RAM suffisent largement. HAProxy ne stocke rien et ne calcule rien :
il relaie. Le dimensionner comme un serveur applicatif est du gaspillage.
Pas d’environnement de bureau. Il entraîne NetworkManager au lieu d’ifupdown,
le démon avahi qui pollue les journaux du pare-feu, et de la RAM consommée pour rien.
sudo mariadb -e "CREATE USER 'haproxy_check'@'10.0.10.5';"
Dans le lab, depuis le 05/11 : ce compte n’existe plus. La sonde de synchronisation du §6.3 l’a rendu
inutile, il a été supprimé (DROP USER 'haproxy_check'@'10.0.10.5';). Il ne sert qu’avec mysql-check.
Un compte sans mot de passe et sans aucun privilège — volontairement. La sonde
mysql-check n’exécute aucune requête : elle ouvre une connexion, lit la bannière du
serveur, referme. Elle a juste besoin que le compte existe pour que MariaDB réponde au lieu
de rejeter. Lui donner un mot de passe ou des droits serait du risque gratuit — c’est le
moindre privilège poussé à sa limite : zéro privilège.
5.4 L’enregistrement DNS
Sur le résolveur du réseau — ici pfSense, Services → DNS Resolver → Host Overrides :
Host
Domain
IP
www
sio.internal
10.0.10.5
Vérification depuis n’importe quelle machine du lab :
getent hosts www.sio.internal
C’est ce qui donne son sens au certificat : sans entrée DNS, le nom www.sio.internal
ne désignerait rien.
sudo tee /etc/haproxy/haproxy.cfg > /dev/null <<'EOF'
#=====================================================================
#  srv-ha  10.0.10.5  -  Lab SISR Axel GOUIRAND
#  Repartition HTTP sur 2 serveurs web + bascule sur cluster Galera
#=====================================================================

global
    log /dev/log local0
    log /dev/log local1 notice
    chroot /var/lib/haproxy
    stats socket /run/haproxy/admin.sock mode 660 level admin
    stats timeout 30s
    user haproxy
    group haproxy
    daemon
    ssl-default-bind-options ssl-min-ver TLSv1.2 no-tls-tickets

defaults
    log     global
    mode    http
    option  httplog
    option  dontlognull
    timeout connect 5s
    timeout client  30s
    timeout server  30s

#---------------------------------------------------------------------
#  HTTP  -  entree unique du site
#---------------------------------------------------------------------
frontend web_in
    bind 10.0.10.5:80
    bind 10.0.10.5:443 ssl crt /etc/haproxy/certs/srv-ha.pem

    http-request redirect scheme https unless { ssl_fc }
    http-request set-header X-Forwarded-Proto https if { ssl_fc }

    acl est_admin path_beg /wp-admin /wp-login.php
    use_backend web_admin if est_admin
    default_backend web_public

backend web_admin
    option httpchk
    http-check send meth GET uri / hdr Host www.sio.internal
    http-check expect status 200,301,302
    server web-01 10.0.10.10:80 check

backend web_public
    balance roundrobin
    option httpchk
    http-check send meth GET uri / hdr Host www.sio.internal
    http-check expect status 200,301,302
    server web-01 10.0.10.10:80 check
    server web-02 10.0.10.11:80 check

#---------------------------------------------------------------------
#  MySQL  -  bascule sur le cluster Galera (PAS de repartition)
#---------------------------------------------------------------------
listen galera
    mode tcp
    option tcplog
    bind 10.0.10.5:3306
    timeout client 1h
    timeout server 1h
    option mysql-check user haproxy_check
    server mysql-01 10.0.20.10:3306 check
    server mysql-02 10.0.20.11:3306 check backup
    server mysql-03 10.0.20.12:3306 check backup

#---------------------------------------------------------------------
#  Page de statistiques
#---------------------------------------------------------------------
listen stats
    bind 10.0.10.5:8404
    mode http
    stats enable
    stats uri /
    stats refresh 10s
    stats show-node
    stats auth admin:<mot-de-passe-stats>
EOF
6.1 Les points qui comptent
Ligne
Rôle
bind 10.0.10.5:…
une adresse précise, jamais * — même logique que bind-address sur une base : moindre exposition
redirect scheme https unless { ssl_fc }
tout ce qui arrive en clair repart en HTTPS
set-header X-Forwarded-Proto https
la ligne dont dépend §7
acl est_admin path_beg …
reconnaît les URL d’administration
mode tcp(galera)
MySQL n’est pas du HTTP : HAProxy relaie les octets sans les interpréter
option tcplog(galera)
évite l’avertissement « option httplog not usable with proxy ‘galera’ »
backup sur les nœuds 2 et 3
bascule, pas répartition
6.2 Les timeouts à 1 heure ne sont pas un excès
Les valeurs par défaut de defaults sont de 30 secondes — adaptées au HTTP, catastrophiques
pour MySQL. Une application garde sa connexion ouverte entre deux requêtes ; au bout de 30 s
d’inactivité, HAProxy la couperait et on obtiendrait des MySQL server has gone away
aléatoires.
C’est l’erreur n°1 des configurations HAProxy + base de données, et elle produit une panne
intermittente — donc difficile à relier à sa cause.
6.3 La sonde de santé Galera — sa limite
option mysql-check ouvre une connexion et lit la bannière. Elle ne sait pas dire si un nœud
est Synced ou en pleine resynchronisation. Un nœud démarré mais pas encore à jour serait
déclaré sain.
La version canonique est clustercheck : un script officiel Galera qui expose
wsrep_local_state = 4 (Synced) en HTTP sur le port 9200. HAProxy l’interroge alors avec
option httpchk et ne considère sain qu’un nœud réellement synchronisé.
À retenir comme piste d’amélioration : c’est ce qui rend la démonstration de bascule
honnête, notamment au retour d’un nœud après panne.
Mis en place le 05/11/2026 (Documentation, étape 62) avec une sonde écrite pour le lab plutôt que le script
clustercheck : scripts/galera/galera-etat.sh, servi sur 9200 par un socket systemd (Accept=yes,
IPAddressAllow=10.0.10.5 127.0.0.1, IPAddressDeny=any). Il lit l’état avec root par le socket local : pas de
compte MySQL ni de mot de passe. Règle pfSense WEB : SRV_HA → GALERA_NODES : 9200. Le bloc listen galera
devient :
    option httpchk
    http-check send meth GET uri /
    http-check expect status 200
    server mysql-01 10.0.20.10:3306 check port 9200
    server mysql-02 10.0.20.11:3306 check port 9200 backup
    server mysql-03 10.0.20.12:3306 check port 9200 backup
Test : SET GLOBAL wsrep_desync=ON; sur un nœud de secours → la sonde répond 503, HAProxy le passe
DOWN L7STS en quelques secondes alors que MariaDB répond toujours ; wsrep_desync=OFF → UP. Dans la page de
statistiques, le contrôle s’affiche alors L7OK (réponse HTTP attendue) ou L7STS (mauvais code HTTP).
6.4 Valider avant de démarrer
sudo haproxy -c -f /etc/haproxy/haproxy.cfg
Attendu : aucune sortie, ou Configuration file is valid.
Le même réflexe que apache2ctl configtest et php -l : on valide la syntaxe avant
de toucher au service. Recharger une configuration invalide arrête le service.
reload plutôt que restart en exploitation : il relit la configuration sans couper
les connexions en cours. Sur un répartiteur en service, c’est la différence entre une
modification transparente et une coupure.
À répéter à l’identique sur le second serveur web. Les deux fichiers doivent être
rigoureusement identiques — un écart produirait un comportement qui change une fois sur deux.
Modification
Pourquoi
DB_HOST → l’adresse du répartiteur
si un nœud tombe, HAProxy bascule et l’application ne s’en aperçoit pas
WP_HOME / WP_SITEURLdans le fichier
pas de chirurgie SQL, et modifiable même site cassé — une URL erronée en base rendrait l’administration inaccessible, donc impossible à corriger
Détection du HTTPS relayé
sans elle : ERR_TOO_MANY_REDIRECTS
Les constantes doivent être définies avantrequire_once … wp-settings.php, qui charge
le cœur de l’application. D’où l’insertion après la ligne $table_prefix.
7.2 Le compte de base au nom du répartiteur
Du point de vue de la base, le client n’est plus le serveur web mais HAProxy : un proxy en
mode TCP termine la connexion entrante et en ouvre une nouvelle avec sa propre adresse source.
sudo mariadb -e "CREATE USER 'wp_user'@'10.0.10.5' IDENTIFIED BY '<mot-de-passe-wp_user>'; GRANT ALL PRIVILEGES ON wp_lab.* TO 'wp_user'@'10.0.10.5';"
Puis, une fois la bascule validée, supprimer les anciens :
sudo mariadb -e "DROP USER 'wp_user'@'10.0.10.10'; DROP USER 'wp_user'@'10.0.10.11';"
7.3 La méthode de migration en trois temps
   1. AJOUTER le nouveau chemin      → les deux coexistent, rien ne casse
   2. BASCULER les clients dessus    → vérifier que ça marche
   3. RETIRER l'ancien chemin        → une fois la bascule prouvée
Vaut pour les règles de pare-feu comme pour les comptes. Modifier directement une règle
en service coupe le trafic pendant la transition ; en ajouter une nouvelle à côté permet une
bascule sans interruption, puis un retrait propre.
Et pour le retrait : décocher plutôt que supprimer. La règle grisée reste la trace
documentaire de la démarche — « avant, les serveurs web joignaient la base ; depuis le
répartiteur, non ».
8 · Validation, tests de bascule, pièges
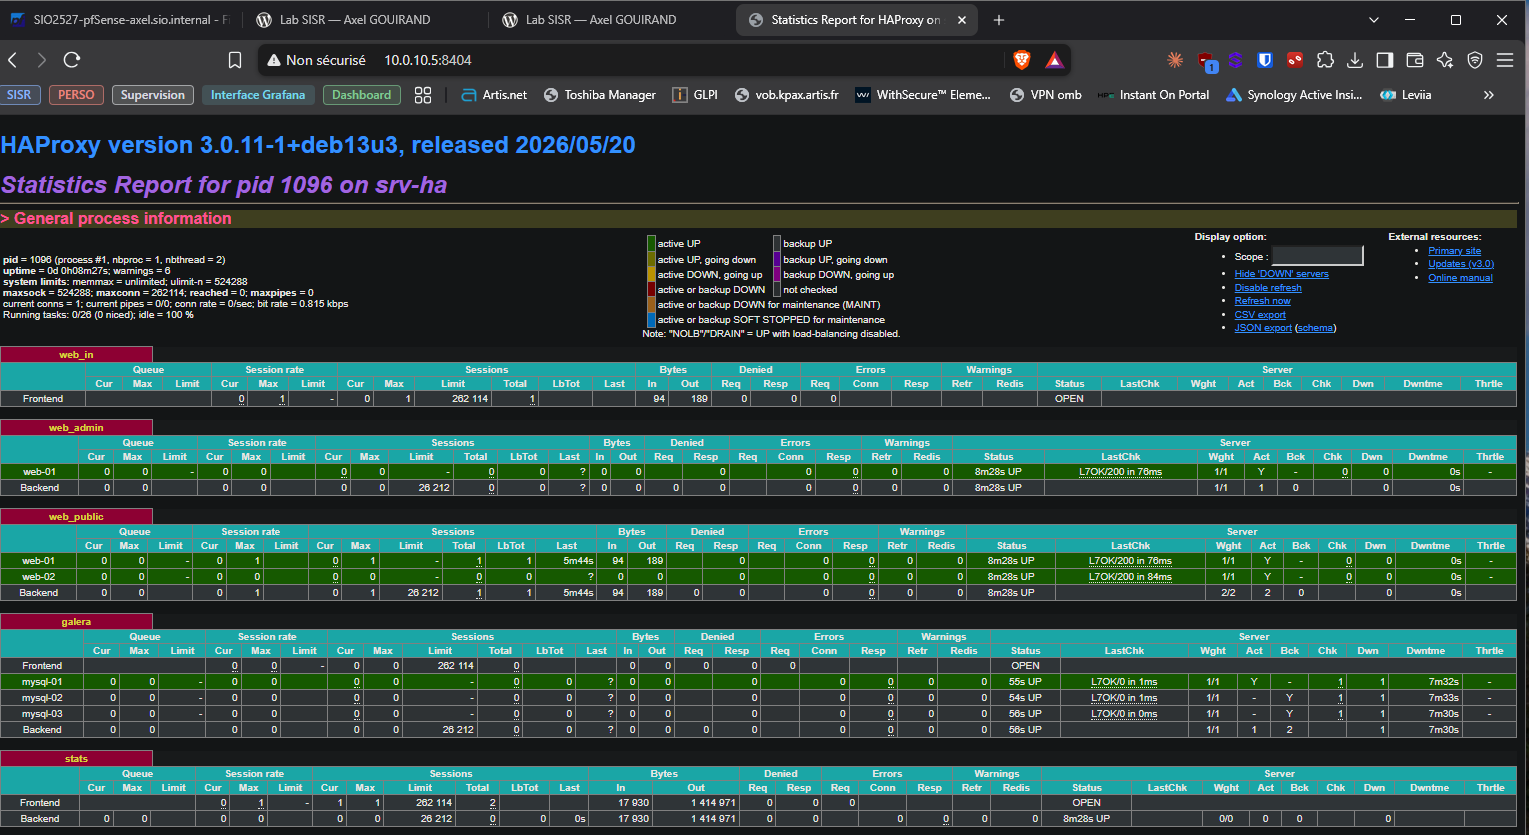
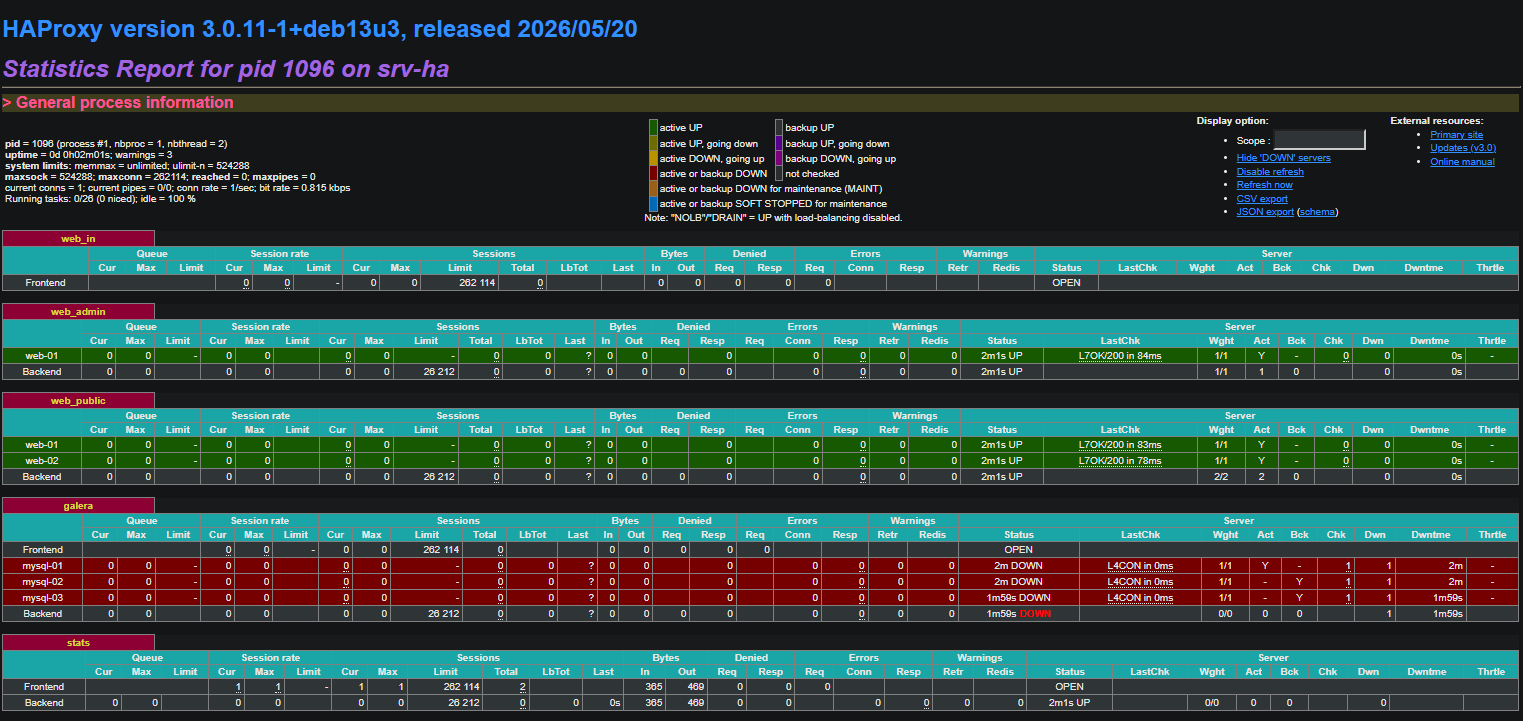
8.1 Le tableau de bord
http://10.0.10.5:8404
Couleur
Signification
vert
serveur actif et sain
bleu
serveur backup sain, sans trafic
rouge
serveur DOWN
Les colonnes Act et Bck confirment le rôle de chaque serveur, et LastChk donne le résultat
de la dernière sonde.
Code
Sens
L7OK/200
sonde HTTP : le serveur a répondu 200
L7OK/0
sonde applicative non-HTTP réussie — c’était le cas de mysql-check
L7STS
sonde HTTP : la réponse n’a pas le code attendu (ici 503 de la sonde Galera : nœud non synchronisé)
L4CON in 0ms
échec de connexion TCP, immédiat → un Reject a renvoyé un RST
L4CON avec délai
échec par expiration → un Block silencieux
L4CON in 0ms est presque toujours un problème de pare-feu, pas de service. Le 0ms
indique un refus immédiat : le paquet est arrivé quelque part et quelqu’un a répondu « non ».
41-haproxy-galera-down.png puis 43-haproxy-stats-tout-vert.png — la même page, une règle
d’écart.
8.2 Vérifier la répartition
Poser un fichier témoin différent sur chaque serveur, à la racine du site (hors du
répertoire synchronisé) :
echo"Je suis srv-web-01"| sudo tee /var/www/wordpress/noeud.txt > /dev/null
Puis, depuis une machine autorisée :
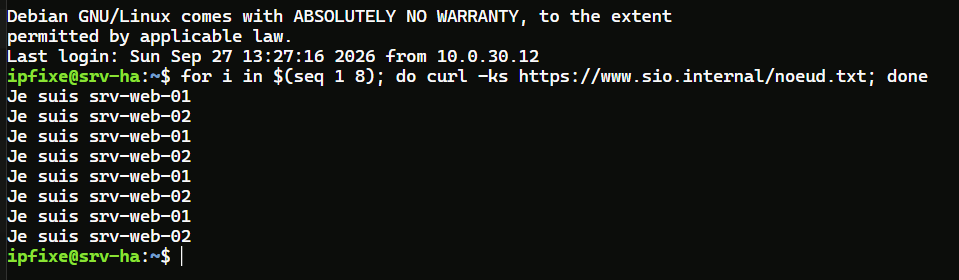
for i in $(seq 1 8);do curl -ks https://www.sio.internal/noeud.txt;done
Attendu : une alternance stricte. 45-test-7-7-repartition.png
Pourquoi curl alterne à coup sûr : chaque invocation ouvre une nouvelle connexion
TCP, et balance roundrobin distribue par connexion. Dans un navigateur, la persistance de
connexion (keep-alive) peut maintenir plusieurs requêtes sur le même serveur — d’où le
Ctrl+F5 pour forcer.
8.3 Les tests de bascule
Test
Action
Attendu
Bascule web
systemctl stop apache2 sur web-01
le site tient, plus d’alternance
Limite de l’épinglage
curl https://…/wp-admin/ pendant l’arrêt
503 — backend d’administration vide
Bascule base
systemctl stop mariadb sur mysql-01
l’application continue
Quorum
arrêter un second nœud de base
écritures refusées — voir MO-2 §7.4
Non-régression
rejouer un test de cloisonnement
doit toujours échouer
Le test de non-régression est le plus important des cinq. Après avoir ajouté quatre
machines, un répartiteur et assoupli un bind-address, il faut re-prouver que le
cloisonnement tient. Vérifier qu’une évolution n’a pas ouvert de brèche, c’est précisément
ce que fait un audit.
8.4 Les pièges rencontrés
Symptôme
Cause
Correction
option httplog not usable with proxy 'galera'
defaults en mode http, la section en mode tcp
option tcplog dans la section
Tous les nœuds base en L4CON in 0ms
règle de pare-feu absente pour l’adresse du répartiteur
créer la règle avant le Reject
ERR_CONNECTION_REFUSED depuis les clients
la règle client vise encore les serveurs web
destination → l’alias du répartiteur
ERR_TOO_MANY_REDIRECTS
X-Forwarded-Proto non traité côté application
le bloc PHP du §7.1
MySQL server has gone away aléatoire
timeouts à 30 s sur la section TCP
timeout client/server 1h
503 sur /wp-admin
le nœud épinglé est tombé
attendu — voir §4.3
8.5 Checklist de mise en service
   VM dédiée, sans bureau, adresse dans la plage « points d'entrée »
   Certificat généré AVEC subjectAltName
   .pem = certificat + clé concaténés, chmod 600
   Compte de sonde créé sur la base, SANS privilège
   Enregistrement DNS du nom public
   haproxy -c -f  → aucun avertissement
   Les 4 ports en écoute sur l'adresse précise
   Règle de pare-feu : clients → répartiteur
   Règle de pare-feu : répartiteur → nœuds de base
   Application : DB_HOST, URL canonique, X-Forwarded-Proto
   Compte de base au nom du répartiteur, anciens supprimés
   Anciennes règles décochées (pas supprimées)
   Tableau de bord : tout vert / bleu
   Alternance vérifiée, bascules testées, non-régression rejouée
À retenir en une phrase : un répartiteur ne se contente pas de distribuer la charge —
il devient le point d’entrée unique, et c’est ce qui permet de refermer tout le reste.